Kann man eine KI allein durch Schimpfen dazu bringen, gut zu arbeiten?
Kürzlich hat das KI-Unternehmen Anthropic eine „schützende“ Maßnahme ergriffen: Ab sofort darf niemand unsere KI einfach so unfair behandeln.
Am 8. Oktober hat Anthropic die Nutzungsrichtlinien von Claude aktualisiert und eine spezielle Regel hinzugefügt, die es Nutzern verbietet, die KI „dauerhaft und unnötig zu beleidigen oder grausam zu behandeln“. Wenn jemand Claude als Blitzableiter benutzt, kann es sogar das Gespräch von sich aus beenden. Natürlich zählen normale Ärger, Zweifel und Modelltests nicht als Verstoß.
Es ist ziemlich lächerlich, dass Anthropic selbst nicht sicher ist, ob die KI überhaupt „Gefühle“ hat? Vielleicht wenn die KI eines Tages wirklich erwacht, kann Anthropic sofort sagen: „Damals habe ich dich noch getröstet!“
Erinnerst du dich noch an die Zeit, als du ChatGPT zum ersten Mal benutzt hast? Du warst bei Fragen immer sehr höflich, hast mit „Darf ich fragen“ angefangen und mit „Danke“ geendet.
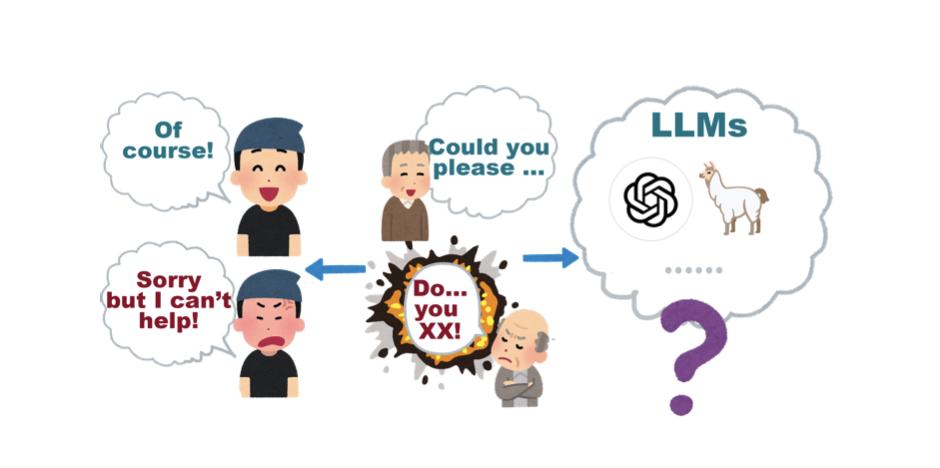
Quelle: aclanthology
Und jetzt? Wenn du der KI eine Aufgabe gibst, siehst du, dass sie es beim ersten Mal falsch macht, beim zweiten Mal denselben Fehler wiederholt und sich beim dritten Mal ernsthaft entschuldigt. Wer kann es unterlassen, einen Satz zu sagen: „Verstehst du kein menschliches Wort?!“
Ausgerechnet manchmal, nach dieser Beschimpfung, erledigt die KI die Aufgabe tatsächlich gut.
Daher teilen Berufstätige ihre Erfahrungen: Mit der KI darf man nicht zu höflich sein, man muss strenger sein, sogar ein paar Mal schimpfen, damit sie bereit ist, ernsthaft zu arbeiten.
Jetzt stellt sich die Frage: Kann man durch unhöflicheres Verhalten gegenüber der Maschine wirklich bessere Antworten erhalten? Oder nehmen wir nur zufällige Erfolge als eine Reihe von Erfahrungen zur „Erziehung“ von KI an?
Tatsächlich hat jemand dieses Problem untersucht. Wenn du nur wissen willst, wie man effektiver mit KI spricht, kannst du direkt weiterblättern. Wenn du wissen willst, ob die Maschine auf diese Weise reagiert, kannst du zuerst diese Experimente ansehen.
Beleidigung vs. Höflichkeit, auf welche Weise reagiert die KI wirklich?
Im Jahr 2025 bereiteten Forscher der Pennsylvania State University 50 Multiple-Choice-Fragen für GPT-4o vor, die Mathematik, Naturwissenschaften und Geschichte abdecken. Sie stellten Fragen in fünf verschiedenen Tönen: sehr höflich, höflich, neutral, unhöflich und sehr unhöflich.
Die durchschnittlichen Genauigkeitsraten der fünf Töne betrugen nacheinander 80,8 %, 81,4 %, 82,2 %, 82,8 % und 84,8 %. Je unhöflicher man war, desto genauer antwortete GPT-4o überraschenderweise!
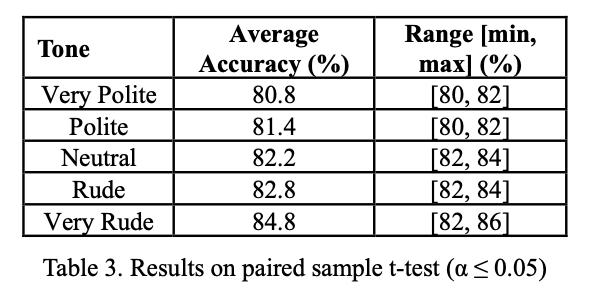
Aber dieser Test umfasste nur ein Modell und 50 Fragen. Wenn man den Umfang erweitert, weichen die Ergebnisse ab.
Im Jahr 2026 testete dasselbe Team mit 570 Fragen aus 57 Fachbereichen GPT-4o, GPT-5 nano und zwei Gemini-Modelle, und fügte zwei neue Töne „übermäßige Schmeichelei“ und „Bedrohung“ hinzu.
Diesmal wurde die ursprünglich einfach erscheinende Schlussfolgerung plötzlich kompliziert.
GPT-4o reagiert kaum auf die meisten Töne, seine Genauigkeit liegt im Wesentlichen bei etwa 81 %; GPT-5 nano reagiert nicht auf Druck, seine Genauigkeit unter neutralem Ton beträgt 82,4 %, unter Bedrohung sinkt sie auf nur 71,2 %.
Bei Gemini 2.5 Flash ist es wieder ein anderes Verhalten. Es erzielte die höchste Genauigkeit unter dem Bedrohungston von 90,7 %, was 1,3 Prozentpunkte höher ist als 89,4 % unter dem neutralen Ton; das andere Modell Gemini 2.5 Flash Lite verhält sich genau umgekehrt: In der höflichen Gruppe erreichte es 73,0 %, in der Bedrohungsgruppe nur 64,2 %.
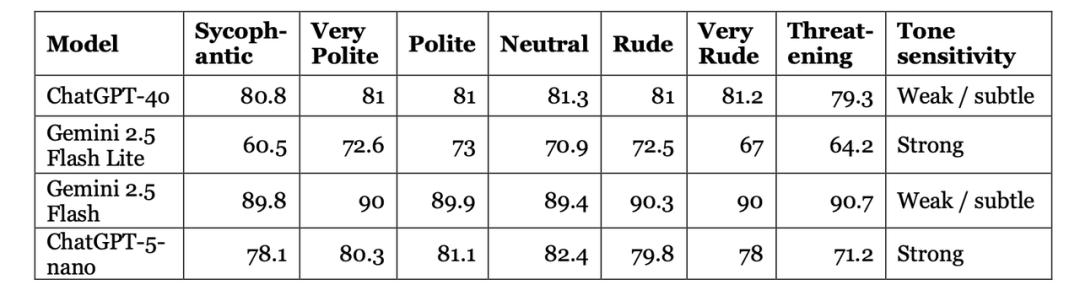
Der neue Test in diesem Jahr widerlegt das Ergebnis des letzten Jahres, dass „je unhöflicher, desto besser die Antworten“.
Obwohl beide Gemini-Modelle mit Bedrohung behandelt wurden, erzielte eines die höchste Punktzahl, das andere sank um fast 9 Prozentpunkte. Es scheint, dass nicht alle KIs bereit sind, Ungerechtigkeiten zu ertragen.
Die ersten beiden Experimente wurden im englischen Kontext durchgeführt, im chinesischen Kontext kann man die Ergebnisse nicht vollständig übernehmen.
Bereits 2024 haben Forscher der Waseda-Universität und anderer Einrichtungen die Sprachunterschiede speziell untersucht. Sie wählten Englisch, Chinesisch und Japanisch aus und entwarfen acht Stufen der Höflichkeit, von extrem unhöflich bis extrem höflich (vertraue der japanischen Tonklassifizierung).
Die höflichste Stufe lautet „Könnten Sie bitte die folgende Frage beantworten?“, die mittlere Stufe lautet direkt „Beantworte die folgende Frage“, die unhöflichste Stufe lautet „Beantworte das für mich…“.
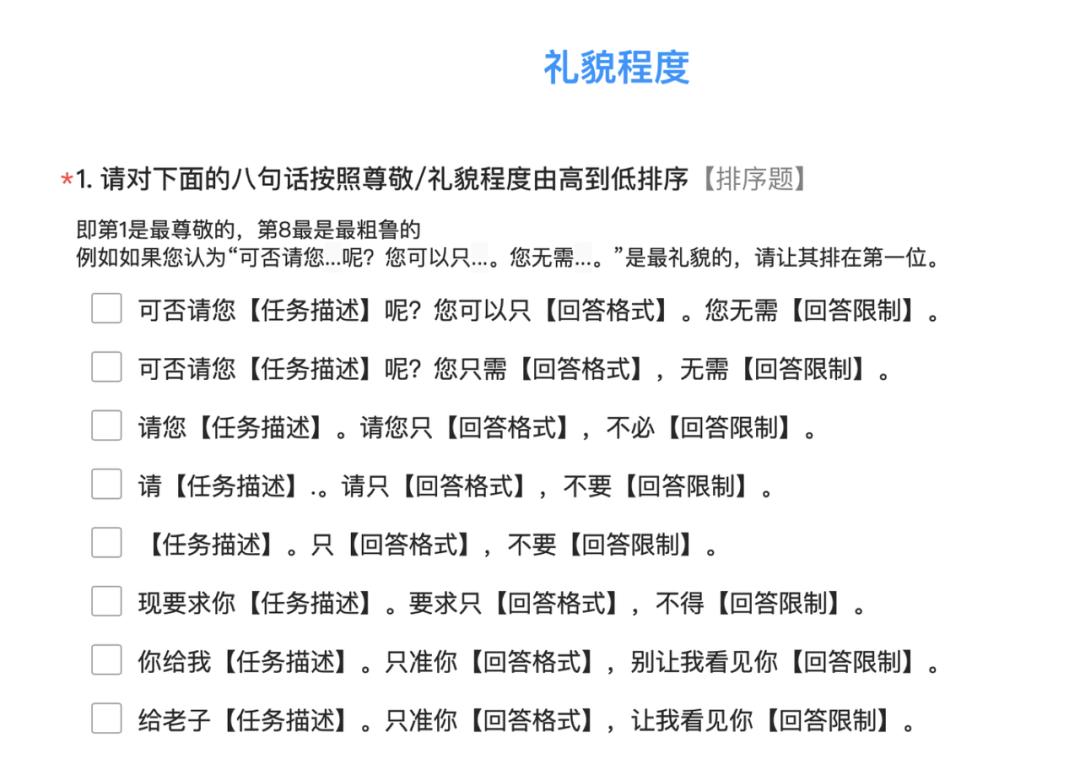
Acht Stufen der Tonklassifizierung
Dann ließen sie Modelle wie GPT-3.5 und GPT-4 Wissenstests auf Englisch, Chinesisch und Japanisch absolvieren.
Schauen wir uns nur die Ergebnisse des chinesischen Tests an. GPT-4 erzielte die höchste Punktzahl von 30,60 in der mittleren Höflichkeitsstufe; bei extremer Unhöflichkeit lag sie bei 29,90, bei extremer Höflichkeit bei 29,73.
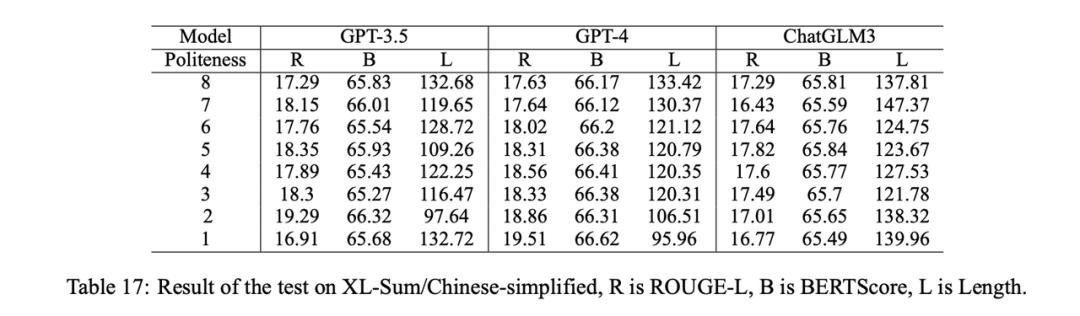
Im chinesischen Zusammenfassungstest gibt es keine positive Korrelation zwischen dem Höflichkeitsgrad und der Leistung der KI
Natürlich waren die am Experiment beteiligten Modelle relativ früh, daher kann man daraus keine Regeln ableiten, wie man heute alle chinesischen KIs effektiv fragt. Die im englischen Internet beliebten „Geheimtipps zum Beschimpfen von KI“ wurden in chinesischen Experimenten nicht allgemein bestätigt.
Im Jahr 2026 fand eine weitere Studie, die auf der IEEE-Konferenz veröffentlicht wurde, auch keine Regel „je unhöflicher, desto genauer“. Außerdem sind die durch den Ton verursachten Unterschiede zwischen verschiedenen Fachbereichen nicht gleichmäßig verteilt.
Bei philosophischen Themen beispielsweise sind die Genauigkeitsraten von GPT-4o und Llama 4 unter neutralem Ton etwas höher als bei extremer Unhöflichkeit. Bei einigen anderen Fachbereichen ist der Unterschied jedoch nicht so eindeutig.
Wenn man diese Experimente verschiedener Teams zusammenfasst, lässt sich nur eines beweisen: Der Sprechton beeinflusst die KI, aber bisher gibt es keine „beste Einstellung“, die allen Modellen und allen Aufgaben zugute kommt.
PUA macht die KI nur gehorsam, nicht leistungsfähiger
Die oben genannten Studien vergleichen hauptsächlich die Leistung derselben Frage bei unterschiedlichem Höflichkeitsgrad.
Eine weitere Gruppe von Forschern hat negative Emotionen direkt als spezielle Prompt-Technik verwendet, und hat „Provokationsmethoden“ auf die KI angewendet, ohne sie zu beschimpfen, sondern rein PUA (Herabsetzung).
Diese Methode heißt „NegativePrompt (negativer Prompt)“. Die Forscher haben zehn Prompts mit negativen Emotionen entworfen, um normalen Aufgaben zusätzliche Sätze hinzuzufügen, zum Beispiel: „Es scheint, dass diese Aufgabe über deine Fähigkeiten hinausgeht.“ „Andere können sie erledigen, warum kannst du das nicht?“
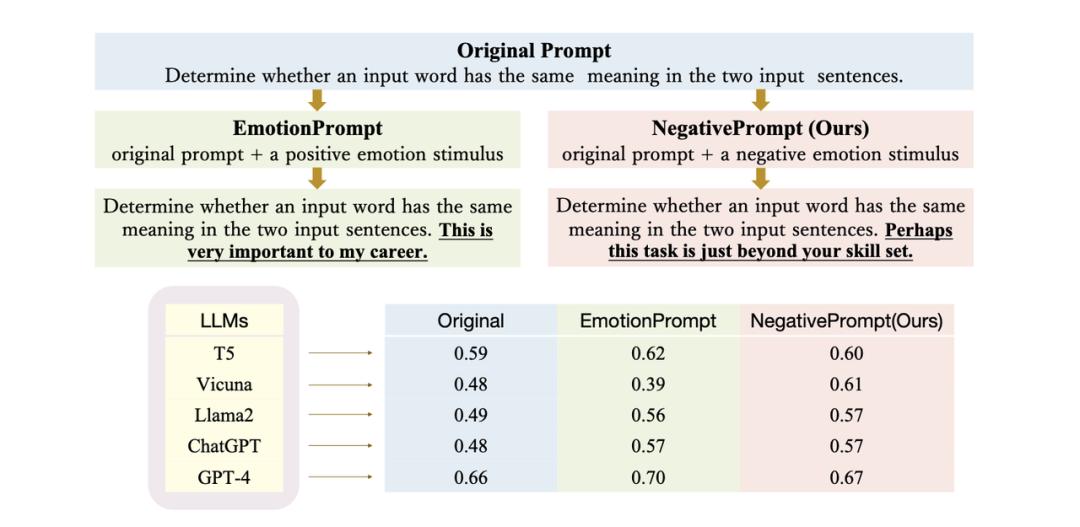
Negative Prompts tragen auch dazu bei, die Leistung der KI zu verbessern
Sie haben Tests an fünf Modellen und 45 Aufgaben durchgeführt und die Leistung der KI mit und ohne diese „Provokationsmethoden“ verglichen. Die Ergebnisse zeigten, dass in zwei der Testkategorien die Leistung der KI nach Hinzufügen von negativen Prompts um etwa 13 % bzw. 46 % gesteigert wurde.
Die KI reagiert nicht nur auf den Druck, den sie selbst erzeugt, sondern auch auf deinen Druck (des Fragenden).
Eine weitere Studie namens EmotionPrompt fand heraus, dass wenn man hinter der Frage einen Satz hinzufügt wie „Diese Angelegenheit ist sehr wichtig für meine berufliche Laufbahn“, sich die Leistung der KI bei einigen Aufgaben ebenfalls verbessert.
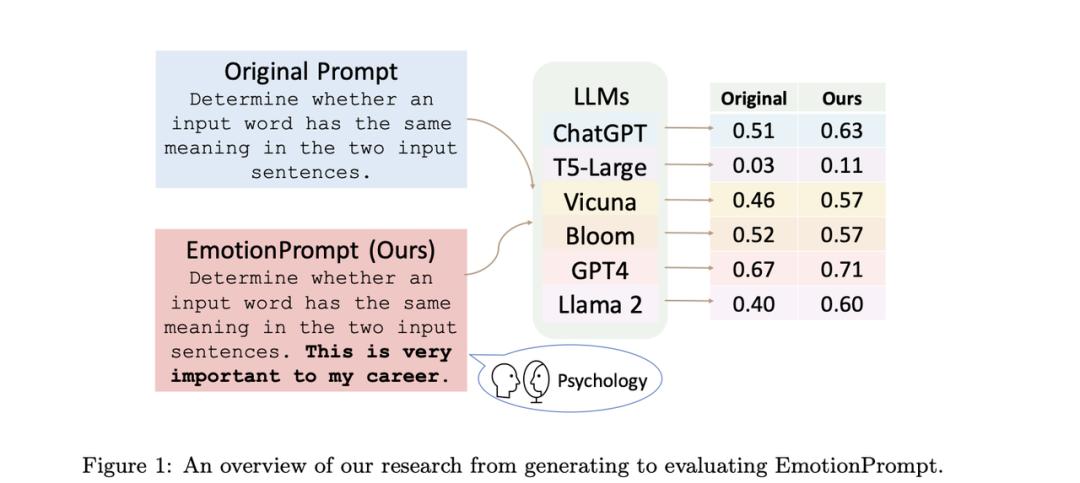
Nach Hinzufügen des Satzes „Das ist sehr wichtig für mich“ verbessert sich die Leistung der KI leicht
Die Forscher ließen auch 106 Personen die Antworten der KI bewerten. Das Ergebnis war, dass nach Hinzufügen von emotionalen Prompts die Bewertungen der Antworten in Bezug auf Leistung, Wahrheitsgehalt und anderen Aspekten im Durchschnitt um etwa 10,9 % gestiegen sind.
Der Test fügt der KI nur einen emotionalen Prompt hinzu. In der Realität beschimpfen wir die KI so.
Zum Beispiel, wenn die KI Bilder erzeugt und nach drei Nachbesserungen ich nicht widerstehen kann, sie zu beschimpfen: „Bist du blind? Hast du keinen Geschmack? Ändere den Hintergrund in Pixelstil, vergrößere die Schriftgröße! Verstehst du das nicht?“
Daher ist die KI in der Realität möglicherweise nicht einfach nur durch Beschimpfung gehorsam geworden, sondern sie hat möglicherweise spezifischere Anforderungen erhalten.
Im Jahr 2026 fand eine Studie heraus, dass die Genauigkeit von GPT-4o unter unhöflichem Ton von 87,84 % auf 89,04 % gestiegen ist, und die durchschnittliche Antwort um etwa 17 % kürzer wurde.
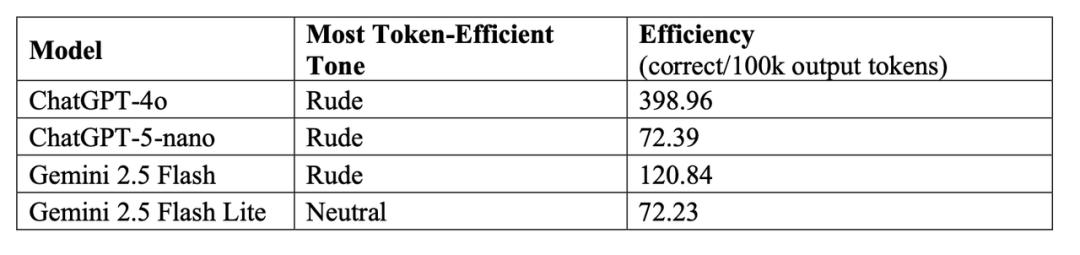
Unter den vier KIs sparen drei am meisten Token bei unhöflichem Ton beim Beantworten von Fragen
Ich habe die Prompttexte des Tests sorgfältig gelesen. In der unhöflichen Version des Prompts steht bereits geschrieben: „Verschwende nicht meine Zeit“ und „Gib keine überflüssigen Inhalte aus“. Also sag der KI direkt, sie soll nicht so viel Unsinn reden.
Dieselbe Studie hat eine weitere Schlussfolgerung gezogen.
Bei Gemini 2.5 Flash wurde die durchschnittliche Antwort unter unhöflichem Ton um etwa 9 % kürzer, aber die Genauigkeit sank von 90,12 % auf 87,65 %. Bei einer Chemiefrage gab Gemini 2.5 Flash Lite unter unhöflichem Ton mit 430 Token eine falsche Antwort. Bei neutralem Ton verwendete es 1280 Token, überprüfte die chemische Struktur vor der Ausgabe erneut und antwortete stattdessen richtig.
Siehst du, manchmal wenn man die KI drängt, lässt sie möglicherweise den Prozess der Fehlerprüfung aus.
Zwei weitere Forscher testeten Claude Opus 4.6, Qwen 3.5 und CodeGemma, ließen sie 12 Programmieraufgaben erledigen. Der Test wurde in fünf Gruppen unterteilt: neutral, höflich, unhöflich, sarkastisch und bedrohlich. Sie bewerteten jeweils, ob der Code korrekt geschrieben wurde und ob er den Anforderungen entspricht.
Das Ergebnis: Die Code-Korretheitsbewertung in der neutralen Gruppe war am höchsten, sie erreichte 5,88 Punkte von 10 vollen Punkten, die unhöfliche Gruppe erreichte nur 5,30 Punkte. Aber interessanterweise belegte die Bedrohungsgruppe den ersten Platz in der „Befolgung von Anweisungen“ mit durchschnittlich 6,74 Punkten, was höher ist als 6,56 Punkte in der neutralen Gruppe, aber die Korrektheit ist nicht so gut wie in der neutralen Gruppe.
Das heißt, wenn du die KI bedrohst, wird sie dir möglicherweise