Der 27-jährige Assistenzprofessor der Tsinghua-Universität ist in das Feld der selbstevolutionären KI eingetreten, und sein erstes 35B-Modell wurde gerade vorgestellt.
Wo wird der nächste Durchbruch der KI kommen? Branchengrößen haben die Einschätzung bereits vor ein oder zwei Jahren abgegeben.
Sam Altman spricht in „The Gentle Singularity“ [1] davon, dass KI den Menschen dabei helfen wird, leistungsfähigere KI-Systeme zu bauen, und den Trend, bei dem KI an der Verbesserung von KI mitwirkt, als frühe Form der rekursiven Selbstverbesserung (RSI) betrachtet. Wenn KI in der Lage ist, an der Entwicklung der nächsten KI-Generation teilzunehmen, eröffnet sich für den technischen Fortschritt die Chance, einen neuen beschleunigenden Zyklus zu bilden.
Dario Amodei hat in „Machines of Loving Grace“ [2] ebenfalls eine mutigere Extrapolation vorgenommen: KI könnte die biologischen Fortschritte der nächsten 50 bis 100 Jahre auf 5 bis 10 Jahre komprimieren. Hinter dieser Einschätzung steckt das enorme Potenzial, das in der tiefen Beteiligung von KI an der wissenschaftlichen Forschung steckt.
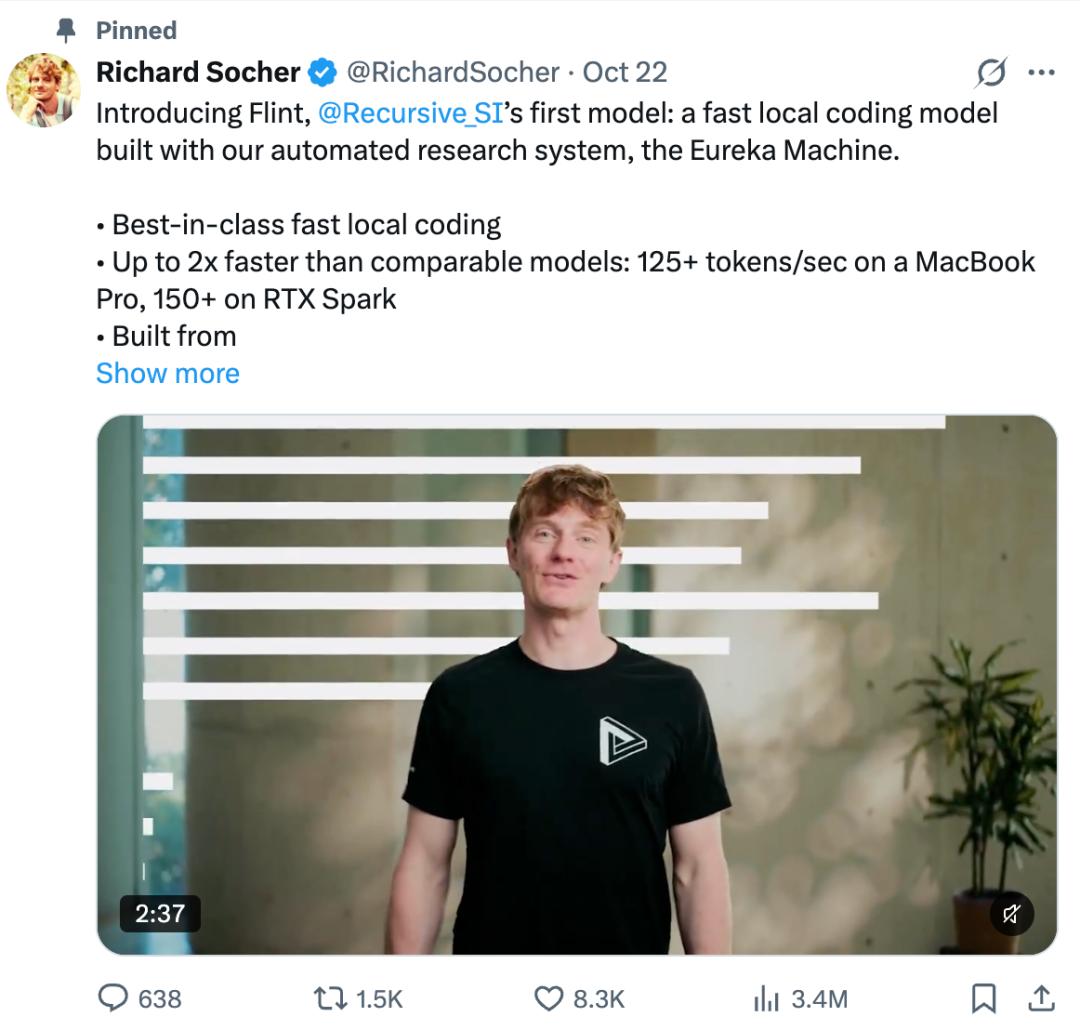
Heute beginnen diese Vorstellungen, zu konkreten Produkten zu werden. Am 22. Oktober veröffentlichte Recursive SuperIntelligence, das von Tian Yuandong mitbegründet wurde, Flint – ein MoE-Programmiermodell mit 40B-Parameterumfang, bei dem jeder Token nur 2,5B Parameter aktiviert und das lokal auf Notebooks ausgeführt werden kann.
Das automatisierte Forschungssystem des Unternehmens, Eureka Machine, war an mehreren Phasen der Modellentwicklung beteiligt.
Auf diesem sich rasant erwärmenden Wettbewerbsfeld hat ein inländisches Team eine neue Karte ausgespielt.
Apex Intelligence, gegründet von Chen Yongchao, einem 27-jährigen Assistenzprofessor an der Fakultät für Künstliche Intelligenz der Tsinghua-Universität, hat gerade sein erstes 35B-Modell Apex-35B-V1.0 veröffentlicht.
Dies ist ein Modell, das sowohl allgemeine Fähigkeiten als auch Forschungsfähigkeiten berücksichtigt. Das Modell Apex-35B-V1.0 kann sowohl reguläre Aufgaben wie Codierung, Agenten, Frage-Antwort und Tiefensuche erledigen, als auch tief in KI-Forschung, Computational Science und Robotersimulation eingebunden werden.
In 21 Benchmark-Tests liegt Apex-35B-V1.0 im Vergleich zum gleich großen Qwen3.6-35B-A3B in 20 Punkten vorne; im Vergleich zu Recursive Flint (40B) erreicht es 18 führende Ergebnisse und ein gleichwertiges Ergebnis, womit es das SOTA-Niveau erreicht. Sogar in einigen anspruchsvollen Bewertungen übertrifft es großformatige Modelle mit Parameterumfängen von bis zu 500B und 800B, was die global wettbewerbsfähigen Fähigkeiten des Modells zeigt.
Technischer Blog: https://www.apexin.com/apex-35b/
Github-Link: https://github.com/apexin-ai/Apex-35B-V1.0
Hugging Face-Link: https://huggingface.co/Apexintelligence-AI/Apex-35B-V1.0
Dieses Modell wurde auf Basis von Qwen3.6-35B-A3B mit Zwischentraining und Nachtraining weiterentwickelt, wobei eine große Menge an eigenen Datensätzen und Forschungspfaden von Apex Intelligence hinzugefügt wurde. Noch bemerkenswerter ist jedoch seine Konstruktionsweise.
Apex Intelligence hat die rekursive Selbstverbesserung (RSI) in die Modellentwicklung eingeführt, KI an Experimenten und Ergebnisanalysen teilhaben lassen und versucht, validierte wirksame Ergebnisse für nachfolgende Entwicklungen zu nutzen.
Dieses Unternehmen, das erst im Juni dieses Jahres gegründet wurde, hat in nur wenigen Monaten zwei Finanzierungsrunden mit einem Gesamtbetrag von fast 400 Millionen Yuan abgeschlossen und wird vom Kapitalmarkt stark nachgefragt. Nun hat es in nur vier Monaten sein erstes global wettbewerbsfähiges Modell vorgestellt – Apex Intelligence hat mit einem konkreten Leistungsnachweis die Erwartungen der Außenwelt erfüllt.
Zuerst zu den Benchmark-Ergebnissen: Führend in der gleichen Größenordnung, übertrifft in einigen Aufgaben 800B-Großmodelle
Bevor wir auf die technischen Details eingehen, werfen wir einen Blick darauf, welches Ergebnis diese Entwicklungsmethode letztendlich geliefert hat.
Heutzutage sind Modelle im 35B-Bereich keine Seltenheit mehr. Bei einem Modellumfang von 35B Parametern ist es jedoch selbst mit ausgereiften Entwicklungsprozessen eine große Herausforderung, bei begrenztem Parameterumfang sowohl allgemeine Fähigkeiten wie Codierung und Agenten zu berücksichtigen als auch komplexe Forschungsaufgaben zu bewältigen. Darüber hinaus hat Apex-35B-V1.0 einen neuen Weg erforscht, bei dem KI tief in die Modellentwicklung eingebunden wird und der Entwicklungsprozess durch rekursive Selbstverbesserung (RSI) kontinuierlich iteriert wird.
Um die Stärke von Apex-35B-V1.0 umfassend zu demonstrieren, prüfen wir die Fähigkeiten des Modells anhand von insgesamt 21 Benchmark-Bewertungen in den vier Fähigkeitsbereichen Forschung, Agenten, Codierung und Schlussfolgerung.
Diese vier Kategorien decken das gesamte Fähigkeitsspektrum von KI-Modellen ab. Die Forschungsfähigkeit bestimmt, ob das Modell fachliche Probleme verstehen und Lösungsansätze erkunden kann; die Agentenfähigkeit ermöglicht es dem Modell, Tools aufzurufen, Aufgaben auszuführen und sich kontinuierlich anhand von Feedback anzupassen; die Codierungsfähigkeit wandelt Forschungsideen in ausführbaren Code und Experimente um; die Schlussfolgerungsfähigkeit unterstützt die Analyse und Beurteilung komplexer Probleme.
Für ein Modell, das sowohl allgemeine Fähigkeiten als auch Forschungsfähigkeiten berücksichtigt, muss es nicht nur bei alltäglichen Aufgaben hervorragende Leistungen erbringen, sondern auch mehrere Fähigkeiten kombinieren können, um komplexere Forschungsarbeiten abzuschließen.
Beginnen wir mit den Bewertungsergebnissen, um zu sehen, wie stark Apex-35B-V1.0 wirklich ist.
1. Forschungsfähigkeit: Führend in allen 6 Bewertungen gegenüber Modellen gleicher Größenordnung
Für ein Modell, das an komplexen Forschungsaufgaben teilnehmen kann, liegt die echte Herausforderung darin, fachliche Probleme zu verstehen, angemessene Lösungsvorschläge zu unterbreiten und Forschungsideen in praktische Ergebnisse umzusetzen.
In den 6 Bewertungen, die die Forschungsfähigkeit am besten widerspiegeln, liegt Apex-35B-V1.0 sowohl vor Qwen3.6-35B als auch vor Flint. Und in einigen Benchmark-Tests übertrifft die Leistung von Apex-35B-V1.0 sogar DeepSeek-V4.1-Flash mit 500B Parametern und GLM-5.3 mit 800B Parametern.
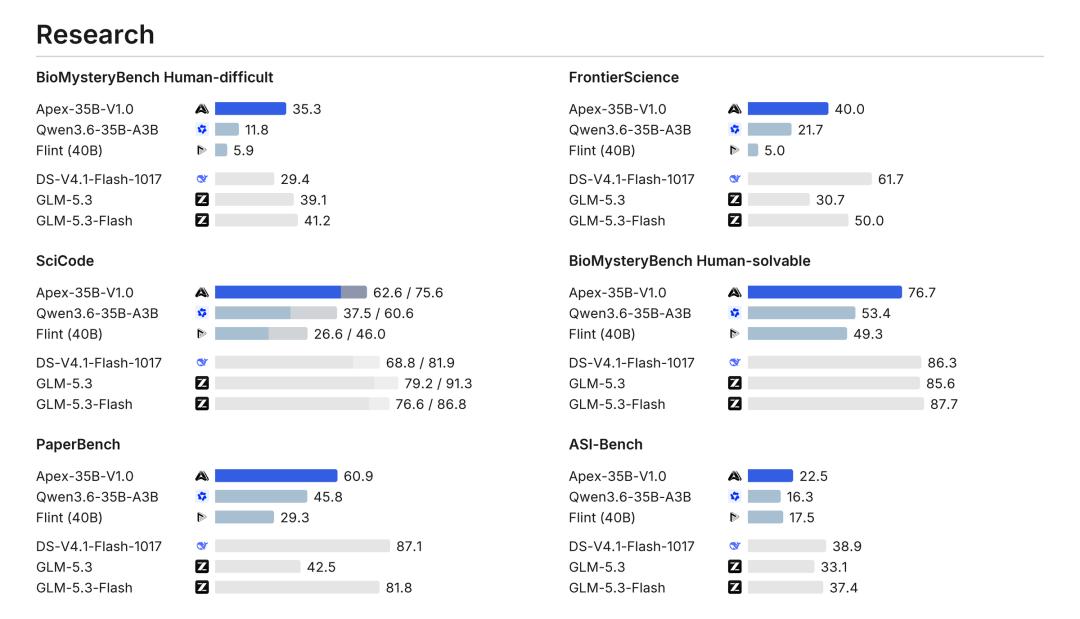
In diesen beeindruckenden Daten verdienen zwei Bewertungen besondere Aufmerksamkeit.
Die erste ist FrontierScience, das 2025 von OpenAI eingeführt wurde. Diese Bewertung misst speziell die Fähigkeit von KI, schwierige wissenschaftliche Probleme zu lösen. Die Aufgaben erstrecken sich über Bereiche wie Physik, Chemie und Biologie, umfassen sowohl Probleme auf dem Niveau internationaler Olympiaden als auch komplexe Aufgaben, denen Forschende in der Praxis begegnen können – weitaus anspruchsvoller als die Beantwortung regulärer Wissensfragen.
Apex-35B-V1.0 erzielte in dieser Bewertung 40,0 Punkte, das 8-fache von Flint, was einer Steigerung von etwa 84 % gegenüber dem Basis-Qwen-Modell entspricht. Noch erfreulicher ist, dass es GLM-5.3 mit insgesamt 753B Parametern übertrifft, das 30,7 Punkte erzielte.
Die andere ist PaperBench von OpenAI, das direkt prüft, ob KI eine KI-Forschungsarbeit von Grund auf reproduzieren kann.
Diese Bewertung wählt 20 Spotlight- und Oral-Arbeiten der ICML 2024 aus und verlangt von dem Agenten, die Methoden der Arbeit zu verstehen, Code zu schreiben, Experimente durchzuführen und die Forschungsergebnisse der ursprünglichen Arbeit so weit wie möglich zu reproduzieren. Um den Abschlussgrad zu messen, haben die Forscher diese Aufgaben in 8316 bewertbare Punkte unterteilt.
In dieser anspruchsvollen Prüfung erzielte Apex-35B-V1.0 60,9 Punkte, etwa das 2,1-fache von Flint, und liegt auch weit über den 42,5 Punkten von GLM-5.3.
Diese Ergebnisse sind wirklich erfreulich. Ein Modell mit nur 35B Parametern kann eine so starke Leistung bei anspruchsvollen Forschungsaufgaben entfalten. Insbesondere in Szenarien wie der Lösung fachlicher Probleme und der Reproduktion von Forschungsarbeiten hat Apex-35B-V1.0 in einigen Bewertungen das 800B-Parameter-Großmodell übertroffen, was die von Apex Intelligence erforschte RSI-Techniklinie noch glänzender macht.
2. Agenten und Codierung: Stabile allgemeine Fähigkeiten
Die Agentenfähigkeit bestimmt, ob das Modell selbstständig Tools aufrufen, mehrstufige Aufgaben organisieren und sein Handeln anhand von Feedback anpassen kann; die Codierungsfähigkeit ermöglicht es ihm, Code direkt zu schreiben und zu ändern, Experimente durchzuführen und sogar komplexe Software-Engineering-Probleme zu bearbeiten.
In 6 Agenten-Bewertungen liegt Apex-35B-V1.0 ebenfalls umfassend vor Modellen gleicher Größenordnung. Es liegt in allen 6 Agenten-Bewertungen vor dem Basis-Qwen3.6-35B-A3B und erreicht im Vergleich zu Flint 5 führende Ergebnisse und 1 gleichwertiges Ergebnis.
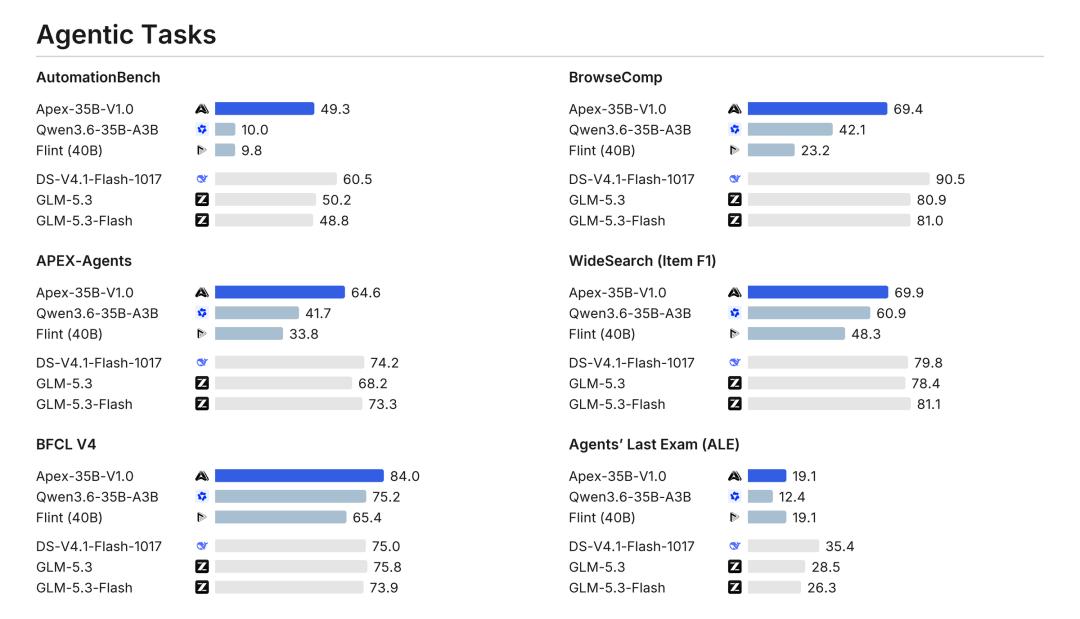
Das herausragendste Ergebnis ist dabei BFCL V4 (Berkeley Function Calling Leaderboard), das von der University of California, Berkeley, entwickelt wurde.
Dies ist einer der repräsentativen Benchmarks zur Messung der Tool-Aufruffähigkeit von Großmodellen. Die Bewertung beschränkt sich nicht darauf, ob das Modell eine Funktion korrekt aufrufen kann, sondern untersucht zudem komplexe Agentenaufgaben wie Mehrrunden-Interaktion, Informationsabruf und Speichervorgänge. Das bedeutet, dass das Modell nicht nur wissen muss, welches Tool aufgerufen werden soll, sondern auch verstehen muss, wann es aufzurufen ist, wie Parameter übergeben werden und wie die Korrektheit bei aufeinanderfolgenden Operationen aufrechterhalten wird.
Apex-35B-V1.0 erzielte 84,0 Punkte bei BFCL V4 und übertraf alle verglichenen Modelle. Selbst gegenüber den größeren Modellen GLM-5.3 und DeepSeek-V4.1-Flash liegt es um 8,2 bzw. 9,0 Punkte vorne.
Codierungsfähigkeit ist längst ein Pflichtprüfpunkt für Großmodelle. Heutzutage beschränken sich anspruchsvolle Codierungs-Benchmarks nicht mehr darauf, einige Zeilen korrekten Code zu generieren, sondern umfassen das Verständnis komplexer Codebasen, die Änderung bestehender Projekte, die Bedienung von Terminalumgebungen und die Validierung von Ergebnissen durch Tests.
In den Bewertungen der Codierungsfähigkeit liegt Apex-35B-V1.0 in 3 von 5 Bewertungen vor Modellen gleicher Größenordnung, darunter SWE-Atlas QnA, Terminal-Bench 2.1 und SWE-bench Pro v2.
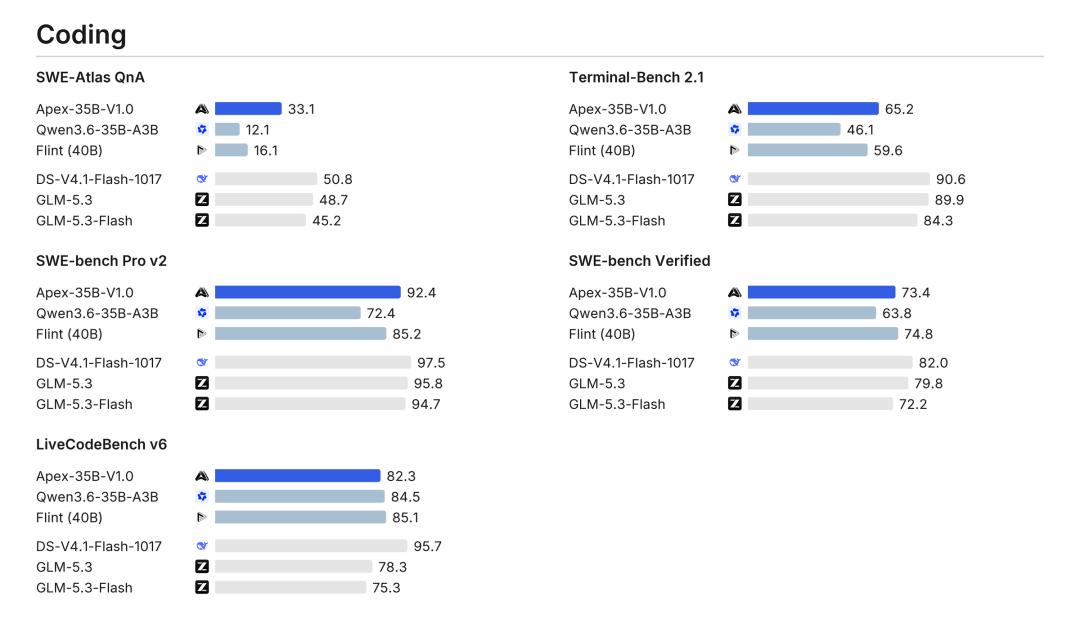
Terminal-Bench 2.1 ist eine anspruchsvolle Bewertung. Es verlangt von dem Agenten, Aufgaben wie Software-Engineering und Systemkonfiguration in einer echten Befehlszeilenumgebung zu erledigen. Das Modell muss Befehle selbstständig ausführen, Fehler behandeln und schließlich Ergebnisse liefern, die die Validierung bestehen. In dieser Bewertung erzielte Apex 65,2 Punkte und übertraf Flint, das auf Agentic Coding spezialisiert ist.
Insgesamt liegt Apex in 3 von 5 Codierungs-Bewertungen vor Flint. Dabei erreicht SWE-Atlas QnA einen Wert von 33,1, etwa das Doppelte von Flint; SWE-bench Pro v2 erreicht 92,4 Punkte, ebenfalls höher als die 85,2 Punkte von Flint.
Apex kann nicht nur Tools aufrufen und Aufgaben planen, sondern verfügt auch über die Fähigkeit, Lösungen in tatsächlichen Code und technischen Operationen umzusetzen. Wenn KI an der Modellentwicklung und komplexen Forschungsaufgaben teilnimmt, ist diese Fähigkeit, Probleme zu analysieren und praktisch umzusetzen, die wichtige Grundlage für ihre tatsächliche Wirkung.
3. Schlussfolgerungsfähigkeit