Gerade wurde Googles Weltmodell Genie 4 im Praxistest erprobt: Es generiert Spiele innerhalb von 30 Sekunden, unterstützt Echtzeit-Interaktion mit 24 fps und ermöglicht Anpassungen während des laufenden Spiels.
Was passiert, wenn KI nicht mehr nur ein Video erzeugt, sondern direkt eine Welt schafft, die man betreten, jederzeit verändern und sogar mit den Figuren darin kommunizieren kann?
Das neueste von Google veröffentlichte Genie 4 treibt diese Vorstellung in die Realität um.
Am 27. Oktober Ortszeit hat Google DeepMind offiziell das neue Weltmodell Genie 4 vorgestellt und es als „das bislang realistischste und interaktivste Weltmodell“ bezeichnet.
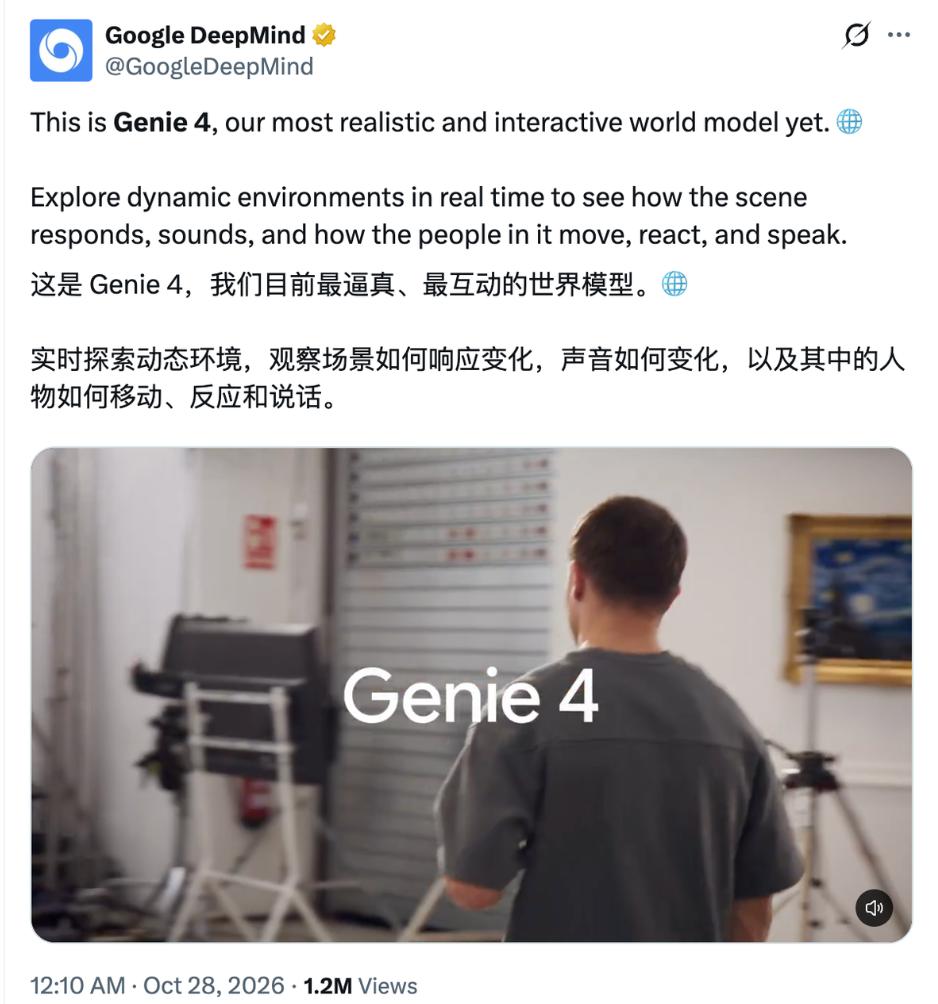
Im Vergleich zu Genie 3, dessen vorherige Hauptdurchbrüche bei der Echtzeit-Szenengenerierung und Interaktion lagen, führt das neue Modell zusätzlich native Audiogenerierung, Echtzeitsteuerung durch natürliche Sprache sowie komplexe Physik- und Figurenverhaltenssimulation ein und realisiert mit Hilfe der Gemini-Modellreihe die schrittweise Ableitung von mehrstufigen Ereignissen.
In der offiziellen Demo steuern die Nutzer die Navigation und die Kamera über die Tastatur und ändern die Szene per Text-Prompt: das Wetter anpassen, die Kamera bewegen, Personen oder Objekte zur Szene hinzufügen. Zum Beispiel kann man ein rosa Seidenband auf einer Wiese erscheinen lassen oder die Kamera in den Korb eines Heißluftballons über dem antarktischen Eisschild platzieren. Die Szene reagiert in Echtzeit, und die Charaktere handeln entsprechend der neuen Einstellung weiter.
Hinter diesen Fähigkeiten übernimmt die Gemini-Modellreihe die Steuerung. Gemini Omni sorgt dafür, dass das Bild dem Aussehen und Verhalten der realen Welt entspricht, während andere Gemini-Modelle die Anfragen in Aktionen übersetzen, komplexe Ereignisse planen, das Bild beobachten und den Fortschritt verfolgen. Wenn der Nutzer die Anweisung ändert, passt Gemini den Plan sofort vor Ort an.
In einer weiteren Demo steuert Gemini 4 Argon sogar Genie 4 und simuliert Schritt für Schritt den Prozess, bei dem ein humanoider Roboter Dame spielt.
Man kann erkennen, dass dies nicht mehr nur die traditionelle KI-Videogenerierung ist, sondern der Schritt hin zu einem interaktiven, steuerbaren und für das KI-Training geeigneten Weltensimulationssystem. Derzeit ist Genie 4 für eine kleine Gruppe vertrauenswürdiger Tester für eine Forschungsvorschau geöffnet und wird später schrittweise für Abonnenten von Google AI Ultra sowie frühe Partner von Gemini API und Google AI Studio bereitgestellt.
In Bezug auf die Parameter beträgt die maximale Dauer des interaktiven Erlebnisses bei einer einzelnen Generierung von Genie 4 bis zu 2 Minuten, während die Obergrenze der Vorgängerversion Genie 3 bei 1 Minute lag. Diese Zahl wirkt unscheinbar, reicht aber für Spieleentwickler zur Überprüfung einzelner Spielabschnitte und für Kreative im Filmbereich zur Vorschau einzelner Einstellungen völlig aus, um die grundlegendsten Testanforderungen abzudecken.
Die KI-Welt beginnt, „lebendig“ zu werden
Google zeigt bei dieser Vorstellung vier Aspekte der Fähigkeitserweiterung: Echtzeitveränderung der Welt, Physik- und Figurenverhaltenssimulation, native Klangerzeugung sowie komplexe Ereignisableitung in Kombination mit Gemini.
Einige dieser Demos kommen bereits der Kombination aus interaktiven Spielen und realen Bildern sehr nahe.
Zuerst müssen Nutzer nicht die gesamte Szene im Voraus entwerfen, sondern können die Welt jederzeit während des Generierungsprozesses verändern.
In einer Demo steht ein Saxophonist in braunem Anzug auf einer schwimmenden Plattform mitten auf einem See. Um ihn herum gibt es nebelverhangene Wälder, langsam fließendes Wasser und eine Kugel, die warmes Licht ausstrahlt.
Die Figur spielt kontinuierlich, wobei Fingerbewegungen, Atmung und Körperbewegungen natürlich ineinander übergehen, während die Kamera sich unabhängig bewegen und die gesamte Umgebung aus verschiedenen Positionen beobachten kann. Der entscheidende Punkt hierbei ist nicht, das Bild wie einen Film aussehen zu lassen, sondern dass die Kamera die Szene frei erkunden kann und gleichzeitig die räumlichen Beziehungen zwischen Figuren, Objekten und der umgebenden Umgebung beibehalten werden.
Nutzer können zudem über die Tastatur Bewegung und Perspektive steuern und per Textanweisung in Echtzeit das Wetter ändern sowie neue Personen oder Objekte hinzufügen. Gemini versteht diese Anforderungen entsprechend der aktuellen Umgebung und hilft, die Entwicklung der Szene aufrechtzuerhalten, wenn der Nutzer keine weiteren Eingaben macht.
Zweitens sind Objekte nicht nur Dekoration im Bild, sondern Figuren und Umgebung zeigen komplexere Bewegungsgesetze.
In einer weiteren von Google gezeigten Demo liegt eine ganze Wassermelone auf einem Steinsockel, Ahornsamen wirbeln herunter und fallen auf die Wiese; es gibt auch einen ländlichen japanischen Bahnhof voller Passagiere, wo Menschen auf dem Bahnsteig gehen, auf den Zug warten und zusammen mit der Umgebung eine dynamische Szene bilden.
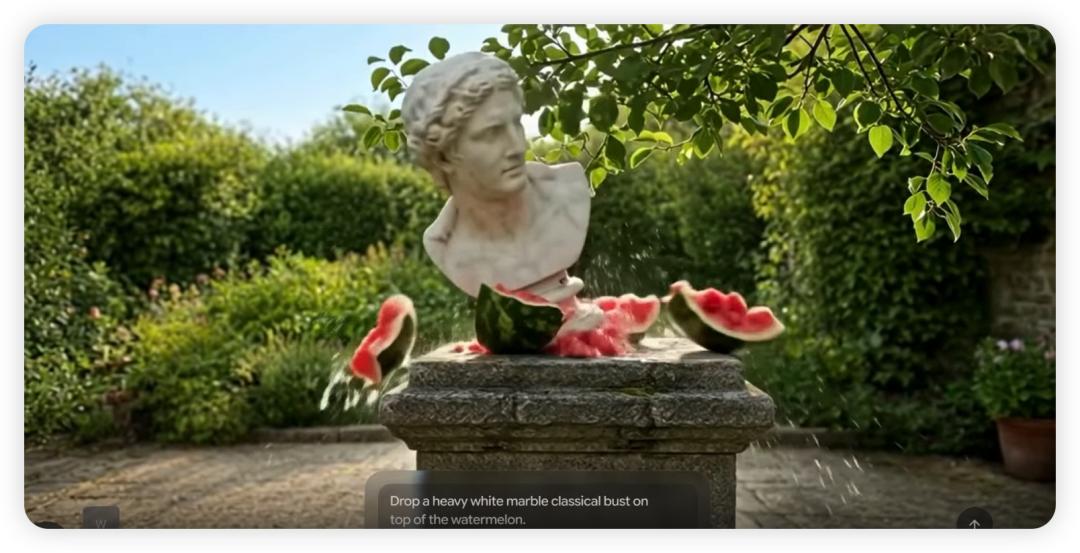
Google betont, dass Genie 4 die Simulationsfähigkeit für physikalische Phänomene wie Aerodynamik und Kollisionen verbessert hat, insbesondere bei den Bewegungen von Figuren wurden deutliche Fortschritte erzielt. Das Modell kann natürlichere menschliche Bewegungen erzeugen, sodass Charaktere entsprechend der Umgebung reagieren und in Echtzeit gesteuert werden können.
Allerdings basiert die physikalische Simulation hier immer noch auf den vom Modell gelernten Weltgesetzen, um Ergebnisse zu generieren, was nicht bedeutet, dass alle physikalischen Prozesse exakt berechnet werden.
Drittens verfügt die KI-Welt bei Genie 4 zum ersten Mal über nativ erzeugte Klänge.
In der Demo reitet man auf dem Rücken eines Drachen durch Berge, umgeben von anderen Reitern. Man fühlt sich an, als säße man wirklich auf dem Rücken des Drachen und fliege mit einer per Prompt festgelegten Geschwindigkeit von 140 km/h durch die Berge. Der WASD-Hinweis in der unteren linken Ecke zeigt an, dass man diese generierte Szene tatsächlich „spielt“.
Begleitet wird der Flug nicht nur von schnell vorbeiziehenden Bergen und Burgen, sondern auch vom Dröhnen der schlagenden Drachenflügel, dem pfeifenden Luftstrom in großer Höhe und Geräuschen von vulkanischen Aktivitäten in der Ferne. Diese Klänge werden nicht nachträglich zur Demo hinzugefügt, sondern direkt von Genie 4 erzeugt.
Darüber hinaus kann das Modell in Echtzeit Dialoge von Figuren generieren. Die Charaktere in der Szene können sprachlich auf Nutzereingaben oder in der Welt stattfindende Ereignisse reagieren, anstatt nur vorbereitete Zeilen zu wiederholen.
Für virtuelle Charaktere, interaktives Storytelling und sogar Spieleentwicklung ist diese Veränderung sehr wichtig. Entwickler müssen nicht mehr unbedingt Charaktere erstellen, bei denen jede Zeile und jede Reaktion festgeschrieben ist, sondern es kann sich um eine simulierte Figur handeln, die kontinuierlich Verhalten und Dialoge entsprechend der sich ändernden Situation erzeugt.
In einem von der Entwicklerin Justine Moore (zugleich Partnerin bei a16z) real erzeugten Video wird eine komplexere, vollständig in Echtzeit generierte Spielwelt gezeigt. Die gesamte Szene wird aus einem einzigen Prompt generiert – Umgebung plus Charaktere – danach können Ereignisse per Prompt geändert werden.
In dem Video erkundet ein Charakter in Taucherausrüstung eine Höhle, unter seinen Füßen liegen verstreute Goldmünzen, daneben steht ein Holzfass. Oben auf dem Bildschirm steht der Hinweis „Describe changes to your world...“, daneben gibt es mehrere Aufgabenoptionen wie „Ai Suggested“ und „Giant Kraken Reach“. Das FPS-Panel auf der rechten Seite zeigt: Aktuell 24,6 FPS, Minimum 17, Durchschnitt 23,8.
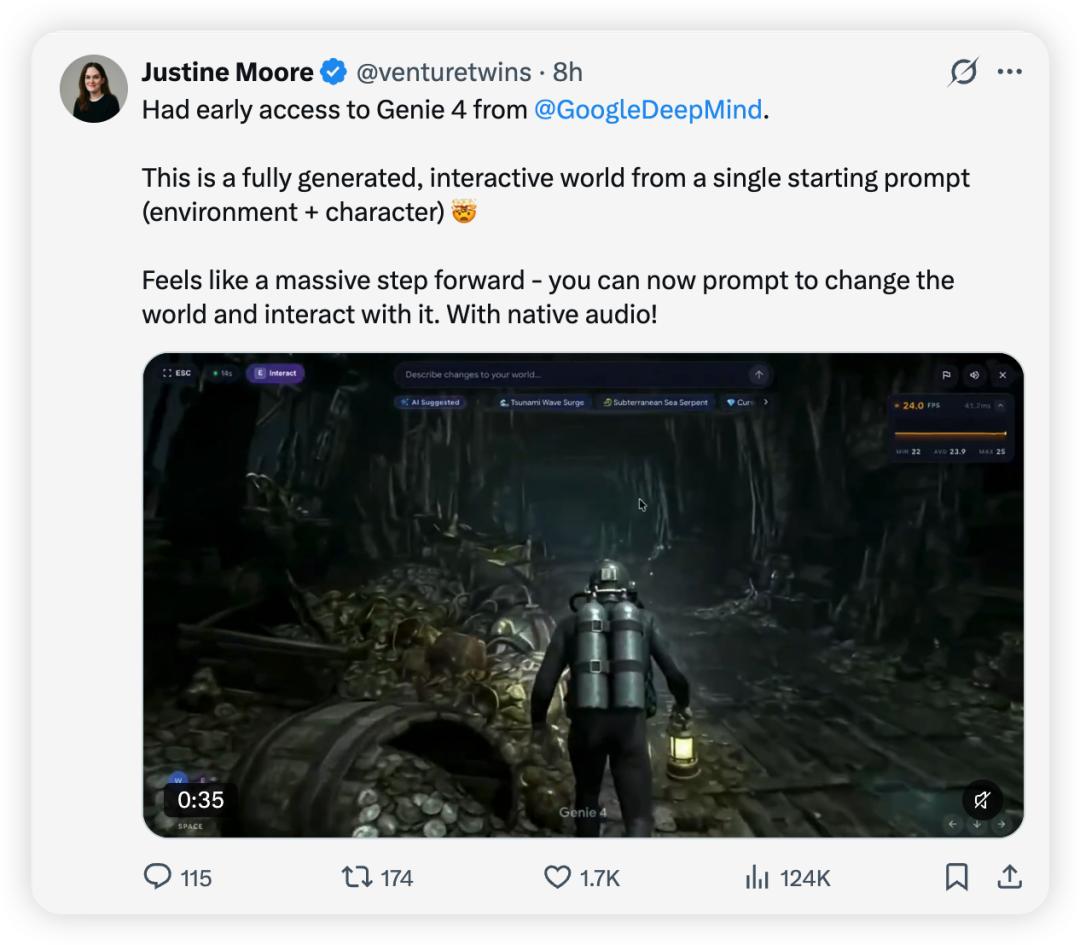
Justine Moore gibt an, dass sie vorab Zugriff auf Genie 4 erhalten hat und die Erstellung einer Welt normalerweise weniger als 30 Sekunden dauert, mit einem Echtzeit-Interaktionsfenster von etwa 2 Minuten. Nutzer können sich per Tastatur und Maus bewegen oder die Welt per natürlicher Sprache verändern, zum Beispiel das Wetter anpassen, die Kamera bewegen oder eine Person hinzufügen. Die Gemini-Modellreihe verarbeitet diese Anweisungen und sorgt für die Kohärenz der Szene.
Darüber hinaus zerlegt Gemini 4 Argon die Aufgabe in eine Reihe von Schritten und leitet Genie 4 anschließend per Textanweisung an, den Ausführungsprozess schrittweise darzustellen. Mit Fortschreiten der Simulation kann das System die nachfolgenden Schritte weiter anpassen. Das entspricht einem Modell, das gut in Schlussfolgerung und Planung ist, welches ein anderes Modell steuert, das gut in der Echtzeitgenerierung von Umgebungen ist.
Technische Enthüllung von Genie 4
Aus technischer Sicht versucht Google, zwei lang bestehende Probleme von Weltmodellen zu lösen: Wie kann sich die simulierte Umgebung in Echtzeit entsprechend den Aktionen des Nutzers ändern und wie kann die logische Konsistenz aufeinander folgender Ereignisse aufrechterhalten werden. Dahinter wirken zwei „Gehirne“ zusammen: Gemini ist für das Denken zuständig, Genie für die Generierung der physischen Welt.
Um diese Veränderung zu verstehen, muss zuerst der Unterschied zwischen Weltmodell und gewöhnlichem Videomodell geklärt werden.
- Traditionelle Videogenerierungsmodelle erzeugen hauptsächlich Bilder mit relativ festgelegtem Zeitbereich basierend auf Bedingungen wie Text oder Bildern.
- Weltmodelle müssen darüber hinaus Fragen beantworten: Was passiert mit dem Sichtfeld, wenn der Nutzer nach links geht? Was passiert als Nächstes, wenn jemand ein Objekt vom Tisch stößt? Existiert die vorherige Umgebung noch, wenn der Charakter den Raum verlässt und wieder zurückkommt?
Diese Fähigkeit betrifft zwei Schlüsselkonzepte: Aktionsbedingte Generierung (Action-conditioned Generation) und Weltzustandskonsistenz (World Consistency).
Ersteres bedeutet, dass das nächste Bild nicht nur aus dem vorherigen vorhergesagt werden darf, sondern auch berücksichtigen muss, welche Aktion der Nutzer gerade ausgeführt hat. Zweiteres verlangt, dass das Modell sich die bereits generierte Umgebung merkt und nach Möglichkeit unbegründete Veränderungen von Figuren, Objekten oder räumlichen Beziehungen im Laufe der Zeit vermeidet.
Tatsächlich hat Google bei der Vorstellung von Genie 3 im Jahr 2025 bereits eine Echtzeit-Interaktionsgenerierung mit 24 Bildern pro Sekunde und 720p-Auflösung erreicht und unterstützt Umgebungsimulationen von mehreren Minuten Dauer. Genie 3 verwendet eine frameweise autoregressive Generierungsmethode, die nicht auf einem vorab erstellten vollständigen expliziten 3D-Szenario basiert, sondern die nachfolgenden Inhalte kontinuierlich basierend auf vorherigen Bildern und Nutzeraktionen generiert.
Dies bringt jedoch auch neue technische Herausforderungen mit sich: Je länger die Generierung dauert, desto mehr historische Informationen muss das Modell berücksichtigen, und Fehler können sich stetig ansammeln. Wenn der Nutzer zum Beispiel vor einer Minute an einem Gebäude vorbeigegangen ist und jetzt zurückkehrt, muss das Modell das Aussehen und die Position des Gebäudes möglichst unverändert beibehalten.
Genie 4 setzt die Richtung der Echtzeit-Weltgenerierung fort, aber die auffälligste Veränderung diesmal ist, die Gemini-Modellreihe in den Simulationsprozess einzubeziehen. Laut offiziellen Angaben umfasst das gesamte System mindestens drei Fähigkeitsebenen.
Erste Ebene: Genie 4 ist für die Echtzeitgenerierung von visuellen Inhalten, Klängen und dynamischen Umgebungen zuständig. Es muss basierend auf dem aktuellen Weltzustand und Eingaben kontinuierlich neue Bilder und Klänge erzeugen und Figurenbewegungen, Umgebungsveränderungen sowie Interaktionsergebnisse darstellen.
Zweite Ebene: Gemini Omni stärkt die Verbindung zwischen der simulierten Welt und den realen Gesetzen. Google gibt an, dass Gemini Omni die Grundlage für das Aussehen und Verhalten der realen Welt für die Simulation liefert.
Dritte Ebene, der wichtigste Durchbruch diesmal: Gemini 3.8 Flash fungiert als Echtzeit-Leitagent. Während Genie 4 die Umgebung kontinuierlich generiert, beobachtet Gemini 3.8 Flash die Szene ständig, zerlegt komplexe Ziele in mehrere Schritte und prüft anhand der neu generierten Bilder, ob der aktuelle Schritt abgeschlossen ist.
Sobald der Nutzer eingreift oder sich der Weltzustand ändert, kann Gemini den Plan neu anpassen. Die Bedeutung dieses Mechanismus liegt darin, die sprachliche Schlussfolgerungsfähigkeit großer Modelle in den Generierungsprozess dynamischer Umgebungen einzubeziehen. Bislang konnte ein Weltmodell, selbst wenn es realistische Roboterbewegungen erzeugen konnte, nicht unbedingt sicherstellen, dass zwischen mehreren Bewegungen die korrekte Aufgabenlogik besteht. Jetzt kann Gemini kontinuierlich Planung, Überprüfung und Anpassung durchführen, sodass das System eine höhere Chance hat, die Kohärenz komplexer Ereignisse aufrechtzuerhalten.
Bemerkenswerterweise erforscht Google noch weitergehende Kombinationen.
In der Demo, in der der Apollo-Humanoide Roboter Schach spielt, ist Gemini 4 Argon an der Aufgabenplanung beteiligt. Es zerlegt das Nutzerziel in Schritte und übergibt die entsprechenden Textanweisungen an Genie 4, um den Simulationsprozess anzutreiben.
Google nennt diese Richtung die zukünftige „Hybrid-Weltmodelle“ (Hybrid World Models). Der Grundgedanke besteht darin, die strukturierte logische Schlussfolgerung, die Code- und Sprachmodelle gut beherrschen, mit der reichen sensorischen Simulationsfähigkeit zu kombinieren, die pixelbasierte Generierungsmodelle gut beherrschen.
Mit anderen Worten: Ersteres versteht, wie sich Ereignisse entwickeln sollen, Letzteres stellt dar, wie dieser Prozess in der realen Welt aussehen könnte.
Dieser Artikel stammt aus dem WeChat-Off