Nomura: Der globale ChatGPT-Moment für Roboter steht unmittelbar bevor.
In der jüngeren Vergangenheit erlebt der Sektor humanoider Roboter fortwährend positive Impulse: Unitree Robotics erhöhte die Preise zeitweilig um 20 %, was die Marktaufmerksamkeit für die Roboterindustrie stark ansteigen ließ.
Vor kurzem veröffentlichte Nomura einen Forschungsbericht über globale Roboter, dessen Aussagen relativ nüchtern sind und eine noch wichtigere Einschätzung treffen: Der eigentliche „ChatGPT-Moment“ der Roboter wird nicht durch eine Pressekonferenz verkündet, sondern leise durch eine Reihe von Betriebskennzahlen und einen Datenrad bestätigt.
Der Forschungsbericht vergleicht die aktuelle Robotertechnik mit dem AlexNet-Moment im Jahr 2012 – Deep Learning hat seinen Wert bereits bewiesen, aber das Gehirn der Roboter hat noch nicht das Niveau von GPT-2 erreicht; neue Modelle zwischen Dezember und Januar könnten GPT-2 näher kommen, verfügen aber noch nicht über die Voraussetzungen für die Massenproduktion.
Mit anderen Worten steht unsere Roboterindustrie kurz vor dem Ausbruch, aber dieser Ausbruch ist kein einzelnes Ereignis, sondern ein Ausdauerwettlauf, der sich von Modellwettbewerben zu Datenrädern, Hardwarekonsistenz und Betriebsvalidierung verlagert.
Von AlexNet zu GPT-2: Die tatsächliche Position des Robotergehirns
Der zentrale Vergleich des Forschungsberichts lautet: Roboter gehen denselben Weg wie große Sprachmodelle, nur starten sie früher.
LLMs haben drei Phasen durchlaufen: umfangreiches Vortraining, Feinabstimmung durch Anweisungen und Versuch-und-Irrtum durch verstärkendes Lernen – das Gleiche gilt für Roboter. Wissenschaftler von Nvidia gehen davon aus, dass das Training von Robotern ebenfalls von breitem Lernen zur Feinabstimmung spezifischer Aufgaben übergeht und sich durch Versuch und Irrtum stetig verbessert.
Aber das heutige Robotergehirn hat das GPT-2-Stadium noch nicht erreicht:
In Laboren gibt es erste Ansätze, aber noch kein Modell ist in der Lage, praktische Arbeiten zu verrichten.
Das 1.5-Modell eines Unternehmens für allgemeine künstliche Intelligenz kann Aufgaben bereits in nur 3 bis 12 Sekunden Demonstration erlernen, die Erfolgsrate liegt bei 10 Tests ohne zusätzliches Training bei 59 % und steigt auf 83 % nach nur 5 Minuten ergänzendem Training mit Daten; S1 von Skild AI kann lernen, Kaffee zuzubereiten, indem es sich Videos von Menschen ansieht; Zero-WAM von Ant Group erreicht in sieben unbekannten Aufgaben in simulierten Umgebungen eine Erfolgsrate von 47,0 %, was 29,5 Prozentpunkte höher ist als das beste vergleichbare Ergebnis.
Diese Ergebnisse zeigen zwar Anzeichen für GPT-3-ähnliches Few-Shot-Lernen, stammen aber alle aus internen Tests von Unternehmen, die Aufgaben sind kurz oder finden in simulierten Umgebungen statt. Der Geschäftsführer von Skild AI hat zudem offen erklärt, dass S1 noch nicht für den Einsatz in Privathaushalten bereit ist.
Daher stuft der Forschungsbericht das Robotergehirn weiterhin auf dem Niveau von GPT-2 oder darunter ein.
Woher wird der echte Durchbruch am wahrscheinlichsten kommen? Nomura geht davon aus, dass große KI-Labore und Tesla die treibenden Kräfte sind, nicht reine Startups für Robotergehirne.
Labore verfügen über Rechenleistung, Talente und allgemeine Modelle, während Tesla einen geschlossenen Datenkreislauf, Testumgebungen in Fabriken und eine im Einsatz befindliche Roboterflotte besitzt.
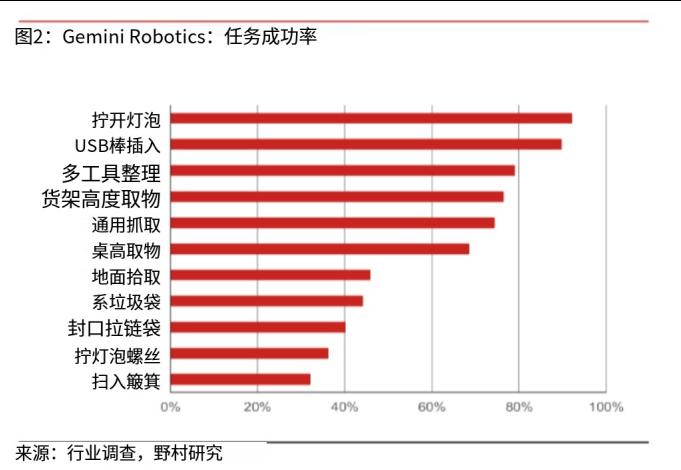
Google Gemini Robotics 2 wurde im Juli 2026 veröffentlicht und erreicht eine Erfolgsrate von bis zu 91,3 % bei komplexen mehrstufigen Aufgaben, die Ganzkörpersteuerung liegt etwa ein Jahr vor der chinesischer Wettbewerber;
OpenAI plant die Veröffentlichung eines eigens für physische KI entwickelten Modells zwischen Dezember und Januar, und Altman erwartet, dass 2027 eine „beeindruckende Demonstration“ von OpenAI-Robotern zu sehen sein wird;
Wang Xingxing hat zudem verraten, dass Unitree GPT-6 bereits auf Robotern getestet hat, die Ergebnisse sind sehr zufriedenstellend, und er geht davon aus, dass GPT-7 im nächsten Jahr die Engpässe bei verkörperter KI durchbrechen wird.
Die Impulse sind in der Tat dicht aufeinander folgend, aber die Veröffentlichung von Modellen bewegt das Robotergehirn nur von einem Niveau unter GPT-2 auf ein Niveau in der Nähe von GPT-2 – es liegt noch einiges vor dem eigentlichen Ausbruch.
Dreiteiliger Wettbewerb: VLA, Weltmodell und simuliertes verstärkendes Lernen
Die technischen Wege für das Robotergehirn teilen sich derzeit in drei Richtungen auf: VLA, Weltmodell und verstärkendes Lernen in Simulationen.
VLA beobachtet Szenen, empfängt Anweisungen und gibt Aktionen aus, meistens Pfade, denen untergeordnete Controller folgen können. Ein bordgebundenes VLA-Modell verfügt über etwa 2 bis 7 Milliarden Parameter und erfordert Chips und Speicher im Wert von etwa 30.000 bis 40.000 Yuan Renminbi.
Das Weltmodell hingegen sagt voraus, was passiert, nachdem der Roboter eine Aktion ausgeführt hat.
Nach dem Rahmen von Li Feifei umfasst es Renderer, Simulator und Planer; Atlas von World Labs erreicht 100 bis 200 Milliarden Parameter. Ein Weltmodell, das vollständige Videos erzeugt, erfordert 3 bis 10 Mal mehr Rechenleistung, während eine komprimierte Version, die auf komprimierten internen Repräsentationen ausgeführt wird, nur 30 % bis 100 % mehr Rechenleistung benötigt.
Es wird erwartet, dass Weltmodelle bis 2027 in der Cloud ausgeführt werden, um Roboter zu trainieren und Daten zu generieren, während kompakte VLA- und RL-Modelle auf dem Roboter selbst laufen.
Simuliertes verstärkendes Lernen trainiert Aktionen durch Versuch und Irrtum in einem physischen Simulator. Die laufenden Roboter von Unitree sind das berühmteste Beispiel: Fähigkeiten, die nur in Simulationen trainiert wurden, funktionieren bereits auf echten Geräten.
Diese drei Wege schließen sich nicht gegenseitig aus, sondern konkurrieren darum, das „Gehirn“ von Robotern zu werden.
Der Forschungsbericht erwähnt, dass frühe VLA-Modelle wie π0 und GROOT den größten Teil ihrer Kapazität für Sprache verwenden. Daher wissen sie, was ein Objekt ist, aber nicht, wie es sich bewegt. WAM verwendet stattdessen Videogenerierung als Physik-Engine: Die vorhersage von Videos Bild für Bild kann dem Modell Gravitation, Auftrieb und Licht beibringen, es sagt in einem Schritt voraus, was als Nächstes passiert und was der Roboter tun soll, sodass es neue Szenen ohne zusätzliches Training bewältigen kann.
Die Forschung von Dream Dojo geht noch weiter, indem sie das Physik-Engine durch ein Videomodell ersetzt, sodass Roboter gleichzeitig in vielen simulierten Welten üben können.
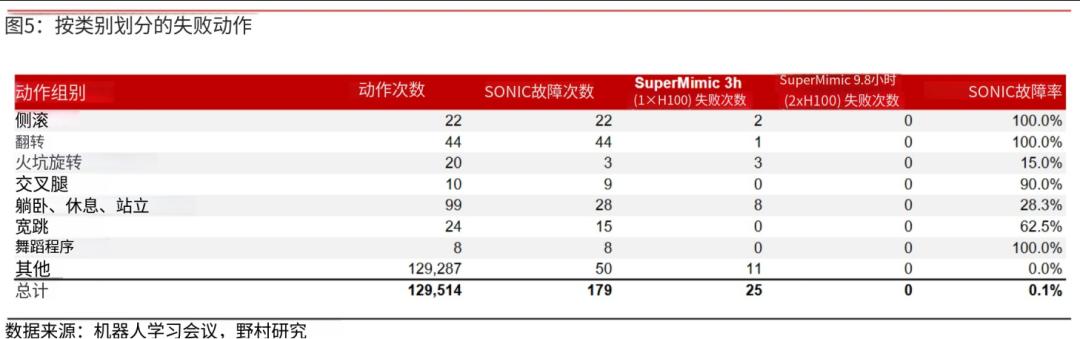
Die Arbeit zum Thema SuperMimic zeigt eine Revolution in der Trainingsmethode: Mit nur einer GPU, die drei Stunden lang läuft, übertrifft die Leistung des Modells das Referenzmodell, das auf 128 GPUs sieben Tage lang trainiert wurde – der Bedarf an Rechenressourcen wird um mehr als das 1000-fache reduziert. Bei 129.514 Aktionstests schlug die alte Methode 179 Mal fehl, das neue Modell schlug in drei Stunden 25 Mal fehl und erreichte nach 9,8 Stunden Laufzeit auf zwei GPUs null Fehler.
Das zeigt uns, dass Roboter innerhalb der erlernten Modelle trainiert werden sollten, nicht in ursprünglichen Simulatoren, und dass mehr Bewegungsdaten genutzt werden sollten, um einen einzelnen Controller zu trainieren.
Aber der Forschungsbericht betont auch, dass Vortraining nur die Hälfte des gesamten Prozesses ist. Für stetige Verbesserungen benötigen die Modelle Daten, die von Robotern erzeugt werden, die im Einsatz vor Ort arbeiten.
Datenrad: Der kritische Punkt von 1 Million Stunden und die Skalierungsgesetze für Videos
Daten sind genau der Engpass, der die Entwicklung von Robotern behindert.
Sprachmodelle können Texte aus dem gesamten Internet zum Lernen nutzen, aber Roboter fehlen ähnliche Datenquellen.
Fernsteuerung lässt Menschen Roboter bei der Datenerfassung anleiten – das ist sowohl teuer als auch langsam, und die Daten sind an bestimmte Robotertypen gebunden. Sobald ein Roboter von einem beinbasierten auf ein radbasiertes Modell umgestellt wird, sind die Daten nicht mehr nutzbar.
Der im Forschungsbericht genannte kritische Punkt liegt bei etwa 1 Million Stunden an Daten, was ungefähr der Zeit entspricht, die ein Mensch in seinem gesamten Leben ansammelt. Derzeit stehen nur etwa 100.000 Stunden an nutzbaren, in einheitlichem Format erfassten Daten zur Verfügung, selbst führende Unternehmen verfügen nur über Hunderttausende Stunden an hochwertigen Daten, und die von Tesla Optimus erfassten Daten haben gerade die Marke von 500.000 Stunden überschritten.
Für den Start des Trainings sind 10 Millionen Stunden erforderlich, langfristig sind es über 100 Millionen Stunden – die Branche hat derzeit nur mehrere Millionen Stunden angesammelt.
Noch wichtiger ist, dass ein großer Teil der Daten nutzlos ist: Bei Unitree kann nur etwa ein Viertel der aufgezeichneten Zeit genutzt werden, nur eine Stunde von jeweils vier aufgezeichneten Stunden ist nutzbar.
Die Marktstruktur für die Datenerfassung bestätigt diesen Engpass.
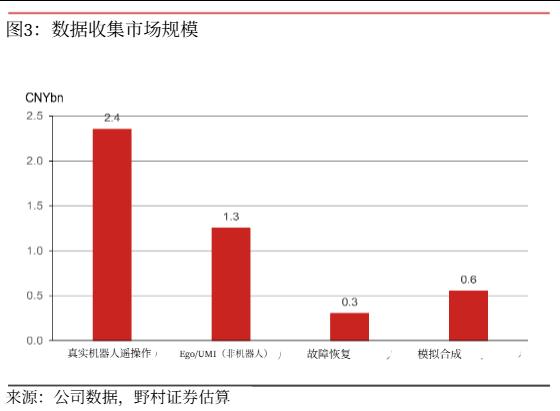
Nach Schätzungen von Nomura beträgt das Volumen des chinesischen Marktes für Datenerfassung im Jahr 2026 etwa 4 bis 5 Milliarden Yuan Renminbi, davon entfallen etwa 2,4 Milliarden Yuan auf die Fernsteuerung physischer Roboter, etwa 1,3 Milliarden Yuan auf Ego-Videos und UMI, etwa 600 Millionen Yuan auf Simulationen und etwa 300 Millionen Yuan auf Fehlerbehebung.
Was die Kosten angeht, kostet eine Stunde Fernsteuerung etwa 700 Yuan, UMI etwa 100 bis 300 Yuan, Ego-Videos etwa 300 bis 350 Yuan und Simulationen etwa 120 Yuan. Fernsteuerungsdaten sind am teuersten und an bestimmte Robotermodelle gebunden; Ego-Videos und UMI sind kostengünstiger, und Videos als Kamerabilder können über Generationen von Robotern hinweg wiederverwendet werden. Simulationen sind am günstigsten, aber ihr Anteil an Daten für Wahrnehmungsaufgaben in der realen Welt übersteigt nicht 20 %.
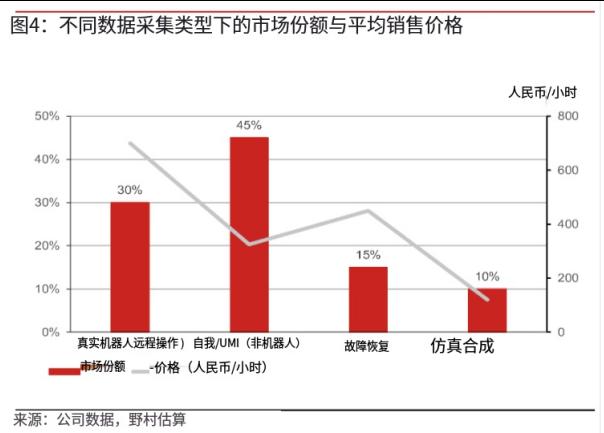
Das ist genau der Grund, warum sich die Branche auf Videos verlagert: Die typische Datenstruktur besteht bereits zu 60 % aus Ego-Videos, zu 30 % aus UMI und zu 10 % aus echten Roboterdaten.
Nvidias EgoScale trainiert zuerst mit über 21.000 Stunden alltäglicher Ego-Videos und führt dann eine Feinabstimmung mit einer kleinen Menge an Fernsteuerungs- und Motion-Capture-Daten durch. Für Handhabungsaufgaben führt mehr Rechenleistung beim Vortraining zu stabilen und vorhersehbaren Leistungssteigerungen – das stimmt mit den Skalierungsgesetzen überein, die die Entwicklung von LLMs vorangetrieben haben.
Wenn menschliche Videos zur Hauptdatenquelle werden, hat derjenige den größten Vorteil, der über den besten Datenverarbeitungsablauf und die stärkste Rechenleistung verfügt. Das unterstreicht die Bedeutung großer KI-Labore und schränkt den langfristigen Wert von Fernsteuerungsdaten ein, die an spezifische Roboterdesigns gebunden sind.
Aber der echte ChatGPT-Moment tritt ein, wenn der positive Rückkopplungskreislauf in Gang kommt: Roboter im Einsatz erzeugen Daten, die Daten optimieren das Modell, und bessere Modelle werden breiter eingesetzt.
Tesla plant, bis Ende 2026 durch das Training von etwa 10.000 eigenen Fabrikrobotern 1 Million Stunden an nutzbaren Daten zu sammeln. Im zweiten und dritten Quartal 2026 sind die Datenkosten von Optimus um etwa 18,1 % gesunken.
Im Vergleich dazu ist der Umfang der Bereitstellung in China viel geringer: 2026 wird erwartet, dass die sieben größten Kurierunternehmen weniger als 500 humanoide Roboter beschaffen, 2027 sind es nur etwa 1.000.
Daher geht der Forschungsbericht davon aus, dass der positive Rückkopplungskreislauf zuerst in Unternehmen startet, die sowohl Roboter als auch Modelle besitzen.
OpenAI hat zwischen September 2025 und August/September 2026 etwa 10 Millionen Stunden an Daten gekauft, was etwa 70 % des US-amerikanischen Angebots ausmacht. DeepMind hat etwa 20 % beschafft, was einem Drittel der Einkaufsmenge von OpenAI entspricht.
Unabhängige Datenerfasser haben noch ein Zeitfenster von etwa drei Jahren, um Daten zu sammeln. Da chinesische Daten aber nicht exportiert werden können und KI-Unternehmen zunehmend auf eigene Datenerfassung setzen, wird die Anzahl der Datenlieferanten bis Ende 2027 voraussichtlich sinken.
Das heißt, die Hürde für das Datenrad liegt nicht darin, „ob man Daten hat“, sondern darin, „ob man kontinuierlich nutzbare Daten zu niedrigen Kosten beschaffen und den Kreislauf der Iteration schließen kann“.
Geschickte Hände und konsistente Fertigung: Der iPhone-Moment auf der Hardware-Seite
Nachdem der Modellpfad festgelegt ist, wird sich das Design humanoider Roboter allmählich zu mehreren standardisierten Formen entwickeln – der Forschungsbericht nennt das den „iPhone-Moment“ im Hardware-Bereich. Danach ist das Schwierigste, jedes Gerät auf