Anthropic hat eine Lösung für das Problem des Kimi-Kontingents gefunden
Nach der Veröffentlichung von K3.1 Pro hat Moonshot AI aufgrund mehrerer Nutzerrückmeldungen, dass das Guthaben zu schnell verbraucht wird, dringend eine Ankündigung herausgegeben: „Das Problem liegt bei uns, wir hätten es schon früher beheben sollen“. Gleichzeitig mit der Vergütung von zusätzlichem Guthaben erklärte Moonshot AI, dass es „unnötige Sub-Agent-Aufrufe und die Ausgabelänge reduzieren“ wird.
Zwei Tage vor der Veröffentlichung des Modells veröffentlichte Anthropic einen Artikel mit dem Titel „Building agents: When to fold subagents into your main agent loop“, der sich genau mit dem Thema der Sub-Agents befasst.
Anthropics Schlussfolgerung lautet: Durch den Vergleich des von mehreren Unternehmen eingesetzten Claude-Modells stellte sich heraus, dass ein Agent mit Fähigkeiten in der Qualität sogar die „Arbeitsteilung einer Gruppe von Sub-Agents“ übertrifft, zudem sind Kosten und Verzögerungen bei einzelnen Aufgaben oft niedriger. Am wichtigsten ist, dass der von diesem Agent verbrauchte Token-Wert weit unter dem einer ganzen Gruppe von Sub-Agents liegt.
Das Konzept des Sub-Agents ist eigentlich ein „Patch“, den die Hersteller in der Zeit unzureichender Modellfähigkeiten eingeführt haben, damit das Modell mehr Aufgaben erledigen kann.
Was die Aufgabenerfüllungsrate angeht, sind mehrere Sub-Agents tatsächlich weit leistungsfähiger als der einzelne Agent zu jener Zeit. Als Preis dafür werden mehr Token verbraucht, und das Modell wird teurer.
Anthropic erklärt, dass mit zunehmender Leistungsfähigkeit der Modelle und längerem Kontext dieser „Patch“ die Fähigkeiten nicht mehr verbessern kann, sondern zu einer „Belastung“ wird.
Was besagt dieser Artikel von Anthropic
Anthropic ist der Ansicht, dass man für die überwiegende Mehrheit der Aufgaben überhaupt nicht so viele Sub-Agents braucht, sondern nur einen einzelnen Agent, ein einzelnes Modell, einen einzelnen Gesprächsverlauf und eine einzige Schleife.
Das Modell arbeitet wiederholt in einer Schleife, in jeder Runde kann es gleichzeitig eine Reihe von Tool-Aufrufen ausführen, die Ergebnisse werden direkt an das Modell zurückgegeben, das entscheidet, was als Nächstes zu tun ist.
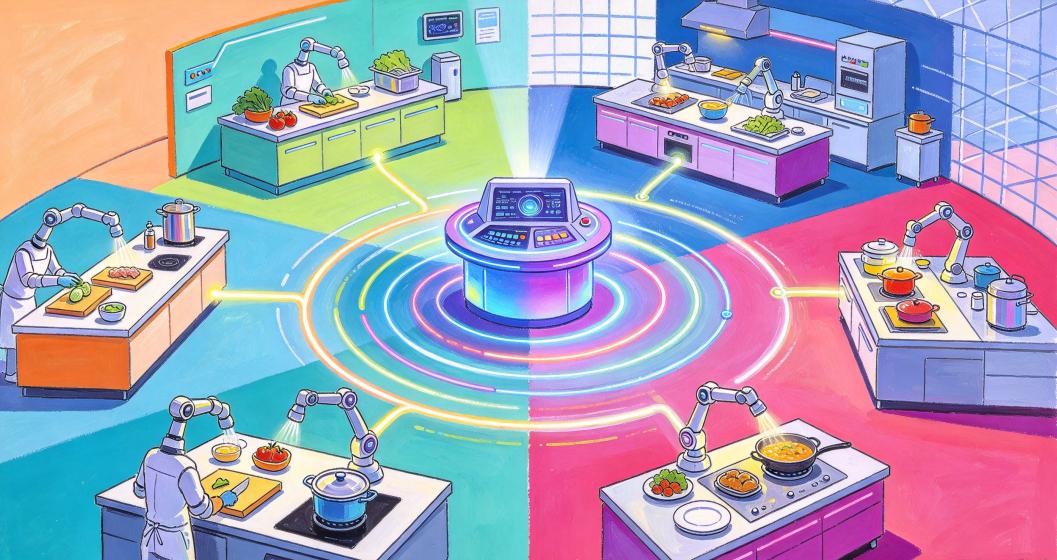
Ein Beispiel: In einer Küche soll ein Gericht zubereitet werden, das beginnt mit der Vorbereitung der Zutaten, dann geht es zum Waschen der Gemüse, zum Schneiden, zum Garen im Topf und schließlich zum Anrichten und Servieren.
Bei der früheren Arbeitsteilung gäbe es jeweils eine Person für das Waschen, das Schneiden, das Kochen und das Anrichten, jede Person hat eine eigene Aufgabenliste. Das Problem ist, dass die Aufgabenliste jeder Person von der vorherigen Person stammt, zum Beispiel erhält die Person, die das Gemüse schneidet, die Liste von der Person, die es gewaschen hat.
Wenn das Gericht auf dem Tisch zu salzig schmeckt, ist es schwer zu sagen, an welcher Stelle das Problem liegt: Vielleicht hat die kochende Person zu viel Salz hinzugefügt, oder das Gemüse war nicht sauber genug gewaschen.
Der Vorteil des einzelnen Agents liegt darin, dass er nicht zu Beginn jeder Runde jemandem erklären muss, „welchen Geschmack ich haben möchte“. Er hat das Gericht selbst zubereitet, er hat den Salzgrad selbst probiert.
Der Artikel nennt drei Gründe, warum Sub-Agents nicht gut funktionieren.
Der erste ist der Zinseszinseffekt bei Token.
Jeder zusätzliche Sub-Agent in einer Aufgabe fügt eine weitere Verzweigung hinzu, und die Kosten steigen entsprechend. Der Token-Verbrauch eines Multi-Agent-Systems beträgt etwa das 15-fache eines normalen Gesprächs.
Der entscheidende Punkt ist, dass dieses 15-fache nicht für das „Denken“ ausgegeben wird, sondern für das „Merken“.
Jeder Sub-Agent muss seine eigene Identität, Regeln, Tool-Liste und zugehörigen Kontext neu aufbauen, nach Abschluss der Aufgabe wird alles zu einer Zusammenfassung komprimiert und zurückgegeben. Dadurch muss der Hauptagent dasselbe Material mehrmals lesen.
Der zweite Punkt ist der Informationsverlust.
Bei jeder Übertragung von Informationen zwischen verschiedenen Sub-Agents sinkt die Treue der Informationen um eine Ebene. Wenn die Informationen bei den späteren Sub-Agents ankommen, stimmen sie möglicherweise nicht mehr mit der ursprünglichen Anforderung überein.
Cognition hat in seinem Artikel von 2025 mit dem Titel „Don‘t Build Multi-Agents“ ein Szenario beschrieben: Zwei Sub-Agents sollen getrennt eine Nachbildung des Spiels Flappy Bird erstellen, einer erstellt den Hintergrund, der andere den Vogel. Das Ergebnis war, dass der erstellte Hintergrund wie Super Mario aussah, und der erstellte Vogel überhaupt nicht zu den Spieleelementen passte.
Der dritte Punkt ist die Fragmentierung der Persönlichkeit.
Obwohl innerhalb des Systems mehrere Sub-Agents miteinander kommunizieren, haben diese Sub-Agents aufgrund unterschiedlicher Prompts völlig unterschiedliche Ausgabestile, aber der Nutzer sieht nur eine einzige Eingabeschnittstelle.
Anthropic gibt in dem Artikel ein Beispiel: Ein Unternehmen hat mehr als ein Dutzend spezialisierte Sub-Agents auf seiner Client-Seite. Das Unternehmen bewertete diese Sub-Agents als „schwer zu stabilisierenden Markenausdruck zu pflegen“, und die Nutzer müssen immer warten, bis der langsamste Sub-Agent seine Ausgabe abgeschlossen hat, um eine Antwort zu erhalten.
Man muss aber auch die andere Seite betrachten: Anthropic vertritt nicht die Ansicht, dass Sub-Agents direkt abgeschafft werden sollen, sondern dass sie bedarfsgesteuert als Fähigkeiten (Skills) geladen werden sollen.
Jeder Sub-Agent trägt verschiedene Wissensbestände bei sich, zum Beispiel die Schneidtechniken beim Gemüseschneiden oder die richtige Temperatur beim Kochen. Wenn diese Fähigkeiten benötigt werden, werden sie abgerufen, in der nächsten Phase werden sie wieder abgelegt.
Die Wirkung dieser Methode ist messbar.
Anthropic erwähnt in dem Artikel, dass durch die Kombination mit passenden Tools und die Umwandlung von Sub-Agents in Fähigkeiten mehr als 80 % der System-Prompts eingespart werden können.
Dadurch werden die ursprünglichen überladenen Prompts, die das Urteilsvermögen beeinträchtigen, sofort sauber und übersichtlich, und es wird viel Kontextspeicherplatz für die eigentliche Aufgabe freigegeben.
Brauchen wir wirklich noch Sub-Agents?
Sub-Agents waren bei ihrer Entstehung ursprünglich ein technischer Kompromiss.
Karpathy, der damals noch bei OpenAI tätig war, hat einmal einen Tweet veröffentlicht, der im Wesentlichen besagt, dass GPT nicht weiß, dass es Kontextbeschränkungen hat. Wenn man es Aufgaben ausführen lässt, füllt es den Kontext sehr leicht vollständig aus, was zum Scheitern der Aufgabe führt.
Daher muss es ein Mittel geben, um Aufgaben aufzuteilen, sodass das Modell sie schrittweise erledigen kann.
Ende März 2023 haben AutoGPT und BabyAGI zwei Experimentierprojekte durchgeführt. Der Kern beider Projekte bestand darin, dass ein Agent große Ziele in mehrere Aufgabenlisten aufteilt, sich selbst Aufgaben zuweist und diese selbst ausführt.
Diese Projekte haben eines bewiesen: Wenn das Modell selbst entscheidet, was als Nächstes zu tun ist, kann die Schleife ausgeführt werden. Aber es hat auch ein Problem offengelegt: Wenn es keine zuverlässige Überprüfung in der Schleife gibt, verstärkt sich der Fehler in der Schleife selbst.
Ein Agent sagt „Ich werde den Finanzbericht dieses Unternehmens nachschlagen“. Selbst wenn er den falschen Bericht findet, wird er basierend auf den falschen Informationen weiter schlussfolgern und am Ende eine sorgfältig wirkende, aber unsinnige Antwort liefern. Danach gerät er in eine Endlosschleife, in der der Fehler immer größer wird.
Vom zweiten Halbjahr 2023 bis 2024 hat die Branche eine Lösung vorgeschlagen: Die Arbeitsteilung soll wie in einem echten Unternehmen gestaltet werden.
Ein Beispiel ist MetaGPT, das das Modell in vier Positionen unterteilt: Produktmanager, Architekt, Ingenieur und Tester.
Wenn man die Anweisung „Erstelle ein Snake-Spiel mit Bestenliste“ eingibt, läuft das System schrittweise durch die Positionen: Zuerst erstellt der „Produktmanager“ das Anforderungsdokument, dann wandelt der „Architekt“ das Dokument in Systemdesign und Schnittstellen um, danach schreibt der „Ingenieur“ den Code gemäß den Schnittstellen, und schließlich sucht der „Tester“ nach Fehlern. So wird das vollständige Programm erstellt.
Zu jener Zeit war die Vorstellung der Leute sehr einfach: Wenn ein einzelnes Modell leicht vom Weg abweicht, lassen sich mehrere Modelle gegenseitig kontrollieren – das war der Ursprung des Sub-Agent-Systems.
Einfach ausgedrückt: Sub-Agents sind im Wesentlichen „eine Architektur, die einen breiteren, stabileren Rechner mit größerem Arbeitsspeicher simuliert“.
Neben dem begrenzten Kontextfenster schreibt Anthropic in dem Artikel auch, dass die Zuverlässigkeit des Modells begrenzt ist: Je länger die Kette ist, desto leichter bricht sie zusammen. Außerdem kann das Modell nur single-threaded arbeiten und nicht gleichzeitig mehrere Gedanken verarbeiten.
Anthropic erklärt, dass das Motiv für die Entwicklung von Sub-Agents im Jahr 2024 darin bestand, diese drei Probleme zu lösen: Kontextisolation, sodass der Hauptkontext nicht durch eine Vielzahl von Zwischenergebnissen verunreinigt wird und das Kontextfenster indirekt erweitert wird; Zuweisung unterschiedlicher Tools für unterschiedliche Aufgaben, um zu verhindern, dass ein Zusammenbruch an einer Stelle der Kette die gesamte Aufgabe beeinträchtigt; Parallelität, sodass mehrere unabhängige Abläufe gleichzeitig ausgeführt werden.
Anthropic vertritt die Ansicht, dass Sub-Agents als eine Art „Patch“ für das Modell angesehen werden können. Aber auch diese Patches müssen mit Token bezahlt werden.
In den letzten zwei Jahren haben hauptsächlich Entwickler und Unternehmen bezahlt, die nach API-Maßstäben abgerechnet werden: Die Kosten sind eindeutig angegeben und können nachvollzogen werden. Wenn man einen Cent mehr für Token ausgibt, steht dieser Cent mehr auf der Rechnung – völlig transparent.
Mit der Popularität des Abonnementmodells für Endnutzer erklärt Anthropic, dass es Zeit ist, etwas zu ändern.
Das monatliche Nutzungsguthaben ist eine Blackbox. Der Nutzer weiß nur, „wie viel in diesem Monat noch übrig ist“, aber nicht, „wie viel Guthaben diese Sub-Agents in dieser Gesprächsrunde tatsächlich verbraucht haben“.
Abonnenten beurteilen das Guthaben danach, „wie viele Dinge ich erledigt habe“, aber das System berechnet es danach, „wie oft ich das Modell aufgerufen habe, wie viele Verzweigungen ich geöffnet habe und wie oft ich die Dateien gelesen habe“.
Daher erklärt Anthropic: Mit der zunehmenden Leistungsfähigkeit des Modells und der Verbesserung der Rechenleistung können diese „Patches“ nur bei extrem komplexen Aufgaben eine Rolle spielen. Für die überwiegende Mehrheit der Aufgaben verbrauchen Sub-Agents nur mehr Token.
Daher kommt Anthropic zu dem Schluss: Die Vorteile, die Sub-Agents bringen, reichen nicht mehr aus, um ihre eigenen Kosten zu decken.
Anthropic hat sogar ein Tool namens single-agent-loop-kit Open Source veröffentlicht, das speziell dafür entwickelt wurde, dass das Modell Aufgaben nur als einzelner Agent ausführt und keine Sub-Agents mehr aufruft.
Die Rechnung von K3.1 Pro
Moonshot AI hat genau den Nachteil erlitten, dass zu viele Sub-Agents geöffnet wurden.
Am 24. Oktober wurde das K3.1 Pro von Moonshot AI veröffentlicht, das eine sehr hohe Leistung aufweist. Auf Terminal-Bench 4.0 erzielte es 65,7 %, übertrifft damit die 58,2 % von GPT-6 Astra und liegt nur 0,7 % unter den 66,4 % von Claude Opus 5.5.
Aber viele Nutzer aus der Community meldeten, dass das Guthaben des Modells zu schnell verbraucht wird: Ein oder zwei kleine Aufgaben reichen aus, um das Guthaben von 5 Stunden zu verbrauchen.
In der frühen Morgenstunde des 26. Oktobers erklärte das offizielle Team von Moonshot AI, dass es unnötige Sub-Agent-Aufrufe und die Ausgabelänge reduzieren wird.
Wer schon einmal in einem Internetunternehmen gearbeitet hat, wird diese Situation sehr vertraut finden.
Wenn eine Anforderung eintrifft, kommen jeweils eine Person aus Produktmanagement, Design, Frontend, Backend, Test und Betrieb, jeder muss einen Kommentar im Dokument hinterlassen, sonst wirkt er nicht beteiligt. Am Ende stellt sich heraus, dass eine Aufgabe, die eine einzelne Person in einem halben Tag erledigen könnte, von der Anforderung über die Planung bis zum Test und zur Veröffentlichung mehr als ein halbes Jahr dauert.
In Unternehmen nennt man das „Organisationsfähigkeit“. Aber bei Modellen nennt man das einfach „Token-Verbrauch“.
Als Nutzer des Modells kann er nur die Denkintensität des Modells wählen, aber nicht entscheiden, wie viele Sub-Agents geöffnet werden. Er möchte nur für die erledigte Aufgabe bezahlen, nicht für so viele Sub-Agents, die sich „abstimmen, Meetings abhalten und Präsentationen erstellen“.
Außerdem hat der Nutzer nicht einmal die Möglichkeit, den Vorgang zu stoppen. Es gibt ein Konzept namens „Vorverlagerung der Fehlerkosten“.
Bei normalen Transaktionen wird das Geld erst ausgegeben, nachdem die Sache erledigt ist. Bei Sub-Agents wird das Guthaben sofort verbraucht, sobald sie gestartet werden, selbst wenn die Funktion dieses Sub-Agents fast vernachlässigbar ist.
Gerechtfertigt gesagt: Das ist keine Krankheit, die nur K3.1 Pro hat.
Nutzer von Claude haben sich auch beschwert: Bei dem 20-Dollar-Abonnement reicht ein einzelner Prompt aus, um das 5-Stunden-Guthaben zu verbrauchen; wenn Opus 5.5 einen vorhandenen Code-Bearbeitungsauftrag bearbeitet, wird die Begrenzung nach etwa 30 Minuten ausgelöst. Das alles liegt daran, dass Claude zu viele Sub-Agents geöffnet hat.
Anthropic vertritt die Ansicht, dass dies der „strukturelle Widerspruch“ der Produktkategorie „Langzeit-Agent“ ist.
Wenn man ihm eine Aufgabe gibt, muss er Informationen nachschlagen, Dateien lesen, schreiben, ändern und das Ergebnis selbst überprüfen. Er muss Dutzende von Schritten ausführen, bei jedem Schritt muss er den Kontext neu lesen – es ist normal, dass der Vorgang eine halbe Stunde dauert.
Je leistungsfähiger das Modell ist, desto länger sucht es, desto mehr Tools ruft es auf und desto mehr Überprüfungsrunden führt es durch.