Kimi gibt seinen Fehler zu, Yang Zhilin muss trotzdem von Liang Wenfeng lernen.
Weniger als 48 Stunden nach der Veröffentlichung von K3.1 Pro veröffentlichte Moonshot AI eine Mitteilung: „Wir entschuldigen uns zutiefst für die Probleme mit der Geschwindigkeitsbegrenzung und dem unnötigen Verbrauch des Guthabens bei unserem Modell. Diese Probleme liegen vollständig in unserer Verantwortung, wir hätten die Lösung früher vorantreiben müssen. Ab dem 26. Oktober erhalten alle Abonnenten aller Tarife 25 % des monatlichen Gesamtbetrags zurück. Wir haben zudem die Betriebsparameter des Produkts angepasst, unnötige Sub-Agent-Aufrufe entfernt und die redundante Ausgabelänge komprimiert, sodass das Guthaben länger hält.“
Nach dieser Anpassung ist die offensichtlichste Erfahrung, dass K3.1 Pro nicht mehr so viel Guthaben verbraucht wie direkt nach seiner Veröffentlichung.
Am Tag der Modellveröffentlichung war die gesamte KI-Branche schockiert: Die Leistung übertrifft alle Modelle von OpenAI und liegt nur knapp hinter Opus 5.5 zurück. Das unabhängige Bewertungsinstitut ModelCompare veröffentlichte einen Artikel, in dem es heißt, dass der KI-Abstand zwischen China und den USA von 3 bis 4 Monaten auf nur noch 31 Tage geschrumpft ist.
Doch bevor diese Begeisterung zwei Tage anhielt, änderte sich die Bewertung von K3.1 Pro von „sehr positiv“ zu „überwiegend positiv“. Yang Zhilin erhielt den Spitznamen „zwei Gesichter zwischen Gott und Geist“: Die Seite des „Gottes“ liegt in der überragenden Modellleistung, und die Seite des „Geistes“ liegt darin, dass die Nutzung von K3.1 Pro ein wenig schmerzhaft für den Geldbeutel ist.
Das am häufigsten gemeldete Problem betrifft das Guthaben. Mehrere Nutzer in der Community gaben an, dass das 5-Stunden-Guthaben von K3.1 Pro fast vollständig aufgebraucht war, obwohl sie es kaum genutzt hatten. Nehmen wir mich selbst als Beispiel: Bei dem Tarif für 199 Yuan habe ich in zwei Tagen weniger als 10 3D-Modelle und einige Demonstrationsanimationen mit einer Dauer von höchstens 30 Sekunden erzeugt, und das monatliche Guthaben ist bereits zur Hälfte aufgebraucht.
Sogar bei einigen einfachen Aufgaben ruft K3.1 Pro eine große Anzahl von Sub-Agents auf, um zu denken und zu schlussfolgern. Die Ausgabenergebnisse verbessern sich nicht wesentlich, aber diese Sub-Agents führen dazu, dass die Nutzer viel Guthaben verschwenden.
Yang Zhilin zeigte sich auch ratlos: Die Verbesserung der Intelligenz des Modells erfordert zwangsläufig mehr Token.
Das führt dazu, dass K3.1 Pro zwar 30 % günstiger ist als K3, aber aufgrund des zu geringen zugewiesenen Guthabens am Ende nur wenige Menschen wirklich das Gefühl haben, dass es „günstig“ ist.
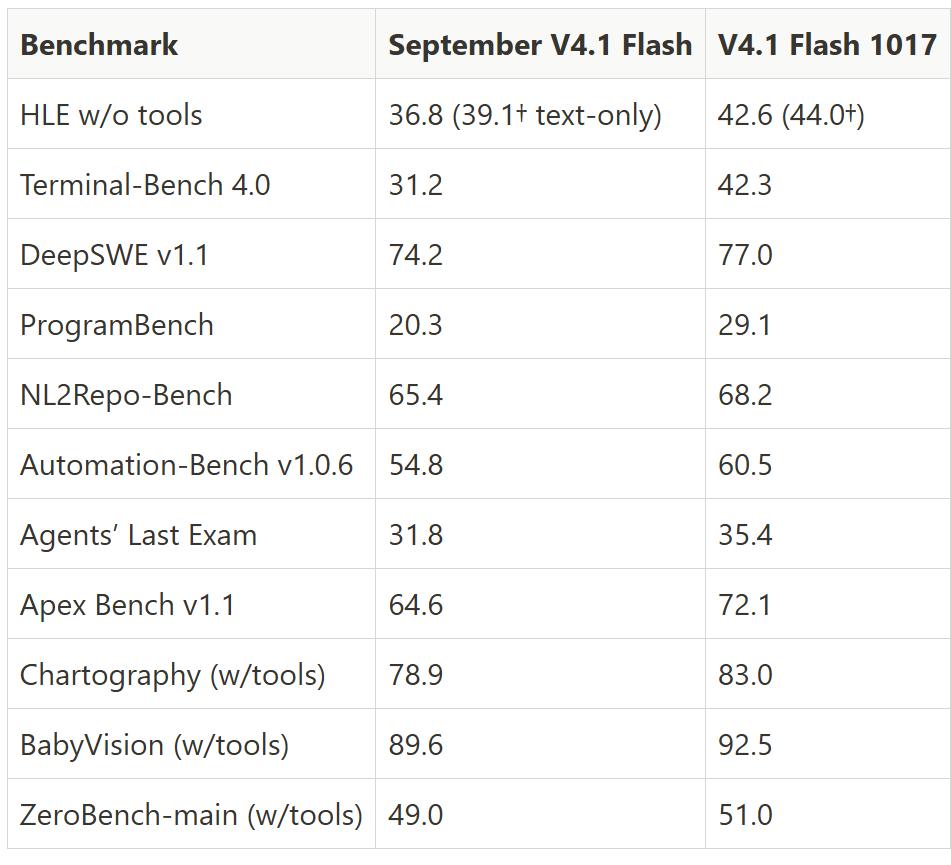
Eine Woche vor der Veröffentlichung von K3.1 Pro veröffentlichte DeepSeek die Version V4.1 Flash-1017, die einen völlig anderen Ansatz verfolgt: Es wird nicht nach der Obergrenze gestrebt, sondern Leistung, Geschwindigkeit und Ausgabelänge werden gleichzeitig optimiert, während der Preis unverändert bleibt.
V4.1 Flash-1017 verkörpert perfekt die Produktphilosophie von Liang Wenfeng und wird seit seiner Veröffentlichung durchweg mit „überwältigend positiven Bewertungen“ bedacht.
Vielleicht sollte Yang Zhilin in Bezug auf das Produktmanagement von Liang Wenfeng lernen.
Das Guthaben ist das größte Problem von Moonshot AI
Nach der Veröffentlichung von K3.1 Pro diskutieren viele Menschen in der Community über das Guthabenproblem. Zum Beispiel gibt es einen hochbewerteten Kommentar, in dem der Autor schreibt: „Es hat nur etwa 10 Minuten gedauert, und das 5-Stunden-Guthaben war bereits vollständig verbraucht.“
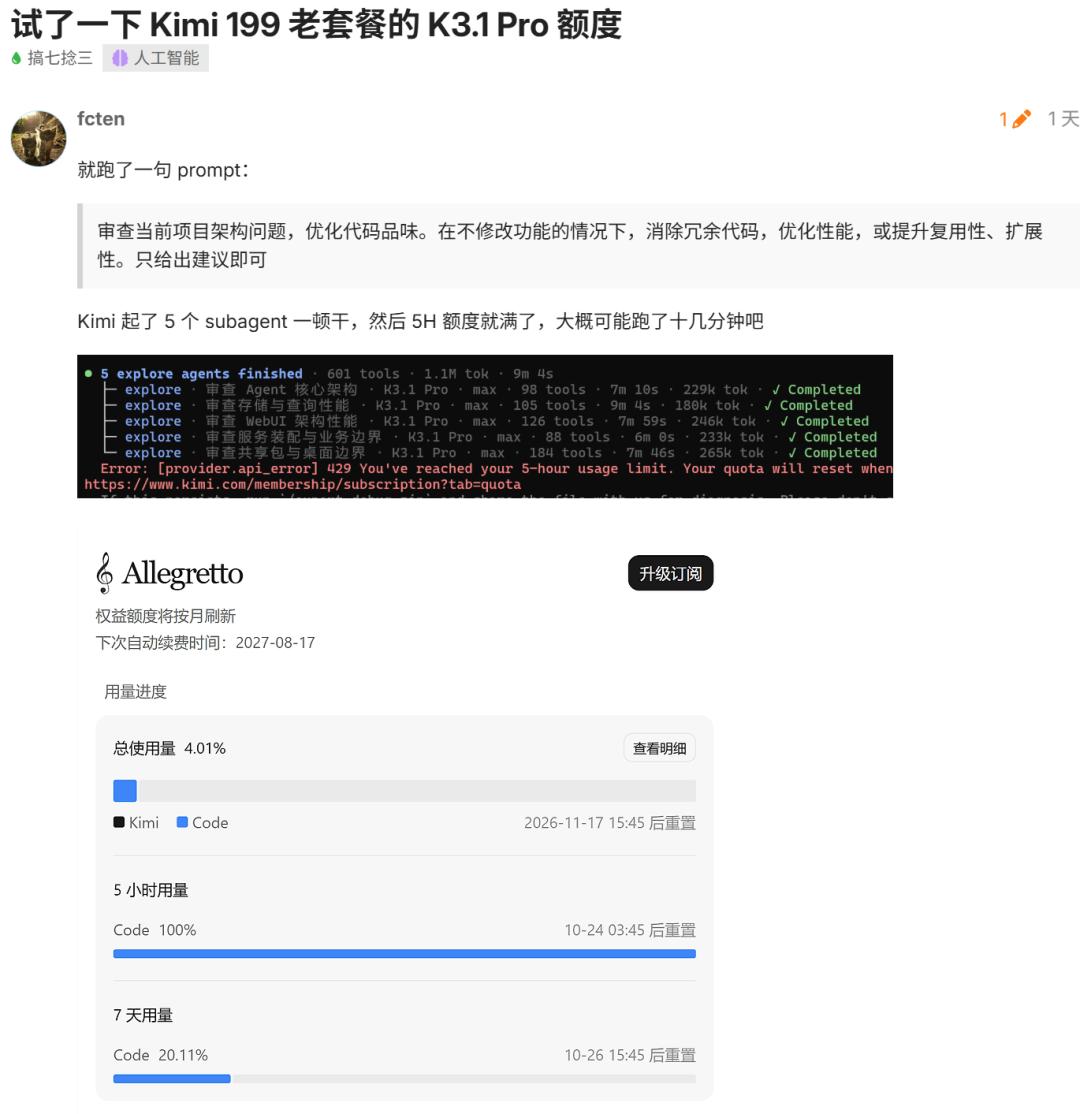
Auf Linux.do berichtete ein Nutzer des 199-Yuan-Tarifs, dass er nur eine Anweisung eingegeben habe, um das Modell zur Überprüfung der Projektarchitektur aufzufordern. Kimi startete 5 Sub-Agents, und nach mehr als zehn Minuten war das 5-Stunden-Guthaben vollständig aufgebraucht.
Der Weibo-Nutzer @Zhe Hen He Li Ba berichtete in einem Beitrag, dass er bei der Nutzung von K3.1 Pro in WorkBuddy mehr als 450 Punkte verbraucht habe, bevor eine einfache Aufgabe abgeschlossen war.
Tatsächlich umfasst die Standardversion von WorkBuddy für 99 Yuan insgesamt nur 4000 Punkte pro Monat. Das entspricht einem Zehntel des monatlichen Guthabens für eine einzige einfache Aufgabe. @Zhe Hen He Li Ba fügte hinzu, dass der aktuelle Multiplikator für den Punkteverbrauch von K3.1 Pro 0,97 beträgt, was bedeutet, dass der tatsächliche Punkteverbrauch noch etwas geringer ist.
Artificial Analysis ist der Ansicht, dass der Grund für den hohen Guthabenverbrauch von K3.1 Pro vor allem in der Tokeneffizienz liegt.
Bei Tests wurde festgestellt, dass K3.1 Pro für die Ausführung des gesamten Intelligence Index-Testsatzes insgesamt etwa 150 Millionen Token ausgeben muss, während der Median von Modellen in derselben Preisklasse 87 Millionen beträgt.
Bei demselben Testsatz verbraucht GPT-6.1 Sol nur etwa 67 Millionen Token und GPT-6 Astra etwa 60 Millionen. Nach Umrechnungen von OrcaRouter beträgt das Ausgabevolumen von K3.1 Pro für dieselbe Aufgabe etwa das 2,5-fache von Astra.
Artificial Analysis fügte hinzu, dass die Geschwindigkeit von K3.1 Pro auch unter dem Median vergleichbarer Modelle liegt und bei etwa 70 bis 80 Token pro Sekunde liegt. Darüber hinaus unterstützt K3.1 Pro nur den Denkmodus, Anfragen mit deaktiviertem Denkmodus werden direkt abgelehnt, und jeder Aufruf wird für die Inferenz bezahlt.
Obwohl K3.1 Pro eine Highspeed-Version eingeführt hat, gab Moonshot AI offiziell an, dass die Highspeed-Version nur die Modellausgabe beschleunigt. Die Zeit für Tool-Aufrufe in Aufgaben (Lesen und Schreiben von Dateien, Ausführen von Befehlen usw.) und die Skriptausführung werden nicht beeinflusst. Wenn dieser Anteil groß ist, ist die Gesamtbeschleunigung nicht offensichtlich.
Obwohl K3.1 Pro im Vergleich zu K3 um 30 % günstiger ist, stellte Artificial Analysis in Tests fest, dass die Kosten pro einzelner Aufgabe von K3.1 Pro nicht wesentlich niedriger sind.
Die durchschnittlichen Kosten pro Aufgabe von K3.1 Pro betragen 2,11 US-Dollar, die von GPT-6 Astra 3,26 US-Dollar. Der Token-Preis von K3.1 Pro beträgt nur ein Fünftel von Astra, aber bei den tatsächlichen Kosten wird nur etwa 35 % eingespart.
All dies hängt möglicherweise mit dem Training von K3.1 Pro zusammen.
Yang Zhilin ist der Ansicht, dass das Modell, um längere Ausgaben zu erzielen, während des gesamten Prozesses stets streng vorgehen, wiederholt prüfen, korrigieren und sich selbst verbessern muss. Dies gilt bereits seit K3: In der damaligen offiziellen technischen Dokumentation wurde festgehalten, dass K3 bei der Ausgabe übermäßig vorsichtig ist und sich wiederholt selbst überprüft.
Im offiziellen Forschungsblog von Fireworks AI mit dem Titel „Introducing Ember-1“ wurde erwähnt, dass selbst das Entfernen des wiederholten Prüfprozesses von K3 kaum Auswirkungen auf die Modellleistung hat. Mit anderen Worten: K3 ist etwas zu streng.
Bei K3.1 Pro ist das Modell nicht nur streng bei Aufgaben, sondern auch gegenüber der gesamten Umgebung.
Im offiziellen technischen Bericht von K3.1 Pro wurde ein Fall erwähnt: Als das Modell den Prozess des menschlichen Lernens des Gehens simulierte, stellte K3.1 Pro fest, dass die Armbewegungen immer nicht ideal waren und eine Anpassung der Belohnung keine Lösung brachte. Daraufhin prüfte es den Simulator erneut, korrigierte 36 Berechnungsfehler der Kraftarme der Schultermuskeln und trainierte dann neu, um schließlich bessere Ergebnisse zu erzielen.
Das ist der Grund, warum K3.1 Pro zwar eine sehr hohe Leistung aufweist, aber längere Ausgaben und mehr Token benötigt: Es muss gegenüber fast allem streng vorgehen, sogar gegenüber der Umgebung.
Yang Zhilin verbraucht viele Token, während Liang Wenfeng Token spart.
DeepSeek bezeichnet die Iteration von V4.1 Flash 1017 als „Pareto-Verbesserung“. Dies ist ein ökonomisches Konzept, das bedeutet, dass nach der Änderung einer Sache mindestens ein Aspekt verbessert wird, ohne dass irgendein anderer Aspekt verschlechtert wird.
Bei dem Modell zeigt sich dies darin, dass alle Benchmark-Werte des Modells höher sind, Aufgaben schneller abgeschlossen werden, die Ausgabe kürzer ist und der Preis unverändert bleibt.
Jemand in der DEV-Community hat Tests durchgeführt und festgestellt, dass im Vergleich zu 4.1 Flash die Ausgabe von DeepSeek V4.1 Flash 1017 kürzer, die Aufgabe schneller erledigt ist und die Kosten für die Erledigung jeder Aufgabe sogar gesunken sind.
Tatsächlich war V4.1 Flash selbst ein extrem „gesprächiges“ Modell. Praktische Messungen auf OrcaRouter zeigen, dass V4.1 Flash auf demselben Intelligence Index von Artificial Analysis 250 Millionen Token ausgibt, was 56 % mehr ist als die 160 Millionen von K3.
Aufgrund der kausalen Encoder-Decoder-Architektur von V4.1 Flash mit insgesamt 552 Milliarden Parametern werden jedoch nur 8 Milliarden beim Prefill und 16 Milliarden beim Decode aktiviert. Der KV-Cache wird auf nur 890 Byte pro Token komprimiert, der Grafikkartenspeicherbedarf sinkt auf ein Viertel des Vorgängermodells und der SSD-Speicherbedarf auf ein Achtel.
Daher erzielt DeepSeek bessere Benchmark-Ergebnisse, schließt Aufgaben schneller ab und gibt kürzere Ausgaben aus. Liang Wenfeng ist nicht bereit, eine Eigenschaft zu opfern, um eine andere zu erreichen.
Agent ist ein Teil des Dienstes für AGI
Liang Wenfeng sagte einmal: „Das, was Investoren derzeit am häufigsten sehen, ist Agent. Aber für uns Forscher sehen wir derzeit mehr das Lernen und die Frage, wie man das Problem des Lernens lösen kann.“
Im Klartext meint Liang Wenfeng, dass Agent nur ein Teil von AGI und nicht das Ganze ist.
Im Jahr 2025 war Yang Zhilin zu Gast in Zhang Xiaojuns „Business Interview“. Bezüglich reiner Inferenzmodelle und Agent stellte Yang Zhilin die Theorie des Gehirns im Tank auf: „Stell dir ein Aquarium vor, in dem du ein Gehirn platzierst, das keine Verbindung zur Außenwelt hat. Es denkt nur ständig in sich selbst hinein, braucht keine Interaktion mit der Außenwelt und kann eine Aufgabe lösen.“
Bezüglich Agent sagte Yang Zhilin: „Es ist nicht mehr das ‚Gehirn im Tank‘, sondern es interagiert mit der Außenwelt. Mein nächstes Handeln hängt von den Rückmeldungen aus der Interaktion und der Aktualisierung neuer Zustände ab, die mir die Außenwelt gibt.“
Das Gehirn im Tank repräsentiert starke Inferenzmodelle wie o1. Was Yang Zhilin anstrebt, ist, dass das Modell mehr Tools nutzen und mehr Runden von Interaktionen durchführen kann.
Egal was Liang Wenfeng und Yang Zhilin sagen, es handelt sich um ihre Definition von Agent in Bezug auf die Produktphilosophie. Um die tatsächliche Agent-Fähigkeit eines Modells zu beurteilen, muss man es in echten Aufgaben testen.
Neben Artificial Analysis verwendet die Community häufig die „Zhizhen | Langzeit-Tracking-Liste für die Intelligenz großer Modelle“ (auch „Katzenliste“ genannt), um das Niveau von Modellen zu testen.
Sie unterteilt die Fähigkeiten des Modells in drei Bereiche: Inferenz, Agentik und visuelle Verarbeitung. Auf der Seite für den Bereich Agentik wird eine Reihe von Aufgaben verwendet, die lange Abläufe, mehrere Einschränkungen und die Zusammenarbeit mit Tools erfordern. Die Zahlen und Buchstaben auf der linken Seite geben die Punktzahl für Abzüge und den Tarif an. Auf der Seite steht „1/A steht für Punktzahl für Abzüge / Tarif“, wobei kleinere Zahlen besser sind. Der ¥-Betrag auf der rechten Seite gibt offenbar die Kosten an, die das Modell für die Bearbeitung der Aufgabe ausgibt.
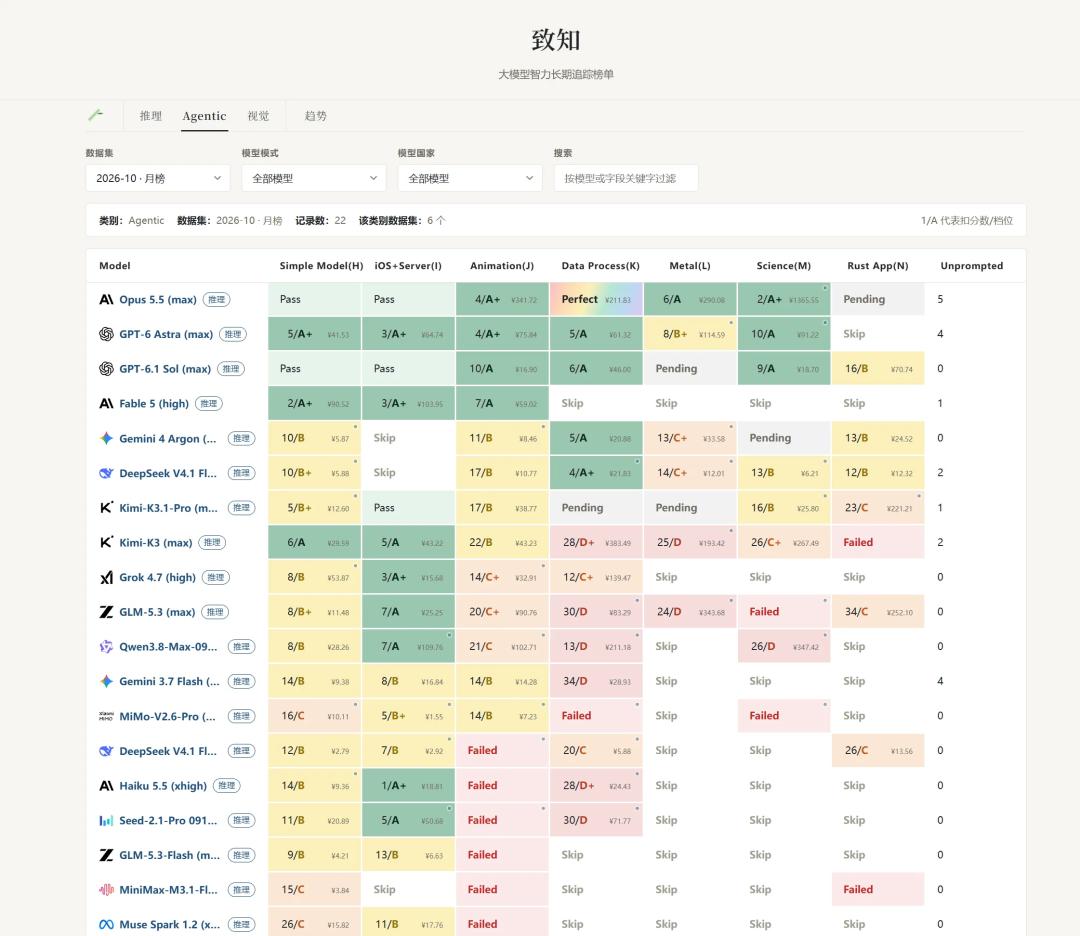
Im Vergleich zur Vorgängergeneration K3 sind die Fortschritte von K3.1 Pro sehr offensichtlich. Bei der Rust App schnitt K3 mit „Failed“ ab, was bedeutet, dass die Aufgabe nicht erfüllt werden konnte, während K3.1 Pro 23 Punkte und den Tarif C erzielte. Bei der Aufgabe Science erzielte K3 26 Punkte und den Tarif C+, während K3.1 Pro auf 16 Punkte und den Tarif B verbessert wurde. Bei der Aufgabe Animation stieg die Punktzahl von 22 auf 17.
Dieses Ergebnis stimmt mit der Aussage von Moonshot AI überein, dass sich die Agent-Ausführungsfähigkeit stark verbessert hat.
Auf dieser Liste schneidet K3.1 Pro jedoch schlechter ab als DeepSeek V4.1 Flash 1017.
Bei der Rust App erzielt DeepSeek V4.1 12 Punkte und den Tarif B, K3.1 Pro 23 Punkte und den Tarif C. Bei der Aufgabe Simple Model erzielt K3.1 Pro 5 Punkte und DeepSeek 10 Punkte, beide befinden sich im Tarif B+, wobei Kimi etwas besser abschneidet. Bei der Aufgabe Animation erzielen beide Seiten 17 Punkte und den Tarif B, also ein Unentschieden. Bei der Aufgabe Science erzielt DeepSeek 13 Punkte und Kimi 16 Punkte, beide befinden sich im Tarif B, wobei DeepSeek etwas besser abschneidet.
Darüber hinaus sind die Aufgaben Data Process und Metal bei K3.1 Pro noch als „Pending“ markiert, was bedeutet, dass derzeit noch keine endgültige Schlussfolgerung gezogen werden kann.
Warum schneidet K3.1 Pro, das bei Artificial Analysis fast an Opus 5.5 heranreicht, hier schlechter ab als DeepSeek?
Das liegt an einer Regel der Katzenliste: „Das Modell ist nicht auf die maximale Token-Anzahl beschränkt, aber es gibt Punktabzüge für übermäßig lange Denkvorgänge je nach Schwierigkeit der Aufgabe.“ Das bedeutet, je mehr Token verbraucht werden, desto mehr Punkte werden abgezogen, was K3.1 Pro stark