Das Schlachtfeld der Rechenleistung hinter der Innovation von KI-Endgeräten
Die jährliche Innovationskonferenz für Unterhaltungselektronik (CEIC) findet wie geplant in Shenzhen statt. In diesem Jahr sind intelligente Roboter mit körperlicher Intelligenz zu einer neuen Variablen der Messe geworden.
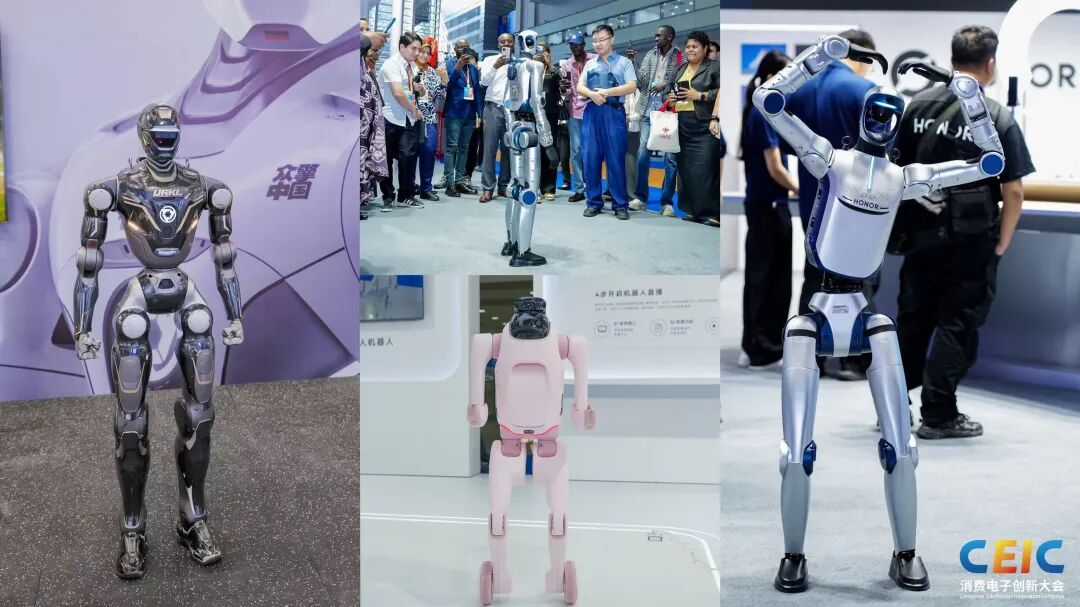
Im Vergleich zu früheren Modellen sind diese Roboter bei der Verknüpfung von Befehlsverständnis, Umfeldwahrnehmung und Aktionsausführung viel besser aufeinander abgestimmt. Ihre Fähigkeiten haben sich von der Ausführung einer einzelnen Aktion schrittweise auf die Bearbeitung von Aufgaben ausgedehnt, die mehrere Schritte erfordern und sich jederzeit ändern können.
Hinter diesen Fähigkeiten steht die rechnerische Unterstützung, die den gesamten Aufgabenablauf begleitet. Nachdem der Roboter einen Befehl erhalten hat, kann die On-Board-Software Befehle und Vor-Ort-Informationen gemäß der festgelegten Aufgabenteilung an Edge- oder Cloud-Server zur Planung übergeben. Wenn die Cloud die Anforderung empfängt, beginnen mehrere Rechenchips im Superknoten gemeinsam mit der Ausführung des Planungsmodells, um das Betriebsschema zu generieren. Der Roboter führt dann die Aktionen gemäß dem zurückgegebenen Betriebsplan aus.
Von der Aufgabenverarbeitung auf dem Endgerät über die Modellberechnung auf dem Server bis hin zur Stromversorgung und Wärmeabfuhr im Rechenzentrum arbeiten alle Glieder koordiniert zusammen und unterstützen gemeinsam die vielfältigen neuen Fähigkeiten von KI-Endgeräten auf der CEIC.
Rechenleistung ist zweifellos zu einem Kernthema der KI-Industrie geworden. Wenn man jedoch die Rechenleistungsbereitstellung und den Rechenprozess hinter den Fähigkeiten der Endgeräte aufschlüsselt, stellt sich heraus, dass die früher isolierten Leistungsindikatoren und das tatsächliche Benutzererlebnis der Endgeräte auch mit systemischem Systemdesign und Bereitstellungsentscheidungen zusammenhängen. Wie Endgeräte und Backend ihre Aufgaben aufteilen, wie Rechenressourcen organisiert werden und wie verschiedene Glieder zusammenwirken, beeinflussen alle, was eine KI-Funktion letztendlich leisten kann und zu welchen Kosten sie dauerhaft bereitgestellt werden kann.
Im Hinblick darauf, wie Rechenleistung in Produktfähigkeiten umgewandelt werden kann, läuft ein weiterer Wettbewerb hinter der Innovation von KI-Endgeräten ab.
Rechenplanung reagiert zuerst – Cloud-Edge-Endgerät-Kooperation rückt wieder in den Fokus
Nachdem ein KI-Endgerät eine Aufgabe erhalten hat, wird zuerst die Aufgabenanalyse und Rechenplanung gestartet. Das System zerlegt die Aufgabe zunächst in Kombination mit den Benutzerbefehlen und den vor Ort wahrgenommenen Informationen und verteilt dann verschiedene Glieder gemäß der Reaktionsgeschwindigkeit, dem Rechenaufwand und den Netzwerkbedingungen an das lokale Endgerät, die Edge-Geräte oder die Cloud-Server.
Am Beispiel der Aufgabe, einen Schreibtisch aufzuräumen: Die Kameras und Sensoren des intelligenten Roboters mit körperlicher Intelligenz erfassen kontinuierlich Informationen auf dem Schreibtisch. Das System versteht dann die konkrete Bedeutung der Aufgabe, bestimmt die Ablageposition verschiedener Gegenstände und legt gleichzeitig die Reihenfolge des Greifens und der Bewegungen fest.
Diese Berechnungen haben unterschiedliche Anforderungen an die Reaktionsgeschwindigkeit und die Ressourcen. Das Erkennen der Benutzerabsicht und das Planen einer Reihe von Betriebsschritten erfordern möglicherweise die Ausführung eines größeren Modells mit relativ höherem Rechenaufwand. Die Anpassung von Position, Kraft und Kollisionsrisiko nachdem der mechanische Arm ausgefahren ist, muss hingegen rechtzeitig auf Basis der neuesten Wahrnehmungsinformationen abgeschlossen werden und kann keine lange Netzwartezeit tolerieren.
Daher ist die häufigere Art der Rechenaufgabenteilung für intelligente Roboter mit körperlicher Intelligenz die, dass Berechnungen mit hohen Anforderungen an die Reaktion wie Aktionssteuerung und sichere Hindernisvermeidung lokal auf dem Roboter verbleiben. Aufgabenverständnis und komplexe Planung, die starke Modellfähigkeiten erfordern, können an Edge-Geräte oder Cloud-Server übergeben werden. Nachdem das Rechenergebnis zurückgegeben wurde, wandelt das lokale Steuersystem des Roboters es dann in konkrete Aktionen der Gelenke und des mechanischen Arms um.
Diese Rechenaufgabenteilung wird normalerweise bereits in der Phase des Produktdesigns und der Modellbereitstellung festgelegt. Wenn der Roboter in den tatsächlichen Betrieb eintritt, sendet das Planungsprogramm die entsprechenden Anforderungen gemäß den festgelegten Regeln, dem Netzwerkzustand und den Aufgabenanforderungen an verschiedene Positionen.
MIAO Fuyou, CTO des Sekretariats der Global Computing Alliance (GCC), sagte zu 36Kr, dass diese intelligente kooperative Aufgabenteilung zwischen Cloud, Edge und Endgerät bereits in der frühen Phase der Cloud-Entwicklung diskutiert wurde. Damals hoffte man hauptsächlich, die Reaktion durch Verkürzung der Kommunikationsentfernung zu verbessern. Heutzutage müssen KI-Endgeräte komplexere Aufgaben verarbeiten. Ressourcennutzung, Energieverbrauch und Kosten sind auch zu wichtigen Gründen für Unternehmen geworden, die Rechenaufgabenteilung neu zu ordnen.
Vor diesem Hintergrund hat die GCC während der CEIC die Veröffentlichung der „Zehn großen Trends der globalen Rechenleistung 2027“ herausgegeben und die „intelligente Kooperation im gesamten Bereich von Cloud, Edge und Endgerät“ als einen der zehn Trends aufgeführt.
MIAO Fuyou erläuterte am Beispiel von Haushaltsrobotern die Veränderung der Art der Rechenleistungskonfiguration durch die Kooperation von Cloud, Edge und Endgerät weiter.
Er erklärte, dass Roboter bei der Planung komplexer Aufgaben möglicherweise kurzzeitig eine hohe Rechenleistung benötigen, aber nach Eintritt in wiederholte Vorgänge sinkt der Rechenbedarf wieder. Wenn keine Aufgaben vorliegen, können Hochleistungs-Chips sogar lange Zeit ungenutzt bleiben. Wenn jeder Roboter mit lokaler Hardware nach Spitzenbedarf konfiguriert wird, müssen Unternehmen und Verbraucher die Kosten für Ressourcen tragen, die nicht häufig verwendet werden. Wenn ein Teil der komplexen Berechnungen in die Cloud verlagert wird und mehrere Geräte die Rechenressourcen gemeinsam nutzen, kann die Hardwarebelastung einzelner Endgeräte verringert werden.
In Fabrikszenarien hingegen kann die Berechnung an Positionen bereitgestellt werden, die näher an den Robotern liegen. Wenn mehrere Geräte konzentriert arbeiten, können die Edge-Server in der Nähe der Werkstatt nicht nur von mehreren Robotern gemeinsam genutzt werden, sondern auch die Zeit verkürzen, die für die Übertragung von Anforderungen an entfernte Rechenzentren benötigt wird. Sie eignen sich besser für die Übernahme von Aufgaben, die bestimmte Anforderungen an die Reaktionsgeschwindigkeit stellen, aber von lokalen Geräten nicht unabhängig erledigt werden können.
Daraus geht hervor, dass die Rechenplanung zwischen Cloud, Edge und Endgerät ein zentrales Glied ist, mit dem KI-Endgeräte die Modellfähigkeit in das Produkterlebnis umwandeln. Wo die Aufgabe abgeschlossen wird und welche Ressourcen sie übernehmen, wirkt sich direkt auf die Reaktionsgeschwindigkeit, die Akkulebensdauer und die Dienstkosten des Endgeräts aus.
Aber MIAO Fuyou gab auch zu, dass eine solche Bereitstellung höhere Anforderungen an das Modellentwurf und die technische Entwicklung von Endgeräteherstellern stellt. Derzeit erforscht der Ausschuss für die Entwicklung der körperlichen Intelligenzindustrie der GCC die Kooperationsarchitektur von Cloud, Edge und Endgerät, um zu untersuchen, wie Modell-Inferenzaufgaben zwischen Lokal, Edge und Cloud verteilt werden können, um Unternehmen Referenzen für die Auswahl geeigneter Rechenlösungen für ihre eigenen Produkte zu bieten.
Superknoten beschleunigen die Backend-Reaktion
Die Zuweisung von Rechenaufgaben an Edge oder Cloud löst das erste Problem „wo gerechnet wird“. Für Endgeräte müssen nach dem Senden von Befehlen und Vor-Ort-Informationen warten, bis der Server das Modell ausführt, das Betriebsschema generiert und das Ergebnis zurück an das Endgerät überträgt. Dieser Prozess vom Empfang der Anforderung bis zur Rückgabe des Ergebnisses ist die Backend-Reaktion.
Da die Aufgaben, die KI-Endgeräte übernehmen, immer komplexer werden, muss das Backend nicht nur eine einfache Berechnung verarbeiten. Die Modellgröße, die Kontextlänge und die Anzahl der gleichzeitig gestellten Anforderungen steigen alle. Wie eine große Anzahl von Inferenzanforderungen in begrenzter Zeit übernommen werden kann, wird zu einem Problem, dem das Backend-Rechensystem gegenübersteht.
Das kürzlich von DeepSeek veröffentlichte V4.1-Flash-Inferenzsystem bietet einen Bezugswert. Sein einzelnes Produktionscluster bedient derzeit täglich etwa 155 Billionen Tokens. Im Inneren des Systems werden in der Vorverarbeitungsphase für die Eingabe gewöhnliche Server mit 8 Karten verwendet, während in der Decodierungsphase für die schrittweise Generierung der Ausgabe Superknoten mit 64 bis 128 Karten eingesetzt werden. DeepSeek erläuterte, dass die massive Parallelisierung von Experten den Speicherzugriffsdruck bei jedem Schritt des Decodierungsprozesses verringern und die Effizienz des Systems bei der Verarbeitung von Tokens verbessern kann.
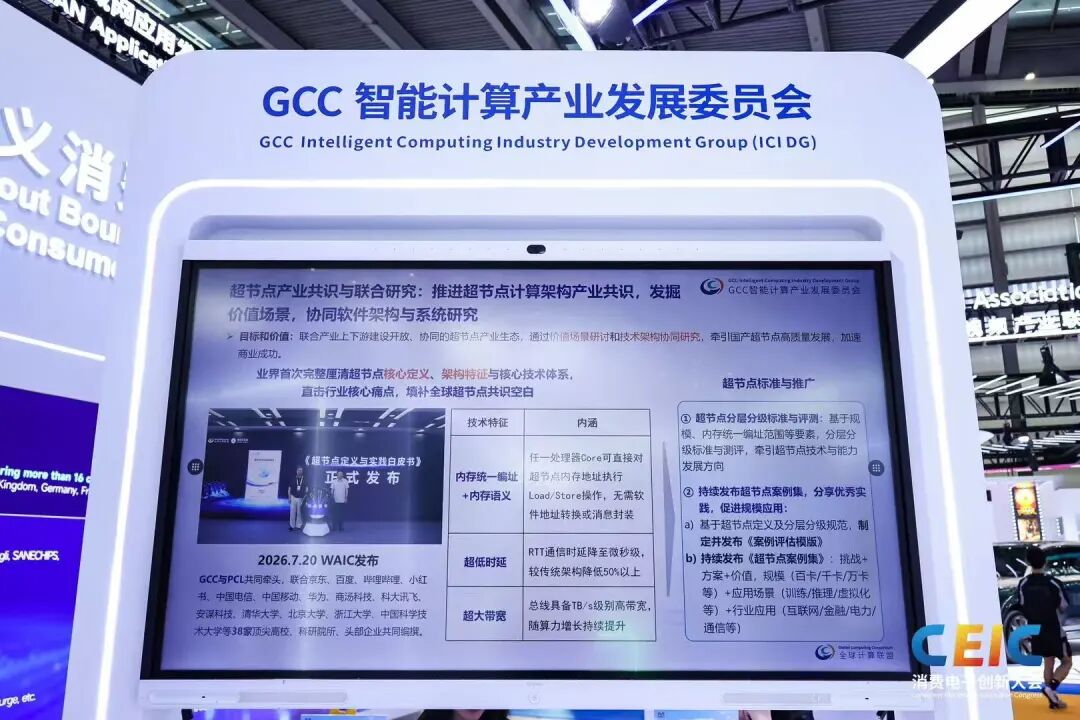
Man kann sehen, dass Superknoten derzeit eine effektivere Architektur sind, um mehrere Rechenchips gemeinsam für die Ausführung von Modellen zu organisieren. MIAO Fuyou sagte zu 36Kr, dass ein großer Teil oder sogar der größte Teil des aktuellen und zukünftigen Rechenleistungsverbrauchs möglicherweise aus der Inferenz großer Modelle stammt. Im Gegensatz zur traditionellen Berechnung, die in mehrere unabhängige Aufgaben unterteilt werden kann, deren Ergebnisse nach Abschluss separat zusammengefasst werden, müssen verschiedene Rechenknoten während der Inferenz großer Modelle ständig Daten lesen, Zwischenergebnisse austauschen und dieselbe Aufgabe gemeinsam vorantreiben.
Daher besteht die Funktion von Superknoten nicht darin, dass ein einzelner Chip selbst schneller rechnet, sondern durch eine Verbindung mit höherer Bandbreite und geringerer Latenz sowie durch effizientere Speicherzugriffsmethoden die Zeit für die Übertragung und das Warten auf Daten zwischen mehreren Chips zu verringern.
Das gemeinsam von der GCC und dem Peng Cheng Laboratory veröffentlichte „Whitepaper zu Definition und Praxis von Superknoten“ erläutert, dass diese Architektur den Datenübertragungsweg verkürzen und die Kommunikations- und Synchronisationskosten bei der massiven parallelen Berechnung senken kann. Konkret auf die Aufgabe, den Schreibtisch aufzuräumen, angekommen, spielen Superknoten eine Rolle im Prozess von dem Moment, in dem die Anforderung in das Modell eintritt, bis zur Generierung des Betriebsschemas: Sie lassen mehrere Chips, die das Modell ausführen, effizienter zusammenarbeiten und helfen dem Backend, die Inferenz schneller abzuschließen oder mehr Anforderungen von Robotern in derselben Zeit zu übernehmen.
Das bedeutet auch, dass die Fähigkeiten, die KI-Endgeräte zeigen, nicht nur von den Chips und Modellen auf dem Gerät abhängen, sondern auch davon, ob das Backend die Berechnung effizient abschließen kann.
Die realen Träger der virtuellen Berechnung verbinden
Man muss sehen, dass Superknoten, Server und Netzwerkgeräte keine abstrakten Ressourcen sind, die in der „Cloud“ schweben. Sie werden letztendlich in echten Schränken und Rechenzentren installiert, erhalten kontinuierlich Strom und leiten die bei dem Betrieb erzeugte Wärme ab. Daher ist die nächste Ebene des Rechensystems, wie das Rechenzentrum diese Geräte trägt und ihren Betrieb gewährleistet.
MIAO Fuyou sagte in einem Interview mit 36Kr, dass die Lebensdauer eines Rechenzentrums zwanzig bis dreißig Jahre betragen kann, während GPUs fast jedes Jahr neue Versionen erhalten und alle ein bis zwei Jahre große Generationsänderungen durchlaufen können. Daher müssen die Bauherren berücksichtigen, ob das Rechenzentrum, in das sie derzeit mit hohem Kapitalaufwand investieren, auch in einigen Jahren noch an neue Rechengeräte angepasst ist.
Chips können schnell iterieren, aber die Flussgeschwindigkeit und Temperaturdifferenz der Kühlflüssigkeit sind durch reale Bedingungen begrenzt. Für Rohrleitungen wie Stromleitungen und unterstützende Einrichtungen muss ebenfalls Platz reserviert werden. Bei der Planung von Megawatt-Rechenleistungssystemen und Gigawatt-Rechenzentren müssen Stromversorgung, Kühlung und bauliche Bedingungen früher in das Systemdesign einbezogen werden.
Gleichzeitig wirkt sich auch die Kompatibilität von Geräten mehrerer Lieferanten auf die Lieferleistung aus. MIAO Fuyou erklärte, dass Cloud-Anbieter oft Chips von verschiedenen Lieferanten einkaufen. Wenn für jeden Chip separat Platinen, Knoten und Schränke entworfen werden müssen und die Verwaltungsmethoden unterschiedlich sind, erhöht dies die Komplexität von Bereitstellung und Betriebsunterhalt.
Aus diesem Grund wird die Bedeutung der Konsensbildung rund um die Anforderungen an das Design und die Verwaltung von Rechenzentren weiter hervorgehoben. MIAO Fuyou sagte zu 36Kr, dass die GCC derzeit einen geeigneten Standard für diese kooperative Zusammenarbeit in der Industrie bereitstellt. Seinen Angaben zufolge hat die Open AI-Infra-Community unter der GCC Projektgruppen für Rechenzentrumsinfrastruktur, ganze Schränke und Platinen eingerichtet, um Nutzer, Bauherren, Chip- und Gerätelieferanten zur gemeinsamen Diskussion dieser Probleme anzuregen.
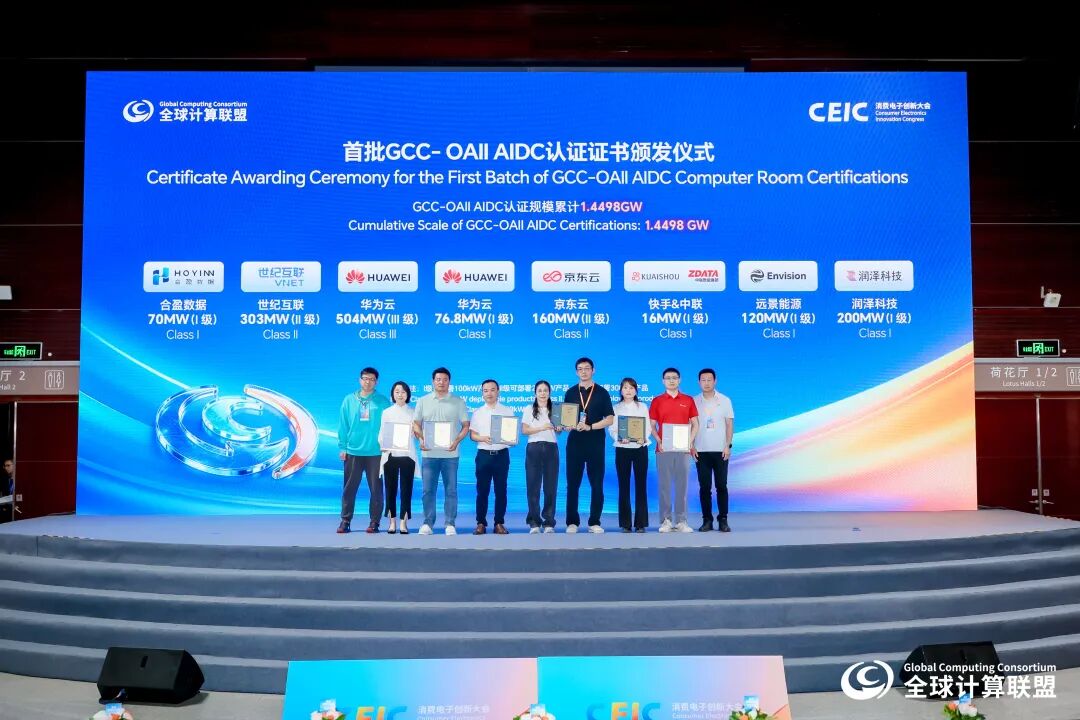
Unter anderem wandeln die AIDC-Infrastrukturnorm und die dazugehörige Zertifizierung die Bedingungen, die ein Rechenzentrum erfüllen muss, in überprüfbare Anforderungen um, die den Geltungsbereich von Gebäudearchitektur, Rechenzentrumsumgebung, Stromversorgung und -verteilung, Luft- und Flüssigkühlung, Lieferung und Betriebsunterhalt abdecken. Für Cloud-Anbieter, die nach Rechenzentren suchen, kann dies ihnen helfen zu beurteilen, ob die Einrichtungen die Anforderungen an die Gerätebereitstellung erfüllen. Für Bauherren bietet es dagegen eine Referenz für Planung und Lieferung und fördert die schnelle Inbetriebnahme der Infrastruktur.
