Das Projektteam von miHoYo hat sich mit den Spitzenabsolventen der Tsinghua-Universität und der Peking-Universität zusammengeschlossen und ein Open-Source-KI-Modell für Spielsteuerungen veröffentlicht – ByteDance hat dies ebenfalls bereits getan.
Am Abend des 22. Oktober tauchte plötzlich auf GitHub ein Open-Source-Projekt mit den Logos von miHoYo, Tsinghua-Universität, Universität der Chinesischen Akademie der Wissenschaften und Universität Hongkong auf. Der große Titel lautete deutlich Scaling in Games, was alle sehr überraschte – hat miHoYo heimlich eine große Aktion gestartet?
Pu Tao Jun hat die Projektvorstellung sorgfältig durchgesehen und festgestellt, dass die Sache nicht so groß ist. Nach den Informationen der Autoren der Arbeit handelt es sich höchstwahrscheinlich um die Forschungsergebnisse, die gemeinsam von mehreren Praktikanten im KI-Forschungs- und Entwicklungsteam des Honkai-Projekts (miHoYo Honkai AI R&D Team) veröffentlicht wurden, und es muss sich nicht um ein strategisches Forschungsprojekt auf Unternehmensebene von miHoYo handeln. Die Arbeit wurde derzeit auch nur auf der Preprint-Plattform arXiv veröffentlicht (d. h. sie wurde noch nicht von Fachkollegen begutachtet).
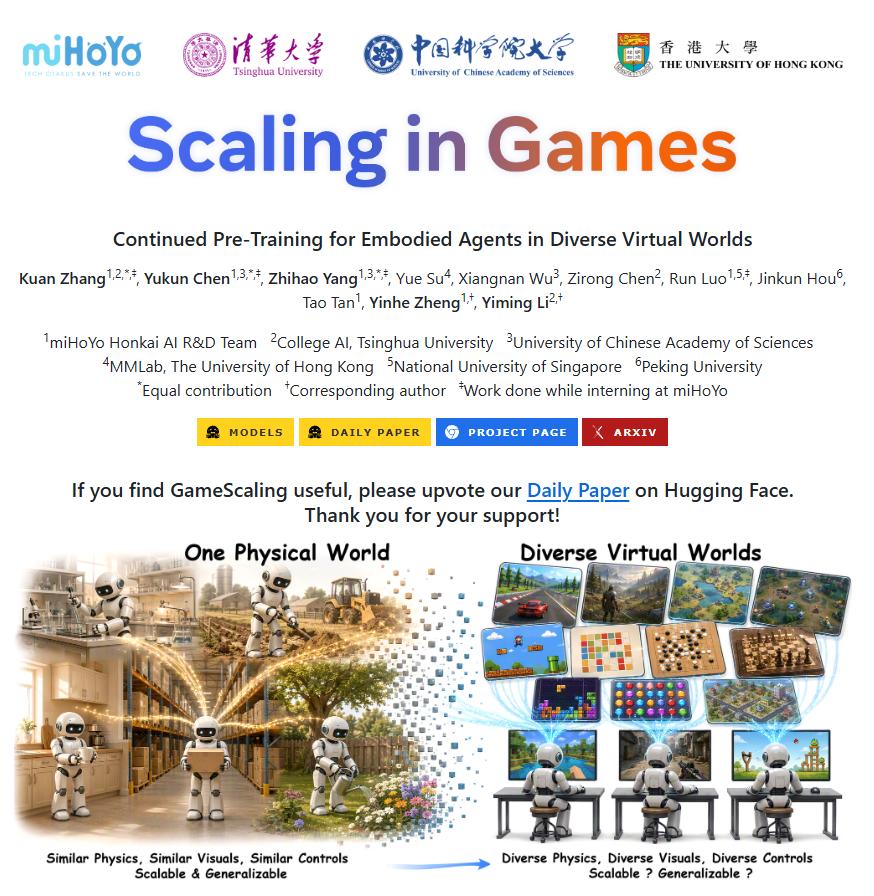
Verkörperte Intelligenz kann das Verständnis der physikalischen Gesetze der realen Welt relativ allgemein anwenden, aber die Regeln der virtuellen Spielwelt sind nicht konsistent. Kann KI wie ein Mensch schnell die unbekannten Regeln und Steuerungsmethoden verschiedener Spiele anpassen?
Es ist erwähnenswert, dass die Einheiten einiger Autoren der Arbeit nicht miHoYo sind, sondern die Universität Hongkong, die Tsinghua-Universität, die Peking-Universität usw. Derzeit gibt es jedoch keine öffentlichen Informationen über das spezifische Kooperationsmodell des Projekts.
Obwohl die Sache nicht sehr groß ist, hat die Forschungsrichtung dieser Arbeit immer noch einen beträchtlichen Wert.
Worum geht es in der Arbeit?
Der Arbeit zufolge scheint das Team bei dem Thema „KI kann Spiele bedienen“ einen Schritt weiter gehen zu wollen und zu erforschen: Kann KI, nachdem sie eine große Menge an Spielerfahrung erlernt hat, das Gelernte auf neue Fälle übertragen und mehr unbekannte Spiele problemlos bedienen?
Während des Trainings basierte das Team auf dem visuellen Sprachmodell Qwen3.5 und nutzte die Spielbilder sowie die entsprechenden Aufzeichnungen von Tastatur- und Mausoperationen, um das Modell weiter zu trainieren, damit das Modell lernen kann, welche Aktion unter einem bestimmten Bild ausgeführt werden soll. Dieser Prozess ähnelt einigermaßen der Bedienung von Spielen durch echte Spieler: Die KI sieht zuerst das Bild, beurteilt dann die Situation, ergreift Maßnahmen und passt sich dann anhand des nächsten Bildes weiter an.
Konkret versucht dieses Experiment, drei Fragen zu klären:
Erstens: Bedeutet ein größeres Modell, dass die KI besser Spiele spielen kann? – Sie haben vier KI-Modelle unterschiedlicher Größe vorbereitet, deren Parameteranzahl 80 Millionen, 2 Milliarden, 9 Milliarden und 27 Milliarden beträgt. Im Allgemeinen ist das Potenzial des Modells, komplexe Informationen zu lernen und zu verarbeiten, umso höher, je größer die Parameteranzahl ist, aber die Betriebskosten sind normalerweise auch höher.
Zweitens: Je mehr Spieldaten die KI lernt, desto besser kann sie Spiele spielen? – Sie haben Spieldaten in unterschiedlichen Größen vorbereitet, die Spielaufzeichnungen von 50 Stunden, 100 Stunden, 200 Stunden, 400 Stunden, 800 Stunden und 1600 Stunden entsprechen.
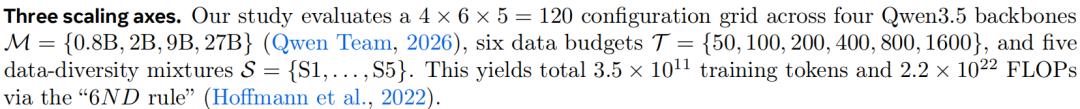
Drittens: Je vielfältiger die gelernten Spiele sind, desto leichter kann die KI unbekannte Spiele erlernen? – In diesem Experiment verwendeten einige Trainingspläne nur die Spielbetriebsdaten von Minecraft, andere mischten Daten anderer Spiele ein, darunter verschiedene Arten von Produkten wie Apex Legends, Counter-Strike 2, PUBG und Monster Hunter Wilds.
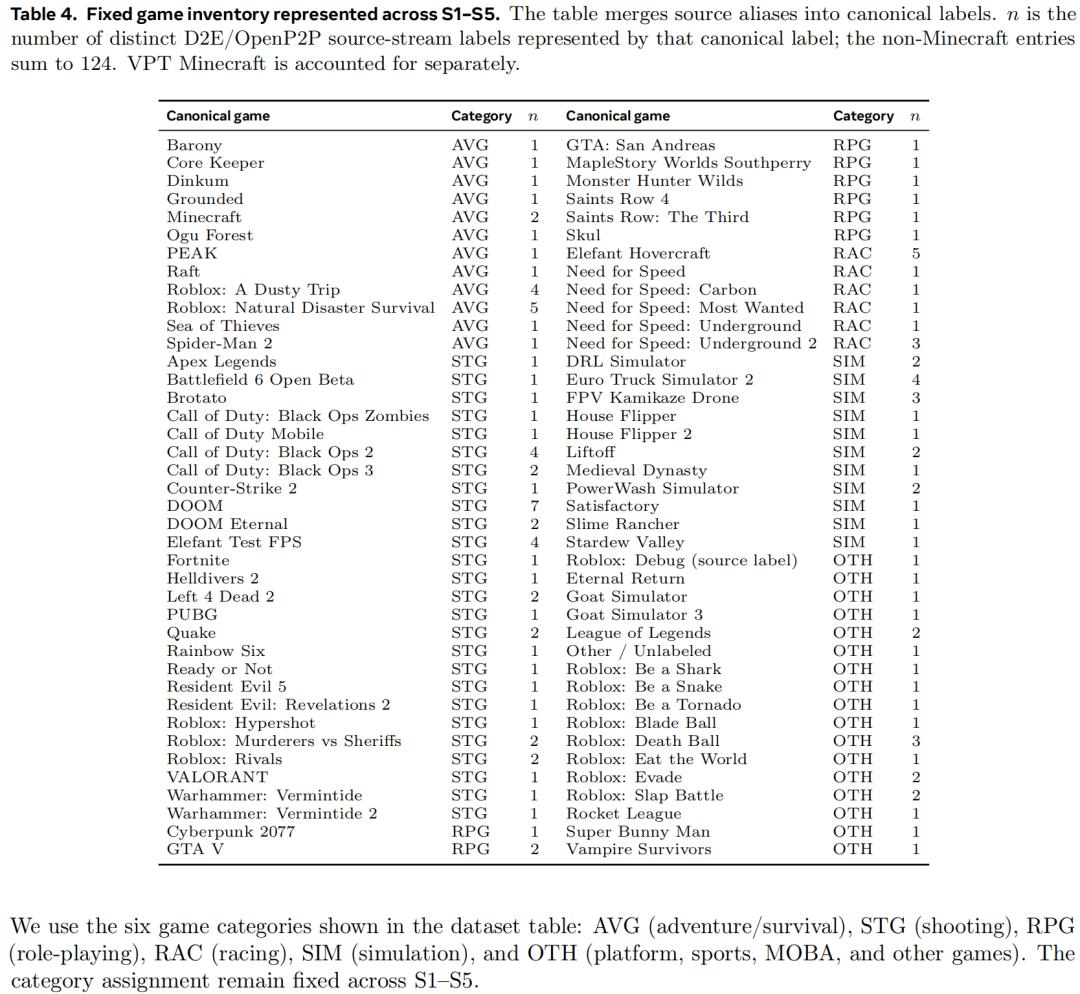
Dies sind die Lernmaterialien des Modells
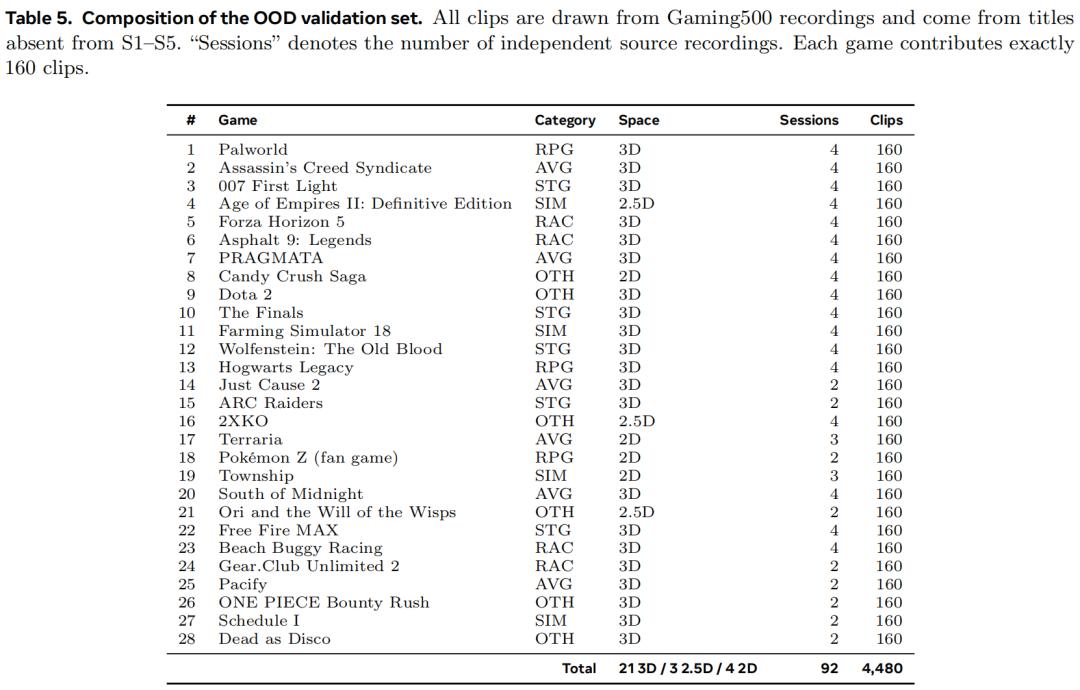
Weitere 28 Spiele, die nicht in den Trainingsdaten enthalten sind, werden verwendet, um die Vorhersagefähigkeit der KI für die Bedienung unbekannter Spiele zu prüfen
Den experimentellen Ergebnissen zufolge bedeutet zunächst einmal, dass ein größeres Modell nicht unbedingt bedeutet, dass die KI besser Spiele spielen kann.
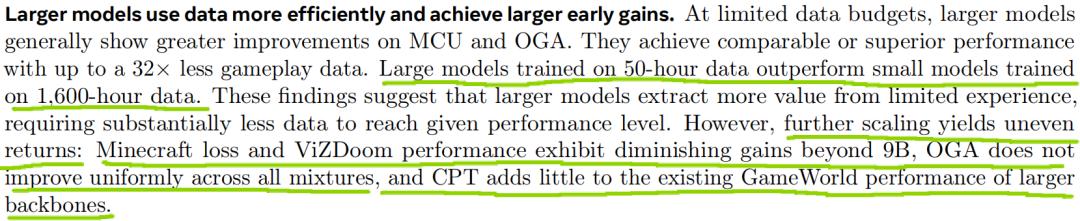
Größere Modelle können normalerweise mit weniger Spieldaten bessere Betriebsfähigkeiten erlernen. Einige große Modelle benötigen nur 50 Stunden Spieldaten zum Lernen, und ihre Ergebnisse übertreffen die der kleinen Modelle, die 1600 Stunden lang gelernt haben. Dies bedeutet jedoch nicht, dass die unbegrenzte Erweiterung der Modellgröße alle Probleme lösen kann.
Denn wenn das Modell eine bestimmte Größe erreicht, kann der Nutzen durch die weitere Erhöhung der Parameter immer geringer werden.
Darüber hinaus haben sie auch die Grenzen großer allgemeiner Modelle beim Erlernen der Spielbedienung festgestellt: Das „Gehirn“ kann Schritt halten, aber die „Handgeschwindigkeit“ ist schwer zu sagen.
In dem pausierbaren Test (das Spiel wird angehalten, während die KI überlegt und Betriebsanweisungen generiert, und läuft erst weiter, nachdem sie eine Entscheidung getroffen hat) zeigte Gemini-3.8-Flash eine recht gute Leistung; aber im Echtzeit-Bedienungstest (das Spiel wird nicht angehalten) sank die Punktzahl von Gemini-3.8-Flash, und GameScaling-9B-S3 zeigte stattdessen eine bessere Leistung.
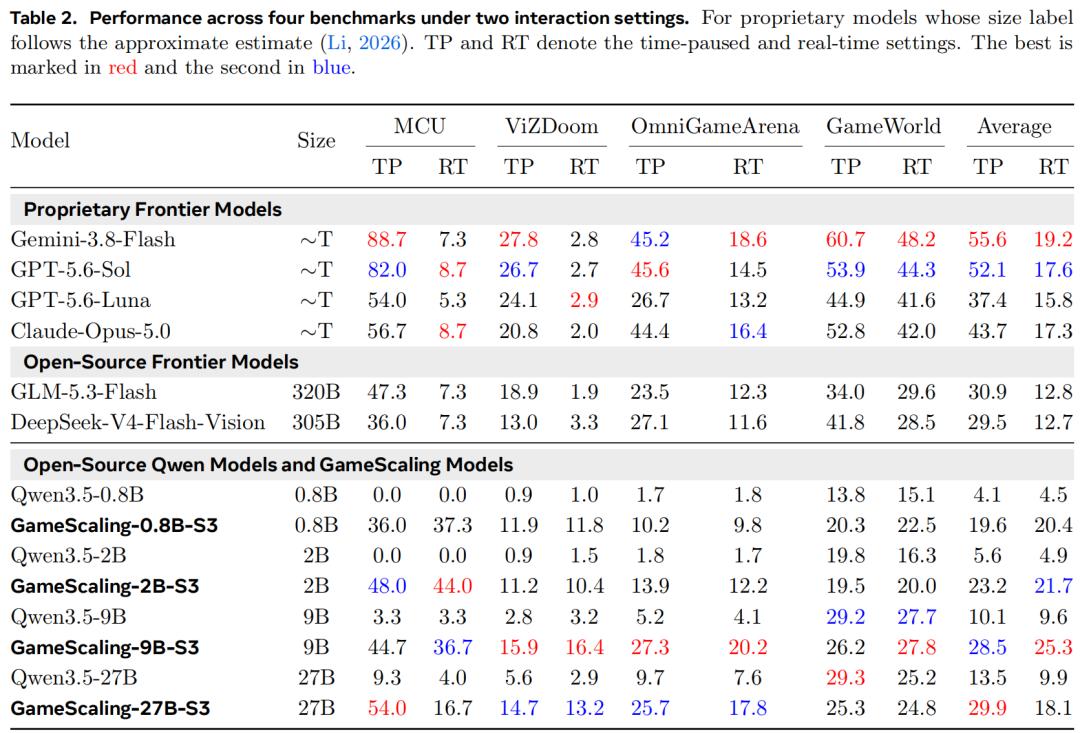
TP steht für time-paused, Pause ist erlaubt, RT steht für real-time, Pause ist nicht erlaubt
Der Grund für dieses Ergebnis hängt möglicherweise mit der Antwortgeschwindigkeit des Modells zusammen. Obwohl große allgemeine Modelle stärkere Verständnis- und Schlussfolgerungsfähigkeiten besitzen, benötigen sie oft mehr Zeit zum Nachdenken.
Darüber hinaus wird Gemini über die API des Dienstanbieters aufgerufen, während GameScaling auf den eigenen Servern des Teams ausgeführt wird. Daher kann der Leistungsunterschied auch von der Bereitstellungsumgebung und der Antwortverzögerung beeinflusst werden.
Wenn das Spiel das Anhalten erlaubt, ist das kein Problem. Sobald das Spiel aber kontinuierlich läuft, können verspätete Aktionen den besten Zeitpunkt verpassen.
Zweitens: Je vielfältiger die Spiele sind, die die KI lernt, desto wahrscheinlicher ist es, dass sie bei ähnlichen neuen Spielen „sofort meistert“.
Das Team stellte fest, dass die Vorhersagefähigkeit des Modells für Tastatur- und Mausoperationen in den ersten Dutzend Stunden der Trainingsdaten schnell ansteigt. Mit anderen Worten: Am Anfang lernt es hauptsächlich, wie man die Spielsteuerung bedient. Selbst bei unbekannten Spielbildern wird seine Vorhersage von Tastatur- und Mausoperationen genauer.
Nach dem anfänglichen Lernprozess wird sich jedoch seine Leistung in anderen Spielen nicht unbedingt verbessern, wenn die KI weiterhin die Daten eines einzelnen Spiels lernt – wenn das Modell ständig Minecraft lernt, wird es mit der Bedienung von Minecraft immer vertrauter, was nicht bedeutet, dass es andere Spiele gut „spielen“ kann.
Wenn die KI mit mehr ähnlichen Spielen in Kontakt kommt, scheint dies ihre Leistung in unbekannten Spielen zu verbessern.
Das Team stellte fest, dass bei Verwendung von 1600 Stunden Spieldaten für das Training die Gesamtpunktzahl der Modelle, die viele verschiedene Spiele gelernt haben, im Testsystem OmniGameArena (7 3D-Spielumgebungen, die auf Unreal Engine 5 aufgebaut sind, um zu testen, ob die KI 3D-Spiele mit ähnlichen Bedienmethoden bedienen kann) auf etwa das 2,8-fache des Modells angestiegen ist, das nur Minecraft gelernt hat.
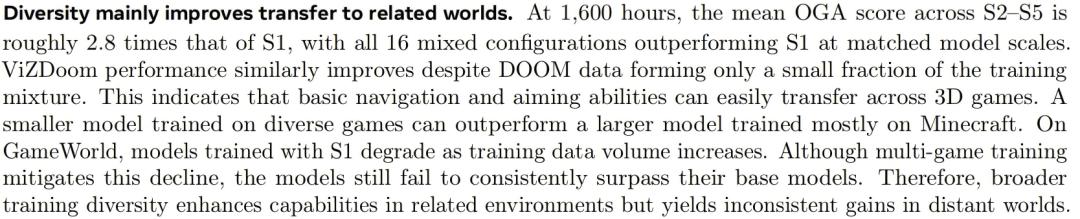
Das heißt, zwischen Spielen mit ähnlichen Bedienmethoden kann die KI tatsächlich auf die Erfahrungen zurückgreifen, die sie früher gelernt hat – zum Beispiel hat das Modell in Minecraft und anderen 3D-Spielen gelernt, wie man sich bewegt, dreht und zielt. Wenn es dann mit einem anderen unbekannten 3D-Shooter-Spiel in Kontakt kommt, können diese Erfahrungen immer noch nützlich sein.
Was ist, wenn die Spanne der Spiele größer wird? Wenn die KI bereits 3D-Spiele geschickt bedienen kann, kann sie sich dann schnell an 2D-Spiele anpassen? Dies führt zum letzten Punkt: Das Lernen von mehr Spielen bedeutet nicht, dass die KI sich an alle Spiele anpassen kann.
Zusätzlich zu MCU (Minecraft, enthält 30 Aufgaben) und OmniGameArena umfasst das Testsystem im Experiment auch ViZDoom (Doom, enthält 4 Testszenarien) sowie GameWorld (enthält 34 Spielumgebungen und 170 Aufgaben, darunter viele 2D- und 2.5D-Spiele mit verschiedenen Spielweisen wie Arcade-Jumping, 2048 und Schiebepuzzle).
Wenn der Wechsel von Minecraft zu einem anderen 3D-Shooter-Spiel bedeutet, dass die KI versucht, die gelernten Informationen anzuwenden, dann ist der Wechsel von Minecraft zu 2048 eher vergleichbar damit, sie dazu zu bringen, ein neues Regelsystem neu zu lernen.
Die Ergebnisse zeigen, dass die KI nicht so gut darin ist, mit dieser Veränderung umzugehen, und es sogar schwieriger werden kann, sich anzupassen –
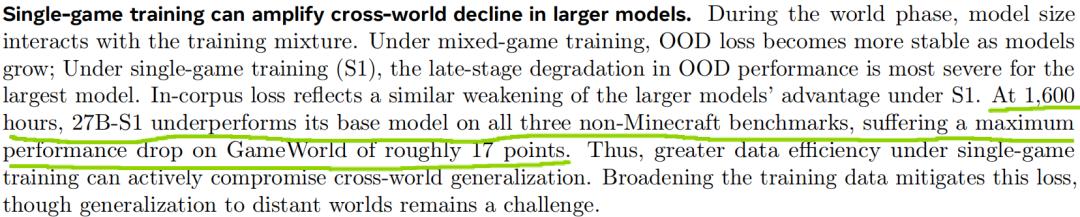
Das Team verwendete 1600 Stunden Spieldaten von Minecraft, um ein Modell mit 27 Milliarden Parametern weiter zu trainieren. Es stellte sich heraus, dass seine Leistung in Minecraft zwar verbessert wurde, aber in den Tests von Doom, anderen unbekannten 3D-Spielen sowie einigen 2D- und 2.5D-Spielen war die Leistung sogar schlechter als die des ursprünglichen Modells, das diese Trainingsrunde nicht durchlaufen hat.
Dies bedeutet, dass das gezielte Training für ein bestimmtes Spiel sogar die Anpassungsfähigkeit der KI an andere Spiele schwächen kann.
Am Ende der Arbeit gibt das Team an, dass das derzeitige GameScaling noch deutliche Einschränkungen aufweist.
Gegenwärtig lernt es hauptsächlich, indem es die vorhandenen Spielbetriebsaufzeichnungen von Menschen nachahmt. Obwohl die trainierte KI bereits Spiele unabhängig bedienen kann, hat sie noch keinen selbstständigen Lernzyklus gebildet, in dem „sie selbst versucht, Fehler macht und dann Lehren aus Fehlern zieht“. Und wenn sie auf unbekannte Spiele trifft, die sich stark von den Trainingsmaterialien unterscheiden, ist ihre Anpassungsfähigkeit immer noch begrenzt.
Auf den ersten Blick scheint dieses Experiment nur verschiedene Modelle eine Menge Spiele spielen zu lassen und schließlich die einfache Wahrheit zu beweisen, dass „sie derzeit nicht in der Lage sind, Regeln so schnell wie Menschen zu verstehen und sich an die Bedienung anzupassen“. Aber auf lange Sicht ist es vielleicht nicht wichtig, ob diese Forschung beweisen kann, dass „KI zu einem geübten Spieler werden kann“ – die Erforschung, wie Modellgröße, Menge der Trainingsdaten und Spielarten die Spielbetriebsfähigkeit der KI beeinflussen, und das Herausfinden, welche Methoden wirksam sind und welche fehlschlagen, ebnet den Weg für zukünftige Forschungen im Voraus und listet die zu lösenden Probleme auf.
Schließlich, wenn man auf die Entwicklung der KI in den letzten Jahren zurückblickt, von dem seltsamen Video, in dem Will Smith Nudeln isst, bis zu dem KI-generierten Video, in dem man nicht mehr unterscheiden kann, ob er Nudeln isst oder nicht – die technische Iteration geschieht nie über Nacht. Manchmal ist das Herausfinden, warum ein Weg nicht funktioniert, oft ein wichtiger Schritt zur nächsten Iteration.
Der Weg des Königs von miHoYo
Im Bereich KI+Spiele ist es schon immer eine beliebte Forschungsrichtung, wie man die KI dazu bringt, Spiele zu lernen.
Im vergangenen November hat das Lumine-Team von ByteDance auf Bilibili ein über 25-stündiges Aufzeichnungsvideo veröffentlicht, das hauptsächlich den Prozess zeigt, in dem KI Genshin Impact, Honkai: Star Rail und Wuthering Waves spielt. In der zugehörigen Arbeit nannten sie sich damals „der einzige KI-Agent, der mehrstündige Aufgaben in einer 3D-Offenen Welt erledigen kann“.
