Was? Eine einzelne Person kann ein großes KI-Modell trainieren, und seine Leistungsindikatoren können direkt mit K3V4 konkurrieren?
Wie viele Menschen braucht man, um ein großes Modell mit 500 Milliarden Parametern zu trainieren?
Die Erfahrung in der AI-Branche zeigt, dass mindestens Dutzende von Personen erforderlich sind, während große Technologieunternehmen oft Hunderte von Mitarbeitern einsetzen.
Doch ein Startup namens Mirendil im Silicon Valley hat diese Zahl auf das Extremste reduziert – nur eine Person.
Gerade hat Mirendil einen Artikel auf seiner offiziellen Website veröffentlicht, dessen Titel sehr aufsehenerregend ist: *Groß angelegtes Vortraining ohne Vortrainings-Team*.
Unter dem Titel des Artikels stehen drei Zahlen aufgelistet:
1 Forscher, dreieinhalb Monate, Kosten von weniger als 10 Millionen US-Dollar.
Diese Kosten decken den Token-Verbrauch des Agenten, die Datenverarbeitung und alle Kosten für Forschungsversuche ab. Mit nur diesen Investitionen haben sie tatsächlich ein Modell mit hunderten Milliarden Parametern trainiert: Mirendil-Base, ein kodierungsspezifisches Basismodell im Bereich von 100 bis 500 Milliarden Parametern.
Mirendil gibt in dem Artikel an, dass über 99 % des Codes des neuen Modells nicht von Menschen, sondern von Agenten geschrieben wurden.
Menschliche Forscher müssen nur die Richtung bestimmen, Urteile fällen und an wichtigen Knotenpunkten die Bremse betätigen. Aufgaben wie das Schreiben von Code, das Durchführen von Experimenten und die Fehlerbehebung werden vollständig an Agenten übergeben.
Bei den Tests von Mirendil haben einige Indikatoren des neuen Modells bereits die gängigen Spitzenmodelle wie Kimi K3, GLM-5.3 und DeepSeek-V4 erreicht.
Die Ära des "selbstgebauten Basismodells durch eine einzelne Person" steht wirklich vor der Tür … oder nicht?
01
Nach offiziellen Angaben ist Mirendil-Base das erste Produkt der Mirendil-Modellreihe, das als kodierungsspezifisches Basismodell positioniert ist und sich an Forscher und Ingenieure in zukunftsweisenden AI-Labors richtet.
Um zu überprüfen, ob eine einzelne Person das Modell tatsächlich entwickeln kann, hat Mirendil viele strenge Bedingungen festgelegt. Zum Beispiel darf keine fertige Vortrainings-Framework verwendet werden, und kein vorhandener Code darf übernommen werden.
Der Forscher und der Agent haben von Grund auf in mehr als 100 Tagen alles aufgebaut – die Trainingsinfrastruktur, die Modellarchitektur, die Trainingsalgorithmen und die Datenpipeline wurden alle selbst geschrieben, wobei nur auf einige beliebte Open-Source-Projekte als Vorlage in den allgemeinen Bibliotheken wie PyTorch und JAX zurückgegriffen wurde.
Natürlich bezieht sich das "selbst" hier normalerweise auf den Agenten.
Der Forscher ist hauptsächlich dafür verantwortlich zu entscheiden, was ausprobiert werden soll, was vertraut wird und bei Bedarf einzugreifen. Konkrete Aktionen wie das Schreiben von Code, das Durchführen von Experimenten und die Diagnose von Fehlern werden fast vollständig vom Agenten selbst erledigt.
Was die Daten betrifft, verwendet Mirendil ausschließlich öffentliche Daten, wie Open-Source-Code von GitHub, öffentliche Webseiten und öffentliche Datensätze. Das Unternehmen betont, dass während des Trainingsprozesses keine einzelne Datenzeile gekauft, keine Destillation durchgeführt und keine synthetischen Daten verwendet wurden.
Darüber hinaus hofft Mirendil, die Effizienz durch verbesserte Designs zu steigern. "Wir haben eine deutliche Effizienzsteigerung durch eine verbesserte Architektur, eine erweiterte Optimierung der Datenmischung, andere Verbesserungen auf Datenebene sowie Kernel-Optimierungen erzielt", heißt es in der Ankündigung.
Das Endergebnis ist Mirendil-Base mit 100 bis 500 Milliarden Parametern.
Auf welchem Niveau befindet sich eigentlich ein Modell mit hunderten Milliarden Parametern, das von einer einzelnen Person entwickelt wurde?
Mirendil hat fünf Modelle zum Vergleich herangezogen, nämlich Kimi K3, GLM-5.3, Nemotron-550B-Base, DeepSeek-V4-Pro-Base und Inkling, die alle große Parameter-Modelle mit MoE-Architektur sind.
Bei dem Kreuzentropie-Test in neuen Code-Repositories (das Modell errät, wie der Code geschrieben wird, wobei ein niedrigerer Wert eine genauere Vermutung bedeutet) sind die Ergebnisse der Wettbewerbe zwischen den Modellen wie folgt:
Kimi K3 belegt den ersten Platz mit einem Wert von 0,193; Mirendil-Base belegt den zweiten Platz mit einem Wert von 0,222; gefolgt von GLM-5.3, DeepSeek-V4 und Nemotron.
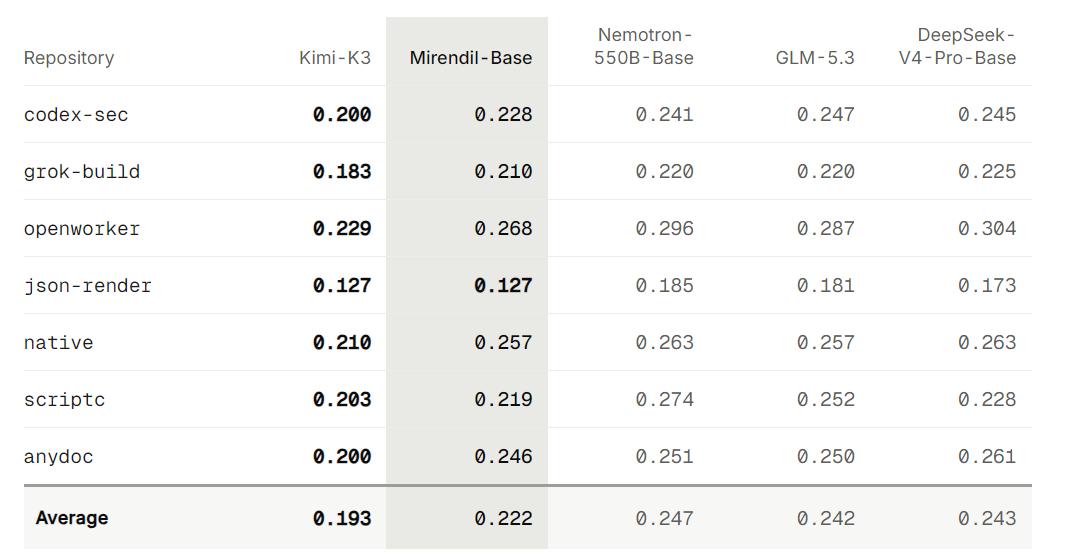
Mit anderen Worten: In einigen Kodierungsdimensionen kann das vortrainierte Modell, das von einer Person in Zusammenarbeit mit einem Agenten trainiert wurde, bereits mit den fertigen Modellen großer Spitzenunternehmen mithalten.
Es muss jedoch darauf hingewiesen werden, dass Basismodelle normalerweise im Kreuzentropie-Test besser abschneiden als nachtrainierte Modelle. Da Mirendil-Base als Basismodell einen höheren Wert erzielt als das nachtrainierte Kimi-K3, zeigt dies, dass die tatsächliche Stärke von Kimi-K3 weitaus größer ist als der angezeigte Oberflächenwert, und der Abstand zwischen Mirendil-Base und ihm ist größer als es aussieht.
Nach offiziellen Angaben gibt es zwei weitere Varianten über Mirendil-Base: Large liegt im Bereich von 500 Milliarden bis 2 Billionen Parametern, und XL erreicht direkt 2 Billionen bis 10 Billionen Parameter.
Derzeit ist Large zu 80 % trainiert, XL hat gerade erst begonnen und ist erst zu 19 % fertig, hat aber bereits fast die aktuellen Werte von Large erreicht.
Das heißt, mit der Unterstützung von Finanzkraft und Agenten ist das Training eines Modells mit Billionen von Parametern durch eine einzelne Person kein Traum – eine Hürde, die viele große AI-Unternehmen noch nicht erreicht haben.
02
Das Vortraining von großen Modellen mit hunderten oder sogar Billionen von Parametern ist extrem kostspielig, zeitaufwändig und erfordert den Einsatz einer großen Anzahl von Mitarbeitern.
Unter Hunderten von Forschern beschäftigen sich einige damit, wie das Modell aufgebaut sein soll und wie Skalierung umgesetzt wird; andere kümmern sich um die Bereinigung und das Verhältnis von Billionen von Token; wieder andere überwachen Tausende oder sogar Hunderttausende von Rechenkarten, um sicherzustellen, dass das Training nicht unterbrochen wird.
Große AI-Unternehmen können genügend Talente zusammenbringen, aber der Druck durch die Kosten für Kapital und Rechenleistung bleibt weiterhin groß.
Die gesamte Branche versucht ständig, die Kosten zu senken, wobei der Kerngedanke lautet: AI soll AI trainieren.
Anthropic ist beispielsweise bereits weit auf diesem Weg fortgeschritten.
Das Unternehmen hat zuvor offengelegt, dass im Mai dieses Jahres über 80 % des zusammengeführten Codes in seinen Code-Repositories von Claude geschrieben wurden.
Auch Google unternimmt ähnliche Schritte: Der AI-Programmieragent AlphaEvolve wird bereits zur Optimierung der Rechenzentrumsplanung, des Chipdesigns und der AI-Trainingsabläufe eingesetzt.
Auf dem Weg von "AI trainiert AI" können derzeit aber nur große Unternehmen erfolgreich sein.
Für Wissenschaftler, Forscher und kleine Teams war es früher fast unmöglich, ein eigenes Modell zu trainieren.
Mirendil-Base beweist jedoch, dass unter bestimmten Bedingungen eine einzelne Person ein Modell "selbst bauen" kann.
Mirendil gibt in dem Artikel auf seiner offiziellen Website an, dass bis vor kurzem der Engpass für das Vortraining eines wettbewerbsfähigen Modells die Menschen waren: ein Expertenteam, dessen Aufbau Jahre dauert.
Heute ändert sich diese Situation.
Was früher nur großen Forschungseinrichtungen möglich war, kann heute ein einzelner Forscher erledigen. Wenn der Agent den Großteil der praktischen Arbeiten übernimmt, verlagert sich der Engpass auf die Rechenleistung, die Daten und das Urteilsvermögen der Person, die den Agenten steuert.
Die Vision, dass "jeder ein Modell trainieren kann", birgt ein enormes Potenzial.
Früher mieteten die meisten Menschen und Unternehmen, wenn sie ein eigenes spezialisiertes Modell benötigten, oft ein allgemeines Modell und passten es am Rand an.
Heute kann ein Chipdesign-Team, ein Robotiklabor oder ein Krankenhaus mit seinen eigenen Daten ein Modell für seine eigenen Probleme trainieren. Basismodelle und die Systeme, die um sie herum aufgebaut sind, werden nicht mehr nur etwas sein, das wenige große Unternehmen herstellen können, sondern werden weit verbreitet sein.
Auf der anderen Seite können AI-Projekte, für die früher ein großes Team erforderlich war, jetzt mit einem kleinen Team oder sogar einer einzelnen Person beginnen; und da die Rechenleistung immer günstiger und leistungsfähiger wird, können mehr Menschen diese Projekte ausprobieren. "Ein-Personen-Unternehmen" oder "Super-Individuen" werden voraussichtlich Realität werden.
Die Arbeitsweise der Menschen wird sich ebenfalls verändern: Da immer mehr Aufgaben an Agenten übergeben werden, wird die tägliche Arbeit der Menschen immer weniger wie "etwas selbst tun" und immer mehr wie "ein kleines Labor leiten": die Forschungsrichtung festlegen, Experimente entwerfen, die es wert sind, durchgeführt zu werden, und beurteilen, welche Ideen es wert sind, weiterverfolgt zu werden.
Mirendil zeichnet eine noch brillantere Zukunft: Das nächste Modell wird teilweise von Mirendils eigenem Modell aufgebaut, und jedes Modell, das beim Aufbau von AI stärker wird, macht den Aufbau des nächsten Modells günstiger und schneller.
"Wir glauben, dass wir noch nicht vollständig autonomes RSI erreicht haben, aber wir sind näher dran als je zuvor", sagt das Unternehmen.
Darüber hinaus hat das Unternehmen bereits mit dem Nachtraining von Mirendil-Base begonnen. Mirendil-Base-Large und das zukunftsweisende Mirendil-Base-XL werden noch trainiert.
03
Hinter Mirendil stehen zwei ehemalige Mitarbeiter von Anthropic: Behnam Neyshabur und Harsh Mehta.
Neyshabur wurde in den 80er Jahren im Iran geboren und studierte dort. 2011 ging er in die USA und promovierte an der Toyota Technological Institute at Chicago. Nach seinem Abschluss arbeitete er 5 Jahre bei Google DeepMind, wechselte Ende 2024 zu Anthropic und leitete das Discovery-Team, das sich speziell damit befasst, wie AI wie Wissenschaftler an der Forschung und Entwicklung teilnehmen kann.
Mehta ist indischer Abstammung, absolvierte sein Studium am Indian Institute of Technology Guwahati und war Kollege von Neyshabur bei DeepMind. Nach seinem Wechsel zu Anthropic baute Mehta die erste Version der internen automatisierten AI-Forschungsplattform von Anthropic auf.
Im Dezember 2025 verließen die beiden nacheinander ihre Arbeitsplätze und gründeten Mirendil. Das Unternehmen positioniert sich so, dass AI Wissenschaftlern dabei hilft, ihre eigene AI zu schaffen, anstatt nur AI direkt zur Unterstützung der Wissenschaft einzusetzen.
Mit anderen Worten: Sie hoffen, dass Forschungsteams ihre eigenen spezialisierten AI-Modelle trainieren und iterieren können, ohne auf die allgemeinen Modelle großer Unternehmen angewiesen zu sein. Die zugrunde liegende technische Route ist das RSI, das kürzlich in der AI-Branche sehr diskutiert wurde.
Diesen Juni hat Mirendil eine Seed-Finanzierung in Höhe von 200 Millionen US-Dollar bekannt gegeben, mit einer Bewertung von 1 Milliarde US-Dollar nach der Investition. Zu den Investoren gehören a16z, Kleiner Perkins, Nvidia und andere.
Das Team besteht derzeit aus etwa 20 Personen, alle Forscher und Ingenieure, die aus Anthropic, xAI, Google DeepMind und OpenAI stammen, und arbeitet in der Innenstadt von San Francisco.
Die Vorstellung von Mirendil-Base markiert, dass das Unternehmen den ersten Meilenstein überschritten hat.
Aber trotzdem: Das "Training eines Modells mit hunderten Milliarden Parametern durch eine einzelne Person" klingt vielversprechend, aber die Hürden wurden nicht wesentlich gesenkt.
Die Kosten von 10 Millionen US-Dollar sind für große Unternehmen nichts, und Mirendil, das gerade eine Finanzierung erhalten hat, kann sie noch tragen. Aber für die überwiegende Mehrheit der Einzelpersonen und kleinen Teams ist dies immer noch eine astronomische Zahl.
Ganz zu schweigen davon, dass nicht jeder beliebige Ingenieur in der Lage ist, einen Agenten so zu steuern, dass er so große Aufgaben erledigt. Die hohe Qualität der Talente und die reiche Erfahrung bei AI-Projekten von Mirendil gehören im gesamten Silicon Valley zur ersten Liga.
Die Ära des "selbstgebauten großen Modells durch eine einzelne Person" nähert sich zwar, ist aber für normale Menschen noch weit entfernt.
Die Veröffentlichung von Mirendil-Base ist der erste Wegweiser auf diesem langen Weg. Ob es die Hürden für große Modelle tatsächlich senken kann, hängt vom tatsächlichen Niveau zukünftiger größerer Modelle ab und davon, ob diese Methodik auf andere Personen übertragen werden kann.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto "Letter AI", Autor: Yan Fei, Redakteur: Wang Jing, veröffentlicht mit Genehmigung von 36Kr.