Jensen Huang liefert Rechencluster innerhalb von 14 Tagen. In Kombination mit der Open-Source-Engine von DeepSeek können Sie sofort 38 US-Dollar pro Grafikkarte und Stunde verdienen.
Na gut, jetzt ist es ernst: Jensen Huang hat den Zug von Liang Wenfeng aufgegriffen.
Gestern hat DeepSeek sein Open-Source-Inferenz-Framework veröffentlicht und zeigt, wie man mit einem Rechencluster einen Umsatz von 38 US-Dollar pro Grafikkarte und Stunde erzielen kann.
Heute macht Nvidia Rechencluster direkt zu Fertigprodukten, vom Baubeginn des Rechenzentrums von Grund auf bis zur Produktion von Tokens vergehen nur 14 Tage.
Nach dieser Rechnung ergibt sich für einen Cluster mit 10.000 Grafikkarten: Nach der Inbetriebnahme in 14 Tagen kann der Umsatz unter Idealbedingungen mit voller Auslastung und vollständig ausgebuchten Kunden bis zu 380.000 US-Dollar pro Stunde betragen (natürlich unter der Voraussetzung, dass man so viele stabile Aufträge bekommt).
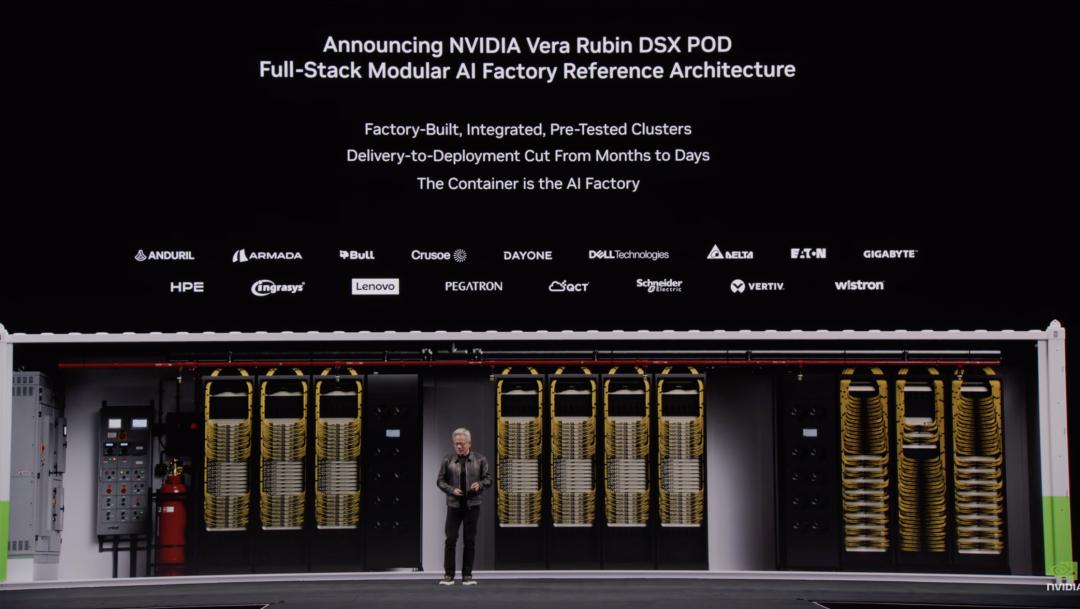
Diesmal begnügt sich Nvidia nicht damit, nur Chips und Schränke zu verkaufen, sondern packt die gesamte „Vera Rubin AI-Fabrik“ direkt in modulare Container.
Früher erforderte der Bau eines Supercomputing-Zentrums langwierige zivile Bauarbeiten, Vor-Ort-Verkabelung und Inbetriebnahme.
Jensen Huang hat vor Ort eine harte Aussage getroffen, die die Ökonomie von Rechenzentren grundlegend verändert:
Eine KI-Fabrik schafft erst dann Wert, wenn sie mit der Produktion von Tokens beginnt – nicht wenn die Bauarbeiten abgeschlossen sind.
Ohne es groß zu bemerken, hat Huang alle dazu gebracht, den Schritt „je mehr man kauft, desto mehr spart man“ zu überspringen und direkt zu „je mehr man kauft, desto mehr verdient man“ zu gelangen.
Das erweckt den Eindruck eines goldenen Zeitalters für die KI-Infrastruktur
Die KI-Fabrik in Container packen – volle Rechenleistung in 14 Tagen liefern
Wie lässt man Kunden am schnellsten mit KI Geld verdienen? Die Antwort lautet: die „Zeit bis zum ersten Token“ (Time to First Token) verkürzen.
Die neu vorgestellte Hardware-Produktlinie DSX POD dreht sich vollständig um dieses Kernprinzip.
Der Aufbau traditioneller KI-Rechenzentren erfordert vor Ort extrem aufwändige Installation von Rechenknoten, Netzwerkverkabelung, rackebene Stromversorgung und Verlegung von Flüssigkühlleitungen. Bei Verzögerungen von Bauteilen oder Fehlern bei der Vor-Ort-Bauarbeit vergehen schnell mehr als ein halbes Jahr.
Jetzt macht Nvidia die gesamte Infrastruktur einschließlich des neuesten Vera Rubin-Systems zu einem in Serie produzierbaren „Container“-Design.
Rechenleistung, Netzwerk, Verkabelung, Stromversorgung und Flüssigkühlsystem werden vollständig in den Fertigungsstätten der Partner integriert, mit Verbindungen zwischen den Racks, Rohranschlüssen und Funktionsprüfungen abgeschlossen.
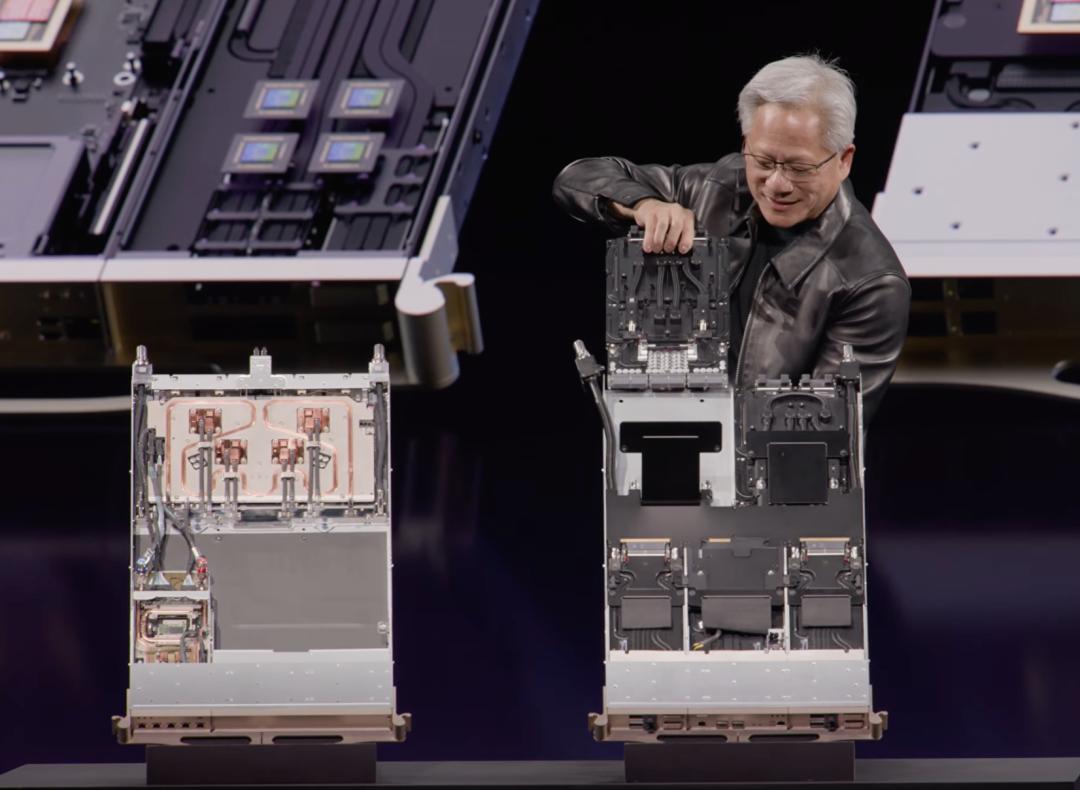
Erster Schritt, Das neueste NVIDIA Vera Rubin-Rechensystem wird mit Hochgeschwindigkeitsnetzwerk, rackebener Stromversorgung und Flüssigkühlsystem gebündelt.
Beim früheren Grace-Blackwell-Konzept dauerte die Montage eines einzelnen Knotens 2 Stunden, die Verkabelung war kompliziert und die Flüssigkühlabdeckung betrug nur 80%.
Mit Vera Rubin hingegen kommt man ohne Kabel aus, erreicht 100% vollständige Flüssigkühlung, die Montage eines einzelnen Knotens dauert nur noch 5 Minuten – gleichzeitig werden Zuverlässigkeit und Leistung verbessert.
Zweiter Schritt, Vor der Auslieferung werden alle Komponenten vollständig in speziell angefertigte modulare Container integriert.
Sogar die Verkabelung zwischen den Racks, Stromanschlüsse, Verlegung von Flüssigkühlleitungen und sogar die Funktionsprüfung des gesamten Systems …
alles wird in der Fertigungsstätte vorab erledigt!
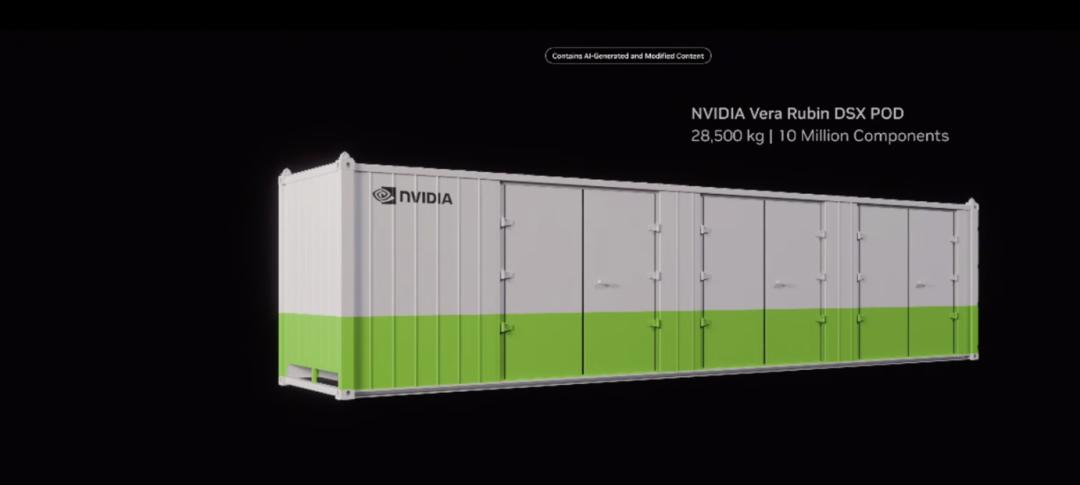
Gleichzeitig können die Vorbereitungen des Standorts beim Kunden vollständig parallel ablaufen, sodass sich beide Seiten nicht gegenseitig behindern.
Wenn der Container mit der fertig geprüften „voll leistungsfähigen Vera Rubin-Rechenfabrik“ am vorbereiteten Standort ankommt, muss man nur die vor Ort vorgesehene Stromversorgung, Kühlung und Netzwerkinfrastruktur anschließen, und schon ist das System sofort betriebsbereit.
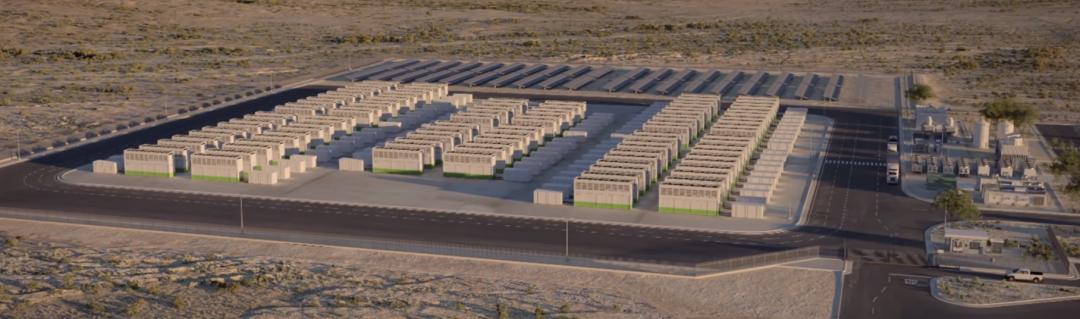
Die daraus resultierende Verbesserung ist überwältigend —
Die Vor-Ort-Einsatzzeit wird von traditionell 6 Monaten auf minimal 14 Tage verkürzt.
Nvidia verwendet die Kennzahl „Time to First Token“ als Maßstab für diese Effizienz bei der Auslieferung.
Wenn man einen Tag früher mit dem Training großer Modelle und der produktiven Inferenz beginnen kann, können Betreiber einen Tag früher Rechenleistung an Kunden liefern und einen Tag früher mit der Generierung von Tokens Einnahmen erzielen.
Ausnutzung jedes Megawatt Stroms – Inferenzdurchsatz steigt um 49%
Nicht nur die Lieferzeit wurde auf 2 Wochen komprimiert, sondern Huang hat auch passende Lösungen bereitgestellt, um Probleme mit Wasser- und Stromknappheit zu mildern.
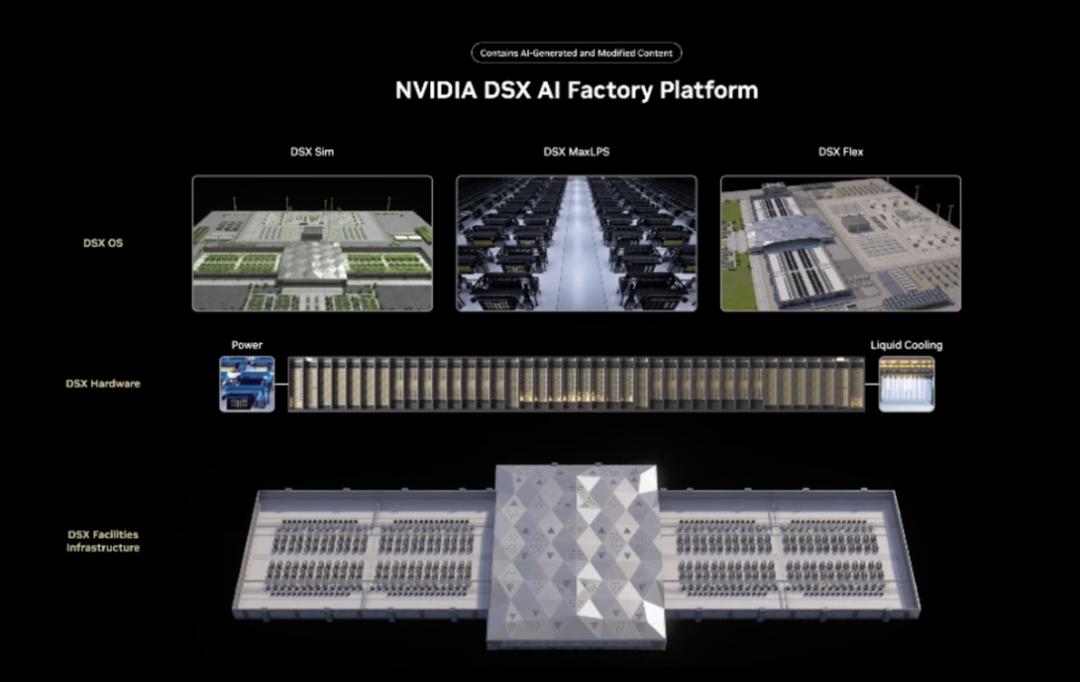
Hinter der genannten DSX POD-Produktlinie steht die vollständige KI-Fabrik-Referenzarchitektur von Nvidia, die NVIDIA DSX-Plattform.
Sie gestaltet Rechenleistung, Netzwerk, Speicher, Software, Stromversorgung und Kühlung als „einheitliches System“ gemeinsam.
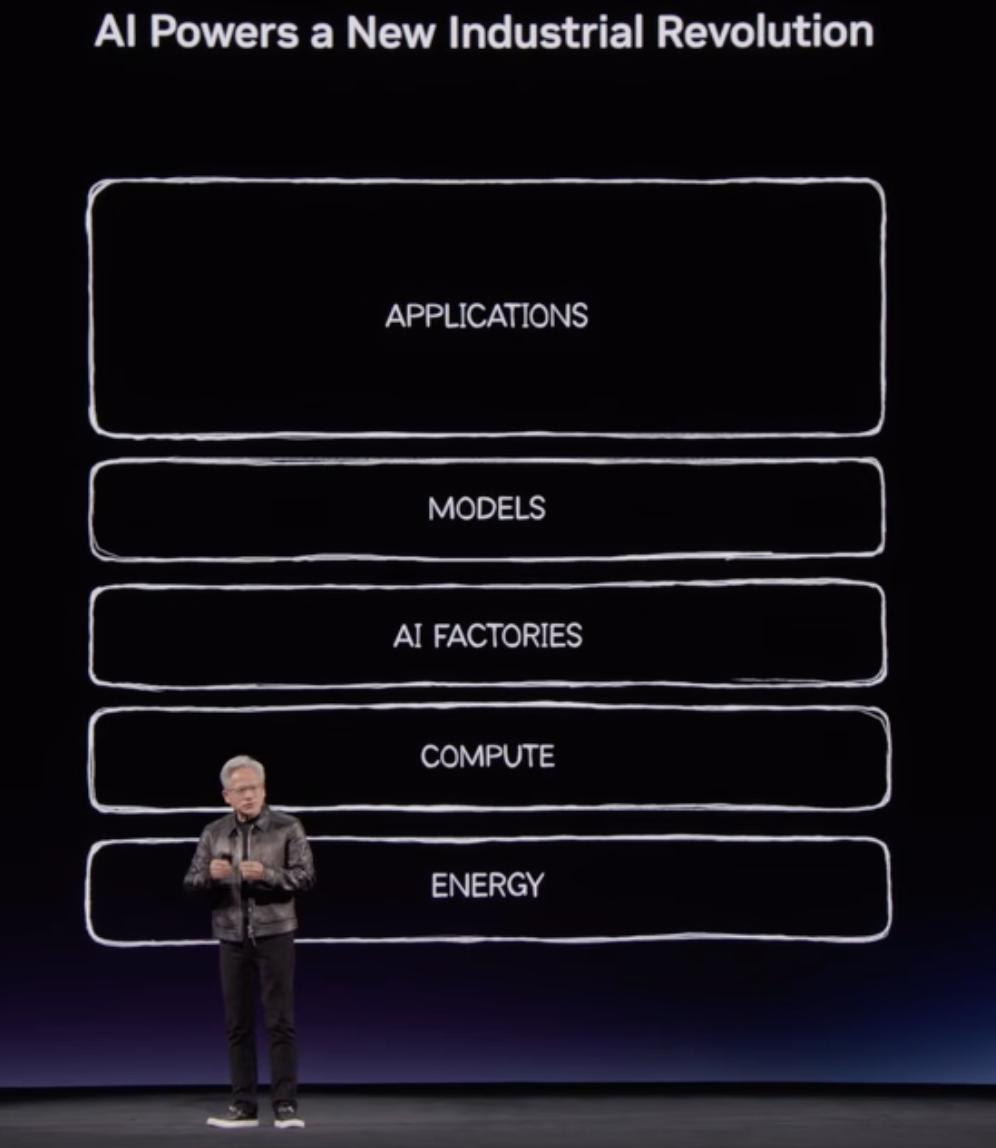
Zuerst die maximale Ausnutzung von Strom und Rechenleistung.
Beim Bau von Rechenzentren bestimmt die verfügbare Strommenge, wie viele Grafikkarten man einsetzen kann.
Um den Stromengpass zu durchbrechen, hat Nvidia zwei leistungsstarke Software-Waffen vorgestellt: DSX MaxLPS und DSX Flex.
Zuerst zu dem ersten Produkt.
DSX MaxLPS ist für die dynamische Leistungsverteilung innerhalb des festgelegten Strombudgets der KI-Fabrik zuständig, bei gleicher Anzahl erzeugter Tokens kann der Stromverbrauch um bis zu 30% eingespart werden.
Umgekehrt: Wenn das Strombudget unverändert bleibt, kann der eingesparte Strom direkt in zusätzliche Rechenleistung umgewandelt werden.
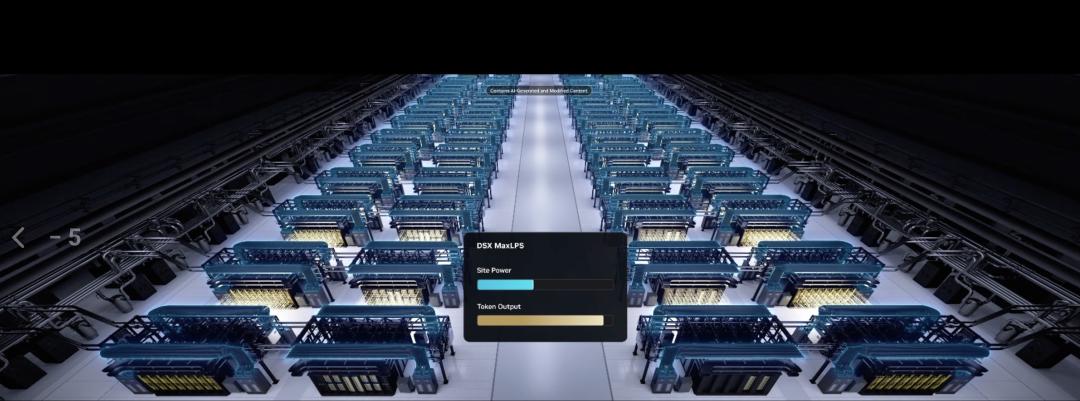
Die gemessenen Werte sind überwältigend:
In der Machbarkeitsstudie des Cloud-Anbieters Lambda auf Basis des NVIDIA HGX B200-Systems stieg der Token-Durchsatz des Clusters bei festem Leistungsbudget direkt um 24%, die aufnehmbare GPU-Rechenkapazität nahm um 19% zu.
Bei den Praxistests im isländischen KI-Werk des europäischen Cloud-Anbieters Nscale stieg der Inferenzdurchsatz bei 4 NVIDIA GB300 NVL72-Schränken und gleicher Stromversorgung von 264 kW sogar um 49%, die verwaltete GPU-Rechenkapazität wuchs direkt um 37%.
Bei gleich hohen Stromkosten lässt sich so fast die Hälfte mehr an Inferenz-Rechenleistung erzielen.
Die zweite der beiden leistungsstarken Software-Komponenten – DSX Flex – geht noch einen Schritt weiter: Sie verwandelt die stromhungrige KI-Fabrik in einen „flexiven Regler“ für das Stromnetz.
Sie kann den Leistungsverbrauch der Rechenleistung in Echtzeit an die Belastung des Stromnetzes, Schwankungen des Strompreises und sogar die vor Ort vorhandene Photovoltaik- und Speicherkapazität anpassen, sodass die KI-Fabrik schneller die Genehmigung für den Netzanschluss erhält.
In gemeinsamen Tests des britischen National Grid, Nebius, Emerald AI und Nvidia konnte der Blackwell-Ultra-GPU-Cluster bei simulierten Stromnetz-Störungen den Leistungsverbrauch des Clusters sofort um 40% senken, ohne kritische Geschäftsabläufe zu unterbrechen.
Als Nächstes die Innovation bei der Kühlung.
Traditionelle Rechenzentren kühlen durch Verdunstung von Wasser in Kühltürmen, was einen enormen Wasserverbrauch bedeutet.
Die Vera-Rubin-Infrastruktur hingegen unterstützt 100% vollständige Flüssigkühlung mit einer Kühlmitteltemperatur von bis zu 45 °C.
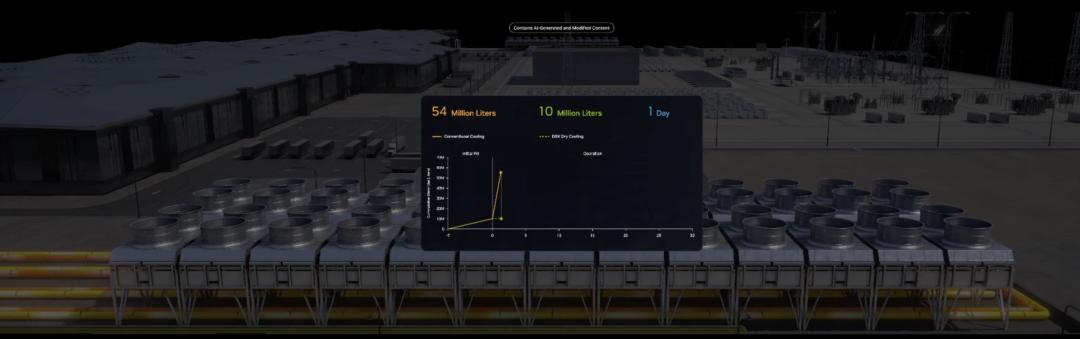
Das DSX-Referenzdesign kombiniert die geschlossene Flüssigkühlung direkt mit Außenluftkühlern (ähnlich riesigen Automobilkühlkörpern): Das Kühlmittel zirkuliert in einem geschlossenen Rohrleitungssystem und nimmt Wärme auf, die dann von dem Außenluftkühler direkt an die Luft abgegeben wird. Dabei verdunstet kein Wasser, sodass der Wasserverbrauch der Anlage auf nahezu Null sinkt (eine Reduktion um 100%).
In einer KI-Fabrik mit einer Leistung von 2 Gigawatt (2 GW) kann DSX im Vergleich zu traditionellen Kühltürmen täglich 54 Millionen Liter Wasser einsparen.
Das entspricht dem Wasserverbrauch von 180.000 Haushalten an einem ganzen Tag.
Auf Hugging Face „Gebäude in der Cloud bauen“ – automatisch verwaltetes Open-Source-Betriebssystem
Um die Effizienz des Fabrikbaus auf das Maximum zu steigern, hat Nvidia sogar einen „Bausimulator“ in die Open-Source-Community gebracht.
Die neu eingeführte digitale Modellbibliothek für physische Geräte NVIDIA SimReady Central ist ab sofort offiziell auf Hugging Face verfügbar.
Darin sind 3D-digitale Assets von geprüften Stromversorgungs- und Kühlgeräten von Partnern wie Vertiv direkt enthalten.
In Kombination mit dem Simulationswerkzeug DSX Sim können Ingenieure den digitalen Zwilling einer KI-Fabrik aufbauen, ohne vor Ort physische Bauarbeiten durchführen zu müssen.
Daran erkennt man auch, warum Nvidia Hugging Face übernommen hat.
Stromversorgung, Kühlverhalten und sogar akustische Geräusche, die Siemens derzeit testet, können alle vorab simuliert und geprüft werden.
Nach der Inbetriebnahme der Hardware übernimmt die Software nahtlos die Steuerung.
Nvidia hat die Erweiterung des quelloffenen DSX-OS-Infrastruktur-Management-Software-Pakets angekündigt und gleich drei Komponenten in der Entwicklervorschau veröffentlicht:
- NVIDIA Config Manager
Erledigt die komplexe Netzwerkkonfiguration von KI-Fabriken vollständig automatisch
- NVIDIA Rack Management Service
Bietet einheitliches Management von rackebener Stromversorgung, Bestandsaufnahme, Firmware und Switches
- NVIDIA Cluster Readiness Engine
Bevor offizielle Produktionsaufgaben eintreffen, führt es automatisch verteilte Lasttests durch, um den GPU-Cluster zu prüfen, Fehler frühzeitig zu erkennen und präzise auf einzelne Knoten zu isolieren
In Kombination mit dem untergeordneten Controller und der Laufzeitumgebung verwandelt Nvidia den Bau von Supercomputern von der virtuellen Planung über die Auslieferung der Container bis zum automatischen Lasttest und der Inbetriebnahme vollständig in eine vollautomatische Fertigungsstraße.
Das stärkste „Infrastruktur-Freundesnetz“ der Welt vorstellen
Wenn man „Container-K