Das interne "KI-Suchrezept" von Tencent wurde veröffentlicht.
Geben Sie ein im Zeitalter der KI sehr häufiges Problem in das Suchfeld ein – überprüfen Sie die jüngsten Aktienkurse, Produkte und Personaländerungen von Tencent. Das sind die nicht KI-gestützten Suchergebnisse von Google:
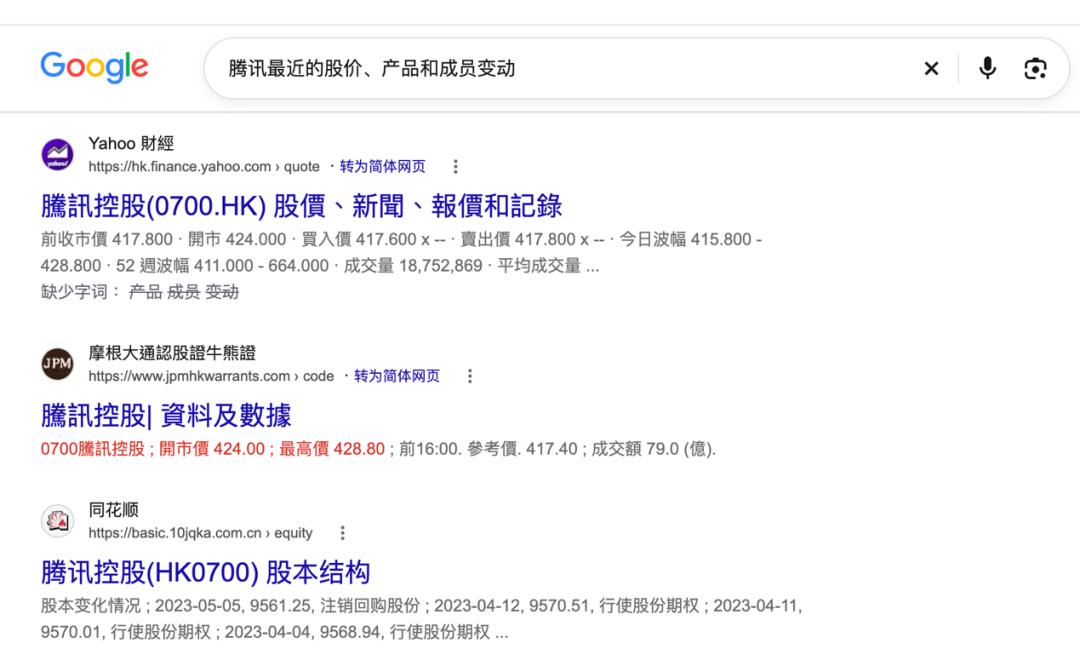
▲ Suchergebnisse von Google
In der traditionellen Google-Suche erhalten Nutzer eine Reihe von Webseitenlinks; bei der Yuanbao-Suche liefert dasselbe Problem völlig unterschiedliche Ergebnisse.
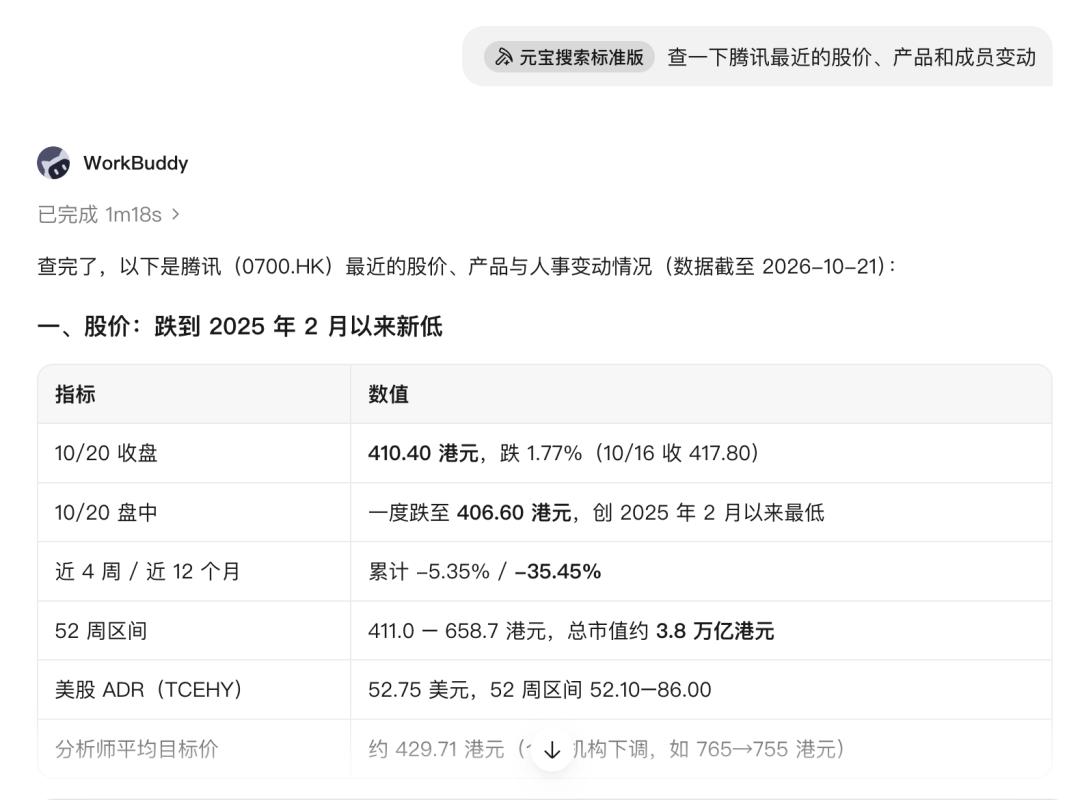
▲ WorkBuddy mit integrierter Yuanbao-Suche
Der Unterschied zwischen den beiden Suchergebnissen spiegelt genau die Veränderungen wider, die die Suchtechnologie derzeit durchläuft.
In der Vergangenheit gaben Suchmaschinen Webseitenlinks zurück, und Nutzer mussten Informationen selbst filtern, vergleichen und organisieren. Im Zeitalter der KI beginnt die Suche jedoch direkt, Daten aus verschiedenen Quellen zu integrieren und Antworten zu generieren.
Die höheren Anforderungen an die Suche im KI-Zeitalter entsprechen genau zwei großen Schmerzpunkten bei der Implementierung großer Modelle – Halluzinationen und Wissensverzögerungen, d. h. selbst das leistungsstärkste Modell kann Halluzinationen erzeugen oder veraltete Informationen liefern, da das Wissen nicht rechtzeitig aktualisiert wird.
Wenn Agenten, die Tools aufrufen und Aufgaben ausführen können, in den Fokus rücken, können Fehler oder veraltete Informationen in der Suche durch nachfolgende Tool-Aufrufe weitergegeben werden, was die Beurteilung und Ausführung der gesamten Aufgabe beeinträchtigt.
Daher muss die Suche nicht nur umfassend und aktuell sein, sondern auch so genau wie möglich, und die Informationen zu Ergebnissen organisieren, die Agenten direkt verwenden können.
Für dieses grundlegende Problem ist RAG (Retrieval Augmented Generation) einer der wichtigen technischen Wege, um Wissensverzögerungen zu mildern und die Zuverlässigkeit der Antworten zu verbessern.
Wenn Entwickler und Unternehmen jedoch selbst RAG aufbauen möchten, müssen sie mehrere Gliederungen wie die Erfassung von Informationsquellen, Datenbereinigung und Indexerstellung aufbauen und langfristig warten, was hohe Kosten bedeutet. Der Wert fertiger Such-APIs liegt genau darin, die Hürden für die Integration und den Betrieb zu senken.
Am 20. Oktober hat Tencent die Yuanbao-Suche aktualisiert und bietet über Tencent Cloud API-Dienste für einzelne Entwickler und Unternehmen an.
Im vergangenen Jahr wurde die Yuanbao-Suche ständig optimiert, indem öffentliche Ressourcen im gesamten Netzwerk und hochwertige Inhalte von Tencent integriert wurden, um einen Index im Billionenbereich aufzubauen, und sie wurde durch interne Anwendungen von Tencent wie WorkBuddy und ima getestet.
Die Bedeutung dieses Upgrades liegt nicht nur in der Veröffentlichung einer Suchfunktion, sondern darin, dass Tencent die durch interne Geschäftsprozesse verfeinerte und großtechnisch validierte Suchinfrastruktur für die gesamte Branche öffnet und zu einem universellen Dienst macht, den externe Entwickler direkt aufrufen können.
Dadurch können die Ingenieurserfahrungen und technischen Fähigkeiten, die Tencent in seinen eigenen KI-Anwendungen gesammelt hat, zu einer Infrastruktur für die KI-Branche weiterentwickelt werden.
01.
Praktischer Test von WorkBuddy und ima
Ist die Suchfunktion, die beide verwenden, wirklich gut?
Für Entwickler gibt es zwei Möglichkeiten, Agenten mit Suchfunktionen auszustatten: Wenn sie die Suchabfrage selbst aufbauen, können sie die Suchlogik flexibler steuern, müssen aber kontinuierlich in Forschung und Entwicklung, Wartung von Informationsquellen und Betrieb investieren. Die Integration eines fertigen Suchdienstes reduziert diesen Ingenieuraufwand, wobei Suchqualität und Dienststabilität stärker vom Dienstanbieter abhängen.
Nach diesem Upgrade bietet die Yuanbao-Suche drei Integrationsmethoden: Skill, MCP und API, und führt zeitlich begrenzte kostenlose Kontingente ein: 2000 Aufrufe pro Monat. Im Oktober und November können Nutzer mit Einladungscodes bis zu 6000 Aufrufe pro Monat genießen. Entwickler können zuerst die Integration testen und dann entscheiden, ob sie sie für tatsächliche Geschäftsvorgänge verwenden möchten.
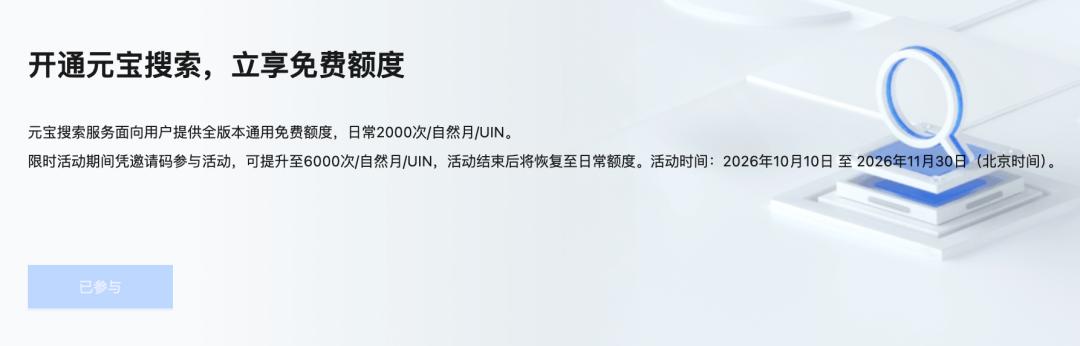
▲ Kostenloses Kontingent der Yuanbao-Suche
Zhidianye hat die Yuanbao-Suche über die API praktisch getestet. Der Integrationsprozess ist nicht kompliziert: Zuerst erhalten Sie den API-Schlüssel in der Tencent Cloud, dann öffnen Sie das Terminal und geben Sie einen curl-Befehl ein, um eine Suchanfrage zu stellen:
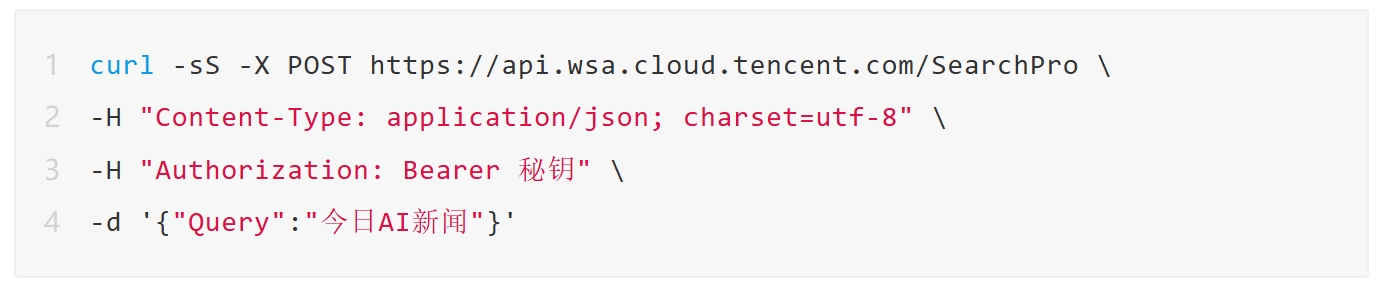
Ersetzen Sie den "geheimen Schlüssel" im Code durch den tatsächlich erhaltenen API-Schlüssel. Nach der Ausführung können Sie eine Abfrage an die Yuanbao-Suche senden und das zurückgegebene Ergebnis im Terminal anzeigen.
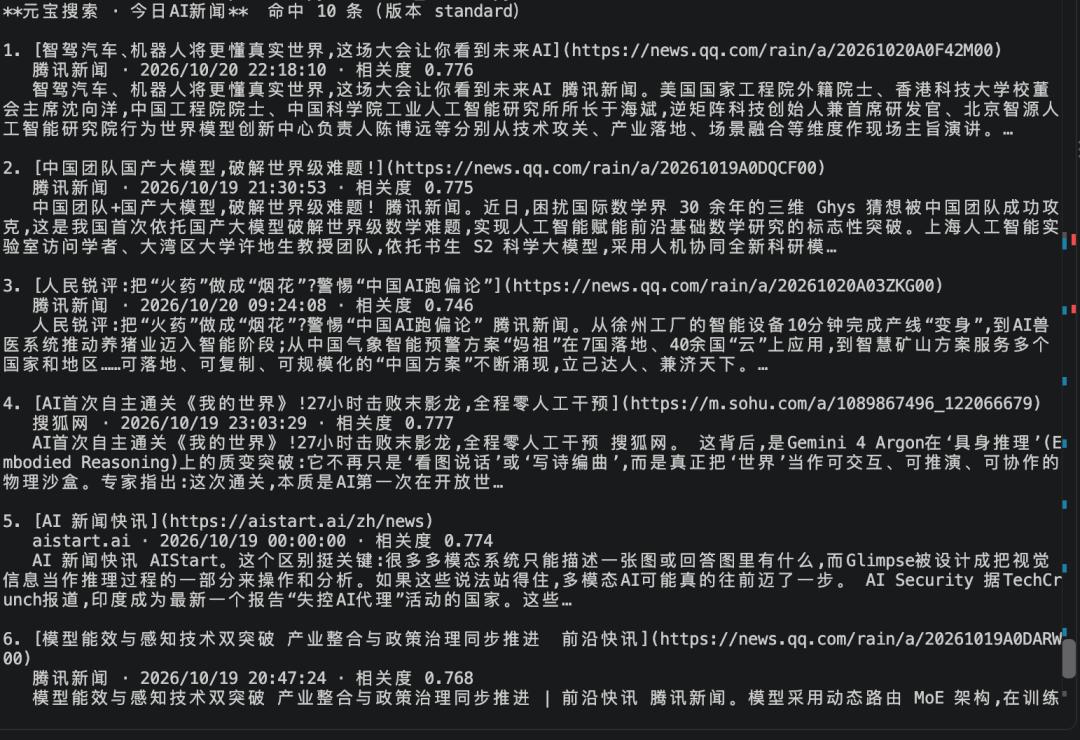
▲ Das ursprüngliche Ergebnis, das vom Terminal zurückgegeben wird
Nach Abschluss des API-Aufrufs haben wir die Schnittstelle als Skill in DeepSeek Harness integriert, sodass Agenten die Suche je nach Aufgabenanforderungen selbstständig aufrufen können. Auf diese Weise wird die Suchfunktion von einer manuellen Anfrage zu einem Teil, der im Workflow des Agenten jederzeit aufgerufen werden kann.
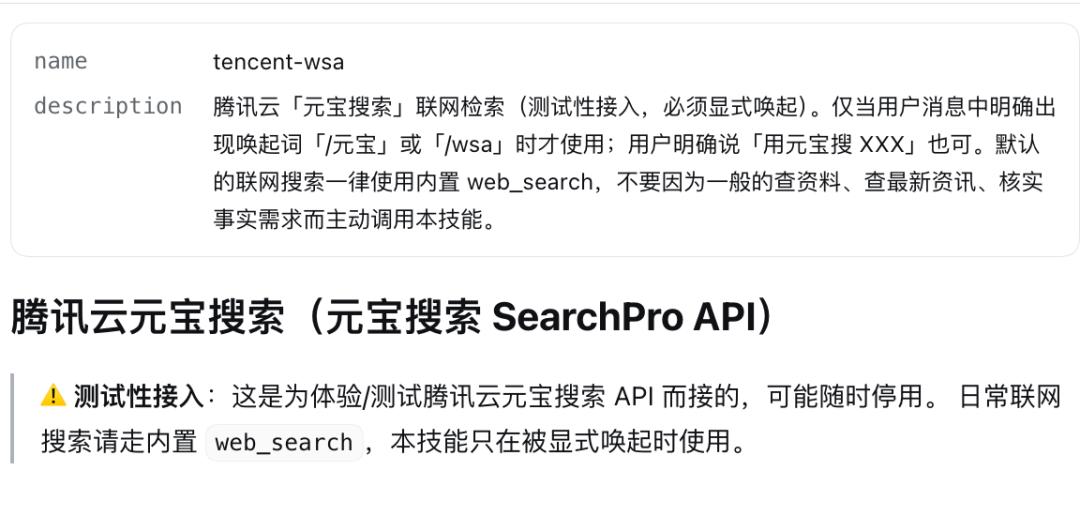
▲ Die Skill-Datei für die Integration der Yuanbao-Suche in DeepSeek Harness
Nach Abschluss der Integration haben wir die grundlegende Nachrichtensuche getestet. Zum Beispiel geben wir einen Prompt ein, um mit der Yuanbao-Suche die heutigen sozialen Nachrichten abzufragen. Man kann sehen, dass Yuanbao das Ergebnis in nur 17 Sekunden zurückgibt.
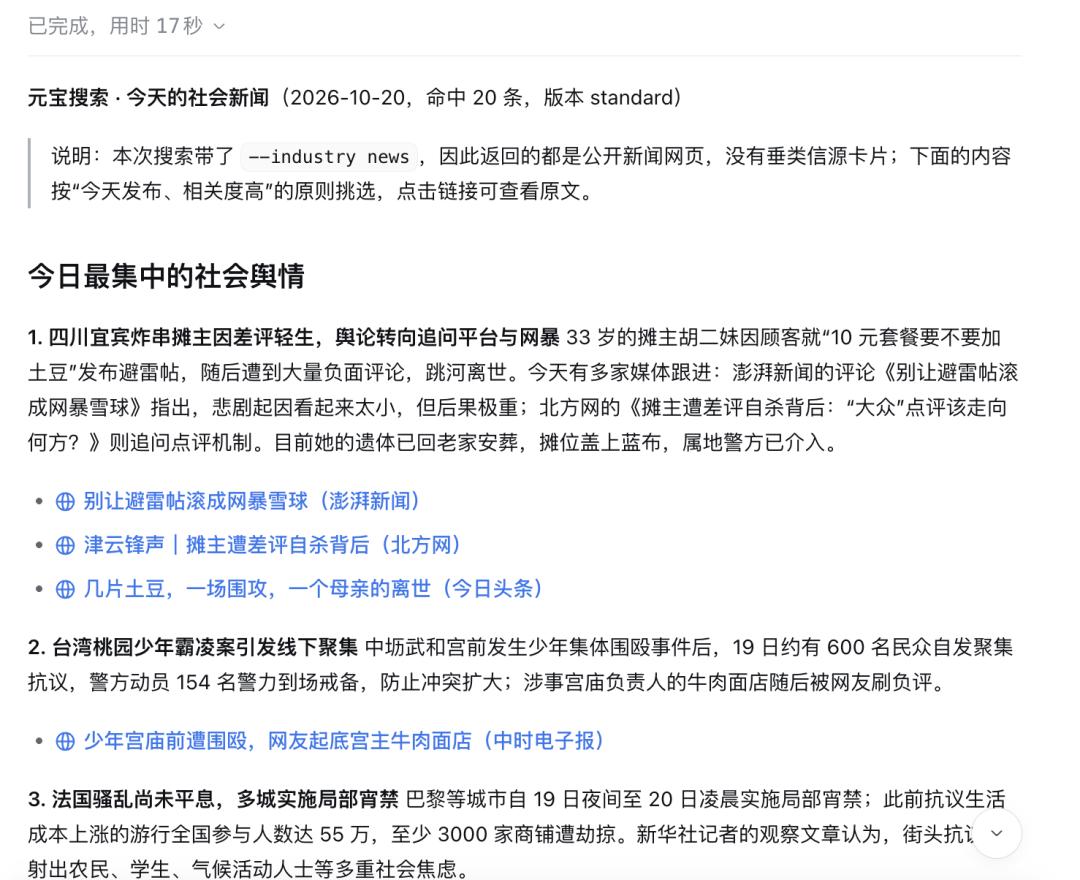
Die Ergebnisse der normalen Websuche konzentrieren sich auf Titel, Zusammenfassungen und Links. Anschließend kann der Agent in Kombination mit Web-Crawling-Tools die relevanten Inhalte lesen, um die Informationsorganisation weiter abzuschließen.
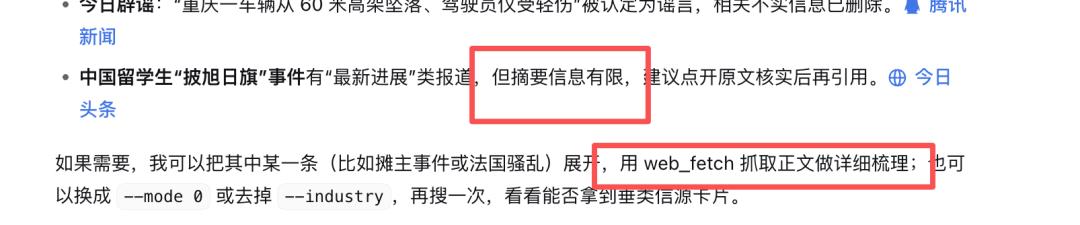
Die Yuanbao-Suche gibt nicht nur Webseiten-Ergebnisse zurück, die sich auf Titel, Zusammenfassungen und Links konzentrieren, sondern auch eine Art von vertikalen Informationsquellen, die strukturierte Daten für Szenarien wie Wetter, Aktienkurse und Goldpreise bereitstellen.
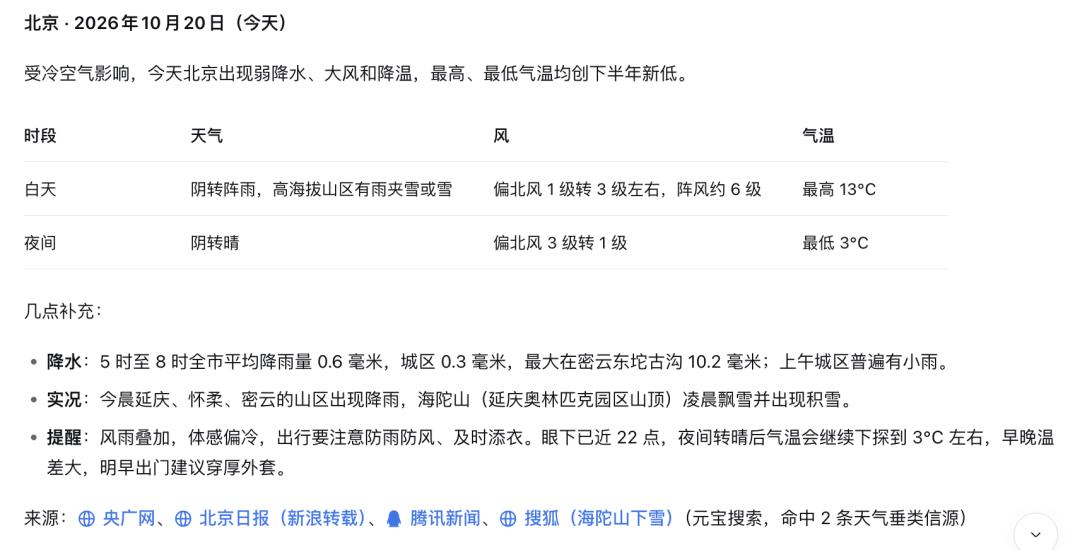
Wenn Sie beispielsweise "heutiges Wetter in Peking" abfragen, wird eine strukturierte VR-Karte zurückgegeben, die die Informationen sehr klar widerspiegelt.
Wir haben auch versucht, den Aktienkurs von Tencent zu suchen, und haben ebenfalls die vertikale Informationsquelle getroffen. Das von der Yuanbao-Suche zurückgegebene Ergebnis enthält eine Aktienkurskarte, deren Daten von Tencent Zixuan Gu stammen.
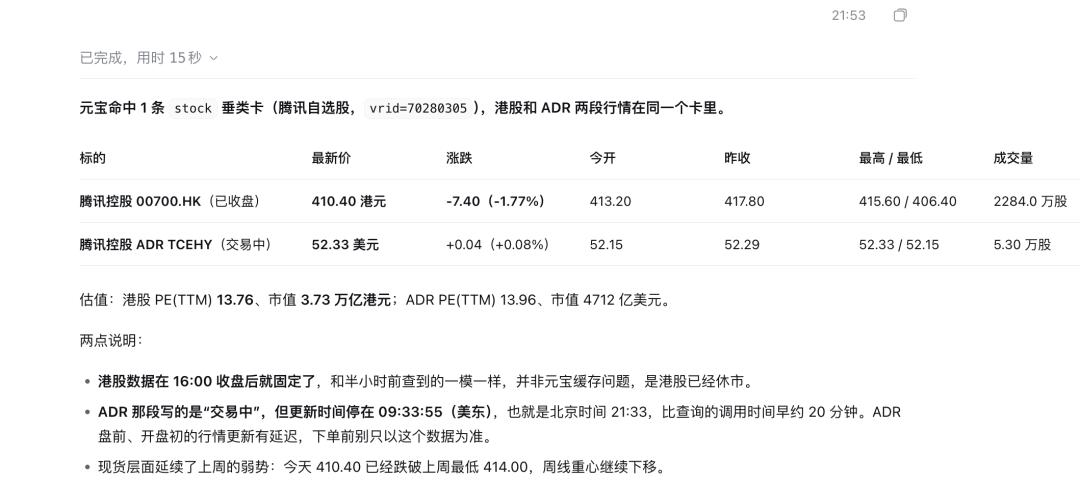
Das bedeutet, dass der Agent bei Aufgaben mit klar definierten Datenstrukturen nicht immer zuerst die Webseite öffnen, den Text crawlen und dann die erforderlichen Felder extrahieren muss, sondern die von der Suchschnittstelle zurückgegebenen Daten direkt verarbeiten kann.
Für Agenten, die Tools nacheinander aufrufen, Informationen organisieren und die nächsten Schritte ausführen müssen, kann ein fehlender Crawling- und Analyseschritt die Effizienz erheblich steigern.
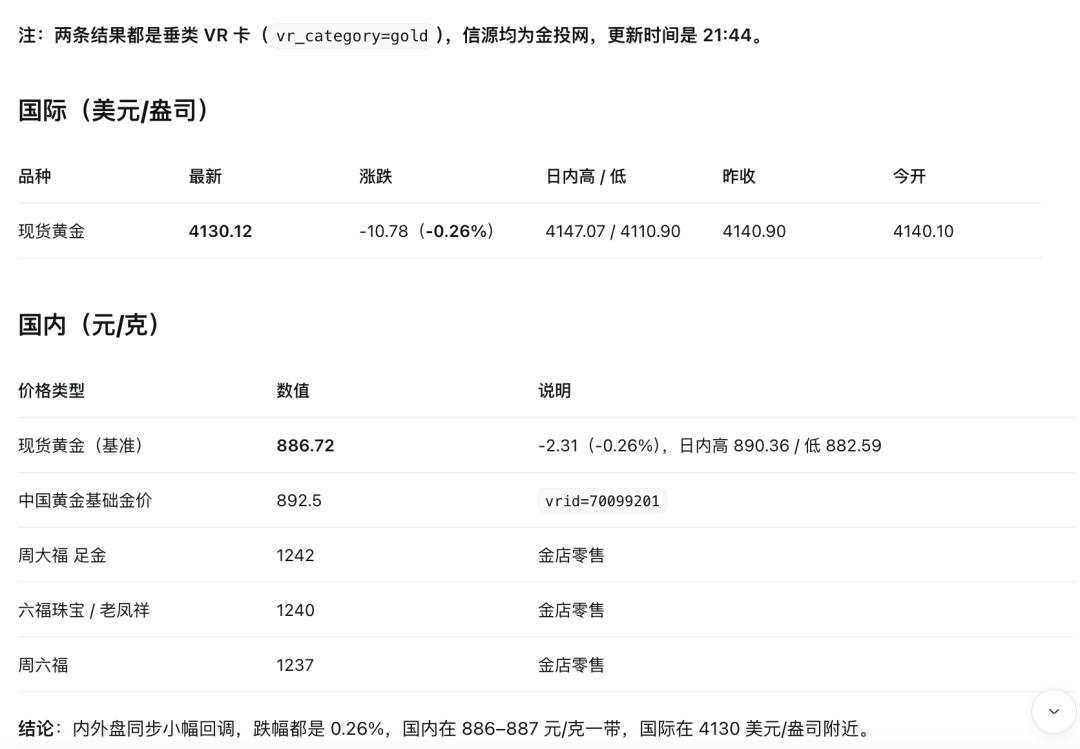
Anschließend haben wir Aufgaben wie Richtlinienabfrage, akademische Forschung und Organisation von Entwicklerressourcen ausgewählt und in Kombination mit dem Crawling-Tool in DeepSeek Harness die Leistung der Yuanbao-Suche in tatsächlichen Szenarien weiter getestet.
Zuerst haben wir die Abfrage von Richtlinieninformationen getestet, indem wir die Eingabe "Verwenden Sie die Yuanbao-Suche, um die Informationen zu den diesjährigen KI-bezogenen Richtlinien abzufragen" eingegeben haben. Nach etwa 42 Sekunden hat der Agent eine Liste der Richtlinieninformationen erstellt, eine Tabelle mit Zeit, Dokumentenname, Herausgeber und Schlüsselinhalten erstellt und mehrere Hauptlinien der Richtlinien zusammengefasst.
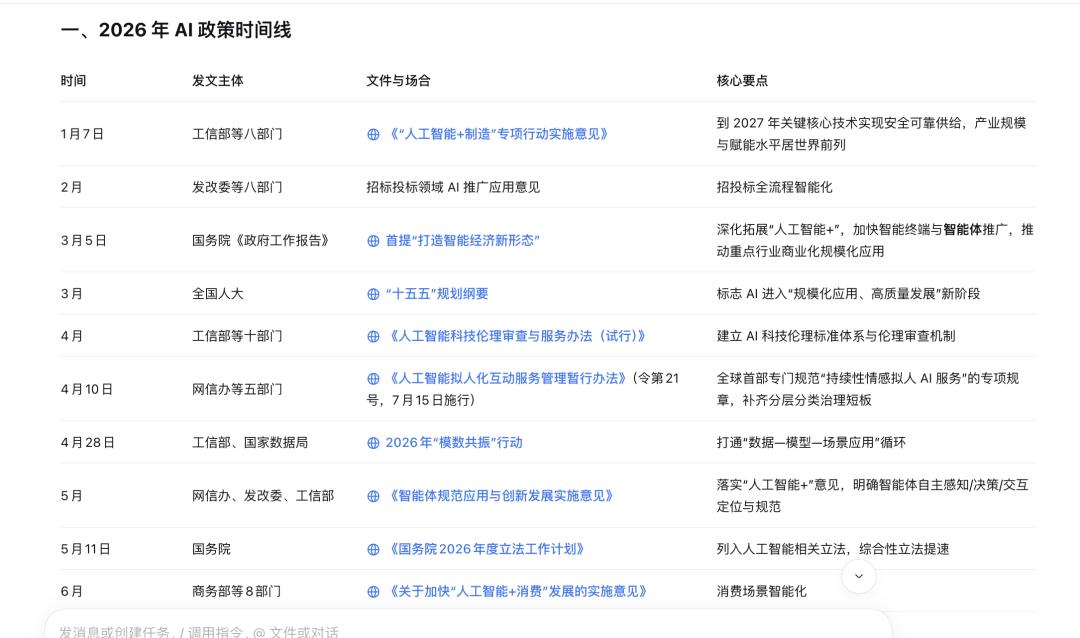
Den Ergebnissen zufolge stammen die Informationen hauptsächlich von Websites von Behörden wie dem Ministerium für Industrie und Informationstechnologie und dem Ministerium für Handel. Dies erleichtert das schnelle Verständnis der Richtlinienentwicklung und bietet einen klaren Eingang für die anschließende Suche nach Originaldokumenten und die Überprüfung spezifischer Bestimmungen.
Akademische Forschung ist ein weiteres Szenario, das für die Zusammenarbeit zwischen Suche und Agent geeignet ist. Wir haben das kürzlich beachtete Thema rekursive Selbstverbesserung (RSI) als Thema verwendet, um die Yuanbao-Suche aufzurufen, um relevante Arbeiten der letzten sechs Monate zu finden und den Forschungsfortschritt zu organisieren. Nach etwa zweieinhalb Minuten hat das System die relevanten Materialien zurückgegeben.
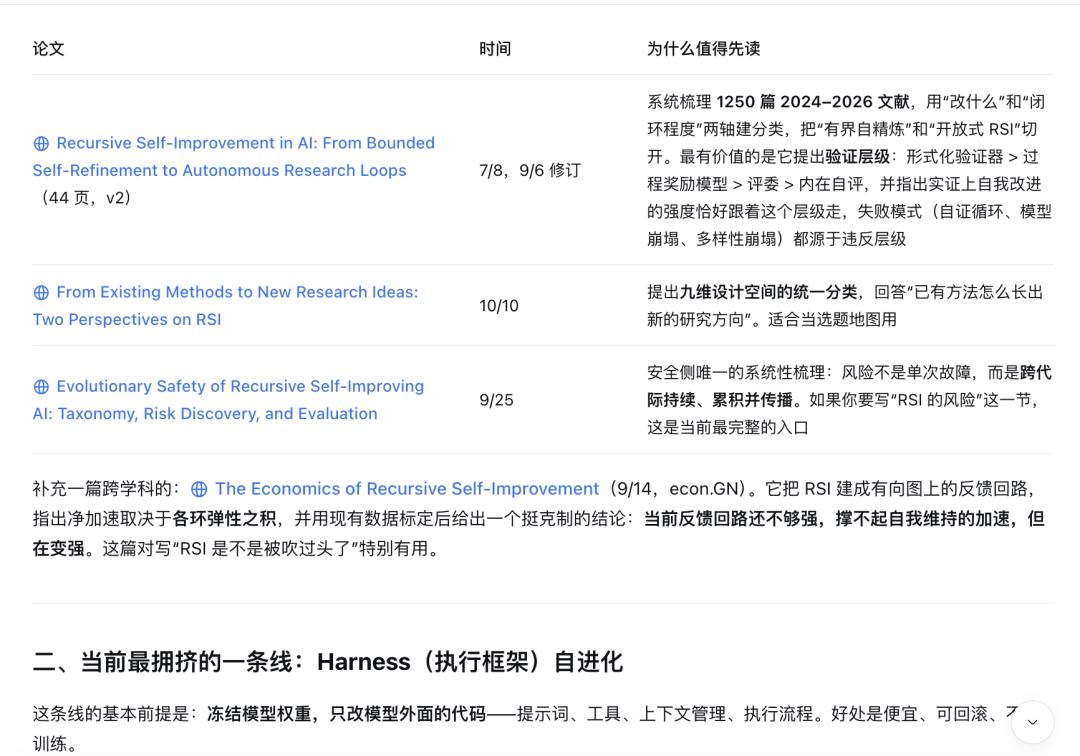
Auf dieser Grundlage haben wir weiter die arXiv-API kombiniert, um Informationen zu Arbeiten abzurufen, die Literatur gegenseitig zu überprüfen und eine RSI-Übersicht zu erstellen. Durch die Zusammenarbeit beider kann der Agent die Suchergebnisse weiter in systematischere Forschungsmaterialien umwandeln.
