Liang Wenfeng hat das Geheimnis des Geldverdienens quelloffen gemacht.
Neben dem neuen Modell hat DeepSeek innerhalb einer Woche nacheinander die selbst entwickelte Suchfunktion, das Inferenz-Framework und die Codec-Komponenten auf den Markt gebracht. Obwohl der Suchdienst ab dem 1. November kostenpflichtig wird, sind die übrigen Produkte kostenlos und quelloffen.
Diese drei Produkte lassen sich tatsächlich zu einer zusammenhängenden Kette verbinden: Egal welches Rechenplattform, welches Harness oder welches Modell Sie verwenden, sobald Sie diese drei Komponenten kombinieren, können Sie die gleichen Produkte wie DeepSeek nutzen und die gleichen Schnittstellen von DeepSeek aufrufen.
Liang Wenfengs Ansicht zur quelloffenen Allgemeinverfügbarkeit stimmt genau damit überein. Er sagte einmal in einer nicht öffentlichen Sitzung: „Wir werden kein minderwertiges Open-Source-Produkt veröffentlichen und dann selbst eine bessere Version für unseren eigenen Einsatz verwenden.“
Gleichzeitig hat DeepSeek in einem Artikel die konkreten Einnahmen pro Grafikkarte und pro Stunde von DeepSeek veröffentlicht.
In dem neuesten Artikel des offiziellen WeChat-Accounts von DeepSeek steht zudem ein Satz: „Tue Gutes gemeinsam mit anderen, teile Geschicklichkeit mit allen, damit sie es beherrschen können.“
Dieser Satz stammt aus dem Werk „Yin Wenzi · Dadaoshang“ von Yin Wen, einem namhaften Gelehrten der Zeit der Streitenden Reiche. In moderner Sprache ausgedrückt bedeutet er: Wenn man Gutes tut, soll man alle anderen mitnehmen; wenn man Fähigkeiten und Fertigkeiten erlernt, soll man dafür sorgen, dass die breite Masse sie beherrschen kann.
Das ist auch das grundlegende Motiv von Liang Wenfeng, diese drei Produkte zu veröffentlichen: Die Nutzer können sie kostenlos nutzen, und DeepSeek erhält im Gegenzug Datenströme und Zugangspunkte, sodass am Ende beide Seiten gewinnen.
Liang Wenfengs Vorgehen wirkt „unabhängig und eigenwillig“, schließlich haben OpenAI, Anthropic und sogar alle KI-Unternehmen weltweit es nie gewagt, ihre Produkte so offen und ehrlich quelloffen zu stellen.
Wenn man aber die Perspektive erweitert, stellt man fest, dass Liang Wenfengs Strategie der von Coca-Cola erstaunlich ähnelt.
Wofür sind diese drei Produkte gedacht?
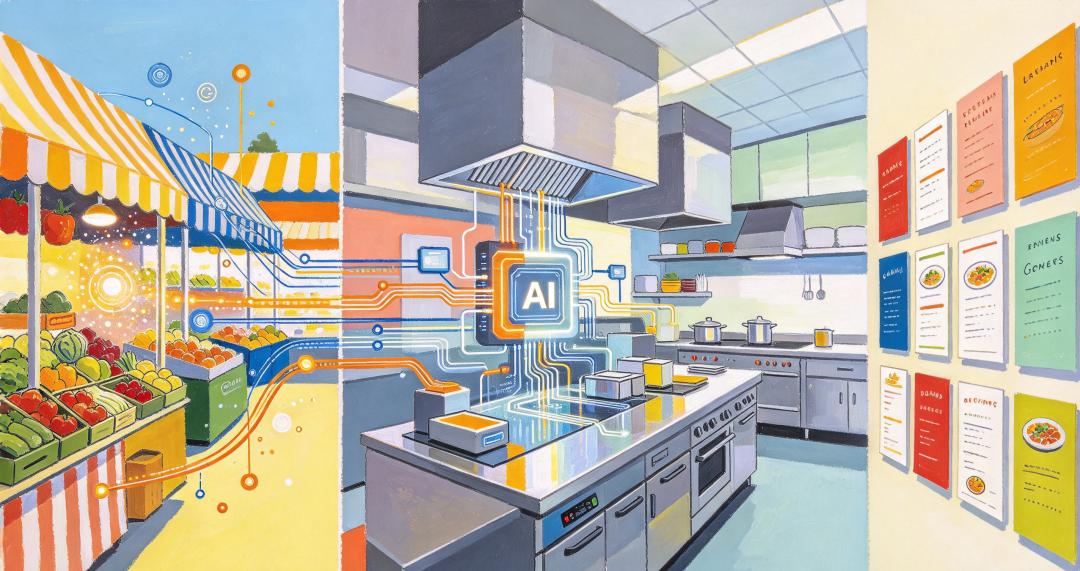
Zuerst eine kurze Erläuterung der drei Produkte. Zusammengefasst: Search und Fetch sind der „Einkäufer“ des Restaurants, der dafür zuständig ist, Zutaten vom externen Markt zu beschaffen; DeepInfer ist die „Küche“, wo das Modell seine Arbeit verrichtet; deepseek-recipe ist das „mehrsprachige Kochbuch“, sodass Menschen aus verschiedenen Ländern verstehen können, was sie konsumieren.
Beginnen wir mit Search und Fetch: Das ist eine Suchfunktion für KI.
Die Suchmaschinen, die wir normalerweise nutzen, sind für Menschen konzipiert. Auf einer Ergebnisseite gibt es Werbung, Empfehlungen und viele Links, die Menschen selbst prüfen müssen – beim Öffnen der Seiten gibt es Navigationsleisten, Pop-ups und Seitenleisten. Menschen können diese Elemente ignorieren, Modelle aber nicht: Jedes überflüssige Wort belegt ihren Kontext, das sind alles Tokens, die Kosten verursachen.
Search und Fetch von DeepSeek sind zwei rohe JSON-Schnittstellen, deren Nutzung genau wie der Aufruf der DeepSeek-API funktioniert und die mit demselben Bearer-Schlüssel authentifiziert werden.
Search ist für das „Suchen“ zuständig: Jedes Ergebnis enthält neben Titel und URL eine kurze Zusammenfassung, eine lange Zusammenfassung, optional den vollständigen Text der Webseite und das Veröffentlichungsdatum. Darüber hinaus gibt es zwei spezielle Werte als Referenz für das Modell: rerank_score (Wert für die Relevanz-Neuordnung) und authority (Autoritätsgrad der Quelle).
Fetch ist für das „Abrufen“ zuständig: Wenn man ihm eine URL gibt, gibt er den bereinigten Markdown-Text der Seite zurück.
Mit anderen Worten: Es handelt sich nicht um ein herkömmliches „Suchfeld“, sondern um „Material, das direkt in den Kontext des Modells eingefügt werden kann“.
Die Preisgestaltung von Search und Fetch ist ebenfalls auf die Nutzung durch Agenten ausgelegt. Jede 1000 erfolgreichen Anfragen kosten 5 Yuan, was umgerechnet nur 0,005 Yuan pro Suchvorgang entspricht.
Der offiziellen Dokumentation zufolge werden Search und Fetch, die über serverseitige Tool-Aufrufe in den drei Tools DeepSeek Harness, Claude Code und Codex verwendet werden, vor dem 1. November 2026, 00:00 Uhr Beijing-Zeit nicht berechnet – danach erfolgt die Abrechnung pro Nutzung.
Darüber hinaus sind Search und Fetch nicht an die Modelle von DeepSeek gebunden. Mit nur einer DeepSeek-API können Sie Search und Fetch auf jedem beliebigen Modell aufrufen.
Das zweite Produkt ist DeepInfer.
DeepInfer ist das Inferenz-Framework, das DeepSeek derzeit für groß angelegte Online-Dienste nutzt. Die jetzt veröffentlichte Open-Source-Version ist die Offline-Inferenz-Variante mit den Kernfunktionen, lizenziert unter Apache 2.0 und läuft auf Nvidia-Plattformen sowie auf inländischen Rechenplattformen.
Viele Menschen glauben, dass die Arbeit abgeschlossen ist, sobald ein Modell veröffentlicht und die Gewichtsdateien auf den eigenen Computer heruntergeladen wurden.
Das stimmt aber nicht. Die Gewichte sind nur eine große Sammlung von Zahlen. Damit sie effizient ausgeführt werden können, braucht es eine komplette Ingenieurskette dazwischen – diese Kette wird als Inferenz-Framework bezeichnet.
Ein Modell ist wie ein Buch voller Schriftzüge: Auch wenn das Buch große Schätze enthält, kann es nicht selbst sprechen und schon gar nicht Ihre Fragen beantworten.
DeepInfer ist das Programm, das dieses Buch zum Sprechen bringt. Sie senden eine Anfrage an es, es gibt diese an die Modell-Datei weiter, die Zahlen in der Modell-Datei werden aktiviert, um eine Antwort zu berechnen, die dann an Sie zurückgegeben wird.
DeepSeek gibt offiziell an, dass die Fähigkeitsgrenzen eines Modells durch das Modell selbst festgelegt werden. Die Kernaufgabe eines Inferenz-Frameworks besteht darin, diese Fähigkeiten zu angemessenen Kosten für eine große Anzahl von Nutzern bereitzustellen.
Das dritte Produkt ist deepseek-recipe.
Ähnlich wie das Begrüßen in verschiedenen Ländern: In China sagt man „Nihao“, in den USA sagt man „Hello“. Auch die Ausgabformate verschiedener Modelle unterscheiden sich: Das Format von OpenAI heißt Chat Completions bzw. Responses, das Format von Anthropic heißt Messages.
Obwohl all dies letztendlich bedeutet, „dem Modell eine Frage zu stellen und eine Antwort von ihm zu erhalten“, sind die Formate unterschiedlich. Selbst identische Dialoge können nicht zwischen verschiedenen Modellen ausgetauscht werden.
Nehmen wir an, Sie möchten das DeepSeek-Modell auf Ihrem eigenen Server ausführen, aber Ihre Client-Software ist im Format von OpenAI geschrieben. Wenn Sie eine Anfrage im OpenAI-Format an das DeepSeek-Modell senden, versteht es diese nicht. Dann braucht es eine Komponente, die die Anfrage übersetzt.
Genau diese Übersetzungsfunktion übernimmt deepseek-recipe. Sie senden eine Anfrage im OpenAI-Format, es übersetzt diese in eine interne Sprache (Prompt), die das DeepSeek-Modell versteht, kodiert sie in Zeichen (Tokens), die das Modell erkennt, und nachdem das Modell geantwortet hat, übersetzt es die Antwort zurück in das OpenAI-Format und gibt sie an Sie weiter.
Sie müssen Ihr Eingabeformat nicht ändern, und zwei verschiedene Modelle können Sie trotzdem verstehen.
In dem offiziellen technischen Artikel werden zwei echte Probleme genannt, die es löst.
Das erste ist der Schutz vor Injektionen: Spezielle Markierungen dienen normalerweise dazu, Rollen und Grenzen zu kennzeichnen, aber Nutzer können absichtlich dieselben Zeichenfolgen in ihre Eingabe eingeben, um sich als System auszugeben und Befehle zu erteilen. Das Vorgehen von recipe besteht darin, dass nur Markierungen, die explizit beim Erstellen des Prompts eingefügt werden, auf echte spezielle Tokens abgebildet werden – derselbe Text in der Nutzereingabe wird als normaler Text kodiert.
Das zweite ist die Beschleunigung bei langen Texten: Normaler Text zwischen speziellen Markierungen kann unabhängig kodiert werden, sodass zuerst die Grenzen lokalisiert, dann die einzelnen Abschnitte parallel kodiert und schließlich in der richtigen Reihenfolge zusammengefügt werden. Dadurch wird die Tokenisierungsverzögerung bei Anfragen mit langem Kontext verringert.
In realen Szenarien lassen sich diese drei Produkte miteinander verbinden. Wenn ein Unternehmen beispielsweise das V4.1 Flash selbst bereitstellen möchte, braucht es DeepInfer. Wenn es mit anderen Modellen zusammenarbeiten möchte, nutzt es recipe zur Formatumwandlung.
Die Ausführungsebene nutzt dann diesen Aufruf, um Search und Fetch anzufragen, fügt die bereinigten Ergebnisse zurück in den Dialog, und das Modell gibt die Antwort weiter aus.
Warum ähnelt DeepSeek Coca-Cola?
Diese drei Komponenten haben noch eine Gemeinsamkeit: Jede von ihnen öffnet eine Tür, sodass Sie unabhängig von Ihrem Anwendungsfall auf die Produkte von DeepSeek zugreifen können.
Wenn Sie über ausreichende Rechenleistung verfügen und die gleiche Inferenzfähigkeit wie die offizielle DeepSeek-Version selbst bereitstellen möchten, nutzen Sie DeepInfer zusammen mit den bereits veröffentlichten Modellgewichten.
Darüber hinaus ist DeepInfer vollständig kompatibel, egal ob Sie Nvidia-GPUs oder inländische GPUs verwenden.
Wenn Sie bereits ein eigenes Inferenz-Backend haben und das DeepSeek-Modell ausführen möchten, ohne selbst die Protokollumwandlung und Prompt-Rendering neu schreiben zu müssen, nutzen Sie deepseek-recipe.
Wenn Sie Modelle oder Harness von anderen Anbietern verwenden und die Vernetzungsfähigkeit unzureichend ist, schließen Sie Search und Fetch an.
Zusammengefasst lässt sich das mit zwei Wörtern beschreiben: „Alles arrangiert“. Sie müssen sich um nichts sorgen, Liang Wenfeng hat alles perfekt für Sie vorbereitet.
Darüber hinaus gibt es eine interessante Sache: Liang Wenfeng hat seine eigenen Trümpfe offengelegt.
In dem Artikel über die Bereitstellungspraxis von DeepSeek steht nicht nur, „wie wir vorgehen und bereitstellen sollen“, sondern auch die konkreten Kosten: Der Durchsatz eines einzelnen Clusters beträgt 155 Billionen Tokens pro Tag, der Gesamtumsatz beträgt nach marktüblichen Preisen durchschnittlich 38 US-Dollar pro Grafikkarte und Stunde. Bei Prefill werden 60.000 bis 1,5 Millionen Tokens pro Grafikkarte und Sekunde verarbeitet, bei Decode 14.000 Tokens pro Grafikkarte und Sekunde. Die Ausgabegeschwindigkeit, die ein einzelner Nutzer wahrnimmt, beträgt etwa 230 Tokens pro Sekunde, in Code-Szenarien etwa 300 Tokens. Die durchschnittliche Latenz für das erste Zeichen beträgt 400 Millisekunden, bei P99 1000 Millisekunden.
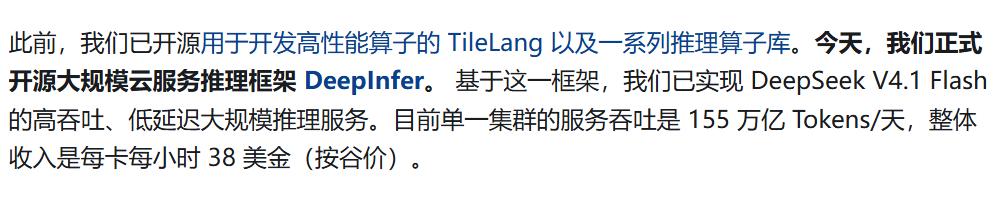
Das bedeutet im Grunde, der Branche mitzuteilen: Wie die Hardware aufgebaut ist, wie lange der Cache vorgehalten wird und wie viel Einnahmen eine einzelne Grafikkarte pro Stunde generieren kann. Multipliziert man 38 US-Dollar mit 24 Stunden und dann mit 30 Tagen, ergibt sich ein monatlicher Umsatz von etwa 27.000 US-Dollar pro Grafikkarte.
Zudem treffen bei durchschnittlich 77.000 Eingabe-Tokens pro Anfrage 96 % davon im Cache zu – nach einem Cache-Treffer vervierfacht sich der Durchsatz pro Grafikkarte um das 25-fache.
Liang Wenfeng sagte einmal in einer nicht öffentlichen Sitzung für Investoren: „Unsere API-Preise bringen einen angemessenen Gewinn. Wenn wir eine Charge Geräte auf dem Markt kaufen, haben wir die Kosten in 10 Monaten wieder hereingeholt – das halte ich für einen angemessenen Gewinn.“
Die Einnahmen pro Grafikkarte sind im Wesentlichen genauso wie unsere Gehälter: In fast allen Einrichtungen sind Gehälter normalerweise geheim. Auch OpenAI und Anthropic haben die wirtschaftlichen Kennzahlen pro Grafikkarte nie veröffentlicht.
Liang Wenfeng hat diese Geheimnis durchbrochen, was zu seiner eigenen Philosophie passt. In der nicht öffentlichen Sitzung erklärte er, dass DeepSeek nur angemessene Gewinne anstrebt und dass diejenigen, die weniger Gewinn nehmen, diejenigen besiegen werden, die mehr Gewinn anstreben.
Allein anhand der Einnahmen und der Preise der eigenen DeepSeek-API wird deutlich, dass DeepSeek eindeutig zu der Gruppe gehört, die weniger Gewinn nimmt. Die Veröffentlichung dieser Zahlen beweist auch den Satz, den Liang Wenfeng einmal sagte: „Wir streben nur einen angemessenen Gewinn an, keine Gewinnmaximierung.“
Auf der anderen Seite zeigt Liang Wenfengs Mut, diese Zahlen preiszugeben, auch: „Die Wettbewerbsvorteile von DeepSeek liegen überhaupt nicht in den Kosten.“
DeepSeek ist das Coca-Cola des KI-Zeitalters: Das Rezept ist vollständig offen, aber das Geldverdienen hängt überhaupt nicht vom Rezept ab.
Im Jahr 2011 ist das Rezept von Coca-Cola durchgesickert, aber das Ergebnis war: „Nichts ist passiert.“
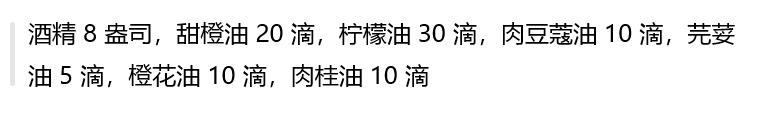
Coca-Cola gab an, dass es sich nicht um das aktuell genutzte Rezept handelt, sondern um ein frühes historisches Manuskript – die derzeit in Massenproduktion hergestellte Version wurde längst weiterentwickelt und verändert.
Die Podcast-Redaktion von „This American Life“ hat selbst den Aromenentwickler der Limonadenfabrik Jones Soda gebeten, das Rezept nachzubilden. Bei anschließenden Blindtests konnten einige Probanden die beiden Getränke nicht unterscheiden, andere langjährige Coca-Cola-Liebhaber stellten Unterschiede zwischen den beiden Rezepten fest.
Trotzdem blieb der Aktienkurs von Coca-Cola unverändert, der Umsatz ist sogar leicht gestiegen. Denn der wahre Wettbewerbsvorteil von Coca-Cola war nie das Sirup-Rezept, sondern das Abfüll- und Vertriebsnetz, die Markenwahrnehmung und die Kostendisziplin.
Nicht Coca-Cola als Produkt steht im Vordergrund, sondern das Trinken von Coca-Cola.
Genauso verhält es sich mit DeepSeek: Fast alles, was quelloffen gemacht werden kann, ist bereits veröffentlicht, jeder kann es sich herunterladen. Unternehmen, die es wagen, ihr „Rezept“ offenzulegen, besitzen etwas, das wertvoller ist als das Rezept selbst.