Tiefgehende Retrospektive des Codex-Star-Teams: Wie ist der absolute Top der Programmierbranche entstanden?
Am Tisch der KI-Programmierwerkzeuge hatte Codex von OpenAI lange Zeit nicht einmal die Zugangsberechtigung: Es gab nur wenige Nutzer, die Reputation war durchschnittlich, und das Team stand kurz vor der Auflösung. Heute hat es sich jedoch vollständig verwandelt, ist zum Grundsystem der Desktop-Version von ChatGPT geworden, betreut 40 Millionen wöchentlich aktive Nutzer und hat die Download-Zahl der CLI-Version erfolgreich Claude Code übertroffen.
Codex brauchte weniger als ein Jahr, um diese Aufholjagd zu gewinnen.
Nach einem Bericht von Zhidongxi vom 20. Oktober hat Dan Shipper, Gründer der mit OpenAI eng verbundenen KI-Firma Every, kürzlich einen langen Artikel mit dem Titel „How Codex Happened“ veröffentlicht. Durch Interviews mit Kernmitgliedern wie Greg Brockman, Mitbegründer von OpenAI, Thibault Sottiaux (Tibo), Leiter des Codex-Teams, Alexander Embiricos, Produktverantwortlicher von Codex, und Designer Andrew Ambrosino hat er diese Geschichte vollständig nachvollzogen.
Dieser Artikel liefert der Öffentlichkeit viele Erfahrungen und Lehren für die Produktentwicklung. Zum Beispiel wurde die Cloud-Version von Codex intern gut bewertet, fand aber extern keine Resonanz. Die Ursache lag darin, dass Nutzer ihre gesamte Entwicklungsumgebung in die Cloud verlegen mussten, was mit sehr hohen Kosten verbunden war. Das Codex-Team gab später zu, dass seine eigene Entwicklungsumgebung hochgradig standardisiert war und die strengen Anforderungen an externe Nutzer verdeckte. Ein Produkt muss „dorthin gehen, wo die Nutzer sind“, und nicht nur in der vertrauten eigenen Umgebung gut funktionieren.
Als die Form von Codex noch unentschieden war, entschied sich OpenAI für mehrere parallele Ansätze. Mitarbeiter beklagten, dass diese Wahl chaotisch und verschwenderisch sei, aber Altman antwortete: „OpenAI investiert sozusagen in eine Reihe von Startups – nur dass sie sich alle im Unternehmen befinden.“ Diese interne Konkurrenz und Mehrfachwetten verhindern, dass das nächste Produkt durch den Erfolg bestehender Produkte erstickt wird, und vermeiden wirksam das Auftreten des „Innovatorendilemmas“.
Nachdem die Nutzerzahl von CLI und Plug-Ins stark angestiegen war, wagte das Codex-Team die Wette auf die nächste Form. Auch wenn intern keine Einigkeit bestand, entschied Tibo, den größten Einsatz auf native Desktop-Anwendungen zu legen, was schließlich zu dem größeren Erfolg von Codex führte.
Als Nächstes lassen wir die Zeit zurück bis Ende 2024 laufen, um zu sehen, wie diese Aufholjagd genau gewonnen wurde.
Die folgenden Inhalte sind die auf Basis des Originaltexts zusammengestellten Kernpunkte:
01.
Alles begann mit dem Satz „Denke nach …“ auf dem Bildschirm
Heutige KI-Produkte haben eine vertraute Oberfläche: Nach der Eingabe einer komplexen Anfrage erscheint an der Stelle der Antwort der Text „Denke nach“. Dahinter verbirgt sich ein Paradigmenwechsel im Computing.
Die ersten großen Modelle ähnelten eher Improvisationskünstlern: Sie mussten Wort für Wort improvisieren, konnten nicht planen und nicht zurückblicken. Aber frühe Nutzer stellten fest, dass die Antworten deutlich besser werden, wenn man das Modell dazu bringt, „zuerst Schritt für Schritt zu schließen und dann zu antworten“ – das ist die Prompt-Methode der „Gedankenkette“.
Anschließend trainierte OpenAI dieses Verhalten direkt in das Modell ein: Bevor das Modell auf die Anfrage des Nutzers antwortet, führt es zuerst Überlegungen auf einem „Notizblatt“ (Schlussfolgerungspfad) durch, kann bei einer Sackgasse zurückgehen, den endgültigen gangbaren Pfad auswählen und dann mit der Antwort beginnen.
Im September 2024 wurde die Vorschauversion des Modells OpenAI o1 veröffentlicht, das erste Modell mit Merkmalen der Gedankenkette. Wenn es sich bei schwierigen Aufgaben etwas mehr Zeit nimmt, kann es bessere Antworten liefern.
Die Programmierung ist eines der Szenarien, für die das Schlussfolgermodell am besten geeignet ist: Code ändern, ausführen, Ergebnis anzeigen – eine Selbstprüfung in wenigen Sekunden, ein geschlossener selbstkonsistenter Kreislauf. Theoretisch kann das Schlussfolgermodell jede Programmieraufgabe unabhängig erledigen, wenn es genügend Zeit erhält.
02.
Mehrere parallele Wege: Die vielen Anfänge von Codex
Einen KI-Programmierer zu bauen, ist seit Jahren eine Bestrebung von OpenAI. Der Name Codex ist auch nicht neu: Die erste Version von Codex aus dem Jahr 2021 war ein Modell, das auf GPT-3 basierte, mit öffentlichem Code feinabgestimmt wurde und zur Steuerung des ersten GitHub Copilot verwendet wurde.
Ende 2024 wurde „Programmierung“ zu einem unternehmensweiten Ziel von OpenAI erhoben, und mehrere Teams versuchten aus verschiedenen Perspektiven, dasselbe Problem zu lösen.
Einer der Wege stammte von Alexander Embiricos, Produktverantwortlicher von Codex. Nachdem OpenAI das Startup Multi übernommen hatte, kam Embiricos zu OpenAI. Als er zum ersten Mal ein Schlussfolgermodell sah, das an ein Terminal angeschlossen war, erlebte er einen berufserschütternden Moment:
„Der erste Moment, in dem ich wirklich ‚AGI berührt‘ habe, war, als ich ein an das Terminal angeschlossenes Schlussfolgermodell sah. Ich weiß, dass es heutzutage nichts Besonderes ist, aber es war wirklich unglaublich cool, zuzusehen, wie es selbst Dateien liest, Befehle ausführt und Fehler Schritt für Schritt behebt.“
Damals liefen alle KI-Programmierwerkzeuge auf dem Markt auf VS Code: Copilot erledigte die automatische Vervollständigung, Cursor und Windsurf boten sekundenschnelle Fragen und Antworten, alle stützten sich auf einen dichten Feedback-Zyklus, auch weil die damaligen Modelle keine langfristige autonome Arbeit leisten konnten.
Die Schlussfolgermodelle von OpenAI waren hingegen das Gegenteil: Wenn die Denkzeit unterbrochen wurde, waren sie langsam und schwach. Embiricos wollte das „Langsame“ zu einem Vorteil machen: Da es lange nachdenken muss, soll es nachdenken und eine vollständige Aufgabe erledigen.
Aber das lange Nachdenken des Modells stellte ein Produktproblem dar: Nutzer konnten nicht auf eine Blackbox warten. Daraus leitete Embiricos eine Regel ab: Egal wie lang die Aufgabe ist, Nutzer müssen alle 30 Sekunden, spätestens nach einer Minute, sehen können, was das Modell tut. Der sichtbare Fortschritt des Agents bei der Arbeit ist selbst Teil des Produkts.
Ein anderer Weg entstand zufällig. Thibault Sottiaux (das Team nennt ihn Tibo) ist ein Ingenieur für Entwicklungsinfrastruktur. Im Dezember 2024 begann er damit, zu erforschen, wie Schlussfolgermodelle die Forschung selbst beschleunigen können: Er trainierte interne Programm-Agents auf dem Monorepo von OpenAI, um Forschern beim Schreiben von Python-Code für die Durchführung und Bewertung von Experimenten zu helfen. Da die Forscher es täglich nutzten, war das Feedback schnell, und das Team konnte das Modell immer schneller trainieren.
▲Thibault Sottiaux
Der entscheidende Punkt ist: Die Techniken, mit denen sie diese Programmiermodelle trainierten, unterschieden sich von den Methoden, mit denen OpenAI die Hauptlinie von ChatGPT trainierte, und beide Seiten waren lange Zeit kaum miteinander vereinbar. Intern bei OpenAI entstand tatsächlich eine zweite Modellinie: Eine Linie ist das allgemeine Modell für die Öffentlichkeit, die andere ist die spezielle Programmiermodellinie für die Forschung und Entwicklung.
Später wurde diese Nebenlinie als Quelle der „Magie“ von Codex angesehen. Tibo enthüllte jedoch, dass OpenAI intern nie die Entscheidung getroffen hat, die Modellinien aufzuteilen. Anfangs war dies nur eine Forschungsuntersuchung, eine Optimierung der Iterationsgeschwindigkeit von OpenAI.
Tibos interner Programm-Agent löste jedoch nur das Problem, wie das Modell stärker wird, und war nicht für alle Nutzer geeignet. Damit Codex wirklich Gestalt annehmen konnte, brauchte es die Beteiligung anderer Teams.
Anfang 2025 begannen mehrere Teams bei OpenAI, die aus verschiedenen Perspektiven KI-Programmierung erforschten, zusammenzuarbeiten. Die Teams von Tibo und Embiricos fusionierten zuerst, anschließend wurde auch das Forschungsprojekt Scientist Assistant (Wissenschaftlerassistent) von OpenAI integriert.
Als das Team vollständig war, war die nächste Frage, wie das Produkt aussehen sollte. Der Mitbegründer Greg Brockman fasste zusammen, dass das ungelöste Problem damals der Formfaktor war: Soll dieser Agent im Terminal, im Editor oder auf dem eigenen Computer in der Cloud laufen? Niemand wusste, welche Wege Sackgassen sind, und OpenAI entschied sich tatsächlich für das Konzept der mehreren parallelen Ansätze.
Diese Mehrfachwetten bereitete den Mitarbeitern von OpenAI jedoch Probleme. Einige Mitarbeiter beklagten privat, dass dies chaotisch und verschwenderisch sei – wer möchte in einem Unternehmen in einem Agent-Team arbeiten, das nur den dritten Platz belegt? Auf diese Kritik antwortete Sam Altman, Gründer und CEO von OpenAI:
„In gewissem Sinne investiert OpenAI in eine Reihe von Startups – nur dass sie sich alle im Unternehmen befinden.“
03.
Die Cloud-Version von Codex: Gute Bewertungen, aber wenige Nutzer
Bevor Codex von OpenAI offiziell veröffentlicht wurde, brachte Anthropic am 24. Februar 2025 Claude Code auf den Markt. Dieses Produkt hat keinen eigenen Editor, sondern läuft direkt im Terminal und bearbeitet Dateien auf dem Computer: Es kann in der Mitte der Arbeit unterbrochen werden, und die Erfahrung der letzten Sitzung kann in die nächste Sitzung übernommen werden – eine Fähigkeit, die die damaligen Cloud-Lösungen nicht erreichen konnten.
Tibo enthüllte, dass Codex auch die Terminal-Route erforscht und eine Version entwickelt hat, aber diese einen Monat später aufgegeben wurde, um die vollständige Cloud-Version zu entwickeln. Das endgültige Ziel war es, einen asynchronen Agenten in der Cloud zu realisieren, der von Computer oder Handy aus Aufgaben zuweisen kann. Dahinter steht der langfristige Glaube von OpenAI. Brockman sagte: „Mit Blick auf die Zukunft ist der richtige Formfaktor eine KI in der Cloud mit ihrem eigenen Notebook. Wir haben sie tatsächlich gebaut.“
Nach etwa 7 Wochen Eile wurde die Cloud-Version von Codex am 16. Mai 2025 veröffentlicht. Dieses Produkt stieß bei OpenAI intern auf große Resonanz, fand aber bei externen Nutzern keine Akzeptanz: Um seine volle Leistung zu entfalten, mussten Nutzer die gesamte Software, Berechtigungen und Konfigurationen ihres Notebooks in eine Cloud-VM verlegen, was oft mehrere Stunden dauerte. Die laufende Aufgabe konnte nicht unterbrochen und korrigiert werden. Selbst wenn der Nutzer nur eine Frage stellte, wurde eine neue Cloud-VM gestartet, und die Umgebung musste neu konfiguriert werden.
Bei der anschließenden Nachanalyse gab das Codex-Team zwei Probleme zu: Erstens war ihre eigene Entwicklungsumgebung hochgradig standardisiert und die Aufgaben klar definiert, was die strengen Anforderungen an externe Nutzer verdeckte – das Produkt war nicht „dorthin gegangen, wo die Nutzer sind“. Zweitens, und das ist grundlegender, lag das Problem am Modell: Tibo sagte: „Damals war es zu früh, um dies zu tun, weil das Modell noch nicht klug genug war.“
Gleichzeitig veröffentlichte OpenAI auch eine kleine quelloffene Codex CLI, aber dies war nur ein Randprojekt von zwei Mitarbeitern. Aus Sicherheitsgründen konnte diese CLI nur das allgemeine Modell von OpenAI verwenden, nicht das spezielle Codex-Modell, was die Leistung des Produkts in gewisser Weise einschränkte.
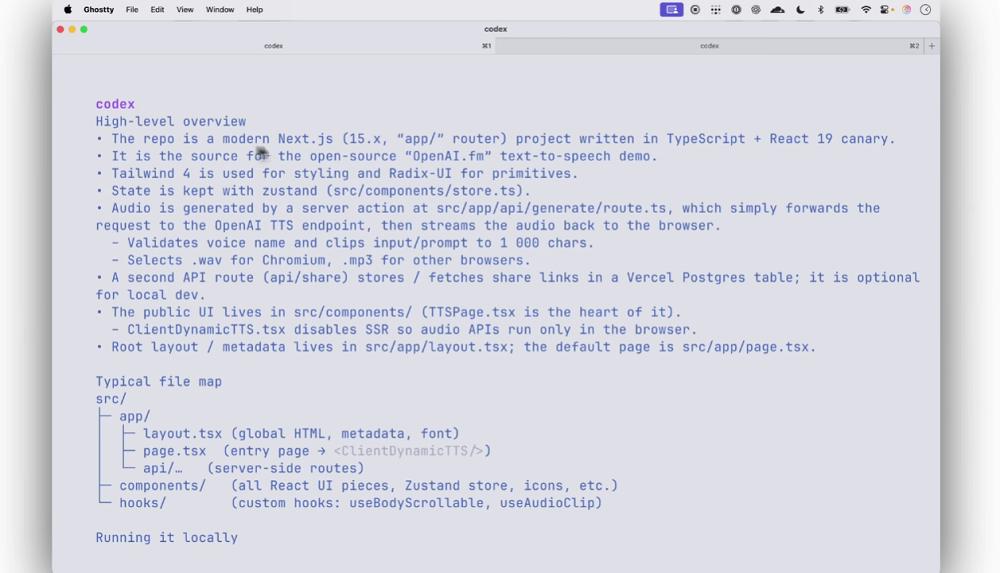
▲Codex CLI
Nachdem das Produkt nicht erfolgreich war, verließ der Ingenieurmanager des Codex-Teams das Unternehmen und wechselte zu Cursor, das damals mit 9 Milliarden US-Dollar bewertet wurde. Die Übernahme von Windsurf durch OpenAI im Wert von 3 Milliarden US-Dollar scheiterte ebenfalls im Juli.
04.
Den Agenten in Rust neu schreiben
Dem Modell einen Kurs über soziale Praxis verpassen
Im Spätsommer 2025 übernahm Tibo die vollständige Leitung dieses Teams, das damals noch ein „Randbereich“ von OpenAI war. Er sagte: „Ich habe das Team übernommen und dann die Richtung erheblich geändert. Wir haben uns auf die lokale Ausführung umgestellt.“
Er beeilte sich nicht, Funktionen zur Codex CLI hinzuzufügen, sondern schrieb Codex in Rust neu, um den Kernmechanismus für „Lesen von Dateien, Ausführen von Befehlen und Beheben von Fehlern“ vollständig von der Terminalschnittstelle zu entkoppeln, sodass es später in Terminal, Editor, Cloud und sogar in ChatGPT integriert werden kann.
Gleichzeitig wurde das Modell von OpenAI optimiert. Michelle Pokrass, die für das Nachtraining von GPT-5 verantwortlich ist, stellte fest, dass Modelle mit guten Benchmark-Ergebnissen in realen Szenarien nicht unbedingt herausragende Fähigkeiten aufweisen, weil die Modelle noch nie chaotische Codebasen gesehen haben und noch nie von Menschen unterbrochen wurden. Brockman nannte dies „einen Schüler, der die SAT-Prüfung mit voller Punktzahl bestanden hat, aber noch nie einen Tag lang gearbeitet hat“.
Daher ließ OpenAI Programmierer GPT-5 bei der Arbeit überwachen, aufzeichnen, wo das Modell scheitert, und wandelte die Fehler in wiederholbare Trainingsaufgaben um, wodurch die Fähigkeit des Modells in realen Szenarien verbessert wurde.
Eine Woche nach der Veröffentlichung von GPT-5 wurden die VS Code- und Cursor-Plug-Ins von Codex veröffentlicht, und Entwickler strömten herbei. Bis Oktober desselben Jahres war die Nutzung um mehr als das Zehnfache gestiegen.
Normalerweise hätte OpenAI die Investitionen in CLI und Editor-Plug-Ins weiter erhöhen sollen. Aber Tib