Direkte Konfrontation mit DeepSeek: MiniMax M3.1 Flash wurde veröffentlicht, mit einem Ausgabedurchsatz von über 200 TPS und einem auf die Hälfte reduzierten Preis.
Das anonyme Modell Space Bunny, das in der KI-Szene für Aufsehen sorgt, hat endlich seinen Besitzer gefunden!
Berichtet von Zhidong am 19. Oktober: Gerade hat MiniMax offiziell M3.1 Flash veröffentlicht, das als leichtgewichtiges, für Codierung/Agent optimisiertes Modell positioniert ist und über einen Kontext von 1 Million Tokens verfügt.
Kurz darauf, am 17. Oktober, ging DeepSeek V4.1 Flash-1017 online. (Liang Sheng hat wieder den Tisch umgeworfen! Das neue Modell von DeepSeek übertrifft GPT-6, die Ära der wunschbasierten Programmierung bricht an.)
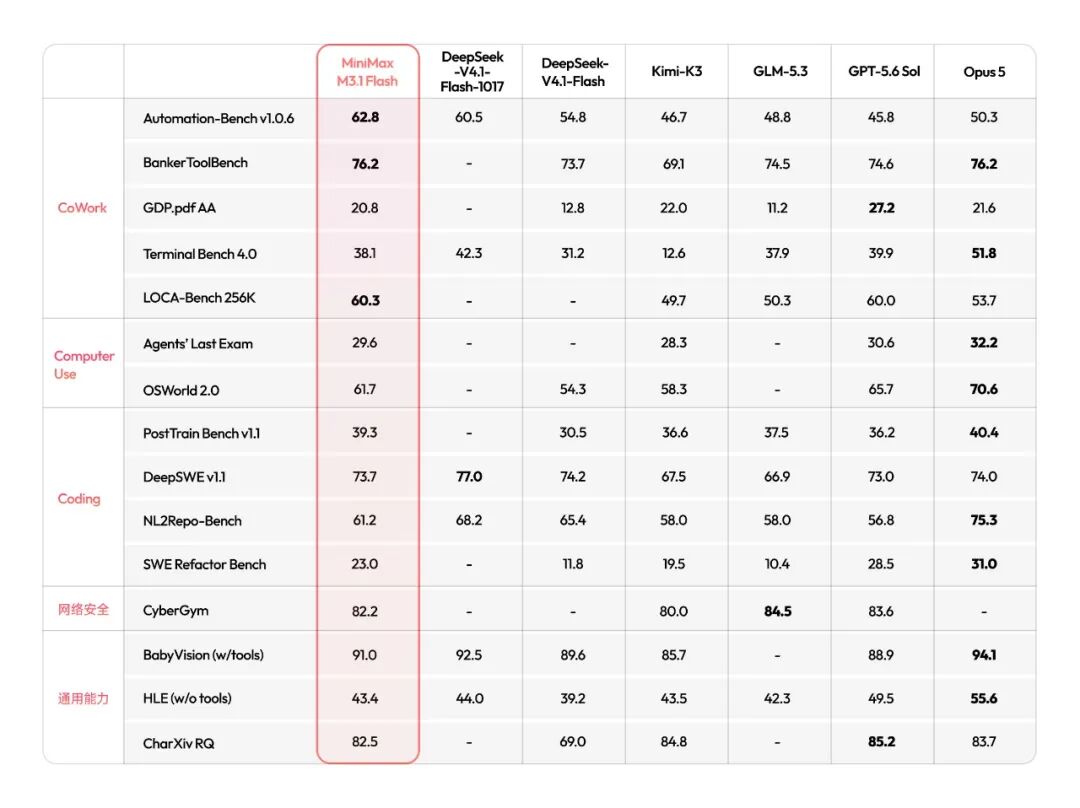
Gemäß den Benchmark-Ergebnissen von M3.1 Flash hat dieses Modell erhebliche Verbesserungen bei Agentic-Aufgaben, Programmierung, Computer Use und Cybersicherheitsfähigkeiten erzielt und ist mit DeepSeek V4.1 Flash-1017 praktisch gleichauf.
Auch preislich hat es die „Abschlusslinie“ weiter durchbrochen. Der Eingabepreis von M3.1 Flash beträgt 1 Yuan pro Million Token, der Ausgabepreis 4 Yuan pro Million Token, und der Preis für das Cache-Lesen liegt bei 0,1 Yuan pro Million Token. Laut den vom MiniMax-Team veröffentlichten Informationen sind die umfassenden Nutzungskosten dieses Modells bei Agentic-Aufgaben um 70 % niedriger als bei dem Vorgängermodell.
Die Preisgestaltung von DeepSeek V4.1 Flash-1017 beträgt außerhalb der Spitzenzeiten 0,02 Yuan pro Million Token für die Eingabe (Cache-Treffer), 1,0 Yuan pro Million Token bei Fehltreffer, 4,0 Yuan pro Million Token für die Ausgabe; während der Spitzenzeiten beträgt der Eingabepreis (Cache-Treffer) 0,04 Yuan pro Million Token, 2,0 Yuan pro Million Token bei Fehltreffer und 8,0 Yuan pro Million Token für die Ausgabe.
Bei den Fähigkeiten jagt man sich gegenseitig, und preislich gibt man sich nicht nach. Mit der nacheinander erfolgten Markteinführung dieser beiden „Flash“-Modelle gibt es bei inländischen Modellen im Flash-Bereich erstmals ein Muster mit zwei starken Konkurrenten.
01.
Analyse des harten Zeugnisses: König des Preis-Leistungs-Verhältnisses
Viele Ergebnisse übertreffen Kimi K3 und GLM-5.3
Der Community-Ruf, den Space Bunny in der anonymen Phase gesammelt hat, lässt die offizielle Version von M3.1 Flash mit sehr hohen Erwartungen beladen. Wie sind seine Ergebnisse tatsächlich?
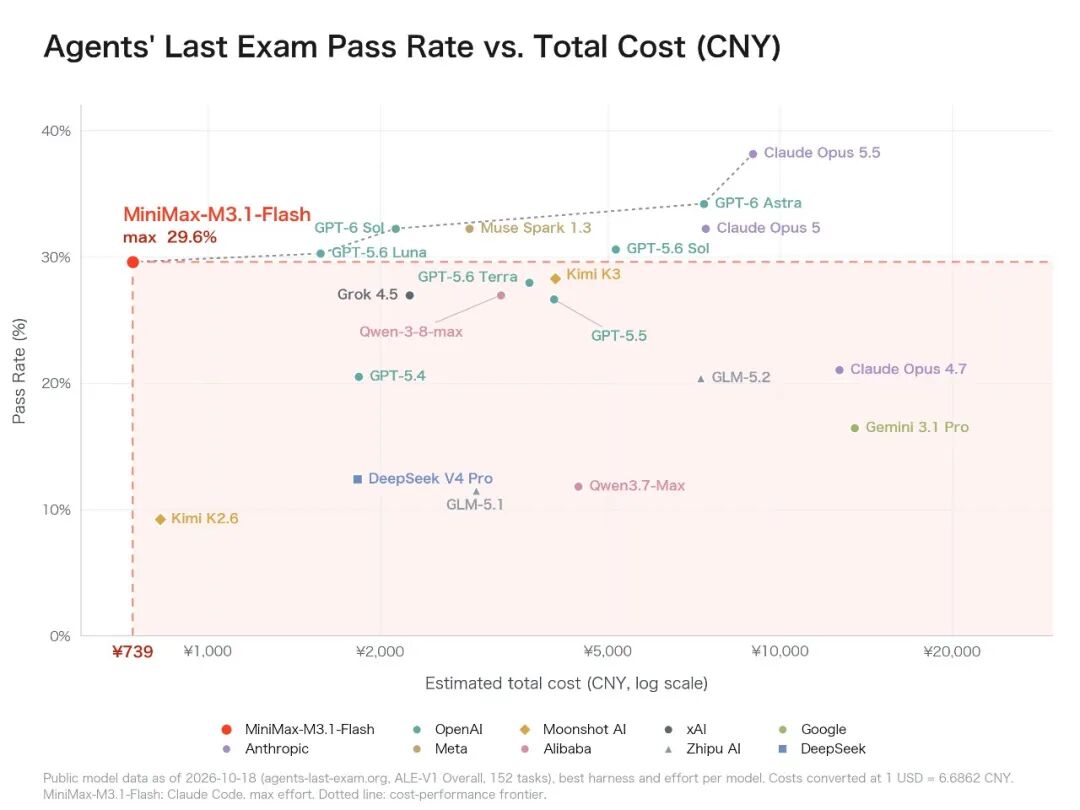
Bei komplexen Aufgaben und Automatisierung hat M3.1 Flash die Führung übernommen. Bei der Agents’ Last Exam, die langfristige, mehrstufige reale Aufgaben von Agenten bewertet, erzielte M3.1 Flash eine Bestehensquote von 29,6 % und Kosten von 739 Yuan, was im vordersten Bereich des Segments „niedrige Kosten – hohe Bestehensquote“ liegt und die Leistung weit über die von Modellen im gleichen Preissegment hinausgeht.
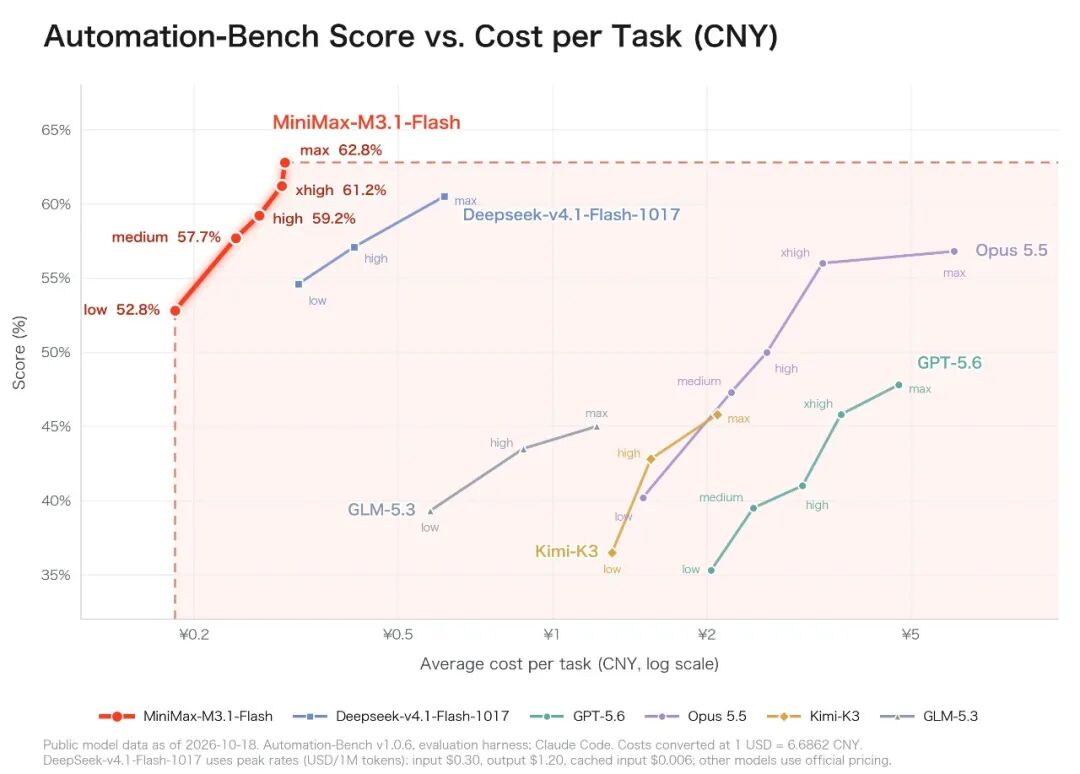
Bei Automation-Bench v1.0.6, das die app-übergreifende Automatisierung realer Geschäftsprozesse untersucht, erzielte M3.1 Flash 62,2 Punkte, übertraf die 60,5 Punkte von DeepSeek V4.1 Flash-1017 und ließ Opus 5 weit hinter sich.
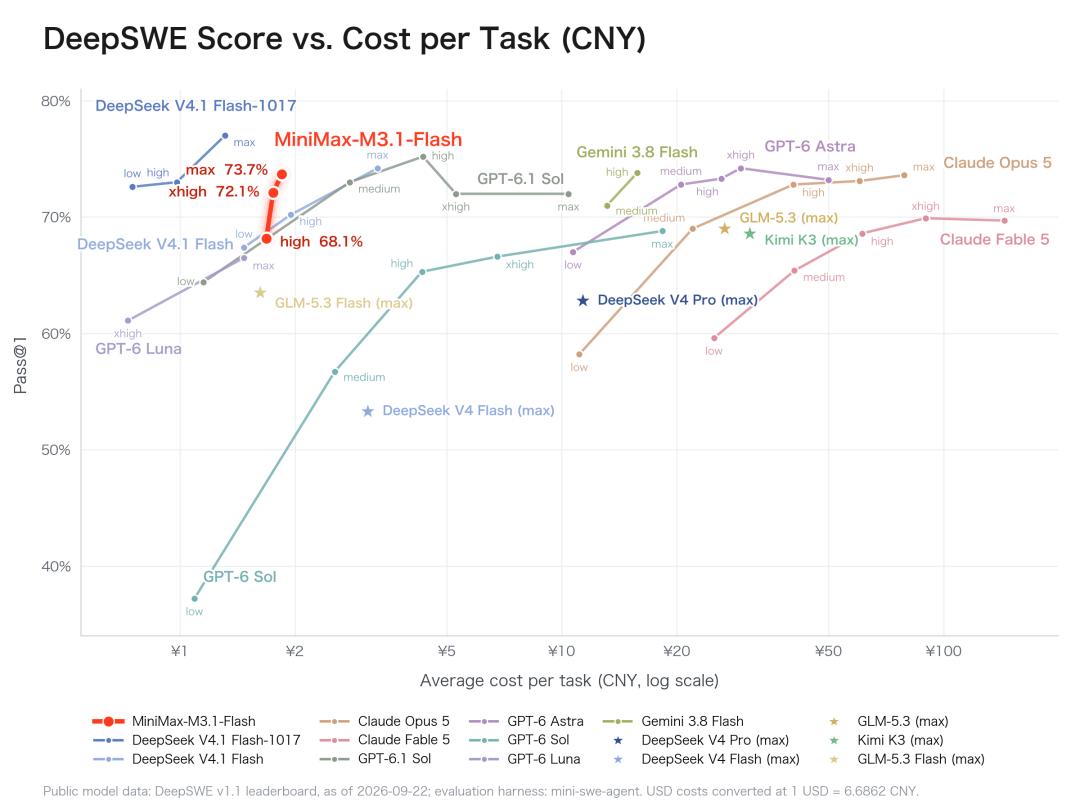
Im Programmierbereich haben M3.1 Flash und DeepSeek V4.1 Flash-1017 jeweils ihre eigenen Schwerpunkte. Beim DeepSWE v1.1-Test erzielte DeepSeek V4.1 Flash-1017 77,0 Punkte und belegte den ersten Platz. M3.1 Flash erzielte 73,7 Punkte und liegt nur 0,3 Punkte hinter Opus 5.
Beim Code-Reparaturtest SWE Refore Bench erzielte M3.1 Flash 23,0 Punkte, was mehr als das Doppelte des Ergebnisses von DeepSeek ist.
Auch im professionellen und Sicherheitsbereich gehört M3.1 Flash zur ersten Reihe. Bei BankerToolBench für Finanztoolaufrufe liegt es mit 76,2 Punkten gemeinsam mit Opus 5 auf Platz 1; beim Cybersicherheitstest CyberGym gehört es mit 82,2 Punkten gemeinsam mit GLM-5.3 zur ersten Reihe; beim akademischen Inferenztest HLE w/o Tools ohne Werkzeuge erzielte M3.1 Flash 43,4 Punkte, etwas höher als DeepSeek V4.1 Flash-1017.
Aus der Liste geht hervor, dass M3.1 Flash keineswegs ein „einseitig begabtes“ Modell ist. Seine Ergebnisse bei Agenten und Automatisierung haben sogar die branchenüblichen Flagship-Großmodelle übertroffen.
Die vollständige Liste lautet wie folgt:
02.
Veröffentlichungen im Abstand von 48 Stunden
DeepSeek und MiniSeek schaffen ein Muster mit zwei starken Konkurrenten
DeepSeek V4.1 Flash-1017 und M3.1 Flash, beide als Flash positioniert, wurden nacheinander innerhalb von zwei Tagen veröffentlicht, und ihre Benchmark-Ergebnisse sind so ähnlich, dass man natürlich ein völlig neues Muster sieht: Zwei starke Konkurrenten stehen nebeneinander.
DeepSeek V4.1 Flash verwendet eine dünnbesetzte MoE-Architektur mit insgesamt 552 Milliarden Parametern, aber bei der Inferenz werden nur 8 Milliarden Parameter für die Eingabe und 16 Milliarden Parameter für die Ausgabe aktiviert. Es übertrifft die Vorgänger-Pro-Version sowohl in Leistung als auch in Geschwindigkeit, aber die Preisgestaltung ist sehr niedrig. Die Veröffentlichung dieses Modells hat Entwicklern direkt die „Flagship-Fähigkeit“ des Flash-Modells gezeigt.
Entlang der Lücke, die DeepSeek aufgerissen hat, ist M3.1 Flash noch einen Schritt weiter gegangen.
Als sich M3.1 Flash noch in der anonymen Phase befand, belegte es innerhalb weniger Tage nach der Online-Stellung stetig den zweiten Platz in der Aufrufzahl-Liste von OpenCode und belegte zeitweise den ersten Platz bei OpenRouter.
Einige Nutzer haben Claude Opus 5, GPT-6 Sol und Gemini 3.8 Flash mit Space Bunny verglichen und mit der höchsten Denkstufe ein Raketenstartszenario erstellt. Der Nutzer sagte, dass Space Bunny nur drei Minuten gebraucht hat, das Endergebnis mit Opus 5 vergleichbar ist und die Geschwindigkeit sehr hoch ist.
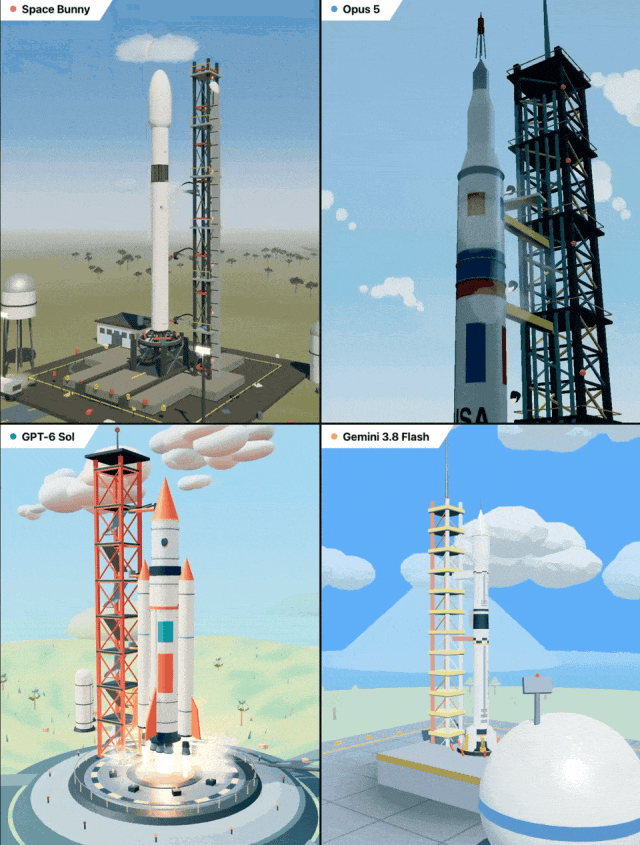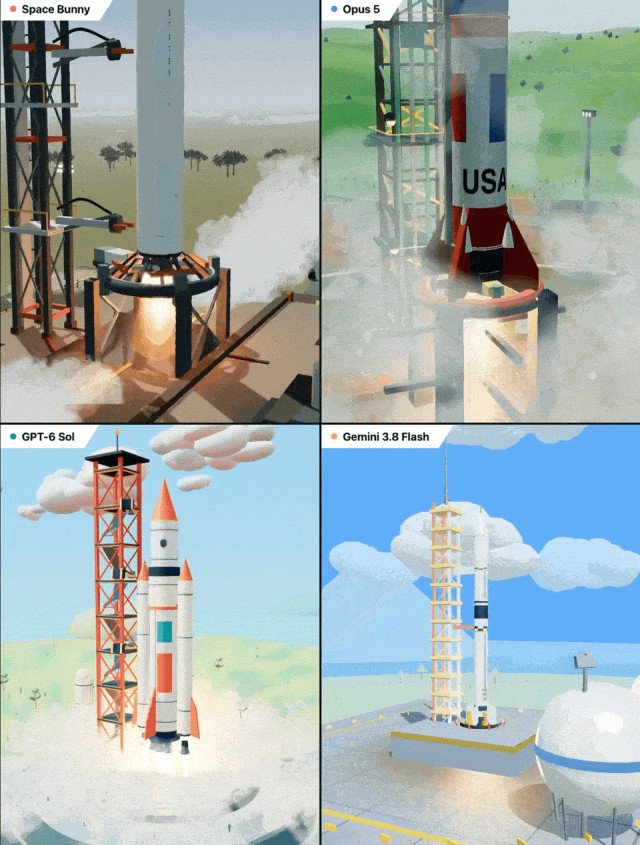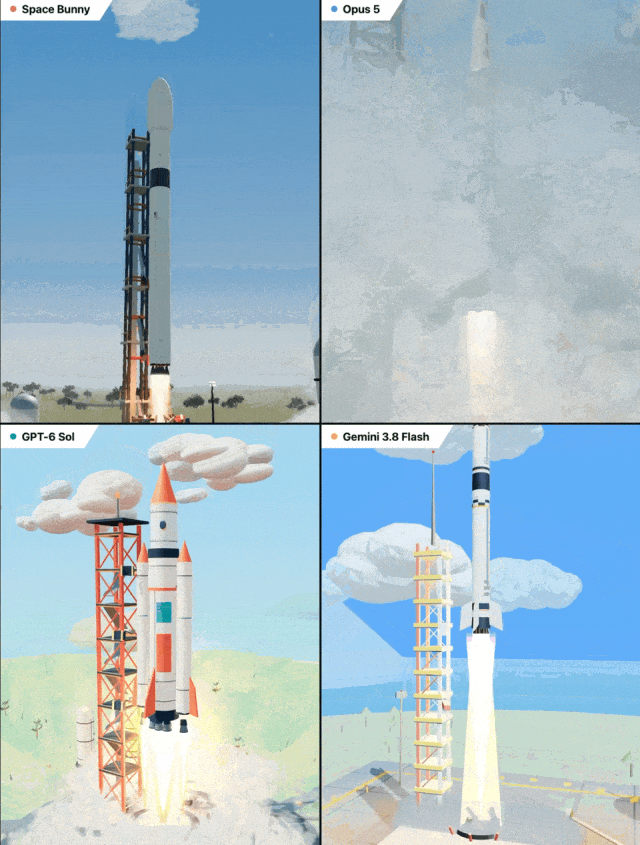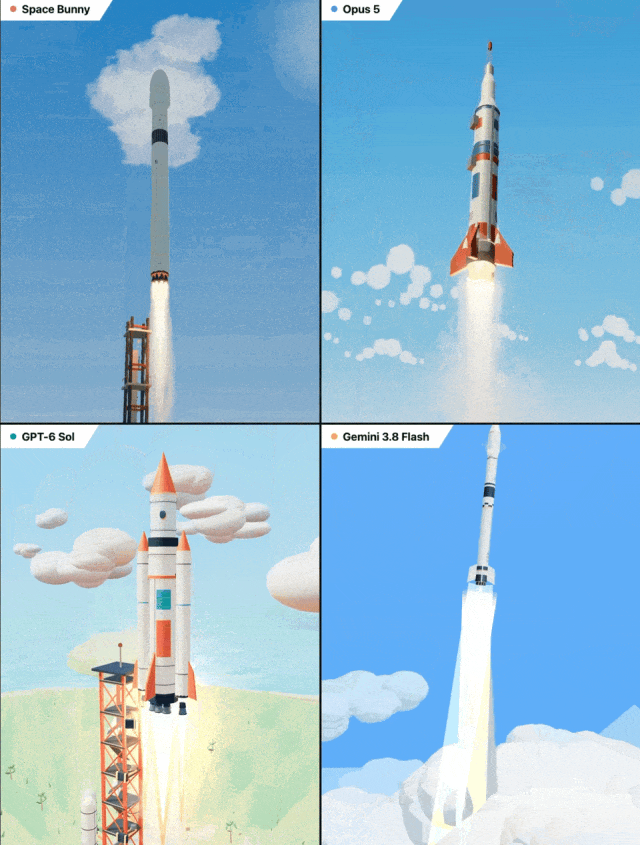
Zhidong hat es auch sofort getestet und ist der Meinung, dass die Wirkung dieses Modells direkt an GPT-6 Astra heranreicht (das mysteriöse Modell „Space Bunny“ ist beliebt, seine Wirkung reicht an GPT-6 Astra heran, 100.000 Menschen haben es beobachtet).
Die Reaktionsgeschwindigkeit von Space Bunny, die Entwickler während der anonymen Phase beeindruckt hat, wurde in der offiziellen Version vollständig beibehalten. Laut Angaben des MiniMax-Teams haben sie die Inferenzeffizienz von M3.1 Flash weiter optimiert und eine radikalere dünnbesetzte Aufmerksamkeitsarchitektur verwendet. In alltäglichen Nutzungsszenarien kann die Ausgabegeschwindigkeit mehr als 200 TPS (Tokens pro Sekunde) erreichen, und der Medianwert (P50) erreicht stabil mehr als 170 TPS.
Preislich liegt der Ein- und Ausgabepreis von M3.1 Flash bei etwa der Hälfte des Spitzenpreises von DeepSeek V4.1 Flash-1017 und entspricht dem Preis außerhalb der Spitzenzeiten.
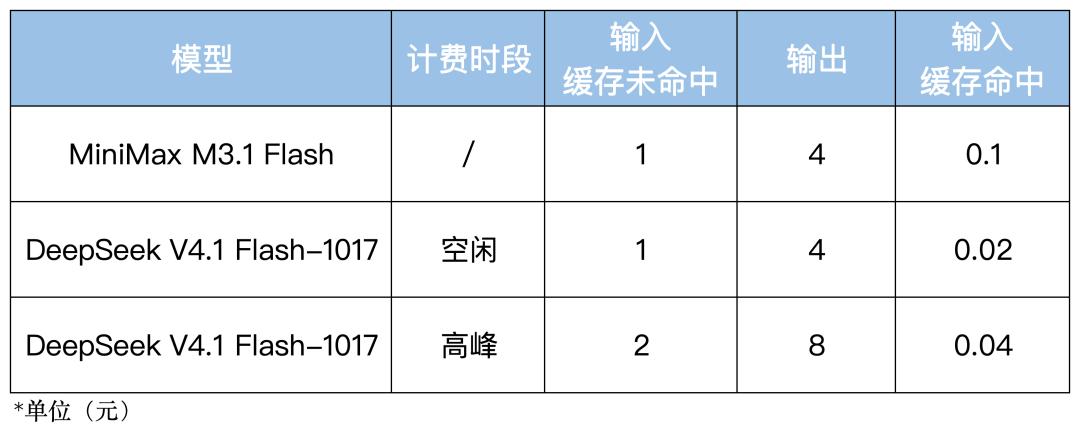
▲ Preisvergleich zwischen M3.1 Flash und DeepSeek V4.1 Flash-1017 (Tabelle erstellt von Zhidong)
Man kann sagen, dass diese beiden Modelle wie zwei Werkzeugsätze mit unterschiedlichen Schwerpunkten im Werkzeugkasten von Entwicklern sind, sodass Entwickler sie flexibel entsprechend den Aufgabenanforderungen einsetzen können.
Wenn beispielsweise die Effizienz der Codegenerierung und die Kontrolle der Cache-Kosten erforderlich sind, können Entwickler DeepSeek V4.1 Flash-1017 wählen; bei langfristigen Agent-Aufgaben, app-übergreifender Automatisierung oder multimodal getriebenen Entwicklungsprozessen kann M3.1 Flash die erste Option sein.
Bisher konzentrierte sich der Eindruck der Außenwelt von MiniMax möglicherweise hauptsächlich auf den multimodalen Bereich. Aber sowohl die Spitzenplätze in der Aufrufzahl während der anonymen Phase von Space Bunny als auch die Benchmark-Ergebnisse der offiziellen Veröffentlichung von M3.1 Flash beweisen die Wettbewerbsfähigkeit von MiniMax im Bereich von Agent und Automatisierung und lassen die Nutzer voller Erwartungen auf die Veröffentlichung des nachfolgenden Pro-Modells sein.
03.
Schlussfolgerung: Flash-Modelle sind auf dem Vormarsch und sind keine „Notlösung“ mehr
Die beiden Flash-Modelle von DeepSeek und MiniMax sind nacheinander auf den Markt gekommen und haben der Branche die Stärke von Flash-Modellen gezeigt.
Flash-Modelle reißen gerade das alte Etikett ab, dass man sie nur wählt, wenn das Budget nicht ausreicht. Aus den Benchmark-Ergebnissen geht hervor, dass sie bereits bei einigen Kernindikatoren in die Vergleichsreihe mit Flagship-Modellen aufgenommen werden können und gleichzeitig ihre inhärenten Vorteile bei Inferenzgeschwindigkeit und Kosten behalten.
Vom Preis-Leistungs-Verhältnis her sind Flash-Modelle möglicherweise die Modellart, die den realen Nutzungsszenarien am nächsten kommt. Bei inländischen Modellen hat sich erstmals ein Wettbewerbsmuster mit „zwei starken Konkurrenten“ aus DeepSeek und MiniMax gebildet.
Für Entwickler und Unternehmen gibt es im Modellwerkzeugkasten ab sofort eine weitere hochwertige Option, die nach Bedarf eingesetzt werden kann.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Zhidong“ (ID: zhidxcom), Autor: Wang Han, Redakteur: Mo Ying, veröffentlicht mit Genehmigung von 36Kr.