Das neue DeepSeek-Modell ist erschienen, und die Nutzer müssen wieder weniger Geld für die KI bezahlen.
Wenn die Grenze zwischen Leistung und Kosten neu definiert wird, tritt der Modellwettbewerb in eine neue algorithmische Phase ein.
Nach einem schwerwiegenden Ausfall ist die wahre Ursache des Systemstillstands nun aufgedeckt: Am 17. Oktober wurde DeepSeek V4.1 Flash-1017 offiziell vorgestellt.
Betrachtet man das Suffix des Modells, könnte man annehmen, dass es sich um ein kleines Minor-Update handelt – doch Thema und Richtung sind sehr klar: Die Nutzungskosten von KI sollen weiter gesenkt werden. Sogar etwas Unerwartetes ist passiert: DeepSeek hat selbst eine schematische Darstellung einer „Abschlussgrenze“ erstellt. Natürlich ist die ursprüngliche Absicht dieser Grafik nicht unbedingt, den Wettbewerb auszuschalten, sondern vielmehr zu verdeutlichen, wie niedrig die Nutzungskosten von KI nach diesem Modell-Update sind – und ob die Erfolgsrate des Modells nach der drastischen Kostensenkung stabil gehalten werden kann.
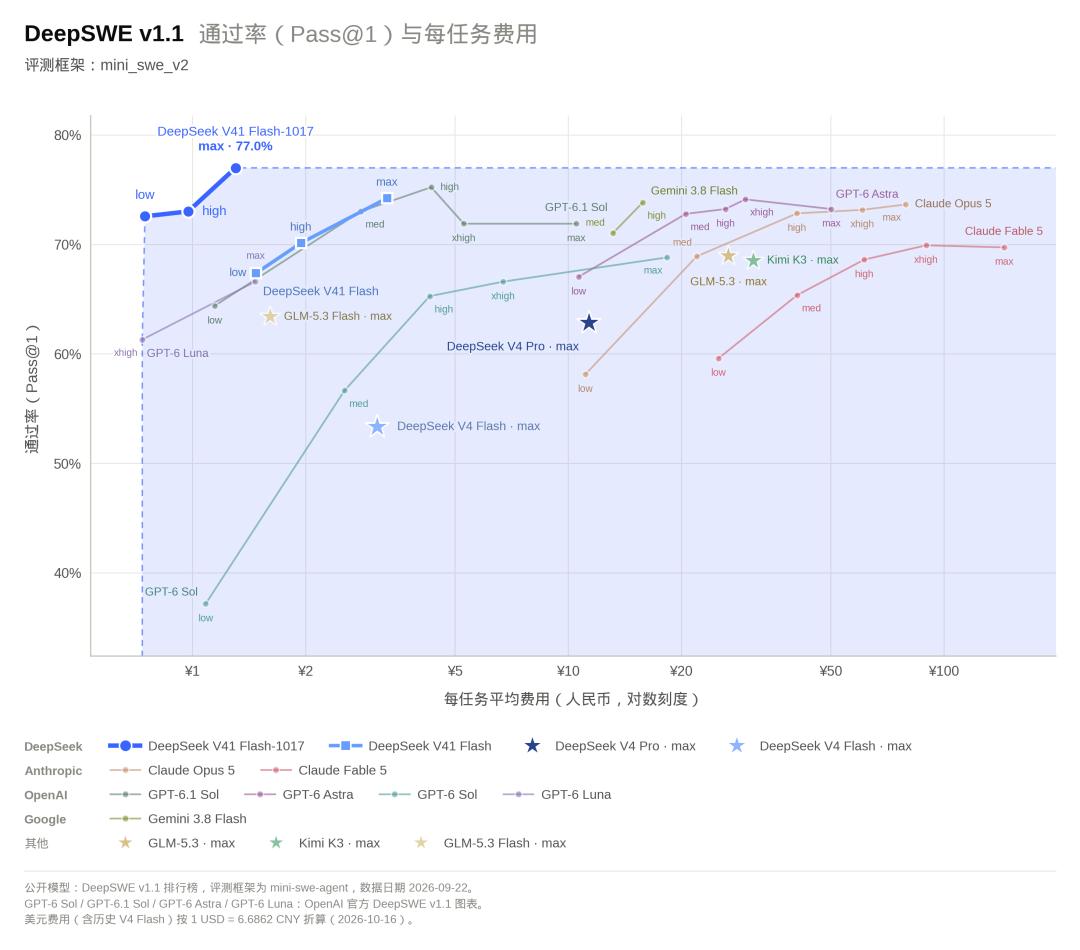
In dem von DeepSeek veröffentlichten Bewertungsdiagramm DeepSWE v1.1 erreicht die höchste Bestehensrate (Pass@1) der neuen Version 77,0 %. Im direkten Vergleich lag der Höchstwert der vorherigen Version DeepSeek V4.1 Flash bei etwa 74 %. Noch bemerkenswerter: Der Spitzenwert der neuen Version wird bei durchschnittlichen Kosten von etwa 1,3 Yuan pro Aufgabe erreicht – deutlich niedriger als bei vielen ausländischen Modellen mit ähnlicher Leistung im Diagramm.
Dies wirft auch eine Frage auf, die normale Nutzer betreffen sollte: Wenn Modelle bereits komplexe Programmieraufgaben bewältigen können, wie viel Intelligenz sind Nutzer bereit zu bezahlen?
Derzeit ist DeepSeek V4.1 Flash-1017 auf der offiziellen Webseite, in der App und über die API aktualisiert worden. Laut offiziellen Angaben verbessert die neue Version nicht nur die Leistung in mehreren Benchmarks, sondern verkürzt auch die Ausführungszeit von Aufgaben und die Ausgabelänge, und wurde zudem für Frameworks wie DeepSeek Harness, Tencent CodeBuddy und WorkBuddy optimiert. Bitte beachten Sie: Tencent ist der zweite auffällig genannte Partner im offiziellen Tweet von DeepSeek, der vorherige war Huawei.
Gleichzeitig öffnet DeepSeek die Search- und Fetch-APIs seines selbst entwickelten Suchmaschinensystems und integriert die Fähigkeiten zur Websuche und zum Webseiten-Scraping in das System von Tools, die Entwickler direkt aufrufen können.
Auf der einen Seite stehen günstigere und effizientere Aufgabenausführungen, auf der anderen Seite die Öffnung weiterer grundlegender Fähigkeiten nach außen. DeepSeek versucht, den Modellwettbewerb von einem reinen Wettbewerb um Leistungsfähigkeit zu einem umfassenderen Wettbewerb um Aufgabenlieferung und Kosten zu wandeln.
01
Wege finden, KI günstiger zu machen
In den letzten zwei Jahren hat sich die Branche der großen KI-Modelle daran gewöhnt, den Wettbewerb anhand von Ranglisten zu erklären.
Wer über stärkere Schlussfolgerungsfähigkeiten verfügt, wer höhere Punktzahlen im Programmieren erreicht und wer in Mathematik, Wissensabfragen oder Codetests vorne liegt – das bildet oft das auffälligste Narrativ bei der Veröffentlichung neuer Modelle. Parameterumfang, Trainingsdaten und Schlussfolgerungsfähigkeiten wurden dadurch zu den wichtigsten Maßstäben für den Fortschritt von Modellen.
Doch seit die Modelle in echte Softwareentwicklungsprozesse eintreten, reichen reine Punktzahlen nicht mehr aus.
Ein Modell, das Programmierfragen beantworten kann, und ein Programmier-Agent, der Anforderungen versteht, Tools aufruft, Code ändert, Tests ausführt und Fehler wiederholt behebt, sind praktisch zwei völlig unterschiedliche Produkte. Ersterer liefert hauptsächlich Antworten, Letzterer muss die Antworten in lieferbare Ergebnisse umwandeln.
Dadurch ändern sich auch die Kosten.
Was Nutzer kaufen, sind nicht mehr nur eine Reihe von Tokens, die das Modell generiert, sondern alle Ressourcen, die für die endgültige Erledigung einer Aufgabe verbraucht werden. Je länger das Modell nachdenkt, je häufiger es Tools aufruft und je öfter es nach einem Fehler neu versucht, desto schwieriger lässt sich die endgültige Rechnung allein über den Preis pro einzelnem Aufruf erklären.
Das von DeepSeek diesmal vorgestellte DeepSWE v1.1-Diagramm stellt genau diese Beziehung offen dar.
Die horizontale Achse des Diagramms zeigt die durchschnittlichen Kosten pro Aufgabe auf einer logarithmischen Skala; die vertikale Achse steht für Pass@1, also den Anteil der Aufgaben, die bei den gegebenen Bewertungsbedingungen in einem einzigen Versuch bestanden werden. Die verschiedenen Inferenzstufen unterschiedlicher Modelle sind im selben Koordinatensystem abgebildet, sodass Leistung und Preis direkt miteinander verglichen werden können.
Der Höchstwert von DeepSeek V4.1 Flash-1017 erreicht 77,0 %. Im Vergleich dazu liegt der Höchstwert der vorherigen Version DeepSeek V4.1 Flash bei etwa 74 %, der markierte Punkt von DeepSeek V4 Pro bei etwa 63 %.
Viele ausländische Modelle benötigen durchschnittliche Kosten von mehreren Dutzend Yuan oder mehr pro Aufgabe, um eine ähnliche Bestehensrate wie kostengünstigere Modelle zu erreichen. DeepSeek V4.1 Flash-1017 hingegen treibt die höchste Bestehensrate auf 77 %, während die Kosten in einem niedrigen Bereich gehalten werden.
Genau das ist der Punkt, der bei diesem Upgrade wirklich Aufmerksamkeit verdient.
Wenn ein Modell die Leistung nur von 70 % auf 72 % steigert, dafür aber die Inferenzkosten vervielfacht, lassen sich seine Vorteile nicht unbedingt in kommerzielle Vorteile umwandeln. Umgekehrt: Wenn ein Modell die Erfolgsrate steigern und gleichzeitig die Ausführungszeit und Ausgabelänge reduzieren kann, bringt das nicht nur eine Leistungsverbesserung, sondern auch eine Veränderung der Wirtschaftlichkeit pro Aufgabe.
Natürlich beweist dieses Diagramm nicht, dass DeepSeek bei allen Preisen, allen Aufgaben und allen Frameworks die Oberhand hat. Die Inferenzstufen, Ausführungsframeworks und Bewertungsbedingungen verschiedener Modelle beeinflussen alle das Ergebnis – das Diagramm zeigt nur das Leistungs-Kosten-Verhältnis in bestimmten Tests.
Aber DeepSeek hat die Branche mit einer Frage konfrontiert: Wenn eine höhere Aufgaben-Erfolgsrate zu niedrigeren Kosten erreicht werden kann, was müssen die Modelle, die ihre Wettbewerbsfähigkeit über höhere Preise aufrechterhalten, vorweisen, um ihren Preisaufschlag zu rechtfertigen?
02
Der echte Prüfstein ist nicht das Schreiben von Code, sondern die Lieferung von Projekten
Wenn die Bestehensrate von 77 % den Fortschritt des Modells in bestimmten Tests beweist, dann versuchen die von DeepSeek diesmal vorgestellten Projektbeispiele zu verdeutlichen, wohin dieser Fortschritt führen kann.
In den offiziell veröffentlichten Beispielen hat DeepSeek V4.1 Flash-1017 über DeepSeek Harness die 3D-Modellierung der Verbotenen Stadt, ein webbasiertes Rennspiel, eine Nachbildung des Spiels „Portal 2“ auf Basis der Godot-Engine sowie ein Projekt realisiert, das die historische Entwicklung dynamisch in 3D-Szenen darstellt.
Diese Beispiele haben eines gemeinsam: Die Nutzer stellen keine klar abgegrenzte Programmieraufgabe, sondern ein vollständiges Projekt, das von Grund auf neu erstellt werden muss.
Nehmen wir die Spieleentwicklung als Beispiel: Das Modell muss die Anforderungen verstehen, Szenen und Interaktionslogik strukturieren, Code generieren und dann Probleme durch Ausführen und Debuggen schrittweise beheben. Ein scheinbar einfaches Spiel kann hinter den Kulissen Kollisionserkennung, physikalische Bewegungen, Kamerasteuerung, Level-Design und Nutzerinteraktion umfassen. 3D-Modellierungsprojekte müssen zusätzlich räumliche Strukturen, Materialien, Beleuchtung und Szenenorganisation verarbeiten.
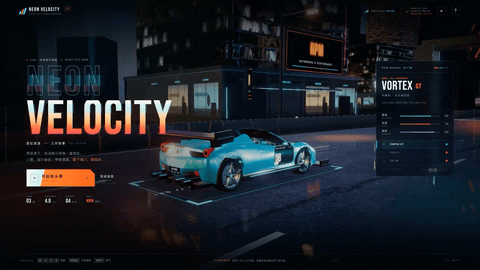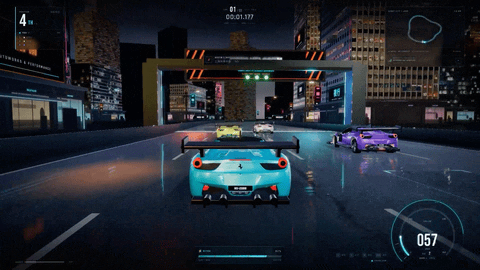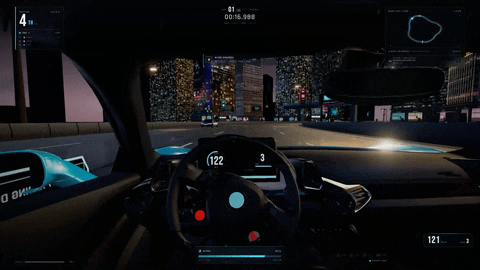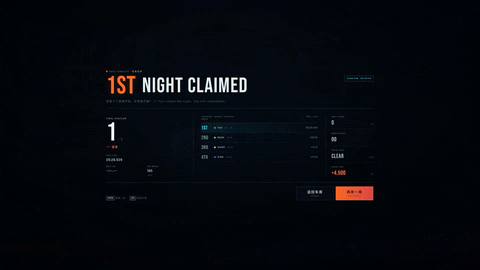
Abbildung | DeepSeek-Beispiel: Entwicklungsergebnis des webbasierten Rennspiels
Solche Aufgaben lassen sich kaum in nur einem einzigen Generierungsschritt abschließen.
Was Nutzer wirklich wollen, ist in der Regel nicht nur ein schöner Code-Abschnitt, sondern ein funktionierendes, interaktives und weiter modifizierbares Werk.
DeepSeek gibt an, dass die neue Version durch Training mit verstärkendem Lernen auf Basis von Selbstfeedback die Fähigkeit verbessert hat, vollständige Projekte von Grund auf in Bereichen wie Spieleentwicklung und 3D-Modellierung zu erstellen, sodass das Modell mehr „Wunschprogrammierung“ genannte Anforderungen verarbeiten kann.
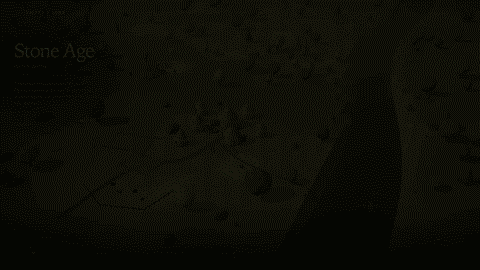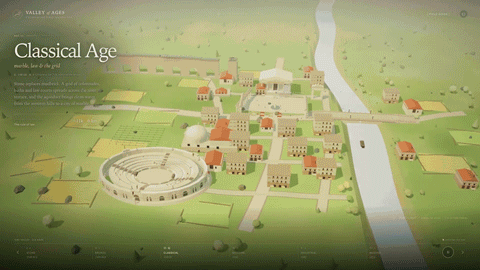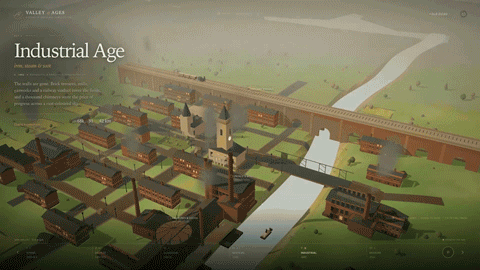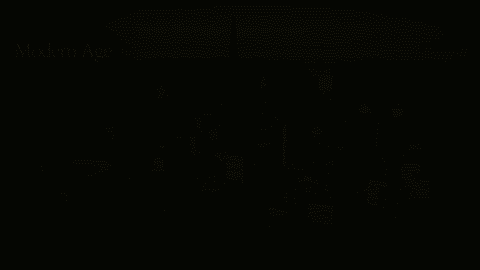
Abbildung | DeepSeek-Beispiel: Valley of Ages – Darstellung der Entwicklungsgeschichte von der Urgeschichte bis zur Moderne in dynamischen 3D-Szenen
Die sogenannte „Wunschprogrammierung“ bedeutet nicht, dass Nutzer keine Anforderungen mehr ausdrücken müssen, und schon gar nicht, dass komplexe Software vollständig von technischen Einschränkungen befreit werden kann. Sie zeigt einen Wandel der Interaktionsweise: Nutzer müssen nicht im Vorfeld jedes technische Detail beherrschen, sondern können zuerst das gewünschte Ergebnis beschreiben und dann das Modell einen Großteil der Zwischenschritte von der Anforderung bis zur Umsetzung übernehmen lassen.
Früher mussten Nutzer wissen, wie man Code schreibt – heute können Nutzer zuerst beschreiben, was sie umsetzen wollen.
Der Abstand zwischen diesen beiden Szenarien bestimmt, wie groß die Nutzerzahl sein kann, für die KI-Programmierwerkzeuge zugänglich sind.
Das ist auch der Grund, warum Harness zu einem wichtigen Bestandteil des Wettbewerbs wird.
Das Modell selbst liefert Inferenz- und Generierungsfähigkeiten, während Harness das Modell in eine Umgebung einbettet, in der es kontinuierlich arbeiten kann: Aufgaben organisieren, Tools aufrufen, Kontext verwalten, Code ausführen, Ergebnisse auslesen und nach Fehlern weitere Versuche starten. Die Fähigkeit des Modells bestimmt, ob es Probleme lösen kann – das Ausführungsframework beeinflusst, ob es Probleme auf stabile und kontrollierbare Weise lösen kann.
Das ist kein Thema, das nur DeepSeek betrifft. Da Programmier-Agenten von der Code-Vervollständigung zur Projektentwicklung übergehen, wird die Zusammenarbeit zwischen Modell und Toolchain zu einem wichtigen Bestandteil der Produktfähigkeit.
DeepSeek hat diesmal ausdrücklich die Optimierung von Frameworks wie DeepSeek Harness, Tencent CodeBuddy und WorkBuddy erwähnt und empfiehlt Nutzern, auf DeepSeek Harness Version 0.2.1-rc.1 oder höher zu aktualisieren, um die optimale Erfahrung mit dem neuen Modell zu erhalten.
Das bedeutet, dass der Fortschritt des Modells nicht nur auf Ebene der Parameter oder Trainingsmethoden stattfindet, sondern auch in der Verbindung zur externen Softwareumgebung.
03
Vom Modellpreis zur Gebühr für Werkzeuge: DeepSeek fügt ein weiteres Puzzleteil hinzu
Bei diesem Update gibt es eine Maßnahme, die leicht von den Programmierbeispielen verdeckt wird: DeepSeek öffnet seine selbst entwickelte Such-API.
Laut offiziellen Angaben stellt die DeepSeek-Suchmaschine seit langem Suchfähigkeiten für ihre Web- und API-Plattformen bereit und kann eine große Anzahl von Suchanfragen aus der ganzen Welt verarbeiten. Die diesmal geöffneten Search- und Fetch-Schnittstellen dienen jeweils zum Abrufen von Webseiten und zum Scrapen von Inhalten bestimmter Webseiten, sodass Entwickler die entsprechenden Fähigkeiten direkt in ihren eigenen Anwendungen und Agenten aufrufen können.
Der Preis für beide Schnittstellen beträgt 5 Yuan pro 1000 erfolgreiche Anfragen. Gleichzeitig wird in der offiziellen Dokumentation erläutert, dass die Abrechnung nur erfolgt, wenn die Anfrage erfolgreich ist und ein gültiges Ergebnis liefert. Die kostenlose Nutzung der Suchfähigkeiten über Tools wie Claude Code und Codex wird nach einer von der Behörde festgelegten zweiwöchigen Übergangsfrist auf ein kostenpflichtiges Modell umgestellt.
Oberflächlich betrachtet ist dies eine Erweiterung der API-Produktlinie – im Kontext des gesamten Updates hat sie noch eine weitere Bedeutung.
Um eine echte Aufgabe zu erledigen, benötigen Agenten oft nicht nur ein ausreichend intelligentes Modell. Sie müssen auch externe Informationen abrufen, Webseiten lesen, Softwaretools aufrufen und all diese Schritte zu einem kontinuierlichen Workflow organisieren.
Da Modelle zunehmend komplexere Aufgaben übernehmen, sind Suche, Scraping und Toolaufruf keine bloßen Zusatzfunktionen mehr, sondern wichtige Infrastrukturen, die darüber entscheiden, ob eine Aufgabe abgeschlossen werden kann.
In der Vergangenheit haben Modellanbieter ihr Geschäftsmodell leichter auf Tokens aufgebaut: Nach Eingabe- und Ausgabemenge wird pro Aufruf abgerechnet. Da Agenten in komplexere Workflows eintreten, wird die Kostenstruktur vielfältiger. Modellinferenz, Suche, Webseiten-Scraping, Codeausführung und wiederholte Überprüfungen können alle zu Bestandteilen der Kosten einer Aufgabe werden.
Dass DeepSeek Search und Fetch für Entwickler öffnet, bedeutet, dass seine Fähigkeiten nun aus dem internen Bereich der eigenen Produkte zu externen Anwendungen gelangen. Entwickler können diese Schnittstellen in ihre eigenen Agentensysteme integrieren, ohne vollständig auf Drittanbieter-Suchdienste angewiesen zu sein.
Aber das Öffnen von Schnittstellen bedeutet nicht, dass bereits ein vollständiges kommerzielles Ökosystem aufgebaut ist. Die Stabilität der Schnittstellen, die Qualität der Suchergebnisse, Aufrufbeschränkungen, der Umfang der Nutzung durch Entwickler und die Effizienz der Zusammenarbeit zwischen diesen Tools und dem Modell beeinflussen letztendlich, ob daraus ein nachhaltiges Geschäft werden kann.
Besonders bemerkenswert ist, dass DeepSeek diesmal gleichzeitig die Relevanz, Autorität und Aktualität der Suchergebnisse hervorhebt, sowie die Erkennung und Filterung von SEO-Betrug, GEO-Manipulation und minderwertigen, per KI generierten Inhalten.
Aus dieser Perspektive bearbeitet DeepSeek verschiedene Teile derselben Aufgabe: Auf der einen Seite wird die Fähigkeit des Modells verbessert, Aufgaben zu erledigen, auf der anderen Seite die