Shunwei Capital hat in einen Principal Investigator der Peking-Universität investiert und will das menschliche Gehirn mit KI „entschlüsseln“.
Das menschliche Gehirn entsteht aus dem allumfassenden digitalen Raum (Quelle: LattixOrigin)
Text von HU Xiangyun
Redaktion: HAI Ruojing
Das menschliche Gehirn ist eines der komplexesten Systeme, die sich in der Natur entwickelt haben.
Das Gehirn eines Erwachsenen hat nur die Größe von zwei geballten Fäusten, beherbergt aber fast 86 Milliarden Neuronen und eine gleich große Anzahl nicht neuronaler Zellen. Diese sind miteinander verbunden, bilden ein riesiges und kompliziertes Gehirnnetzwerk und tragen die gesamte Intelligenz, Emotionen, Erinnerungen und das Selbstbewusstsein des Menschen. Dieses System ist so raffiniert, dass das größte Paradoxon des menschlichen Gehirns darin besteht, dass unser Gehirn nicht schlau genug ist, um ein so schlaues Gehirn zu verstehen.
Kann KI das also besser machen?
Das ist das, was Lu Meng in den letzten 15 Jahren ständig erreichen wollte. Seit er 2011 zur Promotion an die Universität Cambridge ging, bis er vor seiner Rückkehr nach China im Jahr 2024 als leitender Forscher tätig war, hat sich Lu Meng stets der Forschung zu neurodegenerativen Erkrankungen gewidmet. Nach dem traditionellen Forschungsparadigma der Neurowissenschaften hat er zahlreiche Zellmodelle und Analysealgorithmen entwickelt, um die Wirkmechanismen von Gehirnerkrankungen und Medikamenten auf molekularer und zellulärer Ebene zu analysieren; er hat auch Bildgebungstechnologien eingesetzt, um Veränderungen der inneren Zellstruktur während des Krankheitsverlaufs oder nach der Medikamentenverabreichung zu verfolgen.
Doch dann wurde ihm klar, dass diese Art von Forschung wie das Halten einer Stickerei-Nadel ist: Sie kann nur auf einen sehr kleinen mikroskopischen Maßstab abzielen, es ist schwierig, das Gesamtbild des menschlichen Gehirns zu erkennen, geschweige denn den vollständigen Prozess der Entstehung und Ausbreitung von Krankheiten wiederherzustellen.
Aus dieser Erkenntnis entwickelte Lu Meng eine Idee: Wenn man die mehrskaligen Informationen von Molekülen, Zellen, Hirnregionen bis hin zum gesamten Gehirn schicht für Schritt verbinden könnte, ließe sich vielleicht ein „Forschungssystem zum vollständigen Verständnis des Gehirns“ aufbauen.
Dafür sind riesige Datenmengen und große Rechenleistung erforderlich. Deshalb versuchte Lu Meng um 2017 herum, KI in die neurowissenschaftliche Forschung einzuführen. Damals befand sich die KI-Fähigkeit jedoch noch im Stadium des maschinellen Sehens und konnte die überskalige Modellierung des menschlichen Gehirns kaum unterstützen.
Erst nach dem Aufkommen der großen Sprachmodelle stellte Lu Meng erfreut fest, dass „der Selbstaufmerksamkeitsmechanismus von Transformer stark mit biologischen Informationen übereinstimmt“. „Wenn wir Zellen mit langen Sätzen vergleichen, ist jedes Gen ein Wort, die Umgebung der Zelle ist der Kontext, und der Kontext bestimmt das Niveau der Genexpression und den Zustand der Zelle im Gewebe. Die Grundprinzipien großer Modelle und biologischer Informationen stimmen überein, was eine technische Chance für den Aufbau eines überskaligen Modells des menschlichen Gehirns schafft.“
Also hat er nach seiner Rückkehr an die Peking-Universität als Assistenzprofessor im Jahr 2024 diese Arbeit offiziell gestartet und als Chefwissenschaftler des AI4S-Unternehmens LattixOrigin fungiert.
36Kr hat exklusiv erfahren, dass LattixOrigin kürzlich eine Seed-Finanzierungsrunde von fast 10 Millionen US-Dollar abgeschlossen hat. Zu den Investoren zählen Shunwei Capital, Yunmu Capital, Xirius und Zhongguancun Capital. Die in dieser Runde gesammelten Mittel werden für den Aufbau eines geschlossenen Validierungskreislaufs für nasse und trockene Experimente, den Erwerb von Rechenleistung und den Aufbau eines Teams verwendet.
Lu Meng gibt offen zu, dass es mit den Ressourcen eines Universitätslabors kaum möglich ist, diese große Vorstellung der überskaligen Analyse des menschlichen Gehirns umzusetzen. In der heutigen Zeit, in der KI alles schnell erfasst, steigen die Kosten für Rechenleistung und hochkarätige interdisziplinäre Fachkräfte stetig; für das Training von Modellen und den Aufbau des geschlossenen Kreislaufs von nassen und trockenen Experimenten sind in jedem Schritt kontinuierliche Kapitalinvestitionen erforderlich. Das ist auch ein wichtiger Grund, warum er sich dafür entschieden hat, externe Mittel aufzunehmen.
Nach Ansicht von Lu Meng verändert sich die Beziehung zwischen KI und Biologie grundlegend. In der traditionellen biologischen Forschung wird KI meist als Werkzeug betrachtet, das in die bestehenden Abläufe der biologischen Forschung eingebettet wird. Die Hypothese der Forscher ist Ausgangs- und Endpunkt zugleich, und die erkundbaren Wege sind begrenzt.
Was er jedoch tun möchte, ist „die biologische Forschung aus der Perspektive der KI neu zu organisieren“. Zuerst gibt es qualitativ hochwertige, standardisierte Daten, dann lässt das Modell die grundlegenden Regeln aus riesigen Informationsmengen lernen, anstatt die subjektiven Vorgaben des Menschen dem Modell aufzuzwingen.
Es wird berichtet, dass das Team von LattixOrigin das erste Grundmodell des menschlichen Gehirns DigitalBrain-M1 trainiert hat, das bei der Funktionsanalyse einiger Hirnregionen stark mit der Radiomik übereinstimmt.
Mit der nachfolgenden Iteration des Modells hofft Lu Meng, dass die DigitalBrain-Serie als „GPT“ des menschlichen Gehirns fungieren kann: Wenn Forscher Medikamente gegen Gehirnerkrankungen entwickeln, können sie auf diesem System basierend schnell Zielstrukturen finden, Mechanismen analysieren und den optimalen Weg zur Krankheitsintervention ermitteln; darüber hinaus könnte es sogar dem Menschen helfen, die Intelligenz selbst zu verstehen.
All dies wird kleine Schritte auf dem langen Weg sein, um den „heiligen Gral der Wissenschaft“ des menschlichen Gehirns zu erobern.
Gespräch (redigiert):
80 Millionen Gehirnzellen trainieren, um eine „Google Maps für das menschliche Gehirn“ zu zeichnen
36Kr: Können Sie zuerst ein Szenario beschreiben, welche Veränderungen das Modell den Forschern bei der Entwicklung neuer Medikamente bringen wird, wenn es in Zukunft die von Ihnen erwartete „Fähigkeit zum überskaligen Schlussfolgern“ besitzt?
Lu Meng: Im Vergleich zum traditionellen Forschungsmodell kann das Modell Forschern helfen, Krankheitszielstrukturen schneller zu entdecken und Mechanismen zu analysieren; darüber hinaus kann es vorhersagen, welche biologischen Effekte nach der Störung der Zielstruktur entstehen, sodass man krankheitsverursachende Gene genauer findet, wirksame Zielstrukturen entdeckt und Krankheiten früher interveniert.
Nehmen Sie die Alzheimer-Krankheit als Beispiel: Bei der traditionellen Entwicklung von Medikamenten gegen die Alzheimer-Krankheit konzentrieren sich die Zielstrukturen meist auf Ablagerungen von β-Amyloid, da dies das offensichtlichste pathologische Merkmal im Gehirn von Patienten ist. Wenn jedoch die Ablagerungen von β-Amyloid auftreten, hat das Gehirn in der Regel bereits erhebliche Schäden erlitten. Selbst wenn man die Ablagerungen in diesem Stadium beseitigt, lassen sich kognitive Schäden kaum reparieren. Im Idealfall sollte die Intervention stattfinden, bevor eindeutige pathologische Marker auftauchen, um zu verhindern, dass die Krankheit in ein irreversibles Stadium eintritt.
Wenn wir ein vollmodales, mehrskaliges Modell des menschlichen Gehirns besitzen, könnten wir vielleicht den vollständigen Krankheitsverlauf der Alzheimer-Krankheit nachvollziehen: Aus welchen Hirnregionen beginnt die Krankheit und wie breitet sie sich auf andere Hirnregionen aus? Wie entwickelt sich der gesamte Krankheitsverlauf und wann ist der Schwellenwert für die Intervention? Das könnte uns helfen, einen früheren Interventionspunkt zu finden, um die Krankheit zu stoppen, bevor sie in ein irreversibles Stadium eintritt. Sein Wert ist grundlegend.
36Kr: Sie sind 2024 an die Peking-Universität eingetreten. Aber bevor Sie mit der Entwicklung der DigitalBrain-Serie begonnen haben, haben Sie mehr als zwei Jahre damit verbracht, Datensätze zu optimieren. Warum haben Sie diese „harte Arbeit“ geleistet?
Lu Meng: Das zentrale Hindernis bei der Entwicklung von Medikamenten gegen Gehirnerkrankungen besteht darin, dass das Modell nicht mit dem echten menschlichen Gehirn übereinstimmt. Bei traditionellen Methoden vermuten Wissenschaftler Veränderungen im menschlichen Gehirn hauptsächlich durch Tierversuche, aber die physiologischen Systeme der beiden unterscheiden sich stark, sodass viele Zielstrukturen, die bei Tieren wirksam sind, am menschlichen Körper unwirksam werden. Mäuse erkranken beispielsweise nicht spontan an der Alzheimer-Krankheit; selbst wenn man krankheitsverursachende Gene künstlich überträgt, lassen sich nur einige Symptome nachahmen.
Wir sind der Meinung: Um die Hirnforschung besser durchzuführen und Medikamente gegen Gehirnerkrankungen zu entwickeln, müssen wir echte Daten des menschlichen Gehirns als grundlegende Stütze verwenden, um ein Grundmodell des menschlichen Gehirns zu erstellen.
In der Anfangsphase haben wir den Schwierigkeitsgrad des Projekts etwas unterschätzt. Die Voraussetzung für den Aufbau eines qualitativ hochwertigen Modells sind hochwertige Daten. Aber im Bereich der Hirnforschung können Forscher keine menschlichen Gehirnproben in großem Maßstab sammeln wie bei Tierversuchen, sondern erhalten sie meist nur aus Krankenhäusern. Das führt dazu, dass die weltweit veröffentlichten Daten zur Forschung am menschlichen Gehirn sehr verstreut, die Gesamtmenge begrenzt und es an einheitlichen Qualitätskontroll- und Markierungsstandards fehlt. Das ist nicht förderlich für das Training von Modellen.
Deshalb haben wir beschlossen, mit dem Aufbau von Datensätzen zu beginnen, um darauf aufbauend ein Grundmodell des menschlichen Gehirns zu trainieren, das die überskalige Repräsentation abschließen kann.
36Kr: Was ist die Hauptquelle der Originaldaten? Gibt es exklusive selbst gesammelte Daten?
Lu Meng: Um ehrlich zu sein, war die Kooperationsgrundlage des Teams mit inländischen Krankenhäusern in der Anfangsphase relativ schwach, und wir haben hauptsächlich veröffentlichte Forschungsdaten verwendet.
Wir haben mehr als 200 Forschungsprojekte integriert, darunter das transnationale gemeinsame Forschungsprojekt BICCN (Brain Cell Census Network). Die Gesamtmenge aller Originaldaten umfasst fast 100 Millionen menschliche Gehirnzellen, was weltweit zu den Spitzenwerten gehört. Im Vergleich dazu betrug die Datenmenge der Kernforschungsarbeit, die BICCN 2023 in „Science“ veröffentlicht hat, 3,3 Millionen, und der größte Datensatz des menschlichen Gehirns des renommierten Hirnforschungsinstituts Allen Institute, SEA-AD (2026), beträgt 6 Millionen.
Darüber hinaus sind unsere Datentypen sehr vielfältig, umfassen mehr als 4000 Spender mit einem Altersbereich von 0 bis 96 Jahren, decken 165 Hirnregionen im gesamten Gehirn ab und alle Zelltypen wie Neuronen, Gliazellen und Gefäßzellen.
Diese Größenordnung und Vielfalt reichen aus, um zuerst das erste Grundmodell des menschlichen Gehirns DigitalBrain-M1 zu trainieren und die gemeinsamen grundlegenden Mechanismen und Einschränkungen des menschlichen Gehirns zu erforschen. Später planen wir, die Zusammenarbeit mit medizinischen Einrichtungen wie führenden Krankenhäusern im In- und Ausland voranzutreiben, um weitere charakteristische Daten wie Daten zum chinesischen menschlichen Gehirn zu ergänzen.
36Kr: Wenn alle Kerndatenquellen öffentlich sind, worin liegt der Hauptwert Ihrer großen Anstrengungen für diese Arbeit?
Lu Meng: Die einfache Sammlung und Zusammenfassung von Daten hat tatsächlich eine niedrige Eintrittsschwelle.
Aber wir haben eine professionelle „Verfeinerung“ der Daten durchgeführt. Wir haben uns am Markierungssystem des „Goldstandards“ des Allen Institute orientiert, alle Forschungen einheitlich von Chargen befreit, Rauschen reduziert, Metainformationen ergänzt und sie im selben Repräsentationsraum ausgerichtet. So haben wir einen standardisierten Datensatz des menschlichen Gehirns erzeugt, der für KI bereit ist, und eine Trainingsgrundlage gebildet.
Gleichzeitig haben wir eine einzigartige Gen-Suchfunktion entwickelt. Früher konnten Forscher nur die Expression eines bestimmten Gens in lokalen Hirnregionen verstehen, mussten zuerst die ursprünglichen Schnittbilder oder Expressionsmatrizen finden und dann selbst Code schreiben, um sie zu verarbeiten. Das dauerte lange und die Schlussfolgerungen waren nicht unbedingt klar. In unserem System können Nutzer wie bei einer Fahrsuchsoftware direkt die genaue Expression beliebiger Gene in allen Hirnregionen und allen Zelltypen des gesamten Gehirns abfragen. Außerdem können sie Bedingungen für Krankheit und Alter auswählen. Die Abdeckung und Genauigkeit der Daten von DigitalBrain-Atlas gehören in der Branche zu den Spitzenwerten.
Das ist wie das Erstellen einer Google Maps für das menschliche Gehirn, um die Koordinaten von Genen genau zu kennen. Das ist von großer Bedeutung für die Erforschung des menschlichen Gehirns, die Lokalisierung krankheitsverursachender Gene bei Gehirnerkrankungen, die Entdeckung verwandter Medikamentenziele und sogar die Forschung zu Gehirn-Computer-Schnittstellen. Derzeit haben wir die standardisierten Daten von fast 17 Millionen Zellen als Open Source bereitgestellt, sodass Forscher auf der ganzen Welt sie kostenlos abfragen und nutzen können.
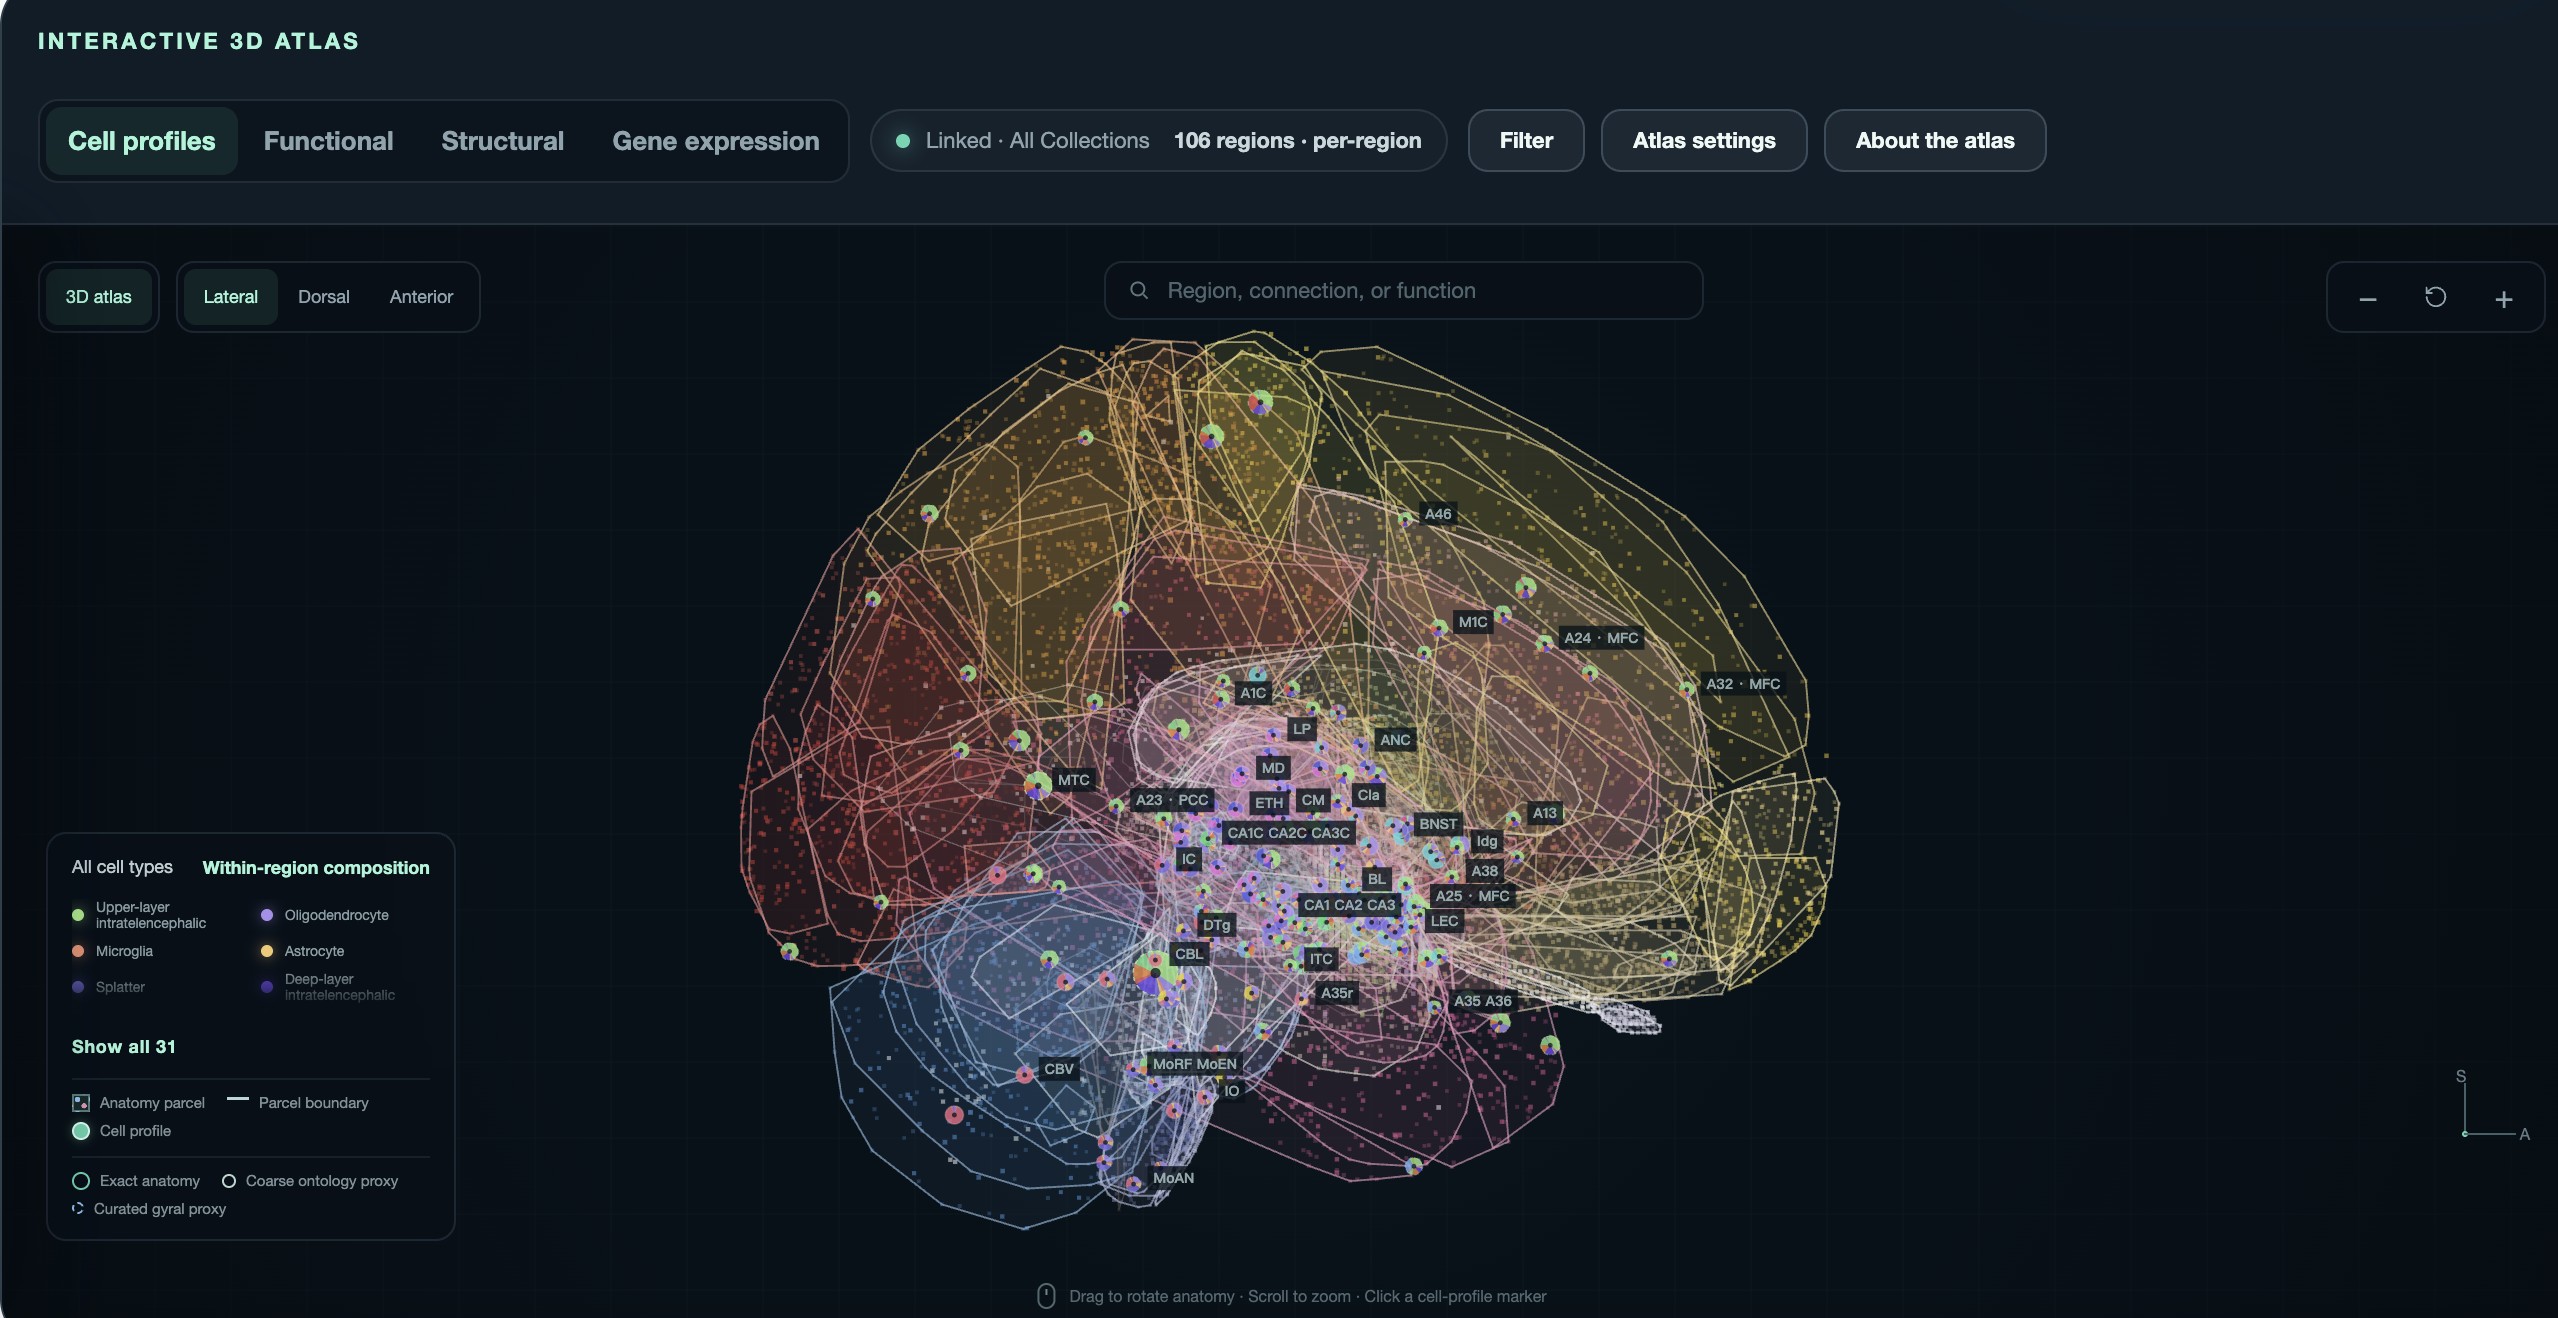
Quelle: LattixOrigin DigitalBrain-Atlas (https://digitalbrain-human.com/)
36Kr: Was ist die größte Schwierigkeit bei der „Standardisierung“ aller Forschungen?
Lu Meng: Der aufwändige Teil besteht darin, jeden Datensatz einzeln zu überprüfen. Obwohl automatisierte Batch-Verarbeitungsalgorithmen diese Aufgabe auch erledigen können, lösen sie nicht alle Probleme. Beispielsweise gibt es Probleme wie nicht übereinstimmende Dateinamen und interne Daten, doppelte Markierungen und falsche Markierungen in einigen Datensätzen. Die Fehlerquelle in riesigen Datenmengen zu lokalisieren, ist wie die Suche nach einem fehlerhaften Teil unter Tausenden von Bauteilen.