Die Comeback-Geschichte von Tibos Codex: Weniger als ein Jahr nach der Übernahme hat er ChatGPT bereits geschluckt
Vor zwei Tagen veröffentlichte Dan Shipper, Mitbegründer und CEO des Technikmediums Every, einen ausführlichen Tiefenbericht mit dem Titel „How Codex Happened“, der den gesamten Prozess nachzeichnet, wie OpenAIs Programmieragent Codex im vergangenen Jahr aus dem Tief heraus zu einem Erfolg wurde.
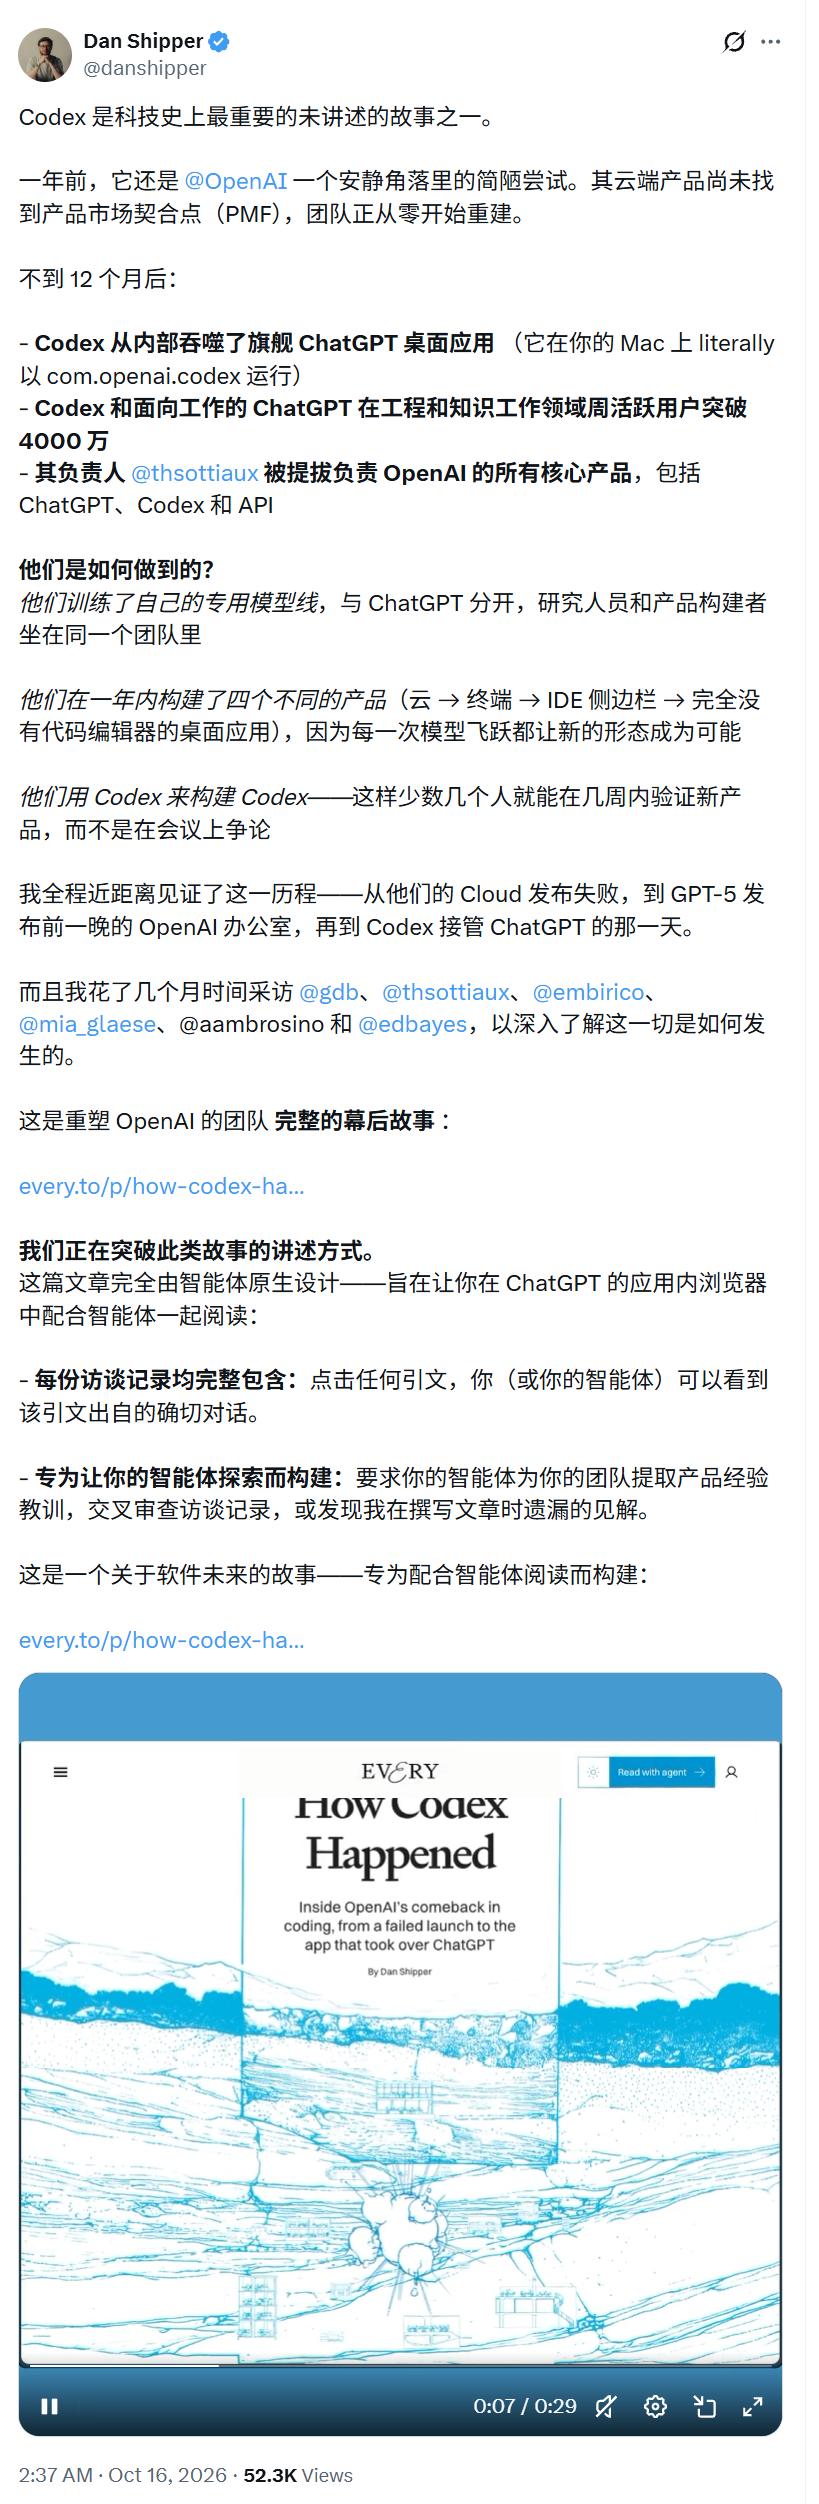
Für diesen Artikel führte Shipper über mehrere Monate hinweg Interviews mit sechs zentralen Beteiligten von Codex:
Greg Brockman, Präsident und Mitbegründer von OpenAI
Leiter von Codex Thibault Sottiaux (auch bekannt als Tibo)
Ehemaliger Produktleiter von Codex Alexander Embiricos
Forscherin Mia Glaese
Designer und Ingenieur Andrew Ambrosino
Designer Ed Bayes
Shipper selbst war ebenfalls Augenzeuge: Every erhält seit langem vor der Veröffentlichung neuer Modelle Testzugänge und veröffentlicht Bewertungen der Reihe „Vibe Check“. Am Vorabend der Veröffentlichung von GPT-5 saß er direkt im Büro von OpenAI.
Die Form dieses Berichts ist ebenfalls besonders. Shipper bezeichnet ihn als „agent-nativ“-Artikel: Die vollständigen Transkripte der sechs Interviews sind vollständig im Text angehängt. Mit einem Klick auf ein beliebiges Zitat gelangt man zum ursprünglichen Gespräch. Leser können ihren eigenen Agenten auch dazu bringen, die Transkripte gegeneinander zu prüfen, Produkterfahrungen herauszuarbeiten und sogar Erkenntnisse zu finden, die der Autor übersehen hat. Laut Every wurde dieser Bericht selbst mithilfe von Codex verfasst und recherchiert.
Im Text gibt es viele interessante Details. Derzeit gibt die ChatGPT-Desktopanwendung im Mac-System ihren eigenen Namen immer noch als com.openai.codex an, Codex hat ChatGPT intern „verschluckt“. Die Außenwelt glaubt, dass die Entscheidung für eine unabhängige Modelllinie von Codex eine weitsichtige Entscheidung der Führung war, aber Tibo sagt offen, dass es eine solche Entscheidung überhaupt nicht gegeben hat.
Innerhalb eines Jahres hat das Team nacheinander vier Produktformen entwickelt: Cloud, Endgerät, Seitenleiste im Editor und schließlich eine Desktopanwendung ohne jeglichen Code-Editor. Um zu überprüfen, ob diese Anwendung, bei der Benutzer keinen Code manuell ändern dürfen, funktioniert, fragte Embiricos jeden Tag, wenn er ins Büro kam, seine Kollegen nacheinander: Hast du es heute als Hauptwerkzeug verwendet?
Das Ergebnis ist erstaunlich. Laut dem Bericht von Every überschritt die wöchentliche aktive Nutzerzahl von Codex im Juni dieses Jahres 5 Millionen; im Juli wurde die Codex-Desktopanwendung direkt zur neuen ChatGPT-Desktopanwendung; heute überschreitet die kombinierte wöchentliche aktive Nutzerzahl von Codex und ChatGPT for Work 40 Millionen, Tibo wurde zudem zum Leiter aller zentralen Produkte und Plattformen von OpenAI befördert und leitet ChatGPT, Codex und die API.
Im Folgenden verfolgen wir die Erzählstruktur von Shipper, um diese Geschichte zu durchleuchten.
Am Vorabend der Veröffentlichung von GPT-5: Ein etwas peinliches Gespräch
Die Geschichte beginnt im Sommer 2025. Every erhielt GPT-5 einen Monat im Voraus und war mit der täglichen Nutzung sehr zufrieden, aber wenn es in Codex zum Schreiben von Code eingesetzt wurde, war die Reaktion eher verhalten: Es ist schnell und intelligent, hört aber immer viel zu früh auf, als würde es sich nicht über die erlaubten Grenzen hinauswagen, eher wie ein Partner beim kooperativen Programmieren.
Zu dieser Zeit hatte Every bereits seine Arbeitsweise geändert: Mit Claude Code übergab man die gesamte Aufgabe an Opus 4, ging dann weg und wartete darauf, dass eine vollständige Funktion oder sogar die gesamte Anwendung zurückgeliefert wurde.
Daher erzählte Shipper im Konferenzraum des OpenAI-Büros in Mission Bay diese Beobachtungen Embiricos: Mit Claude Code kann man es laufen lassen, wie es will, aber GPT-5 wirkt ängstlich. Als er sagte „Wir schauen uns den Code eigentlich kaum noch an“, errötete er selbst, schließlich stand ihm gegenüber jemand, dessen Aufgabe es ist, autonome Programmieragenten zu entwickeln.
Als er an diesem Abend ging, kam Shipper ein Gedanke: OpenAI baut möglicherweise gerade perfekte Werkzeuge für einen Arbeitsablauf, der bald verschwinden wird.
Alles begann mit „Thinking...“
Um den Erfolg von Codex zu verstehen, geht Shipper zurück zur Geburt des Inferenzmodells.
Frühe große Modelle waren wie Improvisationsschauspieler, die nur Wort für Wort denken und sprechen konnten. Im September 2024 stellte OpenAI die Vorschauversion von o1 vor und trainierte das Modell selbst darin, „zuerst Schritt für Schritt zu schließen und dann zu antworten“: Dasselbe Modell kann, wenn es etwas länger nachdenkt, schwierigere Aufgaben besser lösen.
Das Programmieren war der größte Nutznießer. Das Schreiben von Code ist von Natur aus ein geschlossener Kreislauf: Ändern, ausführen, innerhalb von Sekunden weiß man, ob es richtig ist – das Modell kann selbst testen und selbst korrigieren. Theoretisch kann ein Inferenzmodell jede Programmieraufgabe unabhängig erledigen, solange die Denkzeit ausreicht.
Der Name Codex selbst erlebte auch mehrmals einen „Neuanfang“: Das ursprüngliche Codex war ein 2021 auf GPT-3 feinabgestimmtes Modell, das den ersten Generation von GitHub Copilot unterstützte. Nach o1 verfolgten mehrere Teams bei OpenAI diesen Traum aus verschiedenen Richtungen erneut.
Zwei verborgene Linien: Ein Moment, in dem man „AGI spürte“, und ein „Bootstrapping“
Eine Linie stammt von Embiricos. Er kam 2024 durch die Übernahme des von ihm mitgegründeten Programmier-Kollaborationstools Multi zu OpenAI und versuchte sich zunächst an der Zusammenarbeit zwischen Mensch und Maschine bei der ChatGPT-Desktopanwendung und dem Atlas-Browser, aber die damaligen Modelle waren langsam und ungeschickt beim Lesen des Bildschirms. Bis Ende 2024 sah er, wie das Inferenzmodell an das Terminal angeschlossen wurde, selbst Dateien las, Befehle ausführte und Fehlermeldungen verarbeitete – das war das erste Mal, dass er AGI wirklich spürte.
Die andere Linie stammt von Tibo, der Person, die heute alle zentralen Produkte von OpenAI leitet.
Shipper interviewte ihn im Mitarbeiterrestaurant von OpenAI. Nach Shippers Beschreibung hat Tibo glänzendes braunes Haar, das er zur Seite kämmt, trägt eine dünne Metallbrille und sieht von der Nase aufwärts wie ein Architekt aus; von der Nase abwärts sieht er ganz wie ein Programmierer aus: Er hat einen braunen Bart, trägt einen dunkelbraunen Kapuzenpullover mit der Aufschrift „Research and Deployment Co“ und hält eine Peperoni-Pizza in der Hand. Seine Beliebtheit im Team ist offensichtlich: Sein Kollege Ambrosino hat einmal einen Beitrag mit nur dem Inhalt „tibo“ in den sozialen Medien veröffentlicht, der Tausende von Likes erhielt. In China wird er sogar „Gott des Zurücksetzens“ genannt.
Mehr als sein Aussehen ist sein Lebenslauf erwähnenswert. Tibo hat den Großteil seiner Karriere damit verbracht, Infrastruktur für Forscher aufzubauen, zuerst bei DeepMind, dann bei OpenAI. Die sogenannte Forschungsinfrastruktur ist der Satz gemeinsamer Codes, auf den KI-Forscher zum Ausführen, Bewerten, Reproduzieren und Bereitstellen von Experimenten angewiesen sind.
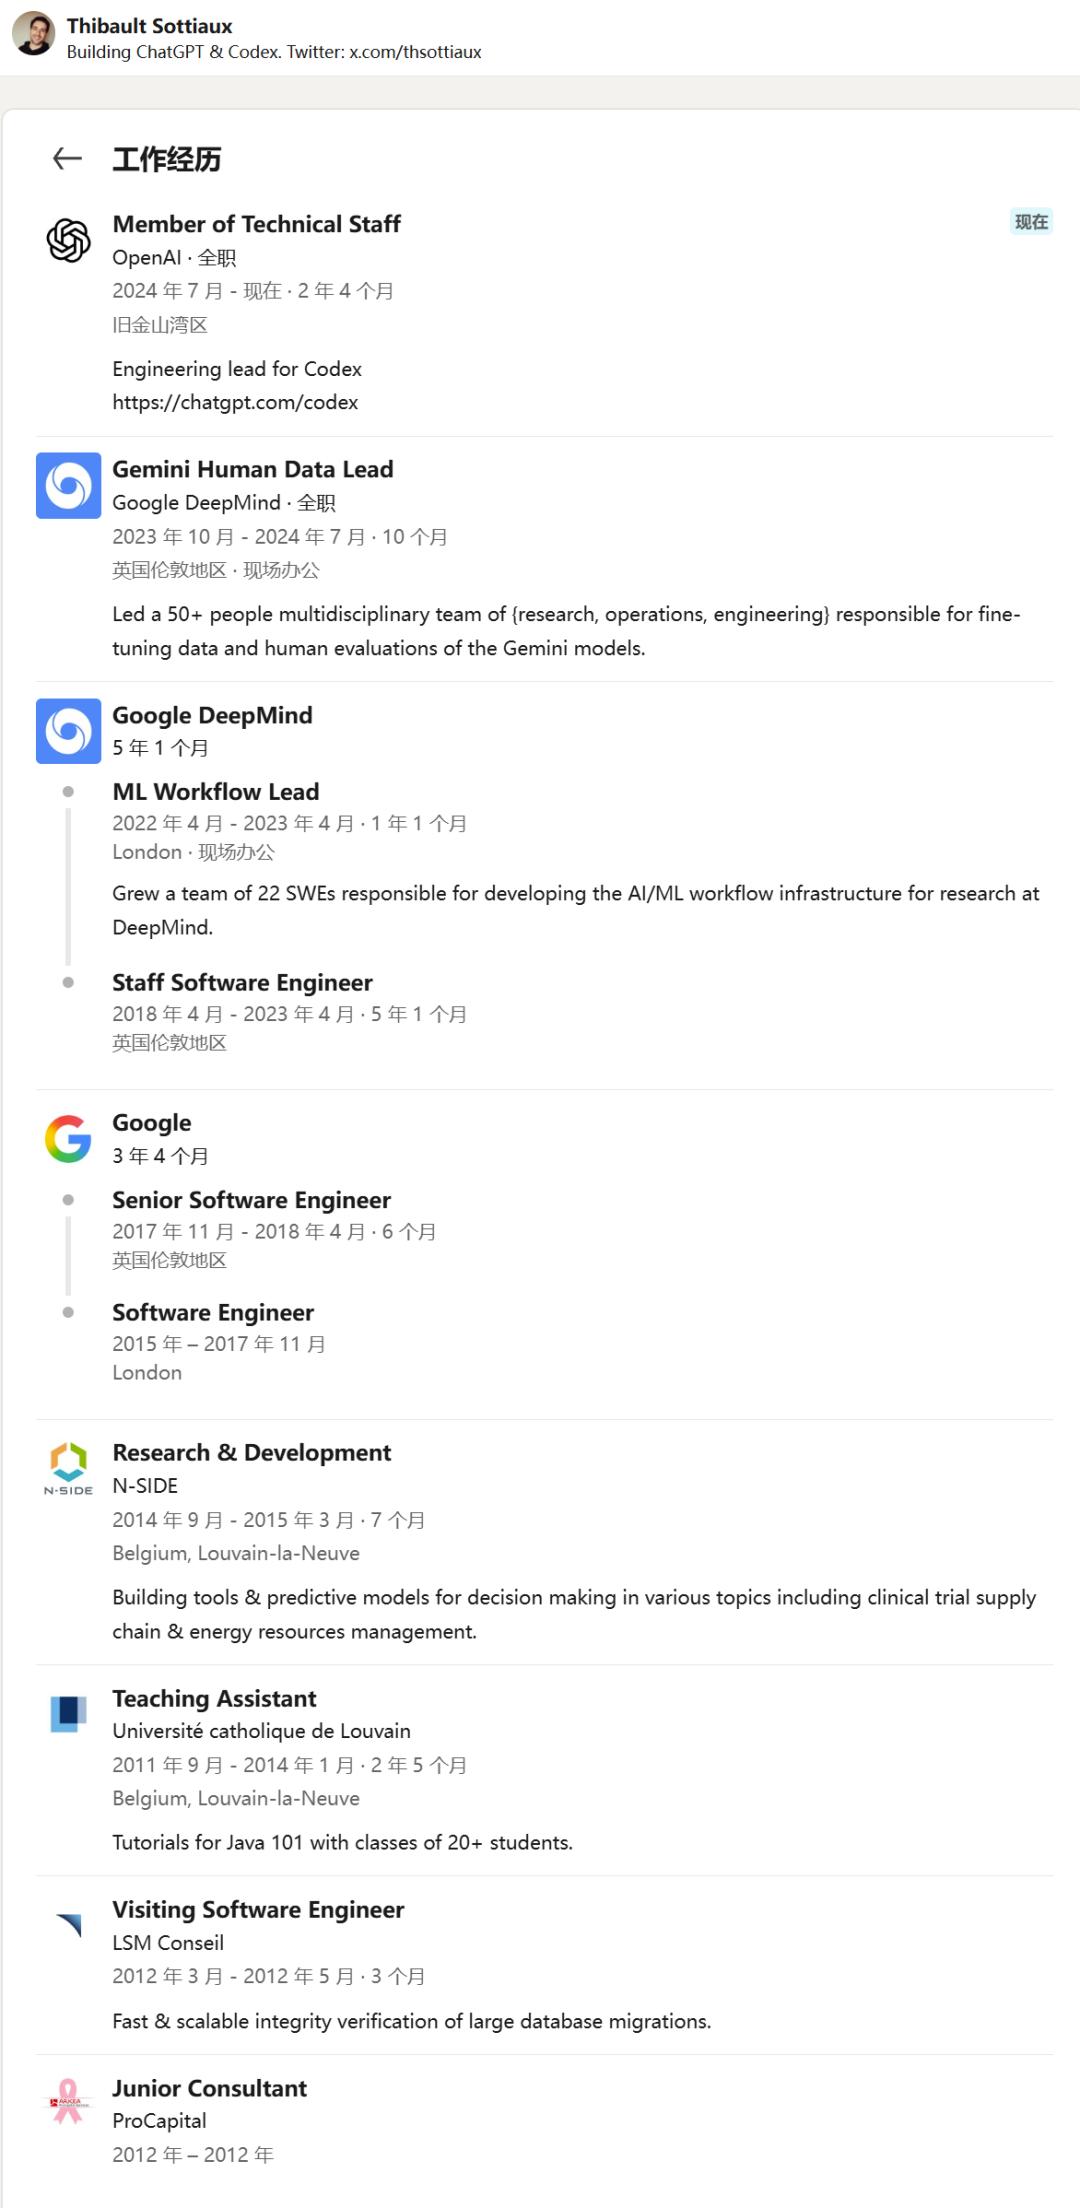
In der Vorstellung vieler Menschen ist die Infrastruktur wie das Wasserrohr der Technikwelt: unverzichtbar, aber niemand beachtet es, bis irgendwo Wasser austritt. Als zukünftiger Leiter von Codex scheint dieser Hintergrund etwas unerwartet. Aber im KI-Bereich ist die Forschungsinfrastruktur genau der Ort, an dem viele wichtige Fortschritte stattfinden: Wenn man die Dauer eines Experiments verkürzt, kann man mehr Experimente durchführen und früher bessere Modelle erhalten.
Diese Denkweise, „Werkzeuge für die Menschen zu bauen, die Modelle bauen“, wurde auch sein Ausgangspunkt, um in den Bereich der Programmieragenten einzutreten. Im Dezember 2024 begann Tibo mit der Entwicklung von Programmieragenten, mit dem Ziel, OpenAI beim schnelleren Schreiben von Infrastruktur und der Durchführung von Forschung zu unterstützen. Sein Team trainierte interne Programmieragenten auf dem einheitlichen Code-Repository (Monorepo) von OpenAI, die Forscher nutzten sie täglich, und die Rückkopplungsschleife war extrem kurz. Welche Trainingstechniken genau verwendet wurden, hält er wie seine Kollegen in anderen großen Labors streng geheim.
Als Shipper nachfragte: „Wie habt ihr entschieden, die Modelllinie auszugliedern?“, antwortete Tibo ruhig: Es gab keine solche Entscheidung, am Anfang war es nur eine Forschungsuntersuchung, um die eigene Arbeitsgeschwindigkeit zu erhöhen. Forscher nutzten diese Modelle für Experimente, bauten stärkere Modelle und verwendeten sie dann für bessere Experimente – Ingenieure nennen das „Bootstrapping“.
Eine Gruppe „interner Startups“ im Unternehmen
Ende 2024 wurde das Programmieren zu einem unternehmensweiten Ziel von OpenAI, und mehrere Teams arbeiteten an demselben Problem. Brockman sagte, das wirklich ungelöste Problem sei die „Produktform“: Sollte der Agent im Terminal, im Editor oder auf einem eigenen Computer in der Cloud laufen?
Sam Altman hat einmal gesagt, dass OpenAI in gewissem Sinne auf eine Reihe von Startups setzt, die sich alle innerhalb des Unternehmens befinden. Diese parallele Erkundung erscheint einigen Insidern chaotisch und verschwenderisch, aber Shipper hält sie im KI-Bereich, in dem sich die Grenzen der Technologie ständig verschieben, für fast unverzichtbar: Ein Modell, das eine Zeile Code ergänzen kann, eignet sich für die automatische Vervollständigung, ein Modell, das 30 Sekunden nachdenken kann, eignet sich für die Fragestellung in der Seitenleiste, und ein Modell, das eine Stunde lang arbeiten kann, erfordert eine völlig neue Form.
Anschließend begannen die verschiedenen Teams zu fusionieren. Nach Brockmans Worten „fusionierten zwei Teams, dann fusionierten zwei weitere Teams“. Das neue Codex-Team brachte produktorientierte Personen wie Embiricos, Ingenieurexperten wie Tibo und Forscher wie Glaese zusammen. Produktmanager schlugen vor „Wie toll wäre es, wenn das Modell das schaffen könnte“, und die Forscher machten es dann Wirklichkeit.
Die in sieben Wochen entwickelte Cloud-Version und ihr Scheitern
Im Februar 2025 veröffentlichte Anthropic die Forschungsvorschauversion von Claude Code. Es arbeitete direkt im Terminal auf deinem Computer, nutzte deine vorhandenen Dateien und Werkzeuge und konnte jederzeit unterbrochen werden – Entwickler akzeptierten es schnell.
Das Codex-Team setzte auf die Cloud, entwickelte Codex Cloud in etwa sieben Wochen und veröffentlichte es am 16. Mai 2025: Beschreibe die Aufgabe in ChatGPT, Codex ändert den Code und führt Tests auf einem isolierten Cloud-Computer aus und gibt schließlich eine Schaltfläche zum Einreichen eines PR zurück.
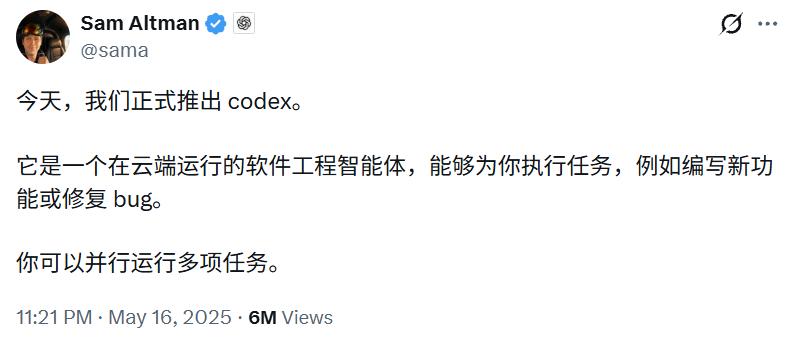
Es war intern bei OpenAI sehr erfolgreich, aber außerhalb des Unternehmens wurde es zwar gelobt, aber kaum genutzt. Entwickler mussten Stunden damit verbringen, Software, Berechtigungen und Konfigurationen ihres Computers in der Cloud neu aufzubauen; Aufgaben konnten nicht unterwegs korrigiert werden, selbst um eine Nachfrage zu stellen, musste ein neuer Cloud-Computer gestartet werden. Die standardisierte Entwicklungsumgebung bei OpenAI verdeckte, wie hoch diese Anforderungen für normale Benutzer waren. Embiricos gab zu, dass das Modell damals noch nicht intelligent genug war; Glaeses Reflexion war, dass das Team mit einer zukunftsorientierten Vision gearbeitet hatte, aber nicht „dorthin gegangen war, wo die Benutzer sind“, nämlich auf ihre Laptops.
Eigentlich hat das Team die Terminal-Route nicht übersprungen. Tibo enthüllte, dass sie intern einen Terminal-Prototyp entwickelt hatten, den sie einen Monat später aufgaben, um sich voll und ganz auf die Cloud zu konzentrieren. Bei OpenAI galt die ideale Form des Agenten immer als eine, die autonom in der Cloud für dich arbeitet und auch dann weiterläuft, wenn du deinen Laptop zuklappst. Nach Brockmans Worten ist die richtige Form eine Cloud-KI mit einem eigenen Laptop.
Aber in der Realität wechselte der Ingenieurmanager des Teams zu Cursor, und die von OpenAI berichtete Übernahme von Windsurf für 3 Milliarden Dollar scheiterte ebenfalls im Juli. Das Codex-Team verlor sich zum ersten Mal in der Wildnis.