NVIDIA hat in einen Konkurrenten im Chipsektor investiert
In den letzten zwei Jahren wurden die Schlüsselwörter der KI-Industrie fast vollständig von Rechenleistung dominiert: GPU, HBM, fortschrittliche Verpackung, Superknoten. Je weiter man jedoch voranschreitet, desto mehr Menschen erkennen, dass Rechenleistung keine einsame Insel ist. Selbst der leistungsstärkste Chip ist nichts weiter als eine teure einsame Insel, wenn er nicht mit anderen verbunden werden kann.
Wenn große Modelle von Parametern im Milliardenbereich zu Parametern im Billionenbereich übergehen und Trainingscluster von Tausenden von Karten zu Zehntausenden von Karten wechseln, wandelt sich die Netzwerkkonnektivitätstechnologie von einer unterstützenden Hintergrundkomponente zu einer Kernvariable, die bestimmt, wie schnell ein KI-Cluster laufen kann und wie groß er skaliert werden kann.
Genau an diesem Punkt erregt eine scheinbar widersprüchliche Investition die Aufmerksamkeit der Branche: Kürzlich hat ein Unternehmen namens Upscale AI eine vollständige KI-Netzwerkplattform namens Token Fabric veröffentlicht, die dazu dient, KI-Chips verschiedener Anbieter gleichzeitig in Rechenzentren auszuführen.
Diese Angelegenheit an sich ist nicht ungewöhnlich. Das Besondere ist, dass Nvidia prominent in der Liste seiner Investoren aufgeführt ist. Ein Unternehmen, das seine Beschleunigungskarten durch ein eigenes vollständiges Verbindungsnetzwerk zusammenbindet und verkauft, hat Geld in ein Geschäft investiert, das Kunden dabei hilft, Chips anderer Hersteller zu mischen.
Warum investiert Nvidia in ein Unternehmen, das „sich selbst untergräbt“?
Wie allgemein bekannt ist, gehen fast alle in der Branche davon aus, dass Nvidia mit seinem geschlossenen NVLink und der vollständigen Stack-Bindung KI-Cluster monopolisiert und ein Ökosystem mit gemischten Mehrchip-Nutzungen niemals zulässt. Aber Token Fabric ist kompatibel mit KI-Beschleunigern verschiedener Hersteller wie Nvidia, AMD, Intel und inländischen KI-Chips, wobei Nvidia sein zentraler strategischer Investor und Technologielieferant ist.
Wenn man diesen Satz umgekehrt versteht, wird die gesamte strategische Logik plötzlich klar: Nvidia ist sich bewusst, dass der Trend zu heterogener Rechenleistung von mehreren Anbietern nicht aufzuhalten ist. Anstatt vergeblich zu verhindern, dass Kunden Chips anderer Hersteller mischen, sollte man sicherstellen, dass man bei der Umsetzung dieses Trends weiterhin an den unvermeidlichen Knotenpunkten des gesamten Systems steht.
Token Fabric von Upscale AI verkauft kein „Anti-Nvidia“-Konzept, sondern einen inkrementellen Markt, der durch heterogene Rechenleistung außerhalb des Nvidia-Ökosystems entsteht.
Aus dieser Perspektive handelt es sich möglicherweise nicht um einen Kompromiss oder einen internen Wettbewerb von Nvidia, sondern um eine strategische Layout auf einer höheren Ebene. Vor einigen Jahren kaufte Nvidia Mellanox für 7 Milliarden US-Dollar, um die absolute Autorität bei privaten Verbindungen zu erwerben. Jetzt investiert es in Upscale AI und befähigt die offene Verbindungsplattform Token Fabric, um den unvermeidlichen Branchentrend der gemischten Mehrchip-Nutzung aktiv zu akzeptieren, die oberflächliche Bindung durch private Verbindungen einzelner Karten aufzugeben, den ultimativen Eingang des Ausgangsnetzwerks von Rechenzentrumsclustern zu sichern und eine Monopolstellung auf eine andere Weise zu erreichen.
Von der Übernahme von Mellanox zur Investition in Upscale: Die Iteration von Nvidias Verbindungshegemonie
Übernahme von Mellanox: Stärkung der Kernbarriere für die Integration von Rechenleistung und Netzwerk
Am 11. März 2019 kündigte Nvidia die Übernahme von Mellanox für 6,9 Milliarden US-Dollar in bar an, die teuerste Transaktion in der Geschichte von Nvidia. Zu diesem Zeitpunkt nahmen Intel, Microsoft und Xilinx alle an dem Bieterverfahren für Mellanox teil, und am Ende sicherte sich Nvidia den Deal. Im April 2020 wurde die Transaktion nach der Prüfung durch die Antimonopolbehörden mehrerer Länder weltweit für 7 Milliarden US-Dollar offiziell abgeschlossen.
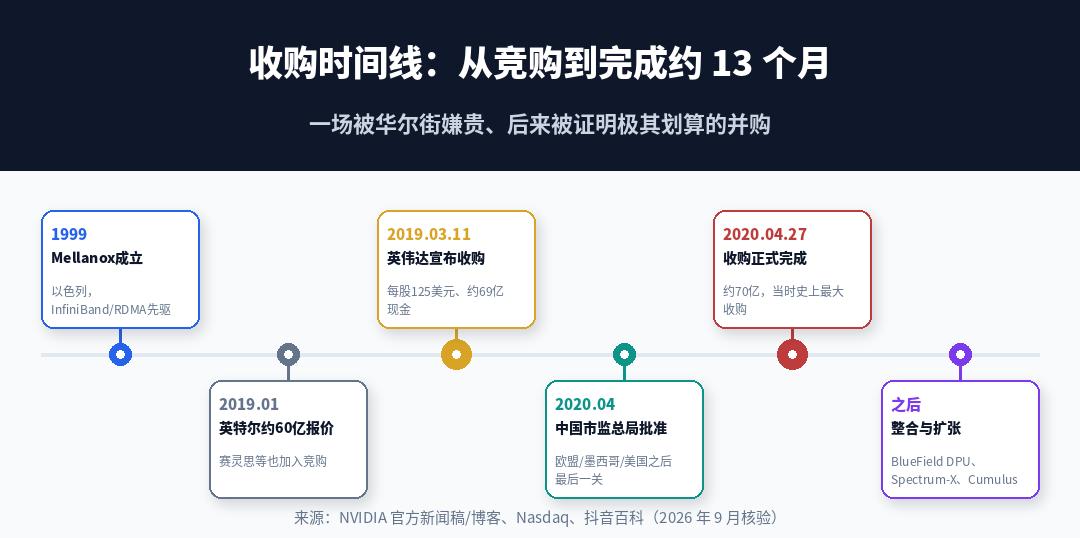
Das Muster vor der Übernahme war sehr klar: Nvidias GPUs stiegen schnell auf dem Markt für KI-Training auf, aber die Hochgeschwindigkeitsverbindung zwischen Racks und Clustern hing von Drittanbietern ab. NVLink kann nur innerhalb eines Racks eine Hochgeschwindigkeitsverbindung zwischen eng gekoppelten GPUs realisieren. Sobald es auf große Rechenzentrumscluster ausgeweitet wird, wird der Kommunikationsengpass von externen Netzwerkanbietern bestimmt.
Mellanox verfügte über InfiniBand, intelligente Netzwerkkarten von ConnectX, BlueField DPU und Spectrum-Ethernet-Switchchips und nahm eine führende Position im Bereich des Supercomputing und des Hochleistungsrechnens (HPC) weltweit ein. Mehr als die Hälfte der weltweit TOP500-Supercomputer nutzt kombinierte Lösungen beider Seiten. Nehmen wir InfiniBand als Beispiel: Die Hochgeschwindigkeitsverbindungstechnologie InfiniBand von Mellanox hält einen Marktanteil von über 70%, und Google, Amazon und Microsoft sind ihre Kunden.
Durch diese Übernahme hat Nvidia die gesamte private Verbindungskette von NVLink (Scale-Up innerhalb der Platine) bis InfiniBand/Spectrum (Scale-Out des Clusters) durchbrochen. Jensen Huang sagte damals: „Durch die Integration der Technologie von Mellanox wird das neue NVIDIA über End-to-End-Technologie von KI-Rechenleistung bis zum Netzwerk sowie über ein vollständiges Stack-Produkt von Prozessoren bis hin zu Software verfügen.“
Das Wesen dieser Phase war ein vollständig geschlossenes Bindungssystem: Kunden mussten das gesamte Paket aus Nvidia-GPUs und Netzwerkgeräten kaufen. Die Leistung war extrem hoch, aber die Kompatibilität lag bei Null. Kunden hatten keine Alternativen und eine sehr geringe Verhandlungsmacht.
Dieses Modell brachte in der frühen Phase des Booms großer Modelle große Vorteile, aber seine Engpässe traten allmählich zutage. Mit der fortschreitenden Lokalisierung von KI-Chips, dem anhaltenden Durchbruch von AMD und Intel, dem Boom selbst entwickelter Chips von Cloud-Anbietern und der angespannten Produktionskapazität und Lieferfrist, die durch die Explosion der Nachfrage nach KI-Rechenleistung verursacht wurde, fehlte es einzelnen Anbietern an ausreichender Produktionskapazität und stabilen Lieferfristen. Die Nachfrage der Kunden nach heterogenen Rechenleistungsclustern stieg schnell an, und das gemischte Einfügen mehrerer Chips wurde allmählich zu einer harten Anforderung von Cloud-Anbietern. Das vollständig gebundene Modell des geschlossenen Ökosystems konnte den Anforderungen von Branchenkunden immer weniger gerecht werden.
Token Fabric läutet ein neues Paradigma für Verbindungen ein
Unter diesem Trend wird Nvidias strategisches Denken grundlegend weiterentwickelt. Es versucht nicht mehr, Konkurrenten am Eintritt zu hindern, sondern steuert die zugrunde liegenden Übertragungskanäle für heterogene Rechenleistung.
Die Logik der Übernahme von Mellanox war ein ausschließliches Monopol, bei dem man selbst produziert und den gesamten Gewinn einstreicht. Die Logik der Investition in Upscale AI besteht darin, alle zur Mitarbeit zu bewegen, die Kanäle selbst zu steuern und den inkrementellen Markt zu erschließen. Das heißt, man erkennt die Notwendigkeit der gemischten Mehrchip-Nutzung in der Branche an, gibt die oberflächliche ausschließliche Bindung im Scale-Up-Bereich eng gekoppelter Verbindungen auf und kämpft um die Autorität im Scale-Out-Backbone-Netzwerk für die Erweiterung heterogener Cluster nach außen.
Nvidies Schutzmauer hat sich von GPU-Hardware und privaten Verbindungsprotokollen zu einer standardisierten Netzwerkinfrastruktur für KI-Rechenzentren weiterentwickelt. Unabhängig davon, welcher KI-Chip von Kunden angeschlossen wird, kann das Backbone-Netzwerk, das Racks und Rechenzentren übergreift, weiterhin auf der Spectrum-X-Basis von Nvidia ausgeführt werden.
Es ist erwähnenswert, dass Nvidia im Mai 2025 auch NVLink Fusion auf den Markt gebracht hat und zum ersten Mal die NVLink-IP-Lizenz für Dritte öffnet, wodurch Nicht-Nvidia-CPUs, ASICs oder Beschleuniger tief in Nvidias GPUs integriert werden können.
Diese Reihe von Maßnahmen und Layouts von Nvidia zeigt, dass es sich nicht um eine isolierte Investitionsmaßnahme handelt, sondern um eine systematische strategische Wende.
Was genau ist die hierarchische Architektur von Token Fabric?
Um die Plattform von Upscale AI zu verstehen, muss man zunächst zwei völlig unterschiedliche Netzwerkebenen in KI-Clustern unterscheiden, die in der Branche häufig als Scale-Up und Scale-Out bezeichnet werden.
Scale-Up (eng gekoppelte Ebene innerhalb des Racks): Eine Gruppe von Beschleunigern wird eng zu einer einheitlichen Recheneinheit verbunden. Bandbreite und Latenz bestimmen direkt die Effizienz des Trainings großer Modelle. Zwischen Chips ist ein direkter Speicherzugriff mit niedriger Latenz und hoher Determinismus erforderlich.
Scale-Out (lose gekoppelte Ebene zwischen Clustern): Mehrere Rechenleistungs-Pods, die das Scale-Up abgeschlossen haben, werden erneut verbunden, um eine supergroße Erweiterung zwischen Racks und Rechenzentren zu realisieren und die Obergrenze für die Skalierung des Clusters zu bestimmen.
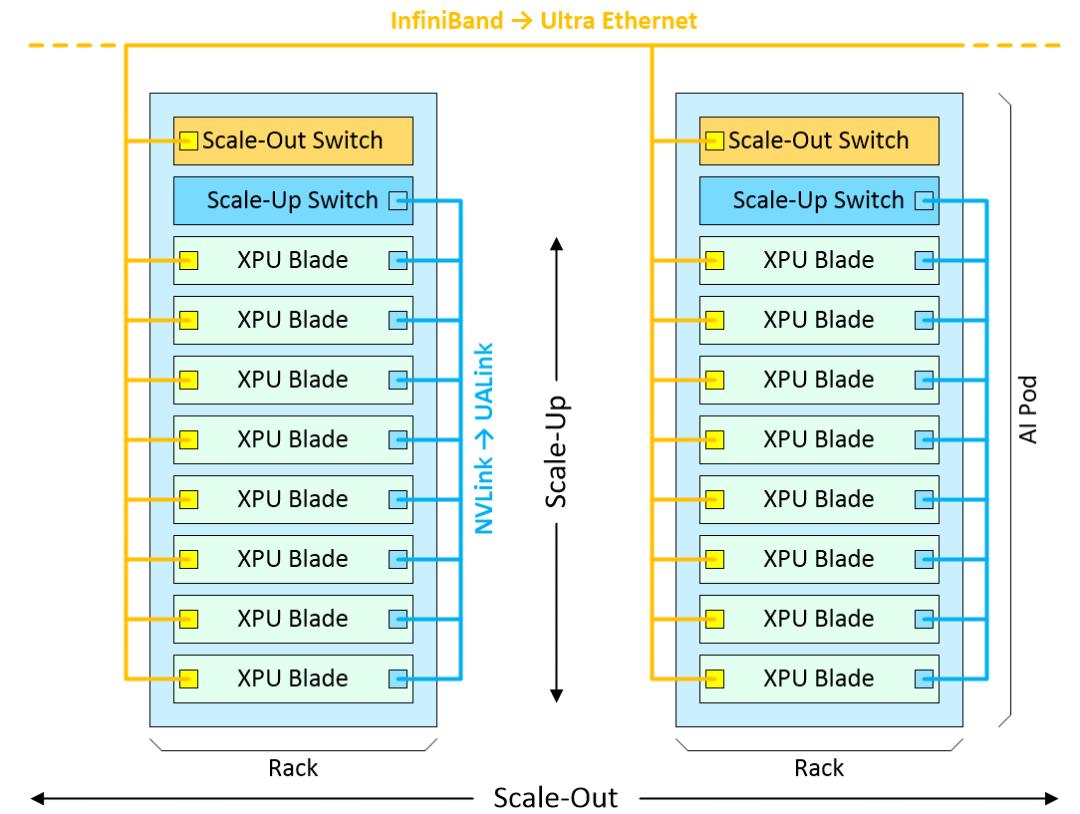
In herkömmlichen Lösungen werden die beiden Netzwerkebenen normalerweise von demselben Anbieter als Paket geliefert. Wenn Kunden den Anbieter von Beschleunigungskarten wechseln möchten, bedeutet dies in der Regel, dass das gesamte Netzwerkarchitektur, die Switches und die Netzwerkkarten neu erstellt werden müssen, was zu extrem hohen Kosten für technische Umgestaltungen führt.
Der Ansatz von Upscale AI besteht darin, das Problem getrennt zu lösen.
In der Scale-Up-Ebene innerhalb des Racks von Token Fabric wird der selbst entwickelte SkyFabriX-Switchchip von Upscale verwendet, der zwei offene Verbindungsstandards UALink und ESUN unterstützt. GPUs, verschiedene kundenspezifische Beschleuniger und Netzwerkkarten von Drittanbietern können angeschlossen werden – dies ist der offene Eingang.
Die Backbone-Ebene für die externe Skalierung von Scale-Out-Clustern wird direkt auf Basis der Spectrum-X-Ethernet-Technologie von Nvidia aufgebaut. Spectrum-X ist eine Ethernet-Plattform, die von Nvidia speziell für KI-Arbeitslasten entwickelt wurde und Hochgeschwindigkeitsports von 400G/800G/1,6T abdeckt. Im Vergleich zu herkömmlichem kommerziellem Ethernet wird die Leistung des KI-Netzwerks um das 1,6-fache verbessert. Es integriert Spectrum-Switchchips und SuperNIC, verfügt über eingebaute Funktionen zur Überlastungssteuerung und Optimierung der kollektiven Kommunikation für die Kommunikation großer Modelle, unterstützt RoCE-Erweiterungen und adaptive Routen und ist für die Erweiterung supergroßer KI-Cluster geeignet.
Auf Softwareebene wird Token Fabric von dem SkyOS-Netzwerkbetriebssystem und dem SkyCMD-Betriebs- und Wartungssystem begleitet, das für die Erkennung von Engpässen im gesamten Netzwerk, die Warnung vor dem Gesundheitszustand von Komponenten und die Planung des Clusterverkehrs verantwortlich ist. Das gesamte Paket wird als Token Fabric gebündelt. Kunden erhalten keine verstreuten Switch-Hardware mehr, sondern ein heterogenes Rechenleistungsnetzwerk, das zwei Ebenen verbindet und Hardware und Software integriert.
Dies ist der Kernwiderspruch der gesamten Lösung: Die Zugriffsebene ist offen, und heterogene Chips wie GPUs und kundenspezifische Beschleuniger können frei angeschlossen werden. Das Ausgangs-Backbone für die externe Skalierung basiert technisch auf Nvidia. Der Eingang ist offen, aber der Ausgang ist gebunden – dieser Satz ist der Schlüssel zum Verständnis des gesamten Geschäftsmodells und der Ausgangspunkt für nachfolgende Branchenkontroversen.
Gewinnen Upscale und Nvidia gemeinsam?
Auf Standardebene unterstützt Token Fabric gleichzeitig die beiden technischen Routen UALink und ESUN.
UALink (Ultra Accelerator Link) ist eine Beschleuniger-Verbindungsspezifikation, die von einer offenen Branchenallianz gefördert wird. Zu den Mitgliedern gehören Unternehmen wie AMD, Intel, Google, Meta, Microsoft, AWS und Alibaba. Bis Mitte 2026 hat die Allianz mehr als 115 Mitglieder. Ihr ursprünglicher Zweck besteht darin, private geschlossene Verbindungslösungen wie NVLink entgegenzuwirken. UALink ist nativ auf eng gekoppelte KI-Cluster innerhalb von Racks ausgerichtet, unterstützt den direkten Zugriff auf den Grafikspeicher zwischen Beschleunigern und realisiert verlustarme Übertragung mit niedriger Latenz auf Hardwareebene. ESUN ist eine Erweiterung von Ethernet im Scale-Up-Szenario.
Dass Upscale AI beide Standards gleichzeitig unterstützt, zeigt möglicherweise, dass es selbst nicht sicher ist, welche Route sich durchsetzen wird, sodass es nicht auf den Erfolg einer einzelnen technischen Route setzt. Da die offenen Verbindungsstandards noch nicht endgültig festgelegt sind, kann eine doppelte Routenlayout die Anforderungen an den Anschluss verschiedener Kunden und Chips maximal abdecken.
Die Rolle von Nvidia in diesem Zusammenhang ist recht subtil. Einerseits stellt die Existenz der UALink-Allianz eine direkte Herausforderung für das private Ökosystem von NVLink dar. Andererseits bindet Nvidia das offene Ethernet-System tief durch Spectrum-X ein und nutzt offene Branchenstandards, um die Auswirkungen der UALink-Allianz auf das private Ökosystem abzuschwächen. In Übereinstimmung damit hat Nvidia 2 Milliarden US-Dollar in Marvell investiert, um potenzielle Konkurrenten in Partner umzuwandeln und seine Autorität im offenen Ethernet-Ökosystem weiter zu stärken.
Wie bekannt ist, wurde der Produktlieferzeitplan für die Lösung von Upscale AI bereits veröffentlicht: Die erste Phase von Token Fabric wird im vierten Quartal 2026 veröffentlicht und löst vorrangig die Vernetzung von Rechenleistung zwischen Rechenzentren und mehreren Pods. Die vollständige Plattform wird 2027 schrittweise eingeführt. Dieser Fortschritt ist schneller als von vielen Branchenanalysten erwartet, was bedeutet, dass der Validierungszyklus in der realen Produktionsumgebung stark verkürzt wird.
Ist diese Lösung wirklich eine neutrale offene Infrastruktur oder eine Bindung in einer anderen Form? Die Branche hat einen relativ klaren Validierungsstandard: Wenn die Scale-Out-Ebene von Token Fabric in Zukunft Hochgeschwindigkeits-Ethernet-Lösungen anderer Hersteller außer Spectrum-X unterstützen kann, ist sie eine wirklich neutrale heterogene Netzwerkplattform. Wenn nach der Einführung der vollständigen Plattform im Jahr 2027 das Scale-Out zwischen Clustern weiterhin nur auf Spectrum-X angewiesen ist, löst sie nur das Problem, dass Karten verschiedener Hersteller gemischt eingefügt werden können, realisiert jedoch keine Auswahl mehrerer Anbieter für das Backbone-Netzwerk des Clusters, sodass das Netzwerkökosystem weiterhin von Nvidia monopolisiert wird.
Die aktuelle Öffnung von Token Fabric öffnet nur das Recht auf Zugriff auf Rec