Heimische GPUs wetteifern um Superknoten – wer zahlt die Rechnung?
Alle inländischen GPU-Hersteller versuchen, einen noch größeren Computer zu bauen.
Auf der 26. Chinesischen Internationalen Industriemesse, die am 12. Oktober eröffnet wurde, feierte die Ausstellung für integrierte Schaltkreise erstmals als eigenständige Fachausstellung Premiere. In diesem als „Chinesische Chip-Ausstellung“ bekannten Bereich sind mehr als 300 Unternehmen vertreten. Die Ausstellungsinhalte decken Chip-Design, Wafer-Fertigung, Verpackung und Test sowie Halbleitergeräte und -materialien ab. Die teilnehmenden inländischen GPU-Hersteller haben einhellig die gleiche Richtung gewählt: mehr Chips miteinander zu verbinden.
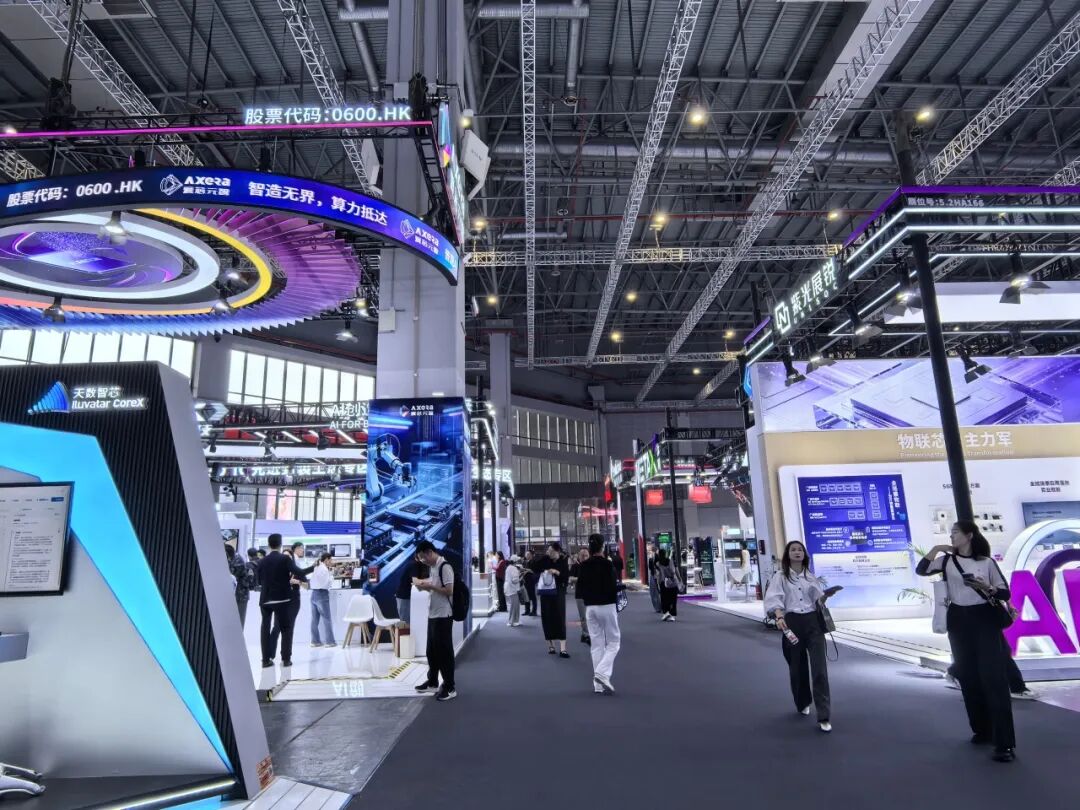
MetaX zeigte den Xijing S600-Superknoten mit vollständiger Vernetzung von 64 Karten pro Schrank, Enflame präsentierte den Cloud-Enflame ESL64-O-Superknoten, während Iluvatar 144 GPUs in einem einzigen Schrank integrierte. In der Vergangenheit konkurrierten inländische GPU-Hersteller hauptsächlich um die Leistung einzelner Chips. Heute beginnen die Hersteller, zu erläutern, wie ein vollständiges Superknoten-System große Modelle ausführt und wie Rechenleistung und Effizienz verbessert werden können.
Als jedoch Huawei, Alibaba und immer mehr unabhängige GPU-Hersteller in den Bereich der Superknoten eintreten, tauchen neue Probleme auf: Wie groß soll ein Superknoten überhaupt gebaut werden? Wer zahlt für diese teuren Investitionen?
Auf der Industriemesse beschwerte sich ein Investor eines lokalen intelligenten Rechenzentrums gegenüber einem Reporter der *IT Times*: Fast jedes Jahr bringen Chiphersteller neue Generationen von Produkten auf den Markt. Ein intelligentes Rechenzentrum benötigt von der Planung über den Bau bis zur Inbetriebnahme oft zwei Jahre oder sogar länger. Wenn die Geräte endlich für externe Dienste bereitstehen, ist das Produkt möglicherweise bereits zur nächsten Generation weiterentwickelt worden, und Kunden wünschen sich dann häufig die neuesten Rechenchips. Diese Verzögerung des Investitionszyklus ist derzeit das größte Problem einiger marktorientierter „Rechenfabriken“.
Aus dem von verschiedenen inländischen GPU-Herstellern veröffentlichten Zeitplan geht hervor, dass mit der zunehmenden Reife der Superknoten-Technologie von Ende dieses Jahres bis zum nächsten Jahr eine Reihe von Produkten kommerziell eingeführt wird. Neben Leistung und Preis werden die stabile Lieferfähigkeit, der Reifegrad des Software- und Hardware-Ökosystems sowie die Fähigkeit, Rechenzentren tatsächliche Geschäfte und Kunden zu bringen, den langfristigen Kommerzialisierungsprozess beeinflussen.
Superknoten werden immer größer gebaut
Seit Huawei im Juli 2025 auf der Weltkonferenz für künstliche Intelligenz (WAIC) 2025 erstmals das physische Modell des Ascend 384-Superknotens offline vorstellte, sind Superknoten bis zur neuen WAIC im Juli 2026 zum zentralen Ausstellungspunkt aller inländischen GPU-Hersteller geworden. Huawei erklärte sogar auf der anschließenden Konnektivitätskonferenz, dass Superknoten-Cluster mit bis zu einer Million Karten erreicht werden können.
Drei Monate später konzentrierten sich die Hersteller auf der Industriemesse erneut auf Superknoten.
Nach Besuchen der Stände mehrerer inländischer Hersteller von Rechenchips stellte der Reporter der *IT Times* fest, dass obwohl alle als Superknoten bezeichnet werden, die von den Herstellern gewählten Vernetzungsmaßstäbe, Gesamtsystemarchitekturen und Softwareökosysteme unterschiedlich sind. Hinter diesen Unterschieden lassen sich auch die unterschiedlichen Einschätzungen der Hersteller über die zukünftige Entwicklungsrichtung großer Modelle und die tatsächliche Marktnachfrage erkennen.
Der offensichtlichste Unterschied lautet: Wie viele GPUs braucht ein Superknoten pro Schrank?
Auf dem Stand von Iluvatar sind 144 GPUs und 18 CPUs in einem 44U hohen Schrank integriert, mit einem gesamten Videospeicher von etwa 10,1 TB. Nach Angaben von Iluvatar erreicht dieser Tianhai 300 IXL144 eine Kommunikationslatenz von 100 Nanosekunden pro Sprung, und in spezifischen All-to-All-Kommunikationsszenarien von Mixture-of-Experts-Modellen (MoE) kann die effektive Bandbreite um 15 % erhöht werden.
Zuvor waren 128 Karten pro Schrank zu einer repräsentativen Hochdichte-Lösung für inländische GPU-Hersteller geworden. Hersteller wie Moore Threads, Biren Technology und Alibaba Cloud haben Produkte in diesem Umfang entwickelt, und die OEX-Architektur von ZTE unterstützt ebenfalls maximal 128 Karten pro Schrank.
Warum fügt Iluvatar 16 weitere Karten hinzu? Ein Mitarbeiter des Standes erklärte dem Reporter der *IT Times*, dass die 144 GPUs des Tianhai 300 IXL144 gleichzeitig an der Berechnung teilnehmen können. Durch die Erhöhung der Rechenleistungsdichte pro Schrank wird der Bedarf zukünftiger supergroßer Modelle an Rechenressourcen und Videospeicherkapazität gedeckt. Für Kunden bedeutet dies nicht nur eine Erhöhung der Rechenleistung pro Schrank, sondern trägt auch dazu bei, die Nutzungseffizienz von Raum im Rechenzentrum und zugehörigen Einrichtungen zu verbessern und die wirtschaftliche Effizienz des Systems zu steigern, wenn die Rechenressourcen vollständig ausgenutzt werden.
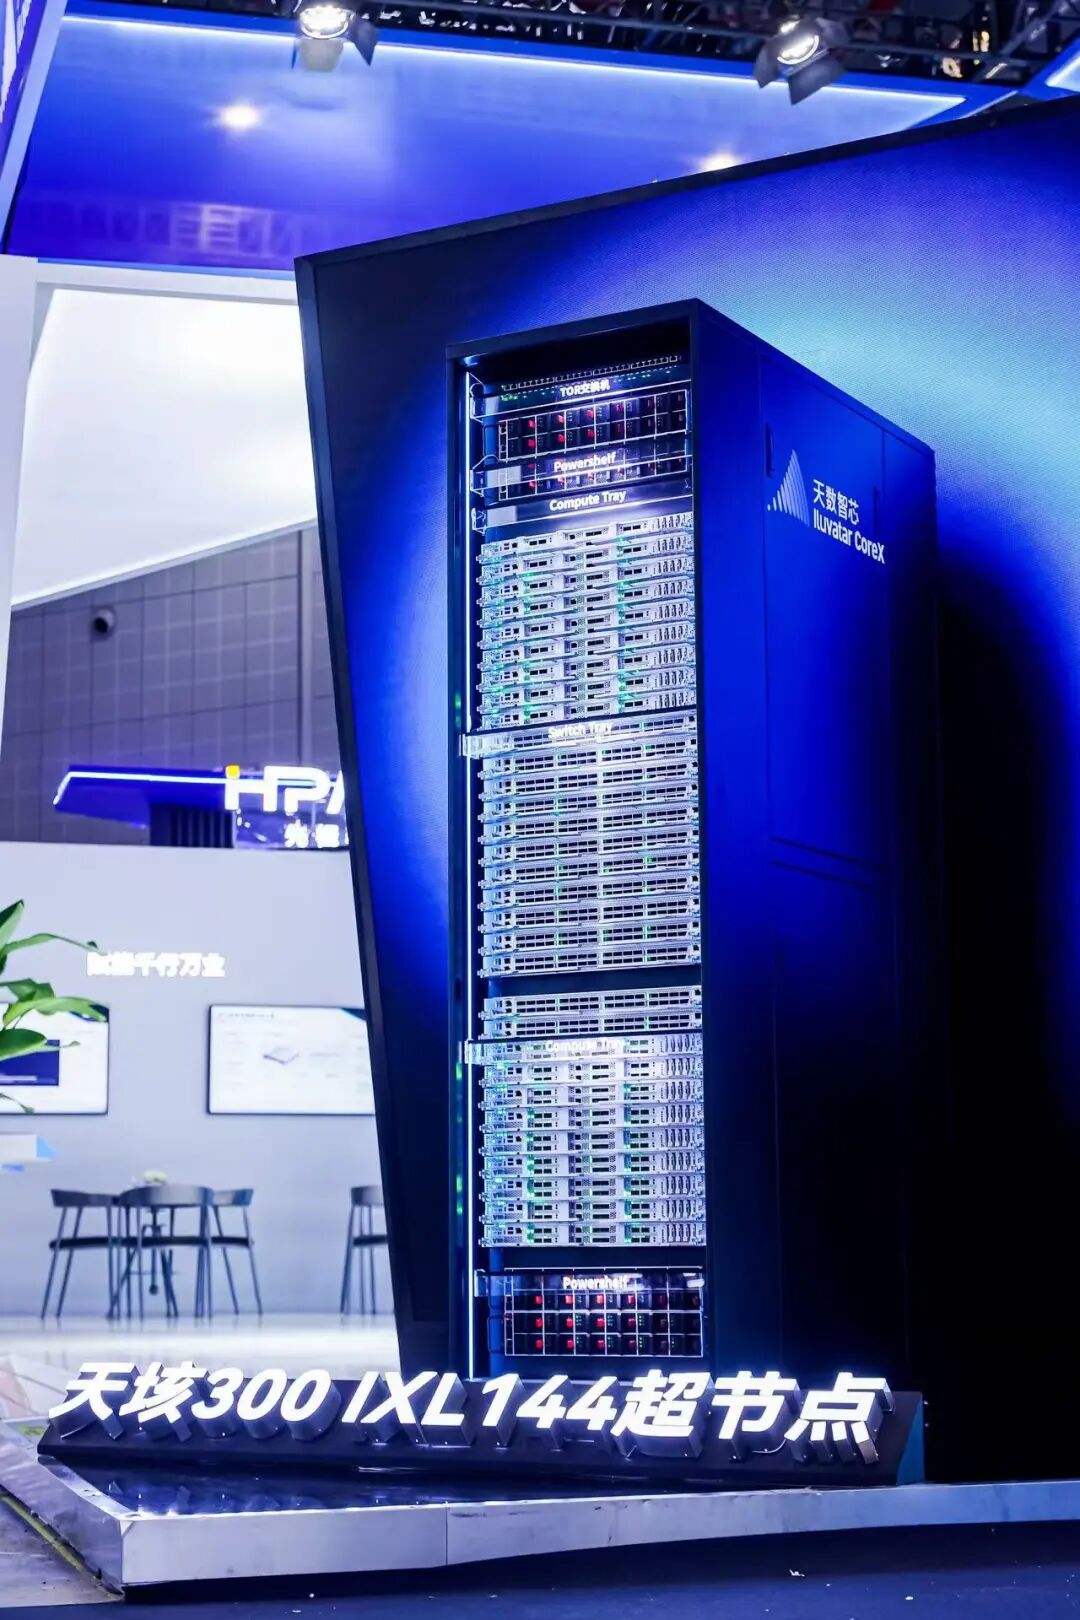
Darüber hinaus berücksichtigt die Konfiguration mit 144 Karten auch die Zuverlässigkeit des Betriebs großer Modelle. Die parallele Berechnung großer Modelle wird normalerweise nach Potenzen von 2 unterteilt, wobei 64 Karten und 128 Karten übliche Berechnungsmaßstäbe sind. Wenn jedoch alle 128 Karten für Berechnungsaufgaben verwendet werden, kann ein Ausfall eines einzelnen Knotens den Betrieb der gesamten Aufgabe beeinträchtigen. Daher kann das IXL144 je nach Aufgabenanforderungen die Konfiguration verwenden, bei der 128 Karten die Hauptberechnungsaufgabe übernehmen und 16 Karten redundante Ressourcen bereitstellen, um flexibel zwischen Rechenleistungsnutzung und Betriebssicherheit zu balancieren.
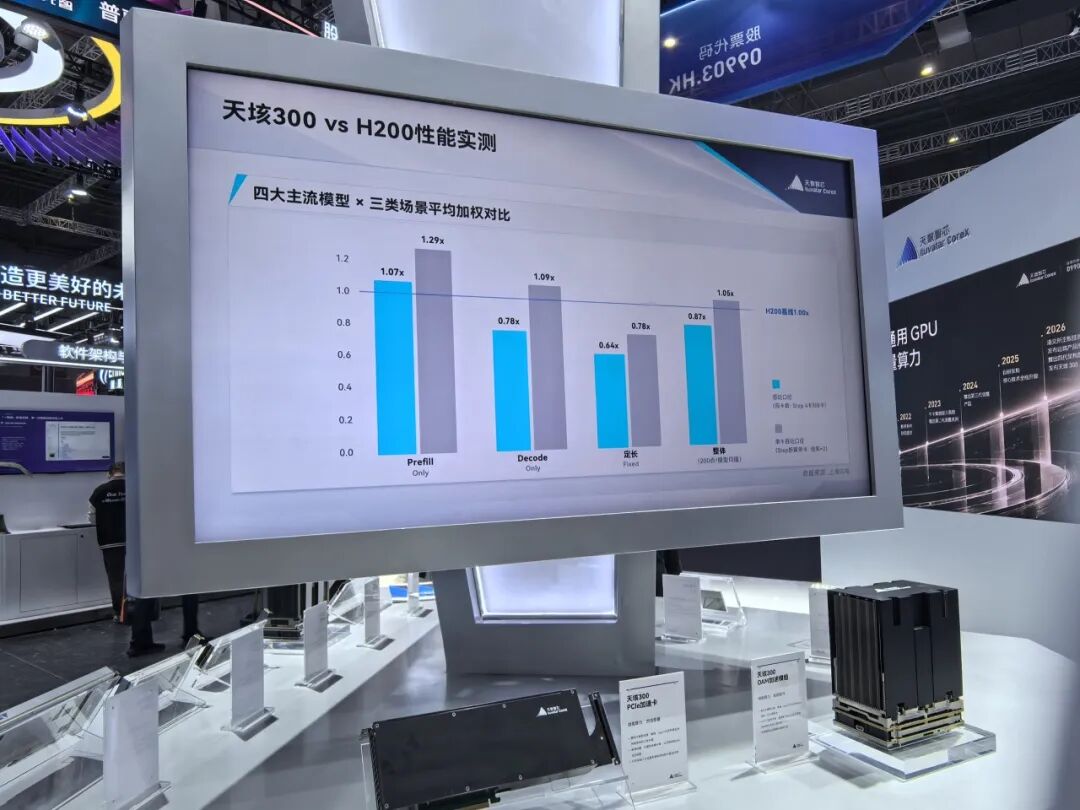
Die Weiterentwicklung großer Modelle verändert die Designlogik von Rechensystemen. Im Juli dieses Jahres erreichte die Gesamtparameterzahl des von Moonshot AI veröffentlichten Kimi K3 bereits 2,8 Billionen. Auf dem Yunqi-Kongress im September gab Alibaba bekannt, dass das nächste Modell Qwen 4 trainiert wird, und das Ziel für den Parameterumfang zukünftiger Modelle auf 5 Billionen bis 10 Billionen festgelegt wurde.
Je größer das Modell ist, desto komplexer werden die zu lösenden Probleme. In der Trainingsphase müssen zahlreiche GPUs häufig Gradienten und Zwischenergebnisse der Berechnung austauschen. In der Inferenzphase muss das System auch bei Verwendung der MoE-Architektur, die jeweils nur einen Teil der Parameter aktiviert, riesige Modellgewichte speichern und verwalten. Insbesondere mit zunehmender Kontextlänge steigt der Speicherbedarf des KV-Cache stetig an.
Iluvatars Entscheidung für die Vernetzung von 144 Karten in einem Schrank zielt genau darauf ab, Raum für diese Nachfrage zu lassen. Nach Angaben des oben genannten Mitarbeiters des Iluvatar-Standes wurde der Tianhai 300 IXL144 bei der Entwicklung auf den Betriebsbedarf zukünftiger Modelle mit 10 Billionen Parametern ausgelegt.
Natürlich gibt es hinter diesem Design auch kommerzielle Überlegungen. Mit der Entwicklung inländischer quelloffener oder gewichtsoffener Modelle wie DeepSeek und Qwen wird die lokale Bereitstellung von „inländischen Chips + inländischen Modellen“ zu einem beachtenswerten technischen Weg für Szenarien wie supergroße staatliche Unternehmen, zentralstaatliche Unternehmen und intelligente Regierungsplattformen mit hohen Anforderungen an Datensicherheit und eigenständige Kontrolle. Dies bietet inländischen GPU-Herstellern auch Marktchancen abgesehen von Trainingsclusteraufträgen großer Internetunternehmen, AIDC von Telekommunikationsbetreibern und Rechenfabriken.
Enflame und MetaX stellten vor allem 64-Karten-Lösungen aus. Während der Interviews betonten die Mitarbeiter beider Unternehmen, dass sie die Bereitstellungsanforderungen verschiedener Kunden in der aktuellen Phase erfüllen wollen.
Der Xijing S600 von MetaX verwendet eine vollständig vernetzte Architektur mit 64 GPUs pro Schrank, die orthogonale Verbinder und Austauschstrukturen nutzt, um die Kabelverbindungen innerhalb herkömmlicher Schränke zu reduzieren. Yang Jian, Mitbegründer und CTO von MetaX, erklärte zuvor: Die gängige praktische Konfiguration der Branche basiert auf 32 Karten, aber unter Berücksichtigung der Nachfrage in den nächsten drei bis vier Jahren sind 64 Karten erforderlich.
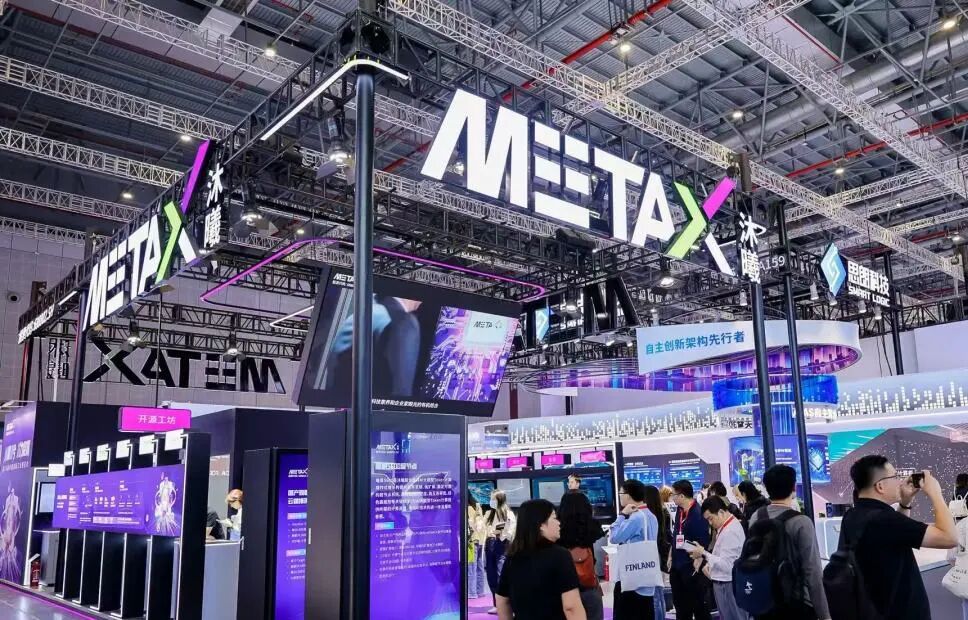
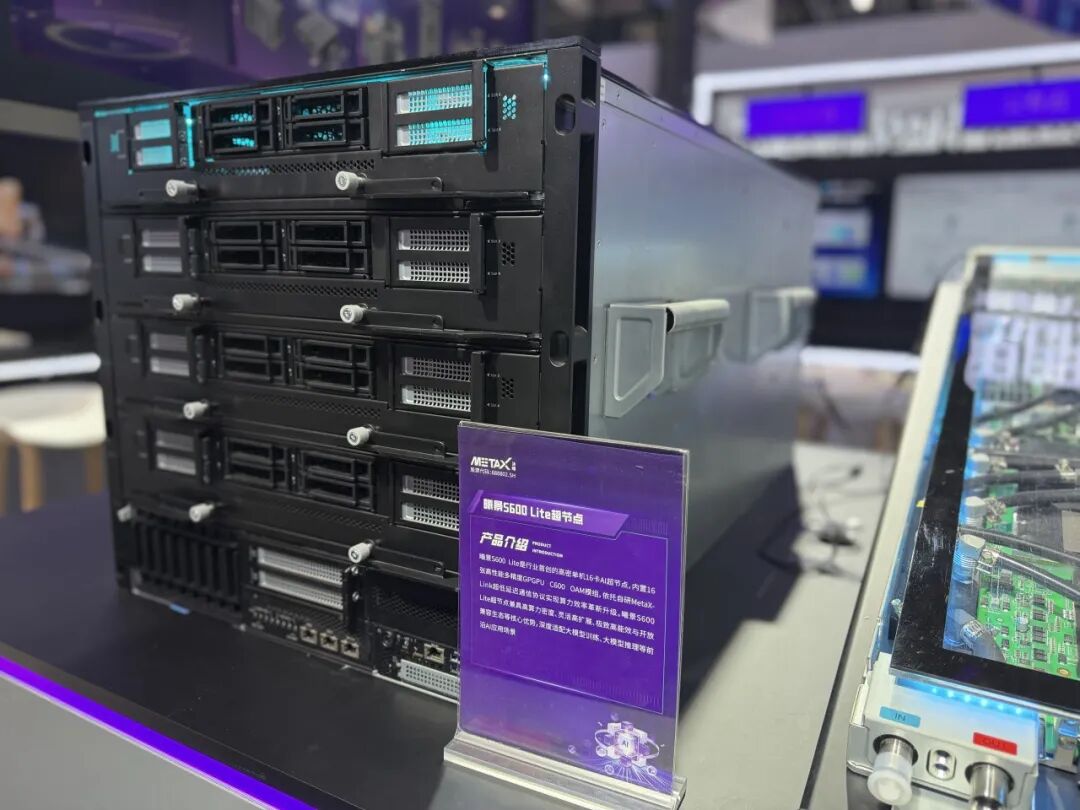
Auf der Messe stellte MetaX auch die Xijing S600 Lite 16-Karten-Superknoten-Lösung vor. Ein Mitarbeiter von MetaX erklärte dem Reporter der *IT Times*, dass dieses Produkt darauf abzielt, die relativ leichten Rechenanforderungen verschiedener Nutzer zu erfüllen. Die Integration von 16 GPUs verwendet ebenfalls die Hochgeschwindigkeitsvernetzung MetaXLink und die kabellose Architektur, hat aber ein Volumen, das kaum von dem herkömmlicher 8-Karten-Server abweicht. Es kann als relativ komplette Gesamtsystemlösung geliefert werden und bietet Kunden, die keine großen Rechencluster auf einmal aufbauen müssen, eine weitere Alternative.
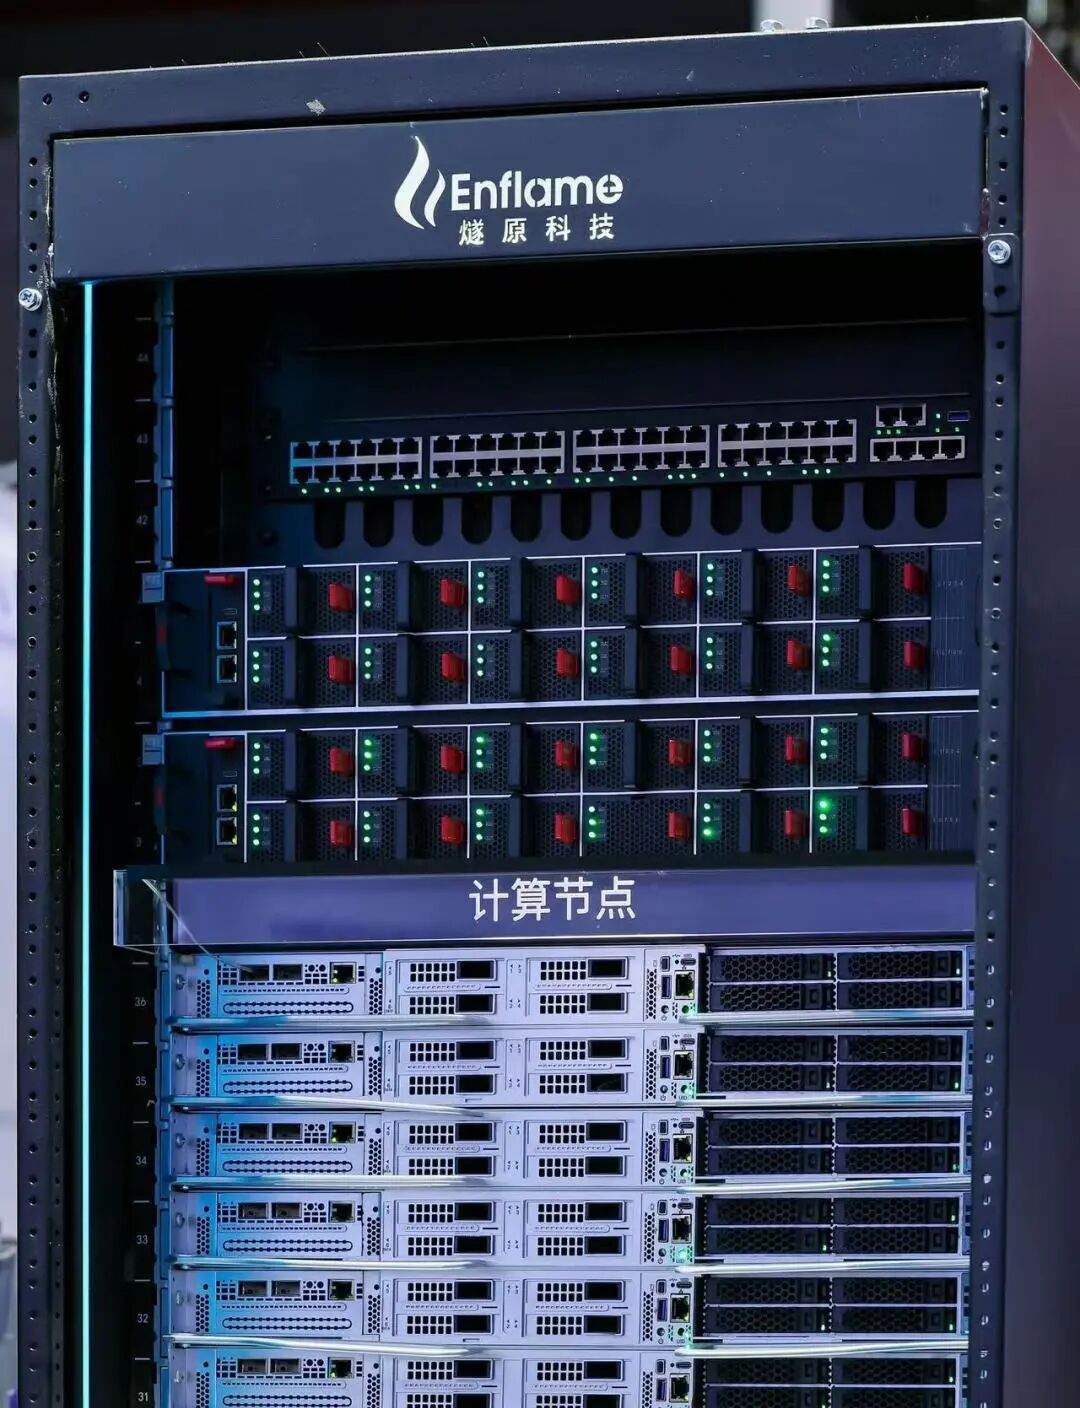
Der 64-Karten-Superknoten von Enflame wurde in Zusammenarbeit mit ZTE entwickelt. Nach Angaben des Standmitarbeiters liefert Enflame hauptsächlich die GPU-Chips, während ZTE die Aufgaben wie Schrankarchitektur, Gesamtsystemintegration und Lieferung übernimmt.
„Wir berücksichtigen zuerst die Möglichkeit der tatsächlichen Umsetzung.“ Als der Reporter der *IT Times* fragte, warum nicht direkt ein 128-Karten-Superknoten auf den Markt gebracht wird, sagte ein Mitarbeiter des Enflame-Standes: Aus technischer Sicht ist die weitere Erweiterung des Vernetzungsmaßstabs nicht unmöglich zu realisieren. Aber eine Erhöhung der Kartenzahl bedeutet einen höheren Gesamtkaufpreis des Systems. Ob Kunden bereit sind, dafür zu zahlen, ist ein Problem, das berücksichtigt werden muss.
Dies führt auch zu einem scheinbar widersprüchlichen Dilemma für Superknoten: Einerseits versuchen Hersteller, mehr GPUs miteinander zu verbinden, da der Parameterumfang großer Modelle und die Rechenanforderungen wachsen. Andererseits gibt es derzeit nur begrenzte Anwendungsszenarien, die tatsächlich eine so große Vernetzung erfordern und deren Leistungsvorteile voll ausnutzen können.
Warum sollte man „deinen“ Superknoten kaufen?
Selbst wenn Kunden tatsächlich große Rechenkapazität benötigen, müssen inländische GPU-Hersteller eine weitere, realistischere Frage beantworten: Warum soll man dein Produkt kaufen?
Aus der aktuellen Marktstruktur ist dies keine einfach zu beantwortende Frage.
Laut einem IDC-Bericht, der am 13. Oktober von Reuters zitiert wurde, erreichte die Liefermenge von KI-Beschleunigerchips für chinesische Rechenzentren im ersten Halbjahr 2026 2,008 Millionen Stück. Davon lieferte Nvidia 678.000 Stück aus, was 34 % des gesamten Marktes entspricht; Huawei lieferte 572.000 Stück aus, was 28 % entspricht. Die Abteilung von Alibaba, T-Head, macht etwa 7 % aus, und andere inländische Chiphersteller kämpfen ebenfalls um verschiedene Arten von Rechenanforderungen.
Bemerkenswert ist, dass nach dieser Statistik die Liefermenge chinesischer GPUs 991.000 Stück erreichte, was einem Rückgang von 26 % gegenüber dem Vorjahr entspricht, während die Liefermenge anderer Arten von KI-Beschleunigerchips 1,016 Millionen Stück erreichte, was einem Anstieg von fast 80 % gegenüber dem Vorjahr entspricht.
Obwohl IDC der Ansicht ist, dass der Rückgang der GPU-Liefermenge darauf zurückzuführen ist, dass die auf dem chinesischen Festland verkaufbaren GPUs nach wie vor begrenzt sind, ist unbestreitbar, dass der inländische Rechenmarkt wächst und sich differenziert. Huawei Ascend hat bereits ein Produktsystem aufgebaut, das Chips, Server, Softwareframeworks und Entwicklungswerkzeuge abdeckt; Unternehmen wie Alibaba und Baidu verfügen über Cloud-Computing, große Modelle und interne Geschäftsszenarien,