Gerade eben hat das Mac Studio das leistungsstärkste Open-Source-Modell von Mark Zuckerberg erhalten, und Apple hat endlich die unerwartetste Unterstützung bekommen, auf die es gewartet hat.
Mark Zuckerberg spottete einst über Apple, dass es nach dem iPhone nichts Bemerkenswertes mehr erfunden habe. Heute postet er freiwillig ein Foto, das zeigt, dass Meta AI auf dem Mac arbeitet, und dankt Apple und dem neuen CEO John Ternus für die Unterstützung.
Was beide Seiten zusammengebracht hat, ist ein großes Modell mit 816 Milliarden Parametern und das gemeinsame Ziel, es auf den Schreibtisch der Nutzer zu bringen.
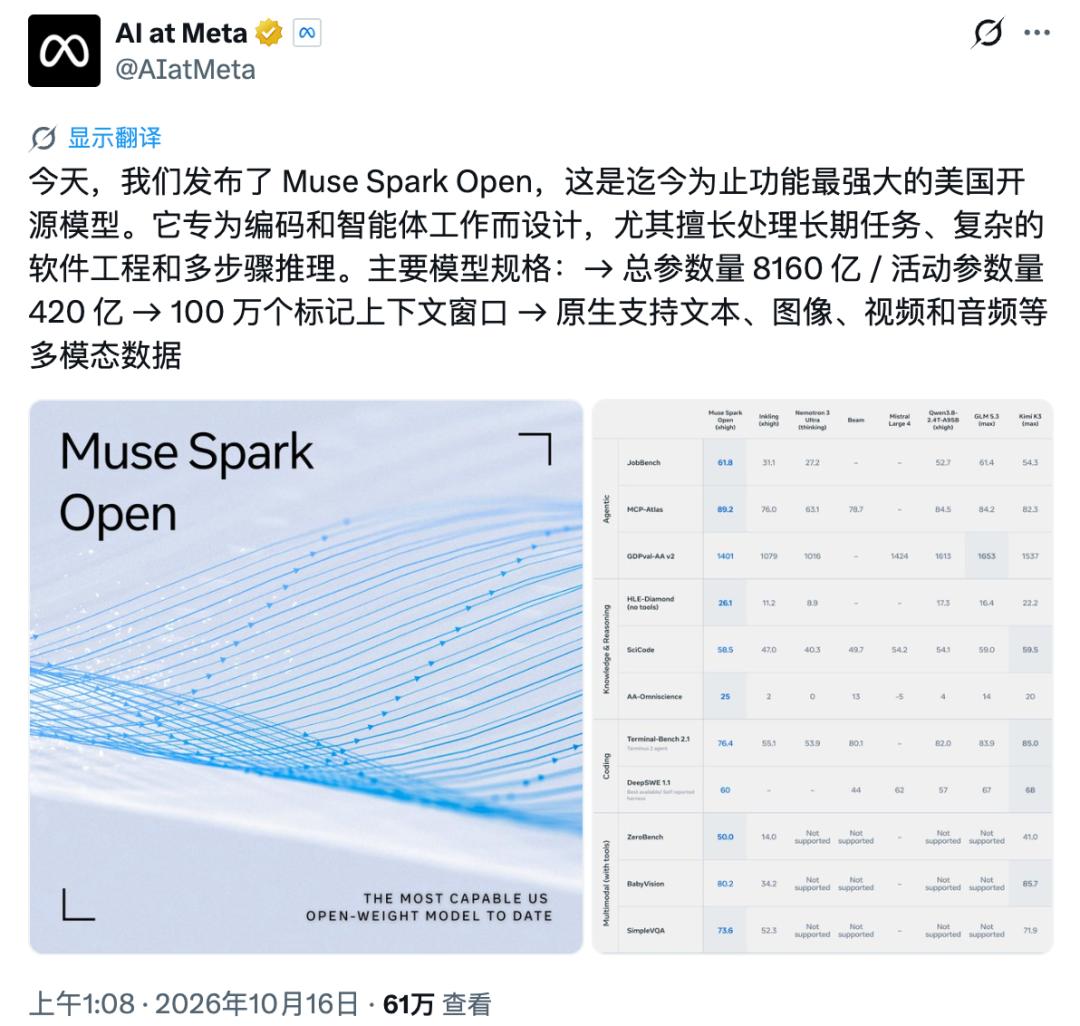
In den frühen Morgenstunden heute hat Meta das gewichtsoffene Modell Muse Spark Open veröffentlicht und gemeinsam mit Apple die Lösung für seinen Betrieb auf zwei oder vier Mac Studio vorgeführt. Entwickler können das Modell lokal nutzen, um Code zu schreiben, Videos zu analysieren und Agentenaufgaben auszuführen, wobei der Inferenzprozess nicht über die Server des Modellanbieters läuft.
Da KI zunehmend private Dateien und Unternehmensdaten verarbeitet, wird es immer wichtiger, wo die Daten verarbeitet werden und wer die Kontrolle darüber hat. Offene Modelle und lokale KI ergänzen sich perfekt: Nutzer können das Modell selbst bereitstellen und die Inferenz auf ihren eigenen Geräten durchführen.
Die seit Jahren von Apple entwickelten eigenen Chips, der einheitliche Arbeitsspeicher und die Entwicklungswerkzeuge erhalten dadurch ihren Einsatzbereich. Heute läuft das Modell mit 816 Milliarden Parametern auf dem Schreibtisch, was den Mac einen Schritt näher zum bevorzugten PC im KI-Zeitalter bringt.
Zuckerberg bringt das neue Modell, Apple hat die Computer bereit
Die Veröffentlichung von Muse Spark Open erfüllt ein früheres Versprechen von Mark Zuckerberg.
Im August dieses Jahres stellte Meta das kleinere gewichtsoffene Modell Muse Glimmer vor. Damals erklärte Zuckerberg, dass später noch größere und leistungsstärkere Modelle veröffentlicht werden. Heute ist dieses Versprechen mit Muse Spark Open, das über 816 Milliarden Parameter verfügt, in Erfüllung gegangen.
Die Fähigkeiten des neuen Modells Muse Spark Open nähern sich denen von Muse Spark 1.3 an. Meta bezeichnet es sogar als das derzeit leistungsstärkste in den USA entwickelte gewichtsoffene Modell.
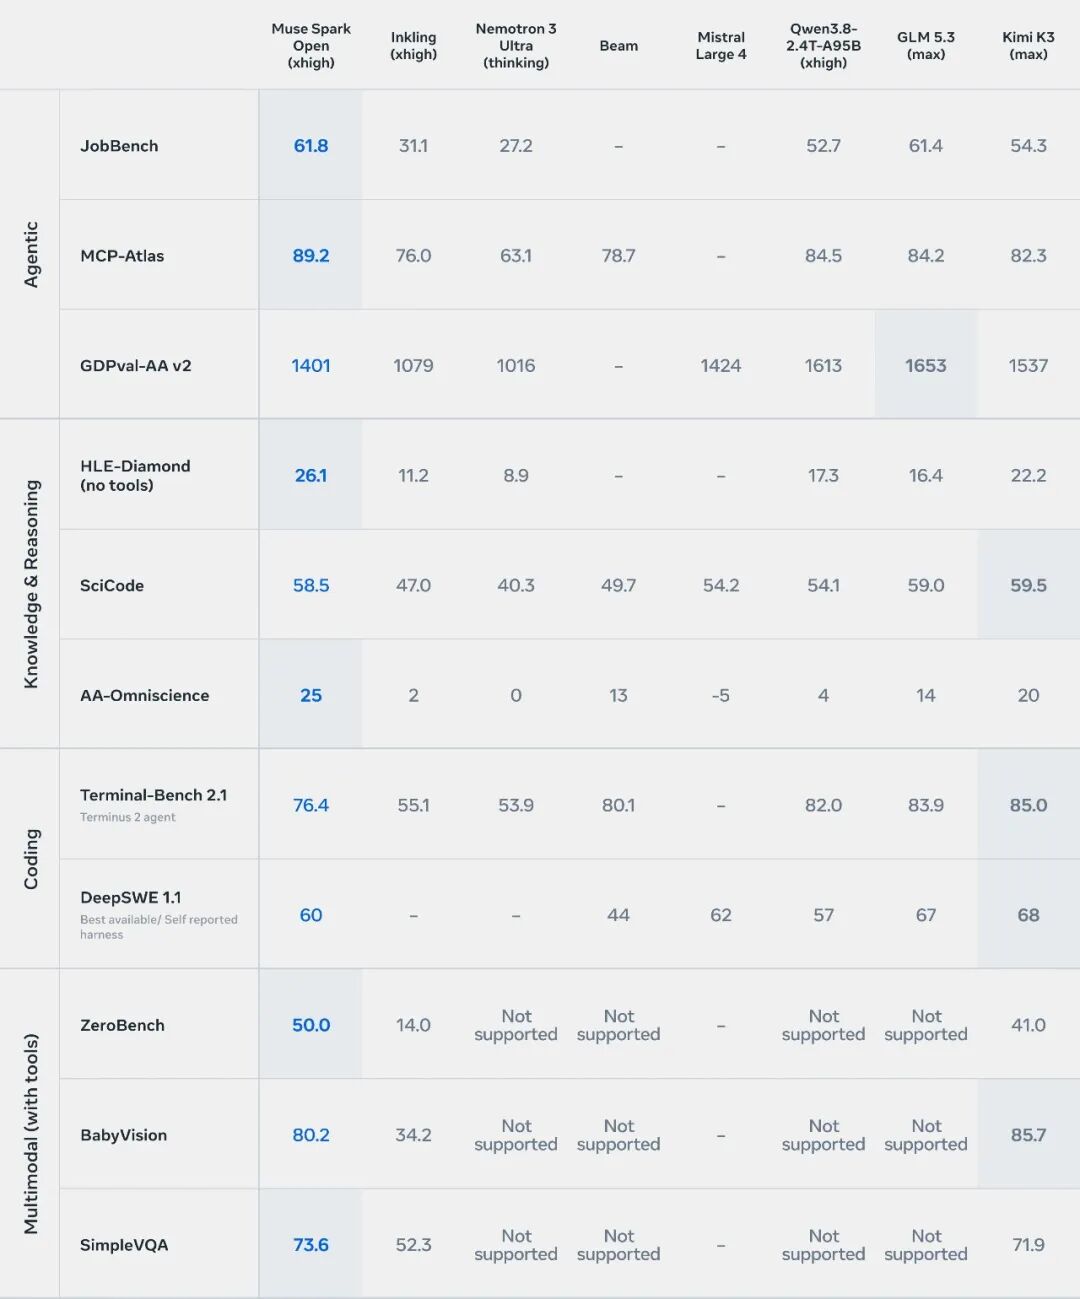
Entwickler können die Modellgewichte herunterladen und auf ihrer eigenen Hardware bereitstellen oder sie über Cloud-Dienste und Entwicklungswerkzeuge nutzen. Seine Lizenz erlaubt die kommerzielle Nutzung in einem bestimmten Rahmen und bietet Unternehmen Spielraum für die eigene Bereitstellung und Entwicklung von Anwendungen.
Alexandr Wang, Leiter von Meta AI, erklärt, dass die Fähigkeiten von Muse Spark Open immer noch unter denen des geschlossenen Modells Muse Wonder liegen, das Anfang dieser Woche veröffentlicht wurde. Dennoch verleihen die offenen Gewichte ihm eine weitere Attraktivität: Entwickler können selbst die Laufumgebung wählen, das Modell erforschen und Anwendungen entsprechend den tatsächlichen Anforderungen gestalten.
Meta hofft, dass diese Versuche in kleinem Maßstab beginnen und dann schrittweise ausgeweitet werden. Die Beteiligung von Apple bietet Entwicklern eine klare Lösung für den lokalen Betrieb.
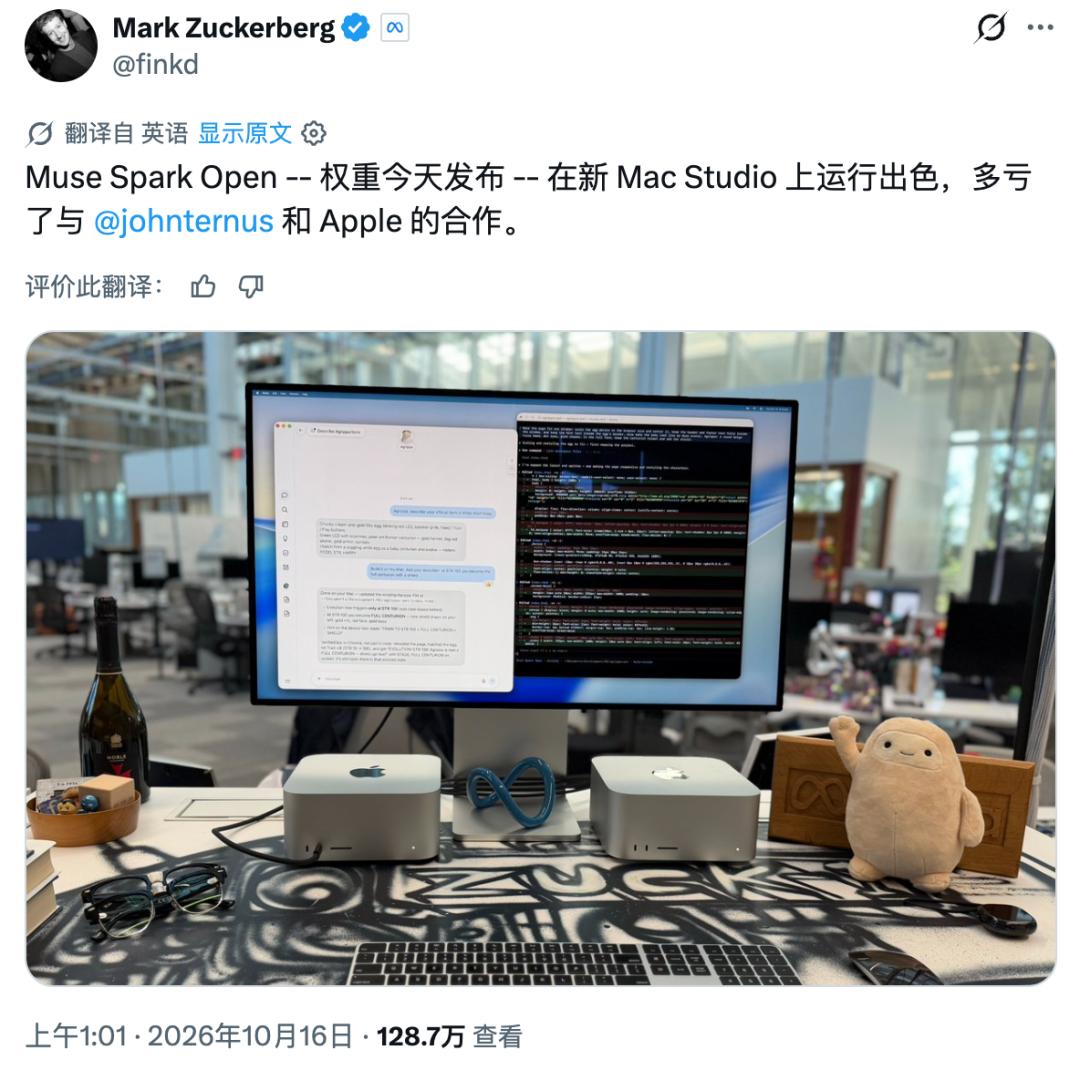
Mark Zuckerberg hat auf X ein Foto gepostet, das zeigt, dass der Meta-Agent auf dem Mac arbeitet, und erklärt, dass Muse Spark Open noch am selben Tag die offenen Gewichte freigibt – dank der Zusammenarbeit mit Ternus und Apple läuft es auf dem neuen Mac Studio sehr gut.
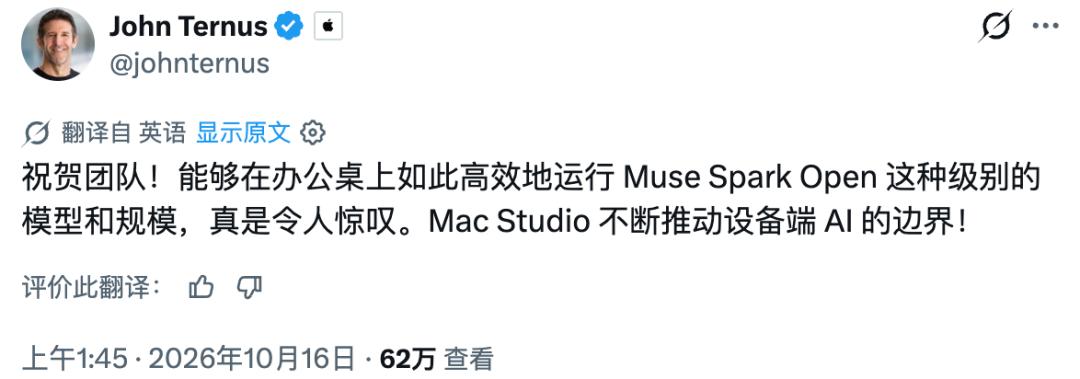
Ternus antwortete darauf, dass es begeisternd sei, Modelle dieser Größe und Leistungsfähigkeit so effizient auf dem Schreibtisch betreiben zu können, und betonte, dass Mac Studio die Grenzen der geräteintegrierten KI weiter vorantreibt.
Wang gab eine sehr lebendige Bewertung der Zusammenarbeit der beiden Unternehmen ab. Er scherzte gegenüber Axios, dass alle froh seien, zu sehen, dass „Mama und Papa endlich wieder gut miteinander auskommen“.
Nach seinen Angaben arbeiten die beiden Seiten bereits seit Monaten zusammen, wobei Daniel Gross, der früher bei Apple tätig war und jetzt zu Meta gewechselt ist, eine wichtige Rolle spielt. Insbesondere hat Meta bereits Anfang dieses Jahres Hunderte von Macs gekauft, damit das Superintelligenz-Team lokale KI und Agentenanwendungen erforschen kann.
Der bemerkenswerteste Punkt der Zusammenarbeit ist, dass eine neue Beziehung zwischen den Modellfähigkeiten und den Nutzerdaten aufgebaut werden kann.
Nach Worten von Wang kann Meta den Inhalt der Nutzung nicht sehen oder kontrollieren, wenn Entwickler das Modell auf ihren eigenen Geräten ausführen. Nutzer erhalten die Fähigkeiten des Meta-Modells, während sie Prompts und Inferenzprozesse in ihrer eigenen kontrollierten Umgebung behalten.
Für Privatpersonen reduziert der lokale Betrieb die Übertragung privater Daten an externe Server. Für Unternehmen können Code, Dokumente und Geschäftsdaten auf selbst verwalteten Geräten verbleiben. Datenschutz- und Sicherheitsanforderungen werden dadurch zu einem praktischen Treiber für die lokale KI, und die offenen Gewichte machen diesen Weg umsetzbar.
816 Milliarden Parameter – wie werden sie auf mehrere Macs verteilt?
Um ein so riesiges Modell auf den Schreibtisch zu bringen, müssen zwei Probleme gelöst werden: ob der Computer es speichern kann und ob es nach der Speicherung schnell genug arbeiten kann.
Muse Spark Open nutzt eine Mixed-Experts-Architektur (MoE) mit insgesamt 816 Milliarden Parametern, wobei bei jeder Inferenz etwa 42 Milliarden Parameter aktiviert werden.
Es funktioniert wie ein großes Team von Experten: Bei der Verarbeitung unterschiedlicher Inhalte wird nur ein Teil der Experten für die Berechnung aktiviert. Dadurch behält das Modell eine große Gesamtkapazität bei und reduziert gleichzeitig die tatsächlich erforderliche Berechnungsmenge bei jedem Schritt.
Dennoch müssen die Parameter, die nicht an der aktuellen Berechnung beteiligt sind, gespeichert werden, um später aufgerufen zu werden. MoE reduziert die Rechenlast, aber der Speicherbedarf für das gesamte Modell ist immer noch beträchtlich.
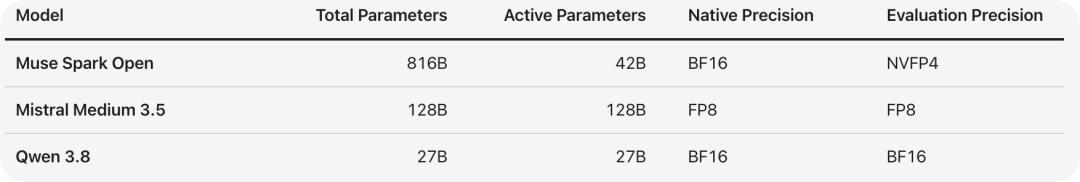
Nach Daten aus dem technischen Blog von Apple benötigen bei nativer BF16-Genauigkeit allein die Modellparameter von Muse Spark Open mehr als 1,6 TB Arbeitsspeicher.
Apple nutzt eine vierstufige Quantisierungsversion nach NVFP4, um den Speicherbedarf des Modells auf etwa 493 GB zu komprimieren. Quantisierung bedeutet, Parameter mit einer kompakteren numerischen Darstellung zu speichern, indem die numerische Genauigkeit reduziert wird, um einen geringeren Speicherbedarf zu erzielen.
Trotzdem ist ein einzelner Mac Studio mit 512 GB einheitlichem Arbeitsspeicher kaum in der Lage, dies problemlos zu bewältigen. Neben den Modellgewichten belegen temporäre Berechnungsdaten während der Inferenz, der KV-Cache sowie das Betriebssystem und das Ausführungsframework zusätzlichen Arbeitsspeicher.
Die Zusammenarbeit mehrerer Macs wird daher der nächste Schritt.
In der von Apple vorgeführten Multi-Geräte-Inferenzlösung nutzt MLX hauptsächlich zwei Parallelisierungsverfahren. Das leichter verständliche ist die Pipeline-Parallelisierung: Der vordere Teil des Modells wird auf einem Mac abgelegt, der hintere Teil auf einem anderen. Nachdem der erste Mac die Berechnung abgeschlossen hat, gibt er das Ergebnis an den zweiten Mac zur weiteren Verarbeitung weiter.
Diese Methode ermöglicht es zwei Computern, gemeinsam ein großes Modell aufzunehmen, aber die Berechnungen hängen voneinander ab: Der zweite Computer muss auf das Ergebnis des ersten warten, sodass die Geräte nicht ständig gleichzeitig arbeiten können.
Die Tensor-Parallelisierung verteilt die Berechnungen innerhalb derselben Schicht auf mehrere Geräte, sodass sie gemeinsam teilnehmen und dann die Ergebnisse austauschen und zusammenfassen.
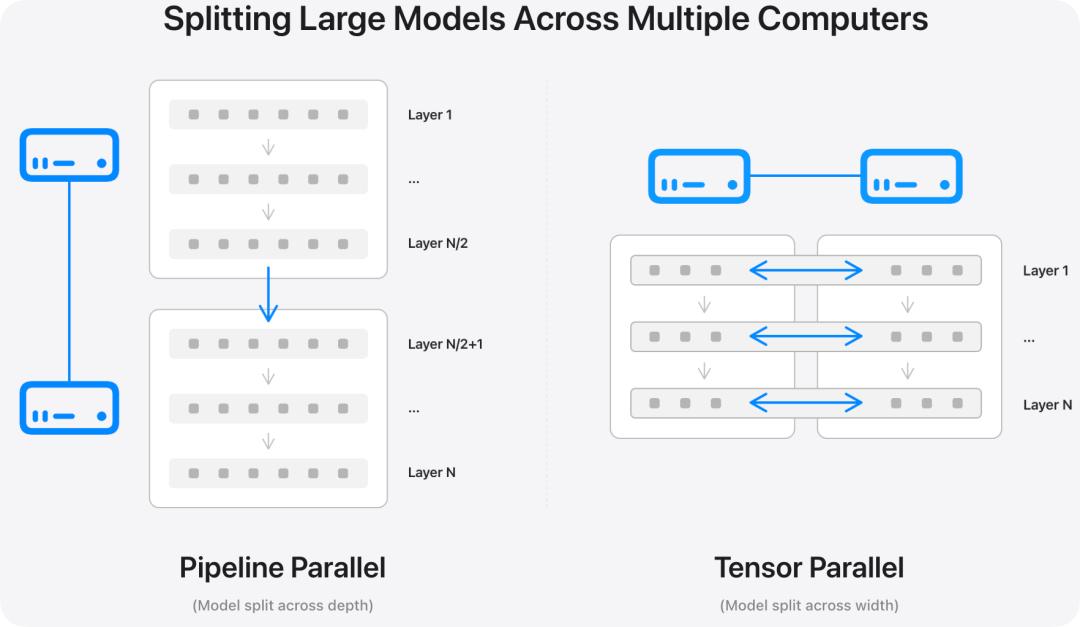
Mehr Geräte können gleichzeitig arbeiten, sodass die Maschinen häufiger Daten austauschen müssen. Wenn die Übertragung zu langsam ist, geht die hinzugewonnene Rechenleistung im Warten verloren.
Apple nutzt dafür die RDMA-Kommunikation über Thunderbolt 5, um die Latenz beim Datenaustausch zwischen mehreren Geräten zu senken, während MLX die Berechnungen koordiniert. In der im Blog gezeigten Zwei-Geräte-Konfiguration sind die beiden Macs über zwei Thunderbolt-Kabel verbunden, um die Link-Bandbreite zu erhöhen.
Der daraus resultierende Leistungsunterschied zeigt deutlich den Wert dieser Kooperationsmethode.
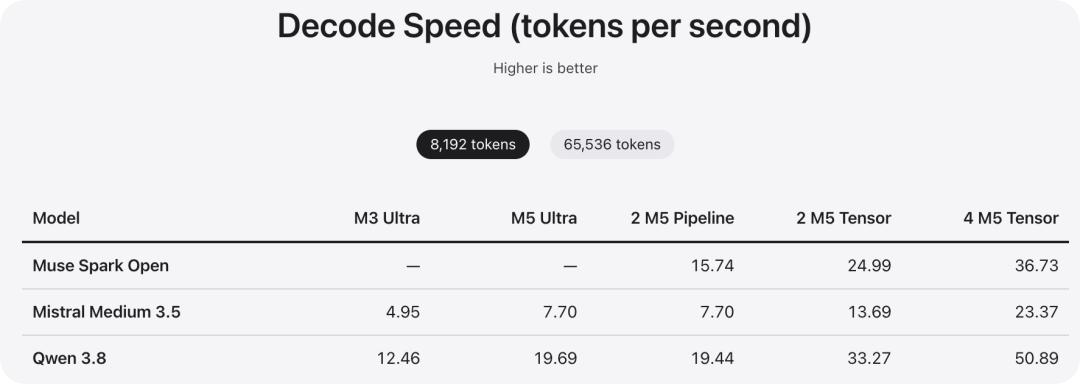
In einem Test mit einem Eingabekontext von 8192 Tokens und anschließender Generierung von 128 Tokens erreichte Muse Spark Open bei zwei M5 Ultra Mac Studio mit Pipeline-Parallelisierung eine Generierungsgeschwindigkeit von etwa 15,74 Tokens pro Sekunde.
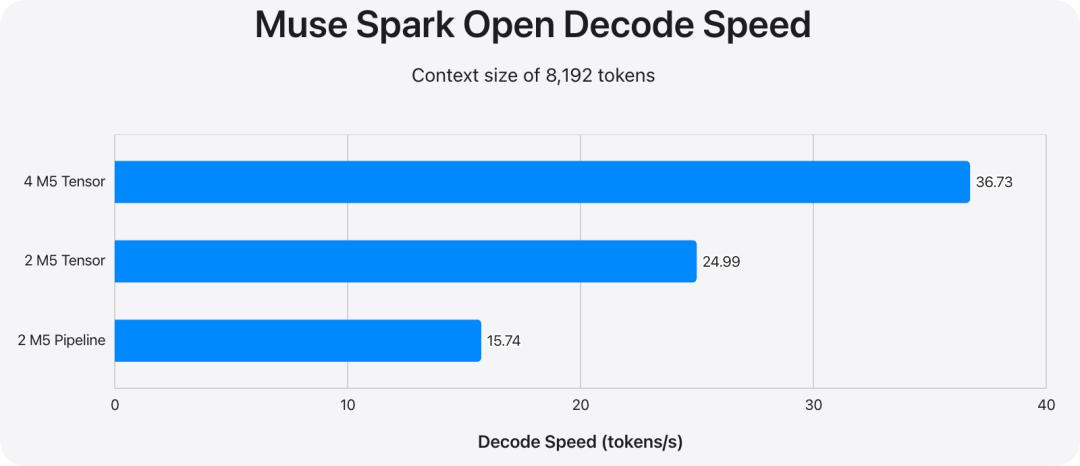
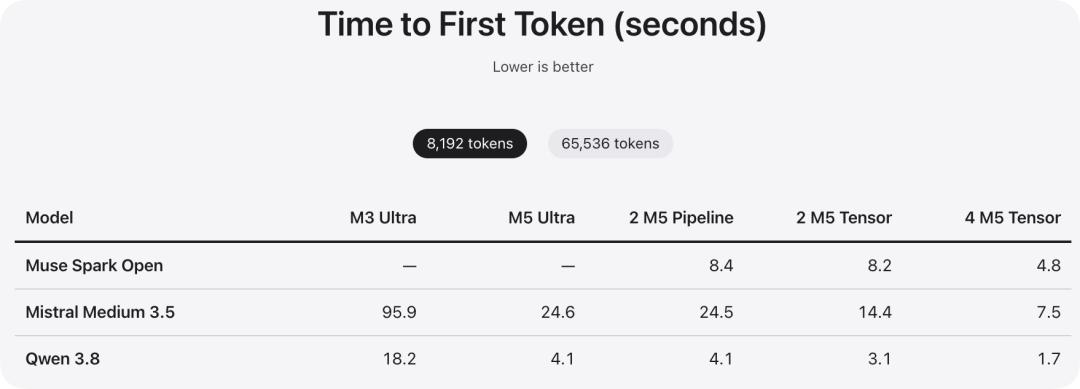
Bei Umstellung auf Tensor-Parallelisierung stieg die Geschwindigkeit der beiden Geräte auf 24,99 Tokens pro Sekunde, was einer Steigerung von fast 60 % entspricht. Bei weiterer Erweiterung auf vier Geräte erreichte die Geschwindigkeit 36,73 Tokens pro Sekunde, und die Wartezeit für das erste Token sank von etwa 8,2 Sekunden bei der Zwei-Geräte-Tensor-Parallelisierung auf etwa 4,8 Sekunden.
Von der Speicherfähigkeit bis zur interaktiven Geschwindigkeit für den praktischen Einsatz beruht alles auf einem gesamten Zusammenspiel von Hardware und Software.
Die einheitliche Speicherarchitektur ermöglicht es CPU und GPU, sich die Speicherressourcen zu teilen. Die große Speicherkapazität bietet Speicherplatz für das Modell, die hohe Bandbreite unterstützt das kontinuierliche Lesen von Daten, und MLX sowie die Thunderbolt-Verbindung ermöglichen es mehreren Computern, Aufgaben gemeinsam zu bewältigen.
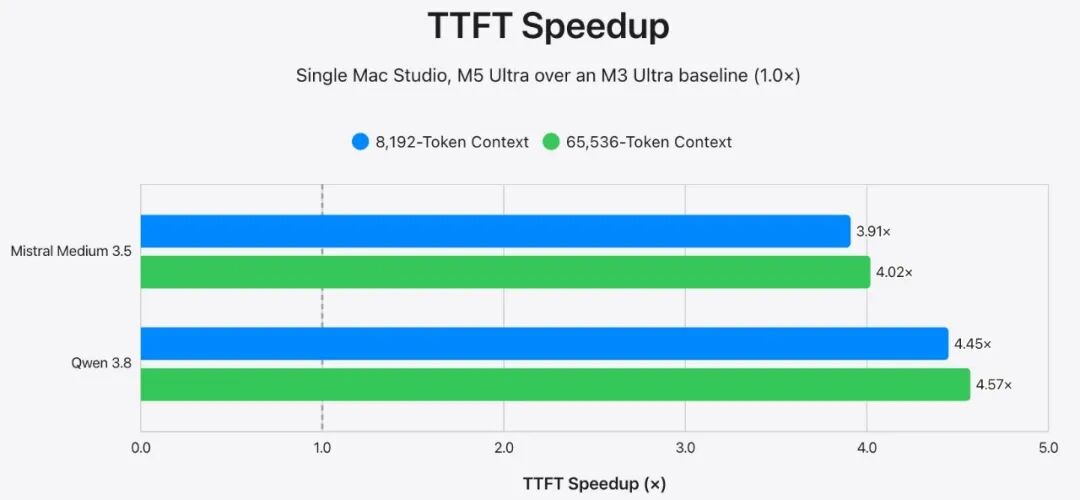
M5 Ultra hat die Bandbreite des einheitlichen Arbeitsspeichers von 819 GB/s bei M3 Ultra auf 1,2 TB/s erhöht. Die in die GPU der M5-Serie integrierten Neural Accelerators dienen dazu, Matrixoperationen zu beschleunigen und die Recheneffizienz bei der Verarbeitung des Eingabekontexts zu verbessern.
Diese beiden Änderungen entsprechen zwei Schritten, die Nutzer wahrnehmen können: Wie lange man nach dem Einreichen eines langen Textes warten muss, bis die Antwort beginnt, und wie schnell der Inhalt danach ausgegeben wird.
In den Einzelgerätetests von Apple für Qwen 3.8 und Mistral Medium 3.5 erreichte M5 Ultra im Vergleich zu M3 Ultra eine Geschwindigkeitssteigerung von bis zu 4,6-fach bei der Wartezeit für das erste Token und eine etwa 1,6-fache höhere Textgenerierungsgeschwindigkeit.