Auch kleine Teams können vortrainieren, Pulu 2B: Die Trainingskosten mit der RTX 5090 belaufen sich auf weniger als 5090 US-Dollar.
Es ist nicht möglich, ein K3 mit 2,8 T zu trainieren, man hat das NanoGPT mit 124 M ausprobiert und möchte nun das Vorabtraining mit Milliardenparametern und Billionen-Token testen – wie hoch ist die Hürde dafür?
Diese Art von Modellen wird weit verbreitet verwendet, beispielsweise die klassische Qwen-Serie (Qwen2-1.5B, Qwen2.5-1.5B, Qwen3-1.7B …).
Obwohl die Qwen-Serie die Gewichte als Open-Source veröffentlicht hat, ist das vollständige Vorabtraining-Rezept nicht vollständig öffentlich zugänglich. Projekte wie OLMo und SmolLM haben Daten und Trainingsdetails weiter offenlegt, aber die Reproduktion ist nach wie vor teuer: Schätzungsweise belaufen sich die Rechenkosten für die Reproduktion von OLMoE-1B/7B und SmolLM3-3B selbst bei Parametern im Milliardenbereich auf etwa 200.000 US-Dollar bzw. 719.000 US-Dollar.
Für gewöhnliche Labore reicht es nicht zu wissen, „wie man trainiert“, man muss auch wirklich „trainieren können, ohne bankrott zu gehen“. Wir brauchen ein kostengünstiges, reproduzierbares „Arme-Leute-Vorabtrainingsverfahren“.
Puro-2B: Das vollständig quelloffene „Arme-Leute-Vorabtrainingsverfahren“
Um dieses Problem zu lösen, hat das Team von Professor CHEN Wenguang und Professor LÜ Kaifeng der Tsinghua-Universität gemeinsam das vollständig quelloffene Puro-2B auf den Markt gebracht und die Trainingsdaten, das Trainingsframework, die Trainingskonfiguration und die Modellgewichte als Open-Source veröffentlicht.
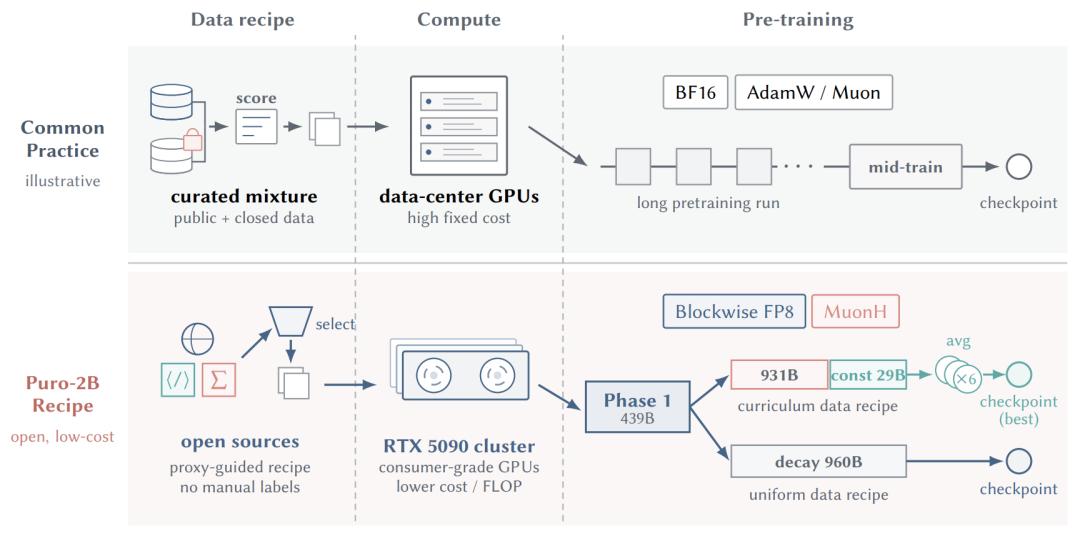
Abbildung 3 aus dem Papier | Der „Arme-Leute“-Trainingsablauf von Puro-2B
Sie haben ein Modell mit etwa 2 Milliarden Parametern von Grund auf auf einem Rechencluster aus Consumer-Grafikkarten vom Typ RTX 5090 trainiert und maximal 1,4 Billionen Token verwendet.
In einer umfassenden Bewertung mit 15 Aufgaben übertrifft das Modell auf Basis dieses Verfahrens bei einem Vorabtrainings-Rechenaufwand von etwa 4400 US-Dollar das Qwen2-1.5B bei den durchschnittlichen Kennwerten der 15 Aufgaben. Die beste Version mit Kosten von 6900 US-Dollar erreicht eine durchschnittliche Leistung, die nahe an der von Qwen2.5-1.5B liegt. Im Vergleich zu anderen Open-Source-Verfahren senkt Puro-2B die Trainingskosten erheblich.
Link zum Papier: https://arxiv.org/pdf/2608.27370
Sammlung der Open-Source-Materialien: https://huggingface.co/collections/thu-pacman/puro-2b
Modell und zwischenzeitliche Checkpunkte: https://huggingface.co/collections/thu-pacman/puro-2b
Trainingsdaten und Mischungsverhältnis: https://huggingface.co/datasets/thu-pacman/Puro-2B
Trainingscode: https://github.com/thu-pacman/Puro-Megatron
Datenverarbeitungscode: https://github.com/thu-pacman/Kaiyuan-Spark
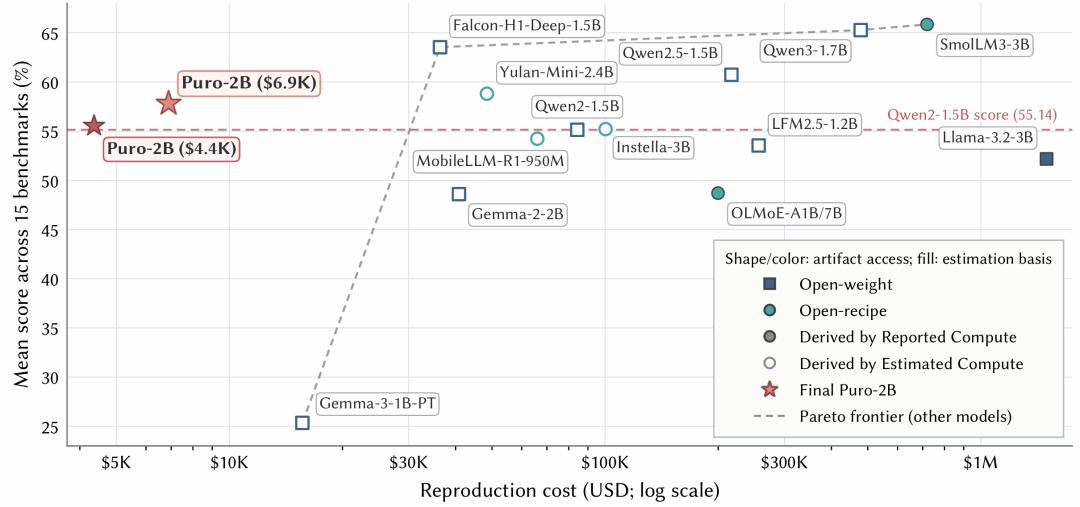
Abbildung 1 aus dem Papier | Modellleistung und Reproduktionskosten
Wenn das Budget noch geringer ist, welches Leistungsniveau kann das Modell dann erreichen? Sie haben die Erfahrungskurve für Kosten und Leistung (Puro Cost Scaling Law) angepasst, um das erreichbare Niveau des Modells bei unterschiedlichen Budgets abzuschätzen.
Sie sind von demselben in der ersten Phase trainierten Checkpunkt ausgegangen und haben das Trainingsbudget für das gleichmäßige Datenrezept in der zweiten Phase angepasst, um die Beziehung zwischen der durchschnittlichen Leistungspunktzahl und den Gesamtkosten anzupassen.
Diese Erfahrungskurve für das Puro-Trainingsverfahren ermöglicht es Forschern, vor dem offiziellen Training das Leistungsniveau abzuschätzen, das bei unterschiedlichen Kosten erreicht werden kann, und das Trainingsverfahren an die Anforderungen anzupassen, ohne den längsten Modelltrainingsprozess zu reproduzieren.
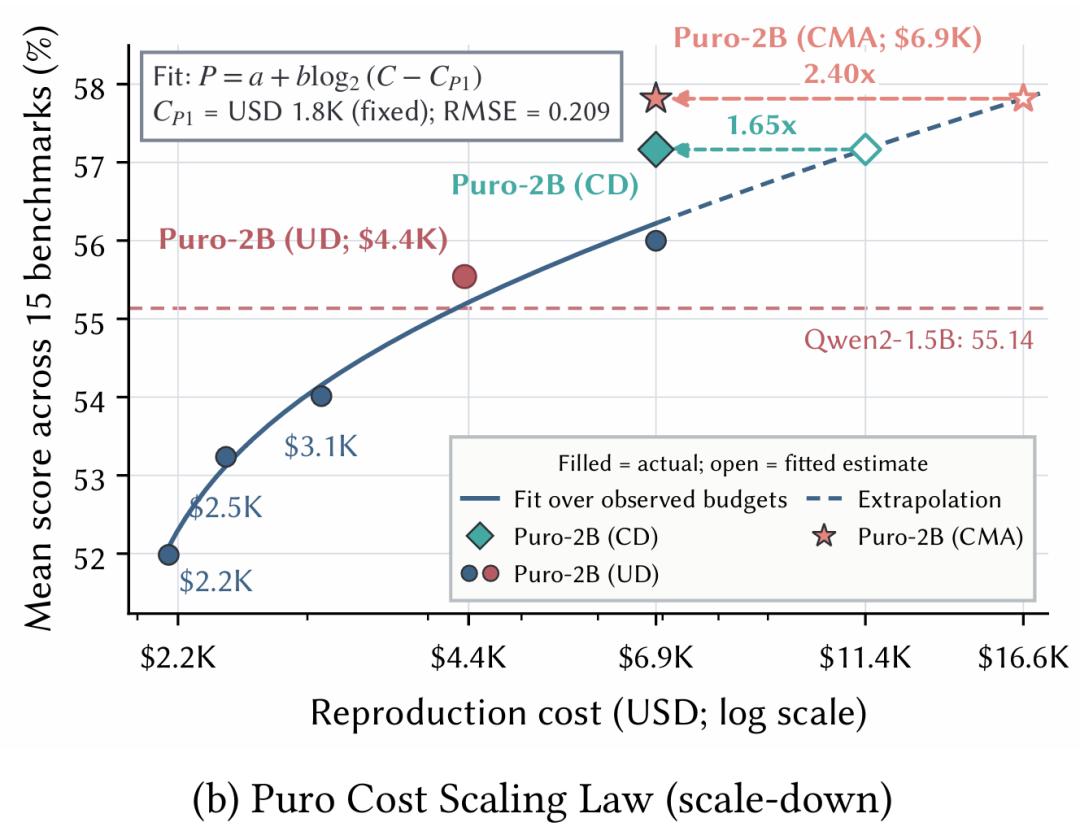
Abbildung 2b aus dem Papier | Puro Cost Scaling Law
Dieses kostengünstige Verfahren ergibt sich aus dem koordinierten Design in fünf Bereichen: Auswahl der Hardware, Training mit niedriger Genauigkeit, Verbesserung des Optimierers, Effizienz der Nutzung hochwertiger Daten und Datenauswahl.
Höhere Rechenleistung pro Kosteneinheit
Im Vergleich zu anderen quelloffenen Trainingsverfahren geht das Puro-2B-Team von grundlegenderen, tieferliegenden und praxisnäheren Problemen aus:
Wie viel Rechenleistung kann man mit demselben Budget kaufen?
Nach Berechnung mit dem im Papier verwendeten Mietpreis für GPUs stellte sich heraus, dass die Spitzenrechenleistung von RTX 5090 im BF16-Modus pro Dollar etwa das 2,77-fache von der von H200 beträgt. Das bedeutet, dass RTX 5090 pro Kosteneinheit mehr Rechenleistung liefern kann als die weit verbreiteten Grafikkarten für Rechenzentren, und gleichzeitig ist RTX 5090 als Consumer-Grafikkarte auch leicht verfügbar.
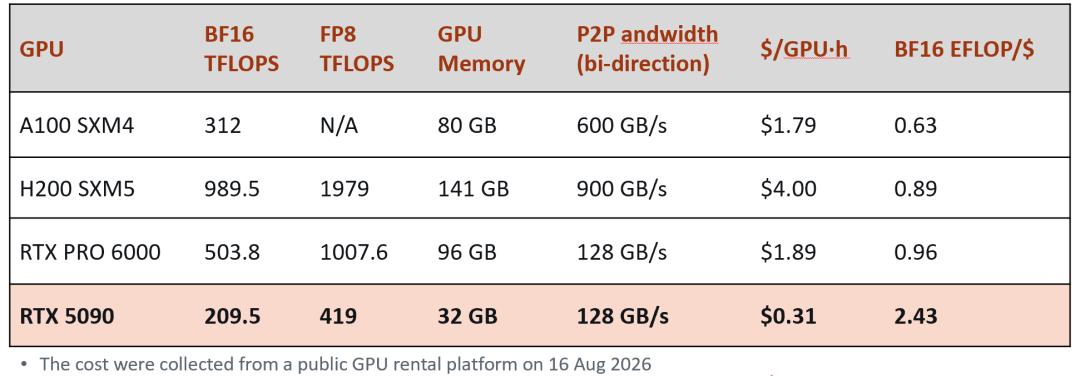
Vereinfachte Tabelle 2 aus dem Papier | Statistik und Vergleich der Berechnungspreisverhältnisse verschiedener Grafikkarten
Aber RTX 5090 hat nur 32 GB Videospeicher und kein NVLink, sodass die Trainingskonfiguration von GPUs für Rechenzentren nicht direkt übernommen werden kann.
Das Puro-2B-Team hat durch Anpassung von Treibern und Systemkonfigurationen die PCIe-P2P-Kommunikation innerhalb des Knotens aktiviert, wodurch die unidirektionale Bandbreite zwischen GPUs von 31,5 GB/s auf 56 GB/s gesteigert und die Kommunikationslatenz von 14,3 µs auf 0,4 µs gesenkt wurde;
Zwischen den Knoten wurde GPU Direct RDMA aktiviert, wodurch die Busbandbreite für AllReduce mit 24 Karten von 8,87 GB/s auf 19,93 GB/s gesteigert wurde.
Die Trainingsstrategie von Puro wurde ebenfalls für die Rechenlast im Milliardenparameterbereich und die Hardwareeigenschaften von RTX 5090 optimiert: Sie kombinieren Datenparallelität und Pipeline-Parallelität, um die kommunikationsintensive Tensorparallelität zu vermeiden;
Durch die Neuzuweisung der Rechenmenge in jeder Phase der Pipeline, die Anpassung der Mikrobatch-Größe und die gleichmäßige Platzierung der Optimiererzustände entsprechend der Videospeicherauslastung wird die Videospeicherbelastung verschiedener Knoten ausgeglichen.
Durch die oben genannten Optimierungen kann der kombinierte MFU über 70 % liegen. Das Preis-Leistungs-Verhältnis von Consumer-Grafikkarten wird durch diese technischen Anpassungen und Systemoptimierungen zu einem Vorteil bei den Trainingskosten umgewandelt.
Mit günstigerer Rechenleistung geht es im nächsten Schritt darum, die Effizienz der Rechengenauigkeit zu verbessern.
FP8 nutzt die Effizienzvorteile von RTX 5090 bei niedriger Genauigkeit
Die Blackwell-Architektur von RTX 5090 bietet auch die Grundlage für das FP8-Training. Sie haben den feingranularen blockweisen Quantisierungsansatz von DeepSeek-V3 übernommen, um die Matrixmultiplikationen der wichtigsten linearen Schichten auf den FP8-Pfad zu verlegen, während numerisch empfindliche Operationen und Trainingszustände die Genauigkeit von BF16 oder FP32 behalten.
FP8 führt zu einem gewissen Genauigkeitsverlust. Um zu beurteilen, ob es sich lohnt, haben sie durch kontrollierte Experimente mit verschiedenen Modellgrößen (Scaling Ladder) den Nettoeffizienzgewinn durch das FP8-Training nachgewiesen.
Durch kontrollierte Experimente mit fünf Modellgrößen stellten sie fest, dass der Validierungsverlust bei FP8 im Vergleich zu BF16 um etwa 0,0031–0,0039 höher liegt, aber der Unterschied ist gering und über alle Größen hinweg stabil.
Gleichzeitig wird die Trainingsdurchsatzeffizienz von FP8 um das 1,36-fache gesteigert; nachdem der Genauigkeitsverlust als zusätzliche Rechenleistung, die zur Erzielung des gleichen Verlusts erforderlich ist, umgerechnet wurde, wird geschätzt, dass immer noch ein Nettoeffizienzgewinn von etwa 1,34-fach besteht.
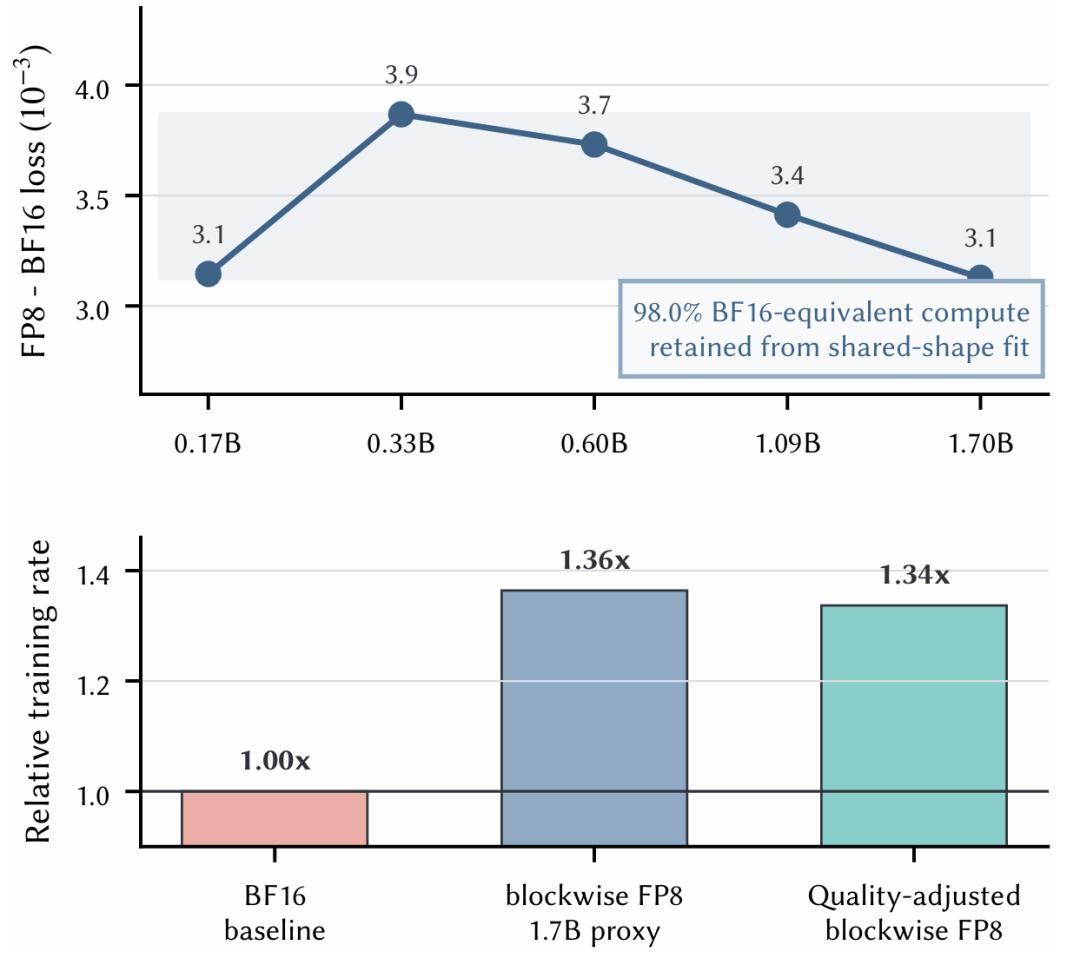
Abbildung 10b aus dem Papier | Verlustunterschied bei FP8 und Effizienz nach der Qualitätskorrektur
Vom gewöhnlichen Lernrate zur effektiven Lernrate
Nachdem die Rechengenauigkeit festgelegt ist, wirkt sich die Gestaltung des Optimierers und der Lernrate auf das Ergebnis jedes Aktualisierungsschritts aus. Der Optimierer bestimmt die Aktualisierungsrichtung bei jedem Schritt, die Lernrate bestimmt die Schrittweite bei jedem Schritt.
Sie haben den neuen Optimierer MuonH verwendet: Auf der Grundlage von Muon wird die Aktualisierungsmenge der Gewichte normalisiert, und nach der Aktualisierung der Gewichte werden die Gewichte auf einen festen Radius zurückprojiziert, wodurch gleichzeitig die Aktualisierungsnorm und die Gewichtsnorm gesteuert werden.
Auf diese Weise kann die effektive Lernrate (Effective LR, ELR), die die Aktualisierungsmenge im Verhältnis zur Gewichtsskala misst, explizit voreingestellt werden, ohne indirekt mit der Änderung der Gewichtsskala während des Trainings zu driften.
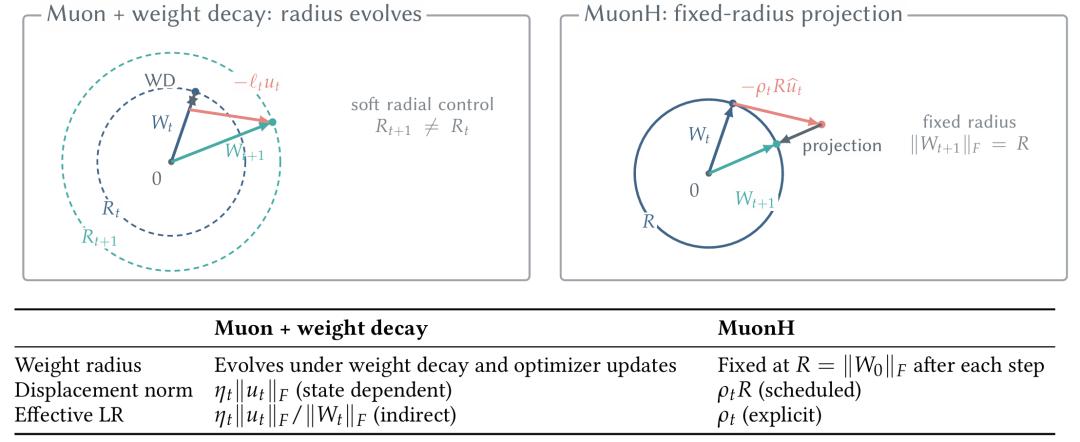
Abbildung 4 aus dem Papier | Schematische Darstellung des Prinzips von MuonH und Vergleich mit Muon
Ihre wichtige Beobachtung stammt aus einer Gruppe von kontrollierten Experimenten: Wenn gewöhnliches Muon ohne Gewichtsprojektion mit festem Radius verwendet wird und nur die Lernrate dynamisch angepasst wird, damit die ELR-Trajektorie während des Trainings mit der von MuonH übereinstimmt, fällt die Verlustkurve fast zusammen.
Das zeigt, dass der Vorteil von MuonH in der Praxis nicht nur auf die Normbeschränkung zurückzuführen ist – der Änderungsverlauf der effektiven Lernrate ELR ist der wichtige Hinweis, um die Effektivität der Hypersphärenoptimierung zu verstehen.
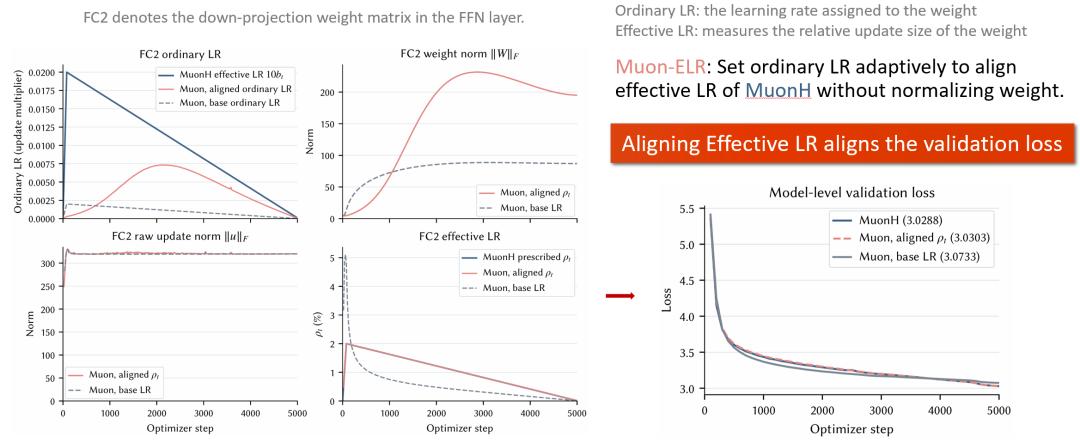
Kombination aus Abbildung 5 und Abbildung 15 aus dem Papier | Erklärung und Vergleich des ELR-Ausrichtungsexperiments
Ein weiterer Vergleich zeigt, dass bei unzureichender Beschränkung der Gewichtsnorm durch Weight Decay die ELR des gewöhnlichen Muon-Optimierers in der frühen Phase schneller abnimmt und der Verlust früher sinkt; MuonH behält einen sanfteren Abfall bei und zeigt in der späten Phase eine bessere Leistung.
Dadurch haben sie ihre Aufmerksamkeit von „welchen Optimierer man wählt“ auf „wie man einen angemesseneren effektiven Lernratenplan (ELR-Schedule) gestaltet“ gelenkt.
Anschließend haben sie