Nach dem Erreichen des 4-Billionen-Yuan-Maßstabs des Rechenleistungsnetzes: Wer kann die Rechenleistung wirklich nutzbringend einsetzen?
Die Nachfrage hat sich tausendfach vervielfacht, während 60 % der Rechenleistung ungenutzt bleibt – worum geht es im zweiten Halbfeld des Rechenleistungsnetzes?
In Ulanqab, der Inneren Mongolei, wird eine verlassene Schule derzeit zu einem Rechenzentrum umgebaut.
Diese nordchinesische Stadt, die Hunderte Kilometer von Peking entfernt liegt, hat bereits 89 Rechenzentrumsprojekte unterzeichnet. Alibaba, Huawei, Kuaishou und Drittbetreiber sind nacheinander eingezogen, und die lokale Regierung hat das Ziel ausgegeben, die „Token-Hauptstadt“ aufzubauen.
Gleichzeitig hat das China Academy of Information and Communications Technology eine weitere Zahlenreihe vorgelegt: Im Jahr 2025 belief sich das landesweite Angebot an intelligenter Rechenleistung auf rund 3,8 Milliarden Kartenstunden, während die tatsächliche Nutzung bei rund 1,4 Milliarden Kartenstunden lag, was einer Auslastung von 36,8 % entspricht.
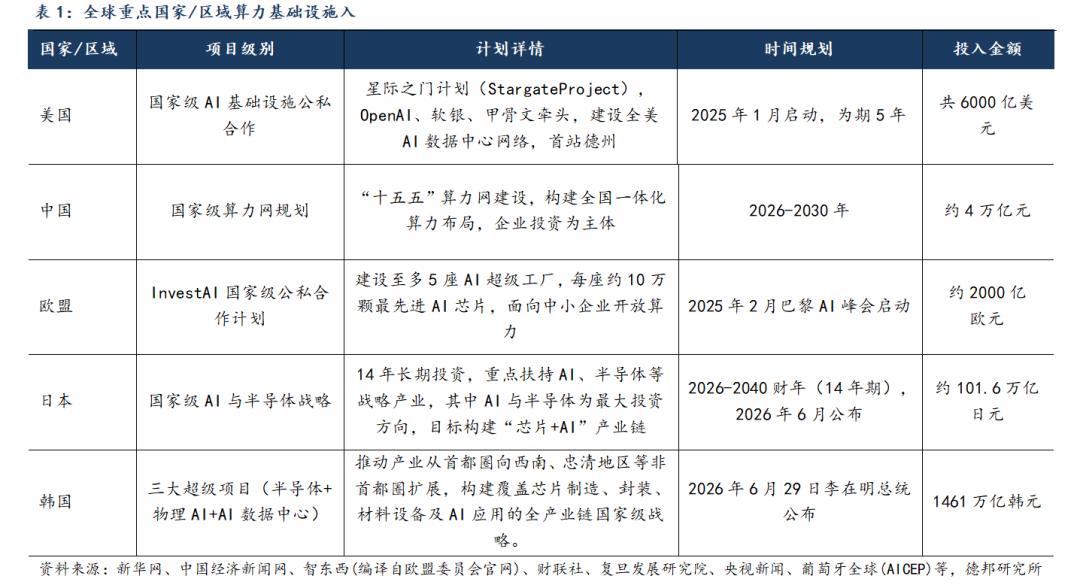
Auf der einen Seite wird nach Kräften expandiert, auf der anderen Seite bleiben 60 % der Rechenleistung ungenutzt. Laut Schätzungen von Institutionen, die von der Nationalen Entwicklungs- und Reformkommission zitiert werden, wird im Zeitraum des 15. Fünfjahresplans für den Aufbau des Rechenleistungsnetzes eine zusätzliche Direktinvestition von 4 Billionen Yuan erforderlich sein, mit der ausdrücklichen Anforderung, „das selbstkontrollierte und kooperativ betriebene Hardware- und Software-Ökosystem zügig zu entwickeln“.
Die Versorgung wird mit echtem Geld vorangetrieben, aber ein großer Teil der aufgebauten Rechenleistung hat keine Aufgaben zu erledigen – wo liegt das Problem?
Die inländische Rechenleistung wird heiß aufgebaut, aber kaum genutzt
Anfang 2024 lag die tägliche durchschnittliche Anzahl von Token-Aufrufen im ganzen Land bei rund 100 Milliarden; bis März 2026 gab die Nationale Datenbehörde eine Zahl von 140 Billionen bekannt, was einem Anstieg von mehr als tausendfach in etwas mehr als zwei Jahren entspricht.
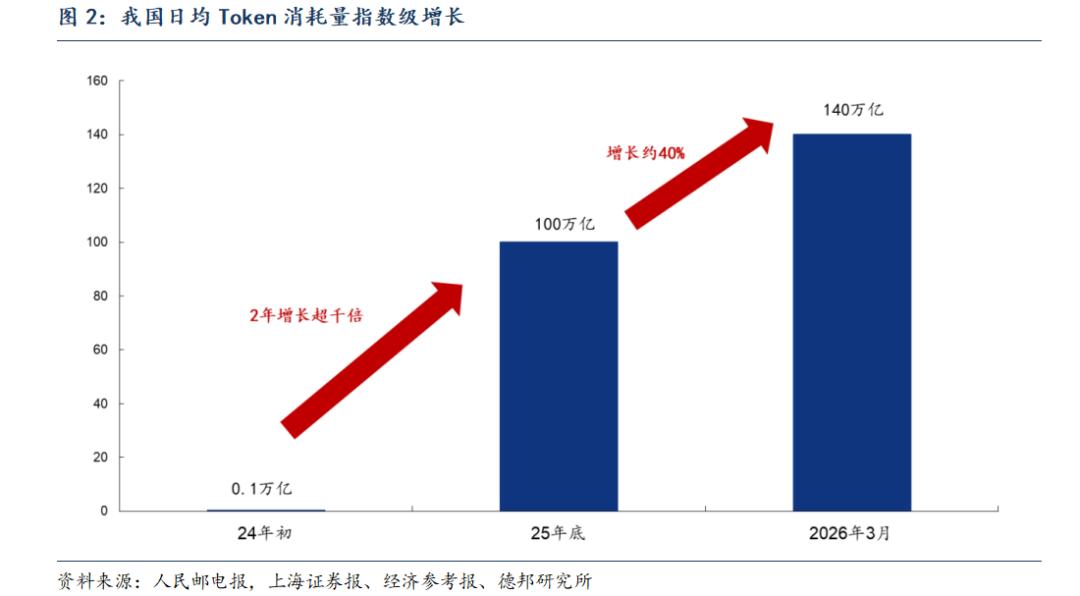
Der explosionsartige Anstieg der Nachfrage treibt auch den Aufbau einer neuen Generation von Rechenleistungsinfrastruktur voran. Am 11. September hat das Exekutivtreffen des Staatsrates den Aufbau des Rechenleistungsnetzes erörtert und vorgeschlagen, die Koordination von Rechenleistung und Stromversorgung sowie die Integration von Rechenleistung und Netzwerk voranzutreiben, wobei die räumliche Anordnung „8+10+3“ bereits Gestalt angenommen hat.
Aber nicht alle Rechenzentren können von dieser Welle profitieren. Der COO von Parallel Technology hat Medien gegenüber mitgeteilt, dass die Rechenleistungsauslastung des Unternehmens im Jahr 2025 zwischen 90 % und 95 % lag. Auf der anderen Seite liegt die umfassende jährliche Auslastung eines intelligenten Rechenparks in der Inneren Mongolei, der von der Wirtschaftsbeobachtungszeitung besucht wurde und sich hauptsächlich an marktorientierten allgemeinen Rechenleistungen mit Tausend Karten orientiert, unter 50 %; die Belegungsrate der neu gebauten reservierten Räume für inländische intelligente Rechenleistung mit 100.000 Karten im Park liegt sogar unter 20 %.
Die Untersuchung des Securities Times hat weiter die Gründe für diese Spaltung hinter sich offenbart: Die selbstgebauten Cluster der großen Internetunternehmen werden von internen Modelltrainings- und Inferenzdiensten gestützt und behalten eine hohe Belastung bei; die drei großen Netzbetreiber werden von eigenen Geschäften und Aufträgen für informationssichere Technologien gestützt; diejenigen, die wirklich Schwierigkeiten haben, sind die intelligenten Rechenzentren, die von lokalen Stadtfinanzierungsplattformen und staatseigenen Plattformen gebaut wurden, die nach der Fertigstellung weiterhin Kunden suchen müssen.
Obwohl es sich um die gleichen intelligenten Rechenzentren handelt, warum gibt es so große Unterschiede?
Es gibt drei Gründe. Erstens das Investitionstempo: Ressourcen werden schnell erworben, aber die tatsächliche Umsetzung der Nachfrage folgt ihrem eigenen Rhythmus. Eine Person von einer lokalen staatseigenen Rechenleistungsplattform sagte der Wirtschaftsbeobachtungszeitung, dass alle um Grundstücke, Stromversorgung und Energieverbrauchsindikatoren wetteifern, und die aktuelle Logik lautet: „Besetzen Sie erst einmal die Position“.
Der Aufbau der Rechenleistungsinfrastruktur umfasst Grundstücke, Stromversorgung, Energieverbrauchsindikatoren und Kapitalinvestitionen, und die frühe Layout erfordert oft die Eroberung von Ressourcen. Aber Rechenräume und Server können schrittweise gemäß dem Bauplan bereitgestellt werden, während die Bildung der Kundennachfrage und die Durchführung von Projektbeschaffungen jeweils ihren eigenen Rhythmus haben. Es gibt eine Zeitdifferenz zwischen vorauseilenden Investitionen und der tatsächlichen Umsetzung der Nachfrage. Sobald die frühe Planung nicht vollständig den tatsächlichen Kunden entspricht, kann die fertiggestellte Rechenleistung vorübergehend keine Verwendung finden.
Zweitens die Betriebseffizienz: Je niedriger die Auslastung ist, desto schwieriger ist es, die Fixkosten zu verteilen. Die Wissenschafts- und Technik-Tageszeitung hat einmal berichtet, dass in einem intelligenten Rechenzentrum mit Tausend Karten in einer westchinesischen Stadt die Belegungsrate unter 50 % liegt, die tatsächliche Auslastung der bereits belegten Server unter 30 % beträgt und die jährlichen Betriebskosten mehr als 30 Millionen Yuan übersteigen.
Stromkosten, Abschreibungen und Wartungskosten werden nicht geringer, auch wenn das Geschäft zurückgeht. Jeden Tag, an dem die Server ungenutzt bleiben, verbrennen diese Kosten buchstäblich Geld.
Der Vorteil von Ulanqab liegt gerade im niedrigen Strompreis. Angenommen, die durchschnittliche Leistung der IT-Geräte in einem Rechenzentrum beträgt 10 Megawatt, läuft das ganze Jahr über, hat ein PUE von 1,2 und der Preisunterschied pro Kilowattstunde beträgt 0,4 Yuan, dann beträgt der jährliche Unterschied bei den Stromkosten etwa 42 Millionen Yuan, was in fünf Jahren mehr als 200 Millionen Yuan übersteigt.
Aber niedrige Strompreise können nur die Betriebskosten senken, nicht aber ein anderes Risiko beseitigen, dem die Rechenleistungsvermögen ausgesetzt sind: GPUs erreichen möglicherweise nicht ihr Lebensende, bevor sie ihre Kosteneffizienz verlieren. Neue Chips verbessern ständig ihre Leistung, und die Inferenztechnik entwickelt sich ebenfalls weiter. Nach einigen Jahren können alte Karten, auch wenn sie noch normal funktionieren, gezwungen sein, den Preis zusammen mit neuen Geräten zu senken.
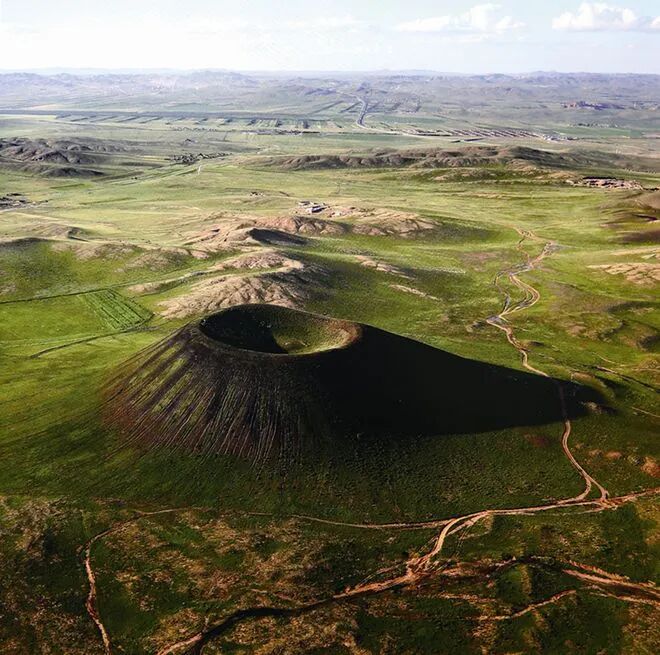
(Vulkansteppe in Ulanqab, Quelle: Offizielle Website der Regierung von Ulanqab)
Der Modellpreis kann in einem Monat um drei Viertel sinken, aber die gekauften Server können nicht jederzeit zurückgegeben werden. Für intelligente Rechenzentren muss nicht nur geprüft werden, ob die Vorabinvestition der tatsächlichen Nachfrage entspricht und ob die täglichen Betriebskosten verteilt werden können, sondern sie müssen auch dem Risiko der Vermögensentwertung standhalten, das durch technologische Iterationen verursacht wird.
Drittens die Kundenauswahl: Auch wenn die Rechenleistung noch so billig ist, sind Kunden möglicherweise nicht bereit, den Anbieter zu wechseln.
Qidian hat den Leiter eines KI-Anwendungsunternehmens interviewt, das Abonnementdienste für Privatanwender anbietet. Die inländische Rechenleistung, die sie nutzen, stammt hauptsächlich von ByteDance und Alibaba Cloud. Als gefragt wurde, ob sie in Betracht ziehen, selbst Rechenleistung aufzubauen oder kleinere Rechenleistungsanbieter oder lokale intelligente Rechenzentren zu nutzen, antwortete die Gegenpartei: „Vorläufig nicht, das Vorhandene reicht aus.“
Dieses „reicht aus“ sagt eigentlich den Schlüssel zur Fehlanpassung aus: Anwendungsunternehmen kaufen täglich modellbasierte Dienste mit nutzungsabhängiger Abrechnung, bei denen Rechenleistung, Modell und Planung bereits von Cloud-Anbietern gebündelt sind. Der Wechsel des Anbieters bedeutet, das Modell neu zu implementieren, Software anzupassen und die Stabilität zu testen. Selbst wenn das Angebot noch so niedrig ist, muss man zuerst die Zeitkosten für die Migration und das Wechselrisiko berechnen.
Daher sind die echten Konkurrenten der lokalen intelligenten Rechenzentren die Cloud-Anbieter, die die Rechenleistung bereits zu ausgereiften Diensten verpackt haben.
Die von Alibaba veröffentlichten Finanzdaten machen die Arbeitsteilung in dieser Industriekette klarer. Im Quartal bis Ende Juni beliefen sich die Kapitalausgaben von Alibaba auf 67,678 Milliarden Yuan, was einem Anstieg von 75 % gegenüber dem Vorjahr entspricht; der Umsatz des erstmals konsolidierten Segments „KI-Cloud und Rechenleistungsdienste“ (entstanden durch die Integration der Cloud Intelligent Group und T-Head) betrug 48,437 Milliarden Yuan, was einem Anstieg von 45 % gegenüber dem Vorjahr entspricht, und das bereinigte EBITA betrug 5,628 Milliarden Yuan. Das neu eingerichtete Segment „KI-Labor und Anwendungen“ (entstanden durch die Integration des KI-Modelllabors, der Qianwen 2C-Abteilung und Qianwen Office) erzielte einen Umsatz von 3,338 Milliarden Yuan, während das bereinigte EBITA einen Verlust von 13,861 Milliarden Yuan verzeichnete.
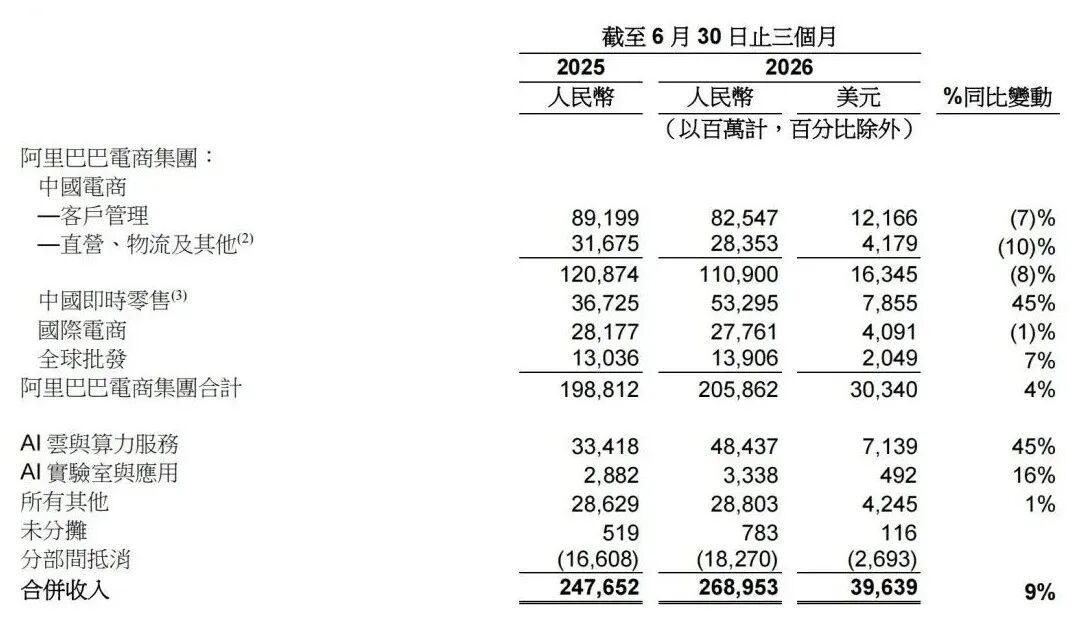
Derselbe Ausgabeposten für Rechenleistung ist in der Bilanz des Cloud-Anbieters ein Umsatz, in der Bilanz des Modellunternehmens aber eine Kostenposition.
Chiphersteller, Rechenzentrumsbetreiber, Cloud-Anbieter und Modellunternehmen haben alle hohe Einsätze in diese Expansion gelegt – obwohl sie im selben Boot sitzen, erreichen sie möglicherweise nicht gleichzeitig das Ufer.
Im Zeitalter der Inferenz wird die Rechenleistung nach „Aufgaben“ abgerechnet
Wenn die ungenutzte Kapazität ein altes Problem der Fehlanpassung von Angebot und Nachfrage ist, bringt das Zeitalter der Inferenz neue Variablen mit sich.
Man muss wissen, dass Training und Inferenz zwei völlig unterschiedliche Arten von Belastungen darstellen. Das Training kann zentral geplant werden, eine Aufgabe läuft mehrere Wochen lang ununterbrochen und hält große Cluster unter hoher Belastung; die Inferenz folgt den Anforderungen der Nutzer, die morgendlichen und abendlichen Spitzen schwanken unregelmäßig, und die Antwortgeschwindigkeit muss gewährleistet sein.
Nach der Verbreitung von Agenten durchläuft eine einzelne Aufgabe mehrere Schritte wie Planung, Abruf, Aufruf von Werkzeugen und Überprüfung, wobei die Anzahl der Aufrufe und der Kontext gemeinsam anwachsen. Die Gesamtmenge an Token, die für eine einzelne Aufgabe verbraucht wird, nimmt nicht ab, auch wenn der Stückpreis sinkt.
Gartner hat in zwei Prognosen im August zwei Zahlenreihen vorgelegt: Die weltweiten Ausgaben für KI-Infrastruktur für Inferenz werden im Jahr 2026 voraussichtlich 23,3 Milliarden US-Dollar erreichen und erstmals die 19 Milliarden US-Dollar übersteigen, die mit dem Training zusammenhängen; bis 2028 werden die Inferenzkosten für einen einzelnen Agenten-Arbeitsablauf auf mehr als das Fünffache des aktuellen Niveaus ansteigen.
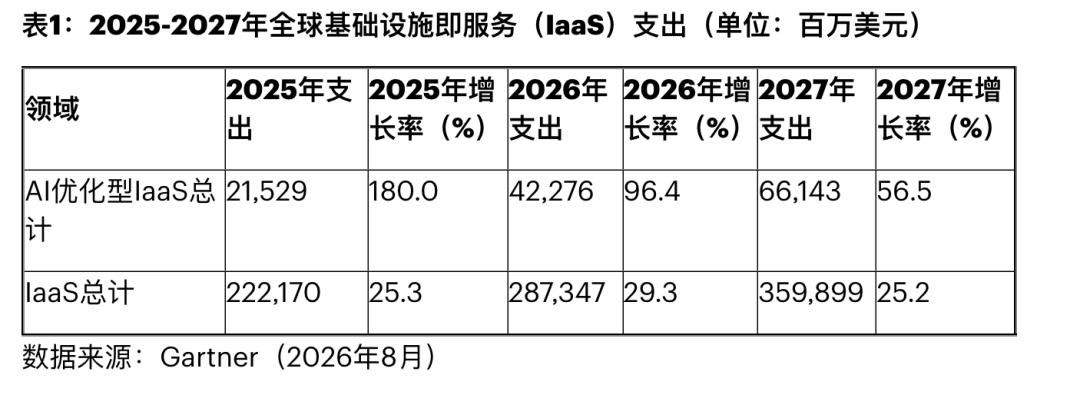
Die Form der Nachfrage hat sich geändert. Die alten Methoden, die früher auf zentrale Beschaffung und den Aufbau großer Cluster setzten, um die Auslastung zu steigern, versagen angesichts der verstreuten und schwankenden Inferenzanfragen.
Die Preisanpassung von DeepSeek im September hat die Spitzen- und Tiefzeiten der Inferenz direkt in die Preisliste aufgenommen. Für die Flash-Serie beträgt der Preis für Cache-Treffer bei der Eingabe außerhalb der Spitzenzeiten 0,02 Yuan pro Million Token, 1 Yuan bei nicht getroffenen Eingaben und 4 Yuan bei Ausgaben, während die Preise in den Spitzenzeiten verdoppelt werden. Die drei Preise sind gegenüber den vorherigen Preisen außerhalb der Spitzenzeiten um 60 %, ca. 33 % bzw. ca. 11 % gesunken.
Die versteckte Bedeutung der zeitgesteuerten Preisgestaltung lautet: Der Preis selbst wird zu einem Planungsinstrument, das Nutzer dazu anleitet, Aufgaben, die warten können, in die Tiefphasen zu verlegen. Der Unterschied zwischen Spitzen- und Tiefwerten der Rechenleistung zeigt sich zum ersten Mal direkt in den API-Angeboten.
Der gesamte Markt senkt ebenfalls die Preise. Aus dem LLM-Token-Ausgabenindex von Silicon Data geht hervor, dass der durchschnittliche Zahlungspreis der Branche pro Million Token von über 2 US-Dollar im Mai auf 0,97 US-Dollar Ende August gesunken ist, was einem Rückgang von mehr als 52 % gegenüber dem Höchststand im Mai entspricht. Aber die Spaltung ist deutlich: Mittelklasse-Modelle werden durch Open-Source-Alternativen ersetzt, wo der Preiskampf am heftigsten