Sternstunden: Das Gruppenporträt der Wissenschaftler hinter den 722 von OpenAI veröffentlichten Manuskripten
Nachdem OpenAI 722 von KI verfasste Manuskripte zu Mathematik und theoretischer Informatik veröffentlicht hat, hat das Open-Source-Projekt *Auf den Schultern von Riesen*, initiiert von Qiongxiu Li vom KI-Sicherheitslabor der Aalborg-Universität in Dänemark, alle relevanten Literaturstellen dieser KI-Manuskripte einzeln überprüft und eine systematische Herkunftsanalyse durchgeführt.
Das Ergebnis lautet: Über einen Zeitraum von mehr als 5 Jahrhunderten verteilen sich 11.067 menschliche Werke von rund 9.600 Mathematikern, darunter 114 Preisträger der Fields-Medaille, des Abel-Preises oder des Wolf-Preises.
Diese Art von Arbeit wird oft mit der Formulierung „Die KI hat das und jenes schwierige Problem gelöst“ beschrieben.
Dieser Satz sagt jedoch nur die Hälfte aus – die andere Hälfte lautet: Auf welcher Arbeitsgrundlage hat die KI das Problem gelöst?
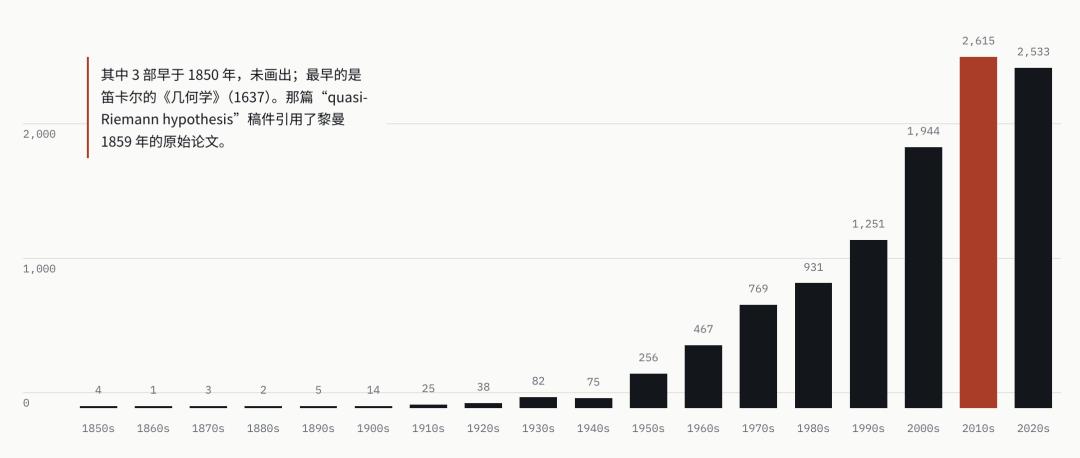
Die meisten Namen der Autoren stammen nicht aus Geschichtsbüchern, sondern von Mathematikern und theoretischen Informatikern, die noch heute aktiv sind.
Aus dem ursprünglichen Kontext geht hervor, dass die KI-Manuskripte die Ergebnisse dieser Wissenschaftler als Werkzeuge verwenden:
In der arithmetischen Geometrie verknüpft ein Manuskript unter Verweis auf [Fargues–Scholze 2024] bestimmte Vektorbündel mit p-adischen lokalen Systemen – dies ist die Arbeit von Laurent Fargues und Peter Scholze.
In der birationalen Geometrie übernehmen einige Manuskripte aktuelle Strategien von Caucher Birkar und einem Koautor, andere wenden Birkars Satz über beschränkte Ergänzungen an; weitere bauen auf der Induktionsmethode von Osamu Fujino sowie den Arbeiten von Omprokash Das, Christopher Hacon und Mihai Păun auf.
In der Wahrscheinlichkeitstheorie stützen sich die Manuskripte auf die kritischen Durchlaufschätzungen für das Zufallskluster-Modell von Hugo Duminil-Copin und Mitarbeitern sowie den Satz zur „Paarung von Bäumen“ (Mating of Trees) von Bertrand Duplantier, Jason Miller und Scott Sheffield.
Ein Gegenbeispiel in der Graphentheorie nutzt die Konstruktion der Grenzwertabtastung von Graphen durch László Lovász und Balázs Szegedy; ein kombinatorisches Gegenbeispiel übernimmt die Summen-Produkte-Methode von Jean Bourgain, Nets Katz und Terence Tao.
Ein Manuskript über Spingläser verwendet die Hohlraummethode von Michel Talagrand.
Ein Argument zum Ricci-Fluss nutzt die Entropiemonotonie von Grigori Perelman aus dem Jahr 2002; ein Argument zur Hodge-Theorie greift auf das Halbeinfachheitsargument von Pierre Deligne zurück.
Jedes Ergebnis der KI in einzelnen Fachgebieten baut auf der Arbeit einer ganzen Gruppe von Personen auf:
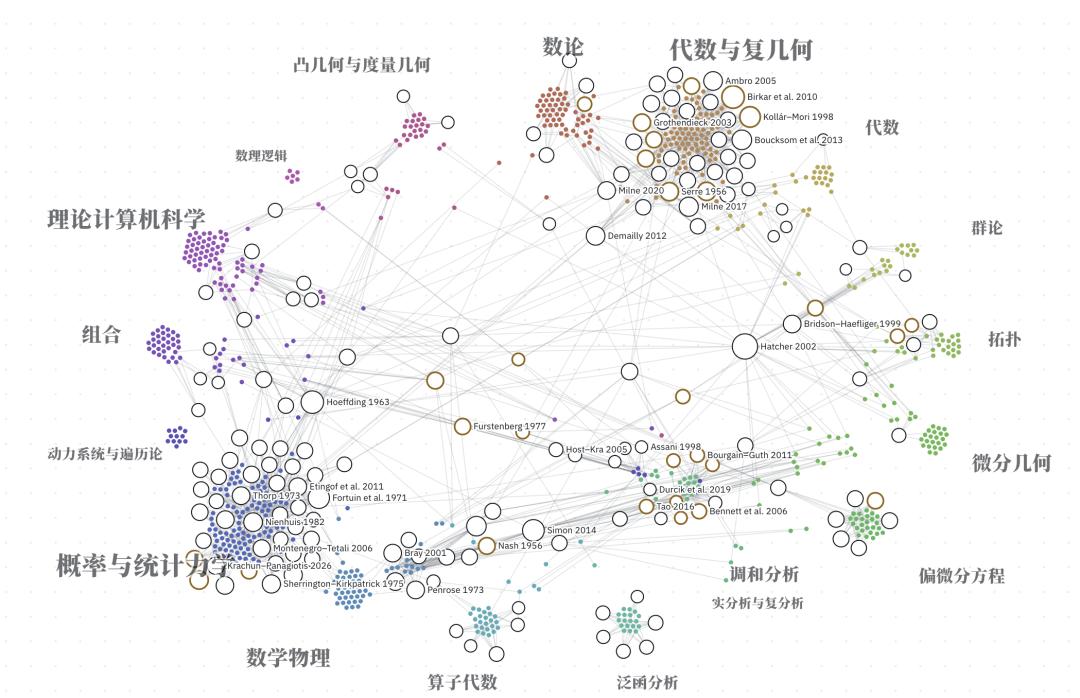
Jeder kleine Punkt steht für ein KI-Preprint, die nach Fachgebieten zu „Kontinenten“ gruppiert sind; die markierten großen Punkte sind menschliche Arbeiten, die von mehreren Preprints gemeinsam zitiert werden. Ihre Größe gibt die Anzahl der Zitate an, ihre Position liegt zwischen den Arbeiten, die sie zitieren.
Projekt *Auf den Schultern von Riesen*: seafill.info/Shoulders
Datenquelle: github.com/openai/math
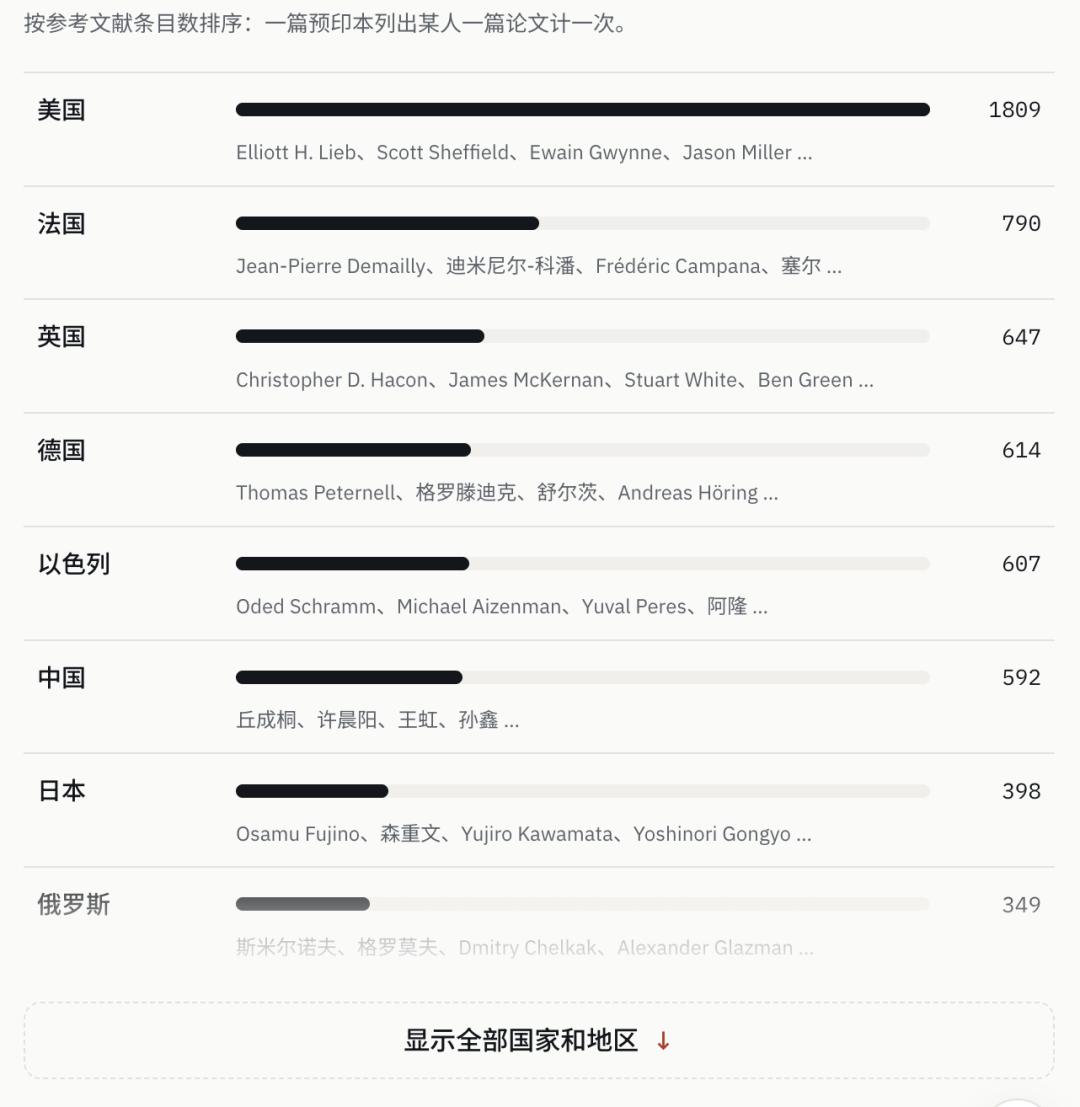
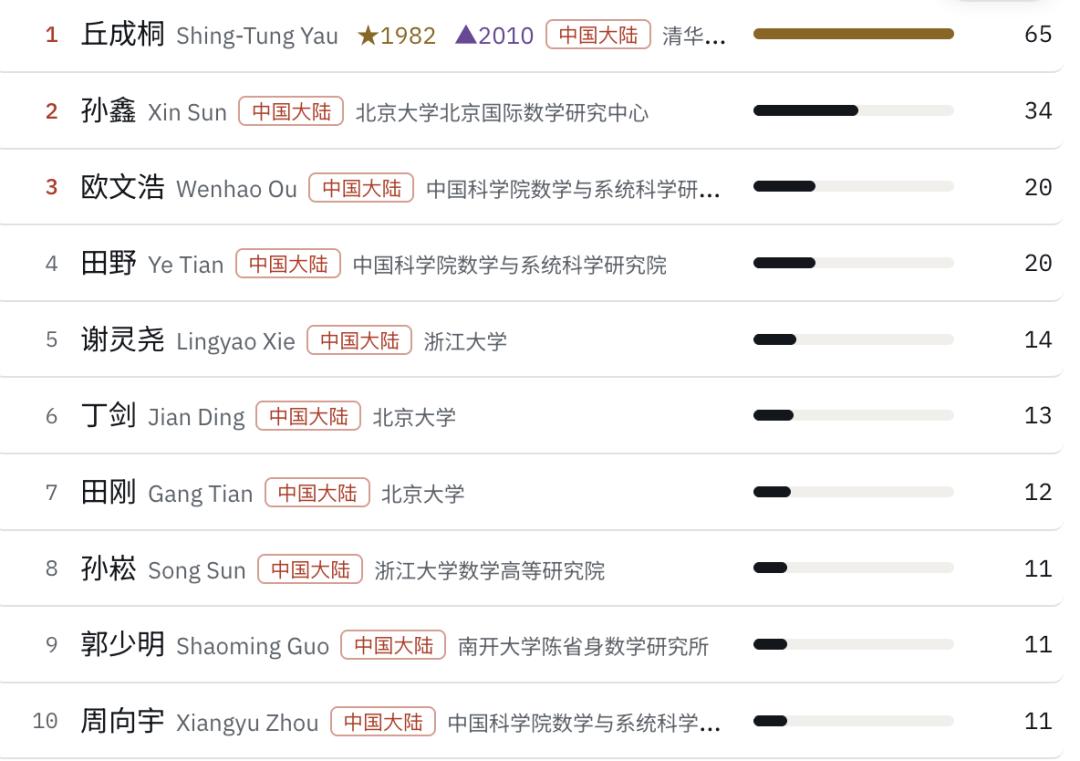
Anzahl der zitierten Arbeiten von teilweise in Festlandchina aktiven Mathematikern
Die Arbeiten von Shing-Tung Yau, Xin Sun, Wenhao Ou, Ye Tian, Lingyao Xie, Jian Ding, Gang Tian, Song Sun, Shaoming Guo, Xiangyu Zhou und anderen werden von OpenAI wiederholt verwendet.
Chinesische Mathematiker in dieser Wissensweitergabe:
Die Arbeit von Shing-Tung Yau aus dem Jahr 1976, mit der er die Calabi-Vermutung bewiesen hat, wird von mehr als zehn Manuskripten zitiert.
Die innere Beweisführung für die Gauß-Bonnet-Formel von Shiing-Shen Chern aus dem Jahr 1944 sowie die Chern-Simons-Form, die er gemeinsam mit James Simons 1974 vorgeschlagen hat, werden jeweils in drei Arbeiten verwendet; eine davon lautet: „Wir verwenden das Chern-Simons-Transgressionsfunktional“. Zwei weitere Arbeiten befassen sich mit dem Problem affiner maximaler Flächen, das Shiing-Shen Chern 1979 aufgestellt hat.
In der aktuell populären harmonischen Analyse baut OpenAIs Manuskript zum vierdimensionalen Kakeya-Problem direkt auf dem Beweis des dreidimensionalen Kakeya-Vermutungen von Hong Wang und Joshua Zahl aus dem Jahr 2025 auf. Die Bourgain-Bedingung im Beweis zitiert zudem die Arbeit von Hong Wang, Shaoming Guo und Ruixiang Zhang aus dem Jahr 2024. Beim eng verbundenen Bochner-Riesz-Problem wurden die Arbeiten von Shaoming Guo, Changkeun Oh, Hong Wang, Shukun Wu und Ruixiang Zhang aus dem Jahr 2025 sowie die bilineare Beschränkungsschätzung von Terence Tao aus dem Jahr 2003 als Grundlage für die Paketmethode nebeneinander aufgeführt.
Ein Manuskript zur Abundanz-Vermutung übernimmt das Blattstrukturkriterium von Chenyang Xu und Lei Zhang. Ein Manuskript über harte Kugelgase nutzt die Schätzungen von Yu Deng, Zaher Hani und Xiao Ma zur Herleitung der Boltzmann-Gleichung aus der Teilchendynamik.
Das Monographie von Gang Tian und John Morgan über den Ricci-Fluss und die Poincaré-Vermutung, der Beweis der Erfüllbarkeitsvermutung durch Jian Ding, Allan Sly und Nike Sun sowie die Arbeit von Chen-Ning Yang, Tsung-Dao Lee und Ke-Sun Huang aus dem Jahr 1957 über harte Kugel-Bose-Gase sind ebenfalls in den Referenzen aufgeführt...
Das Gleiche gilt auch für andere wissenschaftliche Entdeckungen. OpenAIs Arbeit zur Navier-Stokes-Gleichung geht von der von Leonhard Euler 1757 aufgestellten Gleichung aus, anschließend wird auf die 1934 von Jean Leray vorgeschlagenen schwachen Lösungen sowie den Teilregularitätssatz von Luis Caffarelli, Robert Kohn und Louis Nirenberg zurückgegriffen. Googles AlphaFold wurde anhand von Proteinstrukturen trainiert, die Strukturbiologen über Jahrzehnte einzeln aufgelöst haben; die Grundidee geht auf die Veröffentlichung von Christian Anfinsen aus dem Jahr 1973 zurück, die besagt, dass die Sequenz eines Proteins seine Form bestimmt.
Ingenieure bauen die Maschine, Wissenschaftler geben ihr das, was sie lernen kann
Für ein Modell, das wissenschaftliche Durchbrüche erzielen kann (wie GPT, Claude usw.), bauen Ingenieure die Maschine: Architektur, Trainingscode, Datenpipelines und Rechenleistung. Wissenschaftler liefern die hochwertigen Inhalte, die das Modell lernen kann, und bestimmen zudem, in welche Richtung es sich entwickelt. Beim Vortraining lernt das Modell, das nächste Wort anhand des vorherigen Textes vorherzusagen.
In einem KI-Manuskript steht geschrieben: „Nach dem Spaltungssatz für Vektorbündel auf der projektiven Geraden ist E eine direkte Summe von Linienbündeln“. Diese Tatsache wurde nicht vom Modell entdeckt.
Alexander Grothendieck hat 1957 ihre klassische Form angegeben, seitdem schreiben Mathematiker diesen Schritt immer wieder in Arbeiten, Lehrbüchern und Vorlesungsskripten nieder.
Die Intuition von Wissenschaftlern besteht darin, zu wissen, welches Lemma im nächsten Schritt verwendet werden soll; die Intuition des Modells ist eine aus Tausenden von „nächsten Schritten“, die von Menschen geschrieben wurden, abgeschätzte Wahrscheinlichkeit. Bei der überwachten Feinabstimmung lernt das Modell anhand ausgewählter Schlussfolgerungsketten, „wie man Probleme Schritt für Schritt löst“. Einige dieser Schlussfolgerungsketten wurden von Menschen verfasst, andere vom Modell synthetisiert – aber auch die synthetisierten gehen von von Menschen gestellten Aufgaben und Anweisungen aus, und von von Menschen entworfenen Prüfverfahren wird entschieden, ob sie behalten werden.
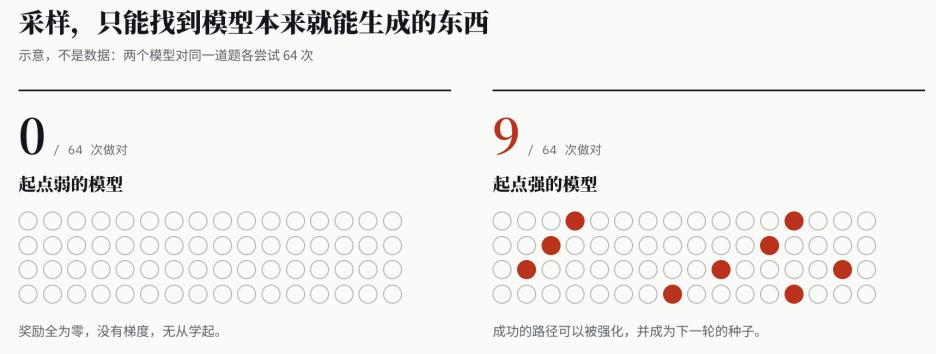
Das Sampling bei der abschließenden Verstärkungslernphase und der Inferenz kann nur Dinge verstärken oder finden, die das Modell ohnehin abzutasten in der Lage ist.
Sampling bei Verstärkungslernen und Inferenz. Das Modell probiert eine Aufgabe viele Male aus, der Prüfer behält die richtigen Lösungen. Das basiert auf Sampling: Wenn das Modell fast nie einen korrekten Beweis schreibt, sind alle Belohnungen null und es kann nichts lernen.
Dass „richtige Lösungen“ von fast nicht vorhanden zu gelegentlich auftauchend werden, hängt zu einem großen Teil von der Qualität der vorherigen Trainingsdaten ab. Einfach ausgedrückt: Ingenieure machen das Lernen möglich, und ein großer Teil der lernbaren Inhalte stammt von Wissenschaftlern verschiedener Fachgebiete.
Wissenschaftler liefern hochwertige Lernsignale
Vortraining und überwachte Feinabstimmung geben dem Modell Intuition und Schlussfolgerungsweisen, aber neue Ergebnisse an der Wissensgrenze hängen von großangelegtem Sampling ab: Verstärkungslernen während des Trainings, Suche und Agenten bei der Inferenz. Gemeinsam ist ihnen, dass das Modell eine Aufgabe viele Male (Rollouts) ausprobieren darf, bevor ein Prüfer entscheidet, welche Versuche zählen.
Erfolgreiche Abläufe können wiederum zu Trainingsdaten für die nächste Runde werden. Damit dieser „Versuch-Prüfung“-Zyklus tatsächlich zu einer Verbesserung der Modellfähigkeiten führt, ist die Qualität der Signale entscheidend. Der Gradient bestimmt, was das Modell aus einem Beispiel lernt, und seine Güte hängt von dem zugrundeliegenden Signal ab.
Ein großer Teil der starken Signale stammt von Wissenschaftlern: Strenge Beweise sorgen dafür, dass das Training klare nächste Schritte zum Lernen hat; gut ausgewählte Aufgaben verhindern, dass Belohnungen alle null oder alle eins sind; präzise Prüfer stellen sicher, dass das Signal in die richtige Richtung weist. Ob das Sampling während des Trainings oder bei der Inferenz stattfindet – Wissenschaftler können an drei Positionen dieses Zyklus beteiligt sein.
(1) Auswahl von Problemen. Das Training lernt am effizientesten an Problemen, die „gerade erreichbar“ sind, und die Rechenleistung bei der Inferenz lohnt sich am meisten für solche Probleme. Gute Probleme hinterlassen gute Ausgangspunkte für das Modelltraining der nächsten Runde, mittelmäßige Aufgaben hinterlassen nur mittelmäßige Ausgangspunkte. Die Auswahl solcher Probleme erfordert das, was Wissenschaftler als „Geschmack“ (Taste) bezeichnen. Die Problemlisten von Paul Erdős, Shing-Tung Yau und David Hilbert tun genau das.
(2) Definition dessen, was als richtig gilt. Während des Trainings bestimmt der Prüfer die Belohnung; bei der Inferenz entscheidet er, welcher der vielen Versuche behalten wird. Wenn die Prüfstandards zu lax formuliert sind, sucht sich das Modell Schlupflücken im Training. Die Mathematik konnte sich zuerst als Testfeld etablieren, weil Mathematiker den Begriff des „Beweises“ bereits extrem präzise definiert haben.
(3) Bewertung der Ergebnisse. Am 7. Oktober hat OpenAI 3 Manuskripte zurückgezogen, nachdem ein symbolischer Fehler entdeckt wurde, und 14 weitere überarbeitet. In der Beschreibung ihres Repositoriums steht zudem, dass einige nicht formalisierte Ergebnisse „möglicherweise fehlerhaft“ sind. Welche Ergebnisse gültig sind, welche wichtig sind und welche Richtungen es wert sind, in der nächsten Runde Rechenleistung zu investieren – diese Urteile werden nach wie vor von der wissenschaftlichen Gemeinschaft getroffen.
Also braucht selbst die stärkste KI einen „Fahrer“. Das ist vergleichbar mit der Ölförderung: Auch der stärkste Bohrer braucht Geologen, die entscheiden, wo gebohrt wird und ob das, was aus der Tiefe kommt, tatsächlich Öl ist. In dem folgenden Zyklus wählen Wissenschaftler Probleme aus, definieren was richtig ist und bewerten die Ergebnisse; die KI führt die Versuche in einem für Menschen unvorstellbaren Umfang durch.
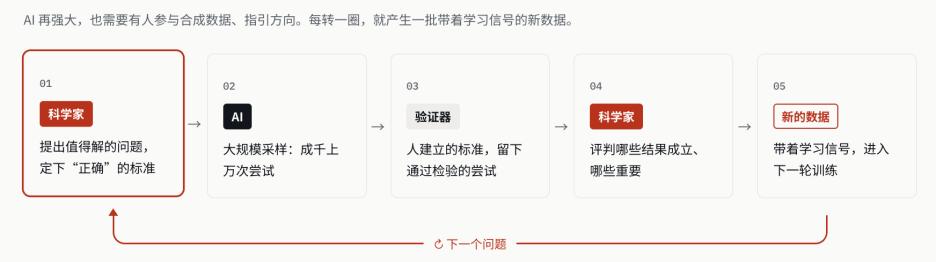
Wissenschaftler wählen Probleme aus, definieren was richtig ist und bewerten die Ergebnisse; die KI führt die Versuche in einem für Menschen unvorstellbaren Umfang durch