Natura-1 Launch: Erlernt Zero-Shot-Generalisierung und dextröse Manipulation aus Millionen von Stunden menschlicher Erfahrung
Wontons zu formen ist für die meisten Menschen eine einfache Tätigkeit: Man hält die Teighaut in einer Hand, nimmt die Füllung mit der anderen, faltet die Haut zur Hälfte, drückt die Ränder zu und verschließt die Öffnung. Nur wenige Menschen sind sich bewusst, dass die Handfläche während dieses gesamten Vorgangs ständig eine jederzeit verformbare Teighaut stützt, die Finger spüren ständig die Rückfederung von Füllung und Teighaut, und beide Hände müssen sich im richtigen Moment austauschen.
Diese alltäglichen, für menschliche Hände entwickelten Bewegungen sind für Roboter äußerst schwierig. Doch diese Schwierigkeiten werden mittlerweile überwunden. In einem 1 Minute und 12 Sekunden langen, durchgehenden Video in Originalgeschwindigkeit hat ein Paar geschickte Roboterhände diesen Vorgang erstmals erfolgreich abgeschlossen.
Angetrieben werden diese Hände von dem gerade veröffentlichten Natura-1 von Nature Will, einem in Peking ansässigen Unternehmen für körpergebundene Intelligenz. Es handelt sich um ein Mischmodell (MoE) mit 50B Parametern, das auf 1 Million Stunden an menschlichen Erfahrungsdaten aus der Egoperspektive vortrainiert wurde, Sprache und visuelle Informationen als Eingabe verwendet und eine geschickte Hand mit 20 Freiheitsgraden in einem Steuerkreis von 100 Millisekunden antreibt.
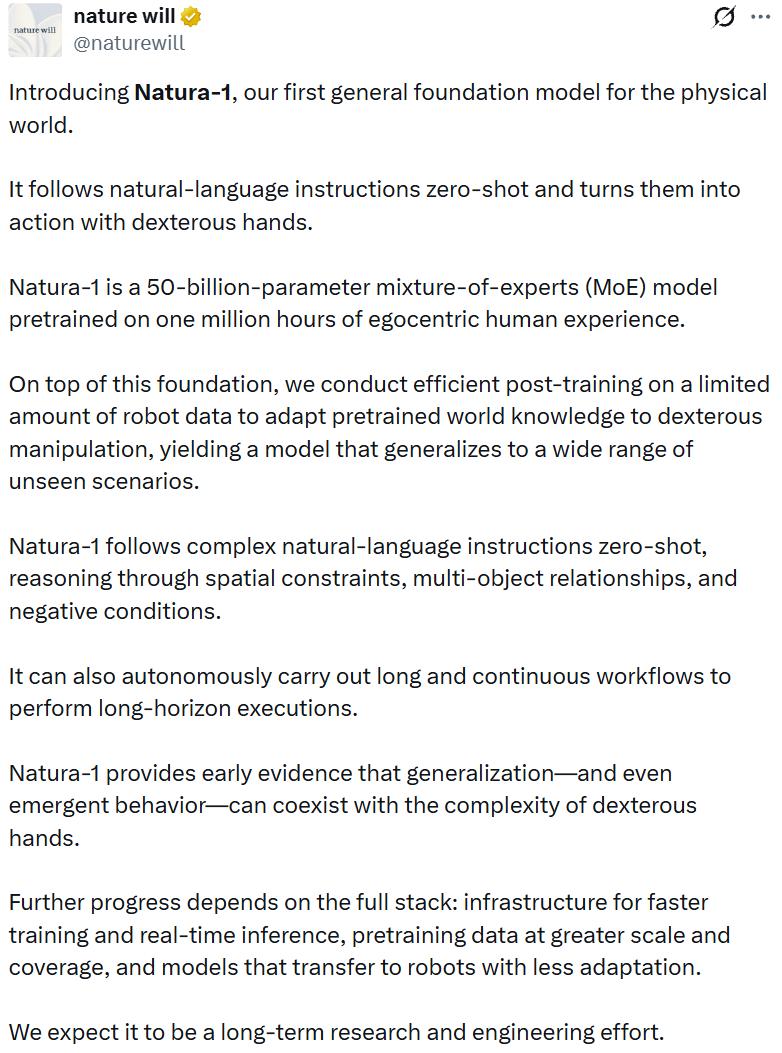
Das Formen von Wontons beantwortet die Frage „Kann man es gut machen?“. Natura-1 möchte jedoch eine schwierigere Frage beantworten: Kann es direkt eine Aufgabe übernehmen, die es noch nie geübt hat?
Geschicklichkeit und Allgemeinverträglichkeit – zwei Eigenschaften, die sich kaum vereinen lassen
Betrachten wir zuerst die geschickte Manipulation. Die menschliche Hand hat mehr als zwanzig Freiheitsgrade, alltägliche Objekte sind oft weich, verformbar und rückfedernd, jeder Kontakt verändert den Zustand des Objekts, und der Roboter muss während der Ausführung ständig anpassen. Die Schwierigkeit ist jedoch offensichtlich: Die Komplexität steigt exponentiell mit der Anzahl der Freiheitsgrade. Parallelgreifer können die Steuerung stark vereinfachen, allerdings auf Kosten vieler Bewegungen wie Stützen, Drehen und koordinierten Aktionen beider Hände, die nur schwer durchführbar sind.
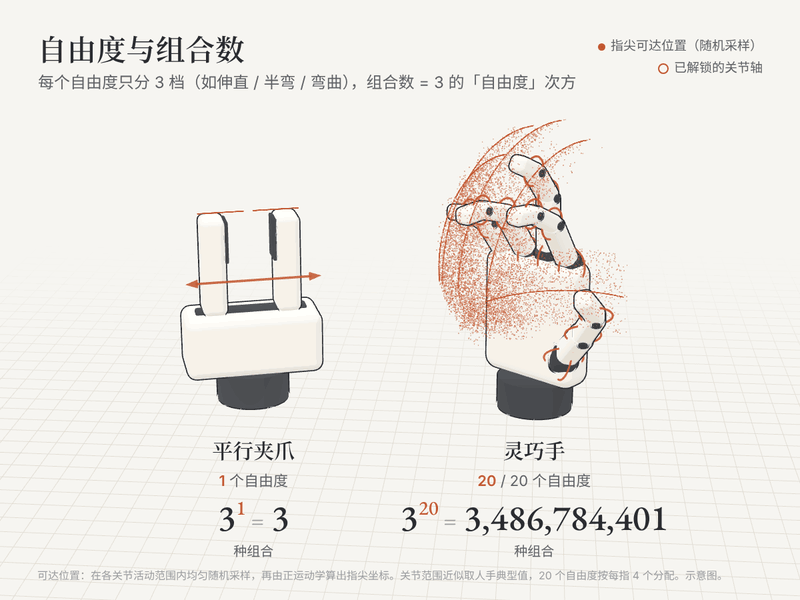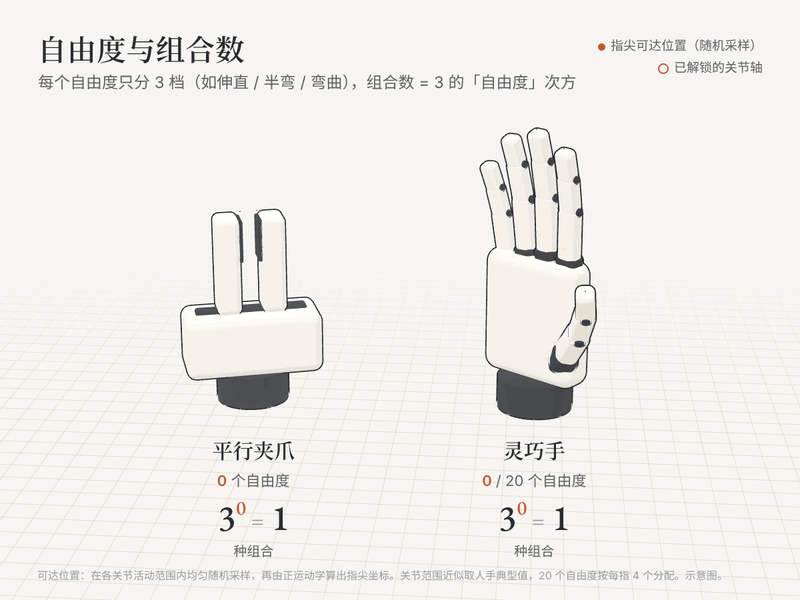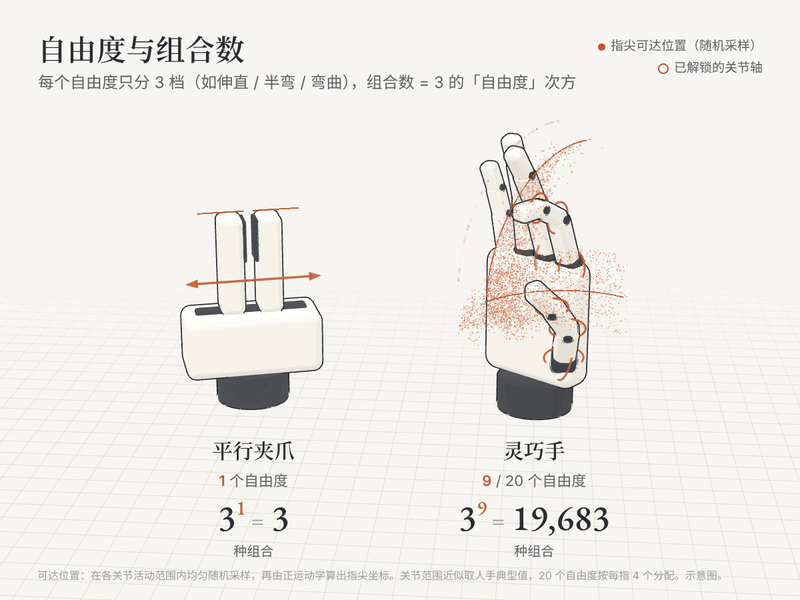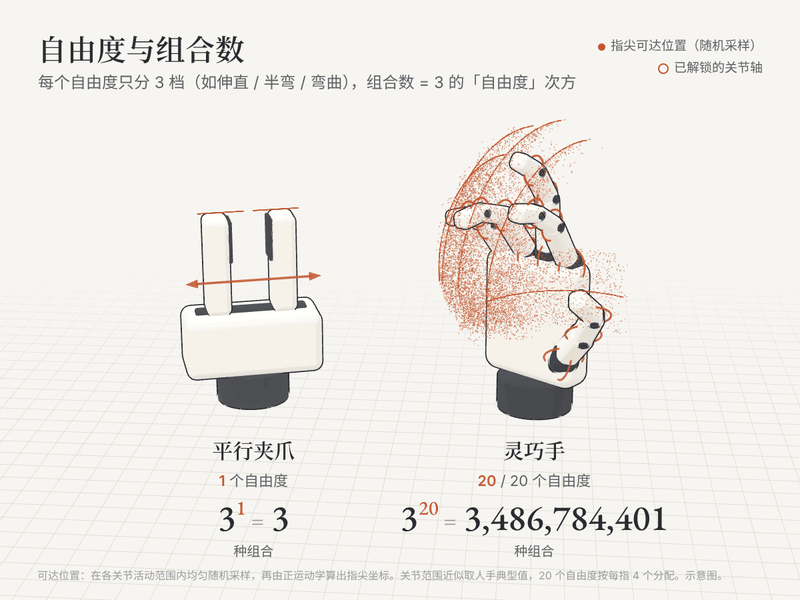
Anzahl der Freiheitsgrade und Kombinationsmöglichkeiten von Parallelgreifern und geschickten Händen, KI-generiert
Nach Ansicht des Teams von Nature Will konzentrierten sich frühere Arbeiten meist auf einen der beiden Bereiche: Entweder allgemeine Strategien für Greifer oder geschickte Betriebssysteme, die für einzelne Aufgaben entwickelt wurden.
Auf der Seite der Allgemeinverträglichkeit gibt es bereits wichtige Fortschritte wie π0.7, aber die Umsetzung dieser Allgemeinverträglichkeit bei geschickten Händen stößt zunächst an die Grenze der Daten. Generalisierung hängt von großen, vielfältigen Trainingsdaten ab, während reale Roboterdaten teuer sind – die Erfassung durch Teleoperation von geschickten Händen ist zudem langsam und schwierig.
Das Team von Nature Will weist zudem auf einen grundlegenden Kreislauf hin: Roboter können nur Daten an Orten erfassen, an denen sie bereits arbeiten können, und sie können nur an Orten arbeiten, für die sie bereits Daten haben. Um diesen Kreislauf zu durchbrechen, müssen die Daten von außerhalb des Roboters stammen.
Daher richten immer mehr Teams den Blick auf eine vorhandene Datenquelle: den Menschen selbst.
Im Februar dieses Jahres veröffentlichte ein Team um Nvidia EgoScale, das mit 20.854 Stunden an menschlichen Betriebsvideos aus der Egoperspektive ein VLA-Modell vortrainiert hat. Dabei wurde eine logarithmisch-lineare Beziehung zwischen dem Datenumfang und dem Validierungsverlust beobachtet. Nach der Bereitstellung auf einer geschickten Hand mit 22 Freiheitsgraden lag die durchschnittliche Erfolgsrate um 54 % höher als bei der Basislinie ohne Vortraining mit menschlichen Daten.
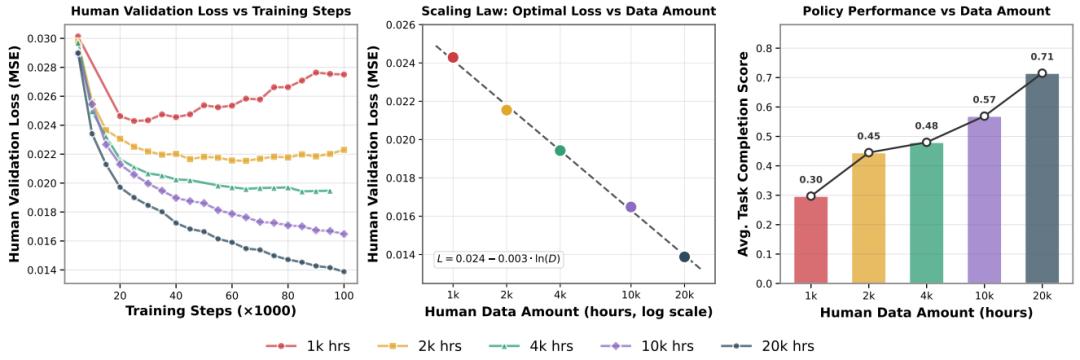
Skalierungsverhalten des menschlichen Vortrainings: Die Funktion des optimalen Validierungsverlusts bei Konvergenz in Abhängigkeit vom Umfang menschlicher Daten zeigt ein nahezu perfektes logarithmisches Skalierungsgesetz, arXiv:2602.16710
Ein halbes Jahr später wurde dieser Umfang um etwa das 50-fache gesteigert. Am 10. August veröffentlichte das amerikanische Robotikunternehmen Dyna Robotics das Welt-Aktions-Modell DYNA-2, das mit mehr als 1 Million Stunden an menschlichen Videos aus der Egoperspektive vortrainiert wurde – in der Vortrainingsphase sind keine Roboterdaten enthalten. Laut Dyna stieg die durchschnittliche normalisierte Punktzahl des Modells bei 14 Roboteraufgaben von 20 % auf 53 %, wenn der Datenumfang schrittweise von 1000 Stunden auf 1 Million Stunden erhöht wurde.
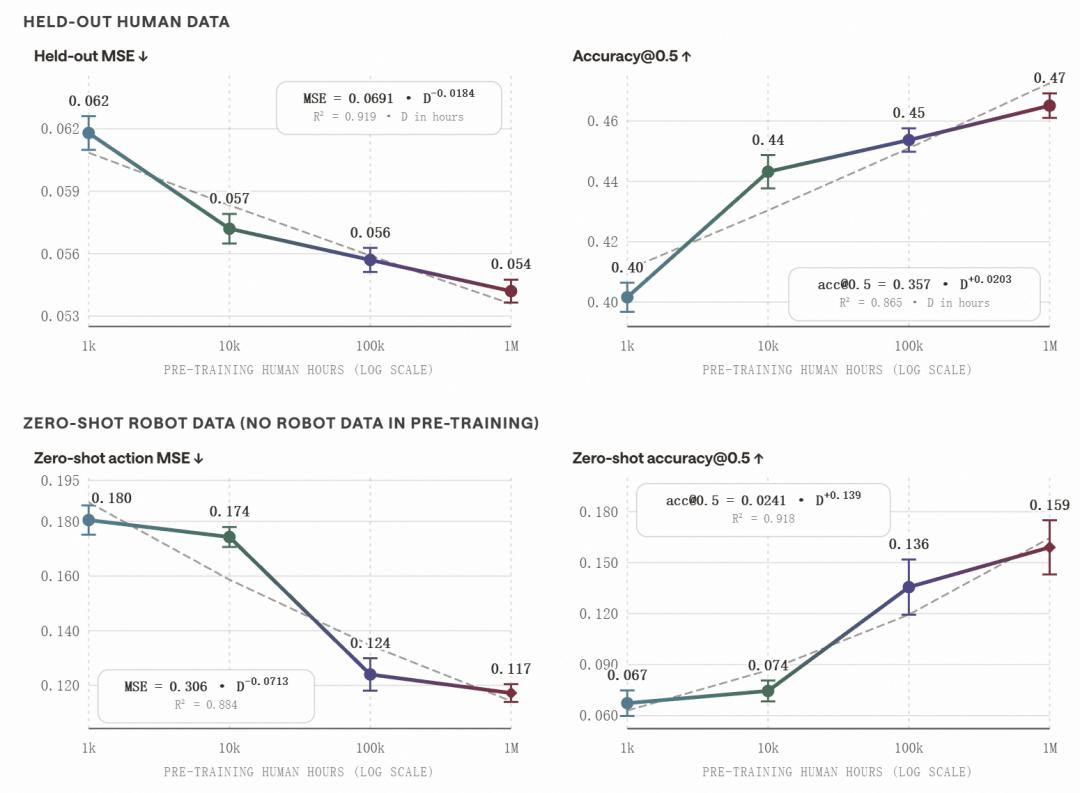
Skalierungsgesetz des Dyna-2 Welt-Aktions-Modells, trainiert auf einer Stufe von menschlichen Videodaten von 1000 Stunden bis 1 Million Stunden. https://www.dyna.co/dyna-2
Beide Arbeiten umgingen jedoch nicht denselben Punkt: Um menschliche Erfahrungen auf spezifische Aufgaben zu übertragen, ist weiterhin eine zusätzliche Anpassung erforderlich. EgoScale verwendet eine kleine Menge an Mensch-Maschine-Ausrichtungsdaten für das Zwischentraining, und DYNA-2 nutzt bis zu 10 Stunden an Roboterdaten für das Nachtraining bei jeder Bewertungsaufgabe.
Es hat sich gezeigt, dass menschliche Erfahrungen in großem Umfang an Roboter weitergegeben werden können. Die nächste Frage lautet: Können diese Erfahrungen ohne aufgabenspezifische Anpassung direkt auf neue Aufgaben auf einer geschickten Hand mit hohen Freiheitsgraden übertragen werden?
Natura-1: Ein Modell, zwei Fähigkeiten
Nature Will wurde im Januar 2026 von Ding Ning, Assistenzprofessor am Lehrstuhl für Elektrotechnik der Tsinghua-Universität, gegründet. Es ist ein forschungsorientiertes Unternehmen, das sich auf grundlegende Modelle für die physische Welt konzentriert. Das Unternehmen hat sich das Ziel gesetzt, allgemeine physische Intelligenz (Physical AGI) zu entwickeln: Ein allgemeines grundlegendes Modell zu trainieren, das in der realen Welt den geschlossenen Kreislauf aus Wahrnehmung, Vorhersage, Schlussfolgerung und Aktion abschließen kann.
Das Team von Nature Will teilte mit, dass dies auf zwei Überzeugungen beruht:
Ein allgemeines grundlegendes Modell für die physische Welt kann realisiert werden;
Menschliche Daten aus der Egoperspektive erfüllen bereits die Voraussetzungen für eine großtechnische Erfassung.
Die Methodik hinter diesen beiden Überzeugungen setzt die Forschung an großen Sprachmodellen fort: Modell, Daten und Infrastruktur müssen gemeinsam entwickelt werden. Das Team von Nature Will erklärte: „Wir haben den Ansatz übernommen, bei dem Modellgröße und Datenumfang gemeinsam wachsen, wie er in der Forschung an großen Sprachmodellen üblich ist. In der frühen Phase haben wir zunächst mit kleineren Modellen und Daten die Architektur schnell validiert und nach Bestätigung der Richtung schrittweise erweitert, anstatt von Anfang an festzulegen, dass wir unbedingt ein 50B-Modell erstellen müssen.“
Natura-1 ist das erste allgemeine grundlegende Modell für die physische Welt von Nature Will. Sein Training erfolgt in zwei Schritten: Zuerst wird es auf 1 Million Stunden an menschlichen Erfahrungsdaten vortrainiert, anschließend wird es mit begrenzten Roboterdaten in einer effizienten Nachtrainingsphase angepasst, um das im Vortraining erworbene Wissen über die Welt auf die geschickte Manipulation zu übertragen.
Im Gegensatz zu vielen Systemen, die „Anweisungen verstehen“, „Welt vorhersagen“ und „Aktionen generieren“ in separate Module aufteilen, ist Natura-1 ein einheitliches MoE-Transformer-Modell, das gemeinsam auf Sprache, Bildern, Videos und Aktionen trainiert wird. Es zielt auf zwei Fähigkeiten ab:
Geschickte Manipulation, die mit geschickten Händen kooperative Aktionen mehrerer Finger, Anpassung der Objektausrichtung und komplexe Kontaktvorgänge ermöglicht;
Zero-Shot-Befolgung von Anweisungen, bei der das Modell in unbekannten Szenarien und bei unbekannten Aufgaben direkt auf Anweisungen in natürlicher Sprache hin die Operationen durchführt, einschließlich der Berücksichtigung räumlicher Beschränkungen, Beziehungen zwischen mehreren Objekten und negativer Bedingungen.
Was kann Natura-1 tun?
Das Team von Nature Will hat Natura-1 auf drei Ebenen getestet:
Bei lang andauernden Aufgaben wird untersucht, wie detailliert und nachhaltig eine geübte Fähigkeit ausgeführt werden kann.
Bei Zero-Shot-Tests wird geprüft, ob das Modell Aufgaben, die es nie geübt hat, direkt übernehmen kann.
Der letzte Teil umfasst sogenannte Emergenzfähigkeiten: Kann das Modell selbst Lösungen finden, wenn eine Aufgabe nicht reibungslos verläuft?
Geschicklichkeit: Sechs durchgehende lang andauernde Aufgaben in einem einzigen Take
Neben dem Formen von Wontons hat das Team von Nature Will fünf weitere Demos veröffentlicht: Tee zubereiten, Joghurt-Schüssel zubereiten, Pakete verpacken, Handyfolie aufkleben und mit Pinsel schreiben. Die längste Sequenz dauert mehr als 3 Minuten, alle sind in Originalgeschwindigkeit, durchgehend und ohne menschlichen Eingriff aufgenommen. Jede Sequenz umfasst mehrere Teilaufgaben, und der Roboter muss im selben Ablauf nacheinander mit Flüssigkeiten, Körnern, weichen Werkzeugen und flexiblen Komponenten umgehen.
Nehmen wir das 3-minütige Aufkleben einer Handyfolie als Beispiel: Natura-1 wischt zuerst den Bildschirm ab, setzt dann den Ausrichtungsrahmen der vorinstallierten Schutzfolie auf das Handy, richtet es mit beiden Händen aus und drückt es fest. Anschließend hält es Handy und Ausrichtungsrahmen mit einer Hand an einer Halterung fest, zieht die Trennfolie mit der anderen Hand flüssig heraus und drückt schließlich mit den Fingerspitzen entlang der Kanten, um Blasen zu entfernen.
Beim Verpacken von Paketen wechselt es die Greifmethode zwischen Seidenpapier, Plüschtieren und Notizbüchern, drückt den rückfedernden Deckel der Kiste mit einer Hand fest, bewegt den Klebebandspender mit der anderen Hand, um die Kiste zu verschließen, und bringt schließlich das Etikett an und scannt den Barcode.
Diese Bewegungen verändern während der Ausführung die Form des Objekts und die Kontaktbedingungen. Das Modell muss sich ständig anhand von Echtzeit-Feedback korrigieren, anstatt einem festen Ablauf zu folgen.
Es ist hervorzuheben, dass diese sechs Demonstrationen die Tiefe der Operationen nach der Feinabstimmung von Aufgaben zeigen. Ob die Fähigkeiten auf ungeübte Aufgaben übertragen werden können, hängt von den Zero-Shot-Tests ab.
Zero-Shot: Aufgaben, die nie geübt wurden
Was zählt als Zero-Shot? Das Team von Nature Will erklärte: „Unter Zero-Shot verstehen wir, dass das Modell nach Abschluss des Vortrainings und des Nachtrainings auf dem echten Roboter keine zusätzlichen Daten für die Testaufgabe erfasst und kein weiteres Training durchläuft, sondern direkt Anweisungen entgegennimmt und ausführt.“
Das Team hat einen Benchmark-Test erstellt, der 12 Fähigkeitsdimensionen abdeckt. Die Testaufgaben sowie ihre Szenarien und Aktionskombinationen sind nicht in den Nachtrainingsdaten enthalten. Neben jedem Testvideo wird zudem das ähnlichste Beispiel aus dem Trainingssatz platziert, damit die Öffentlichkeit die Unterschiede beurteilen kann. Eine Aufgabe fordert beispielsweise auf, einen Apfel in eine Schüssel zu legen, eine Flasche auf ein Tablett zu stellen und das Tablett dann wegzutragen – während der Trainingssatz nur getrennte Aktionen wie „Obst heben“ und „bereits gefülltes Tablett tragen“ enthält. Natura-1 kombiniert diese Aktionen und berührt beim Tragen des Tabletts kein anderes daneben stehendes Tablett.
Auf diesem Benchmark erzielten π0.5 und GPT-6 Astra von OpenAI (das als Steuerungsstrategie durch Codierung fungiert) auf der Plattform mit geschickten Händen keine Punkte. Auf einer Greiferplattform erreichten die beiden Modelle 13,5 bzw. 16,7 Punkte, während Natura-1 auf der geschickten Hand 53,4 Punkte (Base) und 59,1 Punkte (Agentic) erzielte.
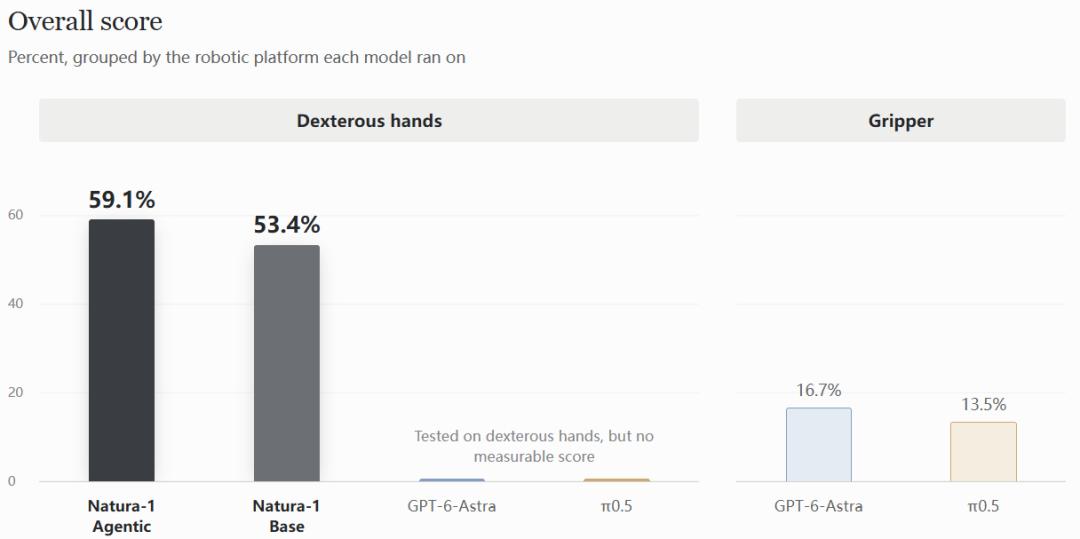
Darüber hinaus hat Natura-1 deutliche Vorteile bei der Ausführungszeit.
