Ein erst vor neun Monaten gegründetes Unternehmen lässt Roboter aus der „vorprobten Welt“ heraustreten
In den neun Monaten, in denen die Embodied Intelligence besonders boomt, ist ein Team besonders unauffällig geblieben.
Während Konkurrenten mit einem Roboterdemo nach dem anderen um Aufmerksamkeit buhlen, setzt dieses Team auf etwas Langsameres und Teureres: das Training eines universellen Modells für die physische Welt.
Dieses Unternehmen heißt Natural Will. Es wurde im Januar 2026 gegründet und hat von Anfang an das Ziel auf ein universelles Grundmodell für die physische Welt gesetzt, das mit ein und demselben Modell ständig neue Aufgaben bewältigen soll.
Erst im Oktober 2026 trat dieses Team mit seinem Produkt erstmals öffentlich auf und stellte das universelle Grundmodell Natura-1 für die physische Welt im 50B-Bereich vor. Es wurde mit Millionen von Stunden menschlicher Ego-Perspektivdaten vortrainiert und zeigt derzeit bereits Fähigkeiten für geschickte Bedienung und Zero-Shot-Befehlsfolge. Bei unbekannten Objekten und spontanen Befehlen kann es vorhandene Erfahrungen nutzen, um Bewegungen zu organisieren, und nach entsprechender Anpassung sogar komplexere Langzeitaufgaben bewältigen.
Jetzt beginnt Natura-1 auch, Erfahrungen aus der realen Welt aufzunehmen.
01 Roboter lernen, neue Aufgaben zu lösen
Roboter im Alltag zu sehen, ist längst keine Neuigkeit mehr. Nehmen wir zum Beispiel die weit verbreiteten Kaffeeroboter in Einkaufszentren: Der Roboterarm nimmt Becher aus festen Positionen, fügt Zutaten in voreingestellter Reihenfolge hinzu und legt das fertige Produkt an die Ausgabe. Solange Becher und Zutaten an bekannten Positionen stehen, arbeitet er stabil.
Probleme entstehen oft durch einen Unfall. Wenn der Becher von seiner Position abweicht, verlieren die im Programm festgelegten Koordinaten ihre Gültigkeit. Die Bewegungen des Roboters sind weiterhin präzise, aber das Ergebnis ist, dass er präzise in die Luft greift.
Ein Mitglied des Teams fasst diesen Unterschied einmal so zusammen: „Ohne Variablen braucht man kein Modellieren, da reicht die Programmierung.“
Das stimmt auch tatsächlich. Vorprogrammierte Roboter handeln nach Abläufen, die Ingenieure im Voraus geschrieben haben, und geraten leicht in Schwierigkeiten, sobald sich die Umgebung ändert. Roboter-Modelle hingegen führen einen zusätzlichen Bewertungsschritt durch: Sie beobachten die vorliegende Umgebung, verstehen die vom Menschen gegebenen Befehle und organisieren dann die Bewegungen entsprechend den Änderungen vor Ort.
Erst wenn die Realität vom Programm abweicht, kommt das Modell zum Einsatz.
Das von Natura-1 betonte Zero-Shot Instruction Following löst genau diese Art von Änderungen: Das Modell überspringt das spezielle Training für die aktuelle Aufgabe, lernt direkt unter unbekannten Befehlen selbstständig und führt die Bewegungen aus.
Zum Beispiel: Die Trainingsdaten haben dem Roboter beigebracht, Äpfel zu greifen, aber nicht, Objekte abzuwischen, und die Aufgabe, einen Apfel abzuwischen, wurde nie festgelegt. Wenn die Mitarbeiter diesen Befehl spontan geben, kann das Modell jedoch schnell selbstständig die neue kombinierte Bewegung des Apfelabwischens erlernen.
In einem weiteren Test ließ das Team von Natural Will den Roboter zuerst Objekte auf der linken und rechten Seite bewegen. Er führte zwei Greifvorgänge nacheinander aus. Als das Wort „gleichzeitig“ zum Befehl hinzugefügt wurde, änderte sich die Bewegung des Roboters: Eine Hand hielt das Objekt fest und blieb an Ort und Stelle, die andere Hand führte dann den Greifvorgang aus, und beide Hände bewegten sich schließlich gemeinsam.
In einem weiteren Fall brachte das Team spontan einen Laptop mit und ließ den Roboter den Bildschirm öffnen und die Leertaste drücken. In den vergangenen Trainings waren Computer und Tastatur nie vorgekommen, und das Team hatte keine großen Erwartungen. Überraschenderweise hob der Roboter schnell den Bildschirm an, bewegte die Hand über die Tastatur und streckte schließlich den Zeigefinger aus, um die Leertaste zu drücken.
Das ist ein interessantes Experiment, das zeigt, dass das Modell bereits die gesammelten Wissen über Objekte und Bewegungserfahrungen auf unbekannte Aufgaben übertragen kann. Nach mehrmonatigem Training sind die Fortschritte von Natura-1 immer deutlicher geworden: Es kann nicht nur mehr spontane Befehle per Zero-Shot verarbeiten, sondern nach Aufgabenanpassung auch kontinuierliche Vorgänge mit mehr Schritten abschließen.
Diese beiden Beispiele wirken sehr einfach, dahinter verbirgt sich aber ein langjähriges Problem der Embodied Intelligence: Roboter können einen Satz von Bewegungen im Training auswendig lernen, aber in der realen Welt tauchen jeden Tag neue Probleme und Anforderungen auf. Nur wenn das Modell die Beziehung zwischen Objekten und Bewegungen versteht, kann es die erlernten Erfahrungen neu kombinieren.
Für Roboterunternehmen verändert diese Fähigkeit auch die Art der Projektabwicklung.
Natural Will hat schon früh das Nach-Training und das Echtgeräte-Reinforcement-Learning optimiert. Daher kann der Roboter mit Greifern schnell Aufgaben wie das Herstellen von Teigtaschen erledigen, aber das Team ist der Meinung, dass dies nicht das Endziel ist. Ihrer Auffassung nach ist „The world is built for hands“ – die Welt des Menschen ist auf Hände ausgerichtet – und geschickte Hände sind die Zukunft. Aus praktischer Sicht sind Messerhalter und Tabletts, die in vielen Roboterdemos scheinbar willkürlich auf dem Tisch platziert werden, zuvor mehrfach getestet worden. Wenn man sie nur wenige Zentimeter zur Seite verschiebt, kann die Erfolgsrate deutlich sinken.
Hinter einem flüssigen Video von wenigen Minuten steckt daher oft eine Woche oder zwei Wochen an Einstellarbeit. Mit steigender Anzahl von Projekten muss auch die Zahl der Mitarbeiter vor Ort für die Einstellarbeiten steigen. Mit jedem verkauften Roboter übernimmt das Unternehmen eine zusätzliche Abwicklungsaufgabe.
Universelle Modelle versuchen, diese Situation zu ändern. Sie erwerben zunächst breitere Betriebserfahrungen, benötigen nur wenige zusätzliche Daten, wenn sie in neue Szenarien eintreten, und lassen Ingenieuren die Zeit für komplexere, weniger verbreitete Aufgaben.
Später entschied sich Natural Will, das Testen von Wontons mit geschickten Händen durchzuführen. Das Team suchte im Internet eine einfache Faltmethode und ließ den Roboter die Wonton-Hülle auf die Handfläche legen und sie dann mit der anderen Hand zusammenkneten. Kleine Modelle griffen jedoch oft ins Leere, manchmal drückten sie zu fest und durchbohrten die Wonton-Hülle.
Nach der früheren Erfahrung bei der Erstellung von Demos bedeutete dies, dass der Ablauf neu entworfen werden musste. Aber am nächsten Tag, nachdem eine mit mehr Daten trainierte Modellversion auf dem Gerät geladen wurde, richtete der Roboter die Wonton-Hülle selbst aus und kontrollierte die Kraft seiner Finger. Die Bewegung, bei der man ursprünglich wiederholt Korrekturen erwartet hatte, gelang auf diese Weise.
Das ist auch der Grund, warum Natural Will sich für geschickte Hände entschieden hat. Greifer sind zwar ausgereift, aber ihre Bewegungen bestehen hauptsächlich aus Öffnen und Schließen. Bei Scheren benötigen sie speziell umgebaute Werkzeuge; bei weichen Objekten lassen sich die feinen Abstimmungen zwischen Fingern kaum durch die zwei Richtungen Öffnen und Schließen darstellen.
Geschickte Hände ermöglichen es dem Roboter, nach menschlichen Methoden zu arbeiten. Zero-Shot-Befehlsfolge lässt ihn neue, spontan auftauchende Aufgaben verstehen, und geschickte Bedienung wandelt das Verständnis in Bewegungen um. Durch die Kombination dieser beiden Fähigkeiten können Roboter von der Arbeitsweise „eine Aufgabe mit einem zugehörigen Programm“ abweichen und haben die Chance, individuelle kundenspezifische Abwicklungen zu skalierbaren Produkten zu machen.
02 Woher stammen die Millionen von Stunden an Daten
Nachdem die Richtung für geschickte Hände festgelegt war, stand das Team bald vor der nächsten Herausforderung: der Datenerfassung.
Wenn man Daten für dieselbe Aufgabe wiederholt erfasst, wird das Modell zwar immer geübter, aber für die nächste Aufgabe muss man wieder von vorne anfangen. Wenn universelle Fähigkeiten davon abhängen, dass das Modell reichhaltige Betriebsvorgänge gesehen hat, muss die Datenquelle langfristig erweitert werden.
Natural Will hat schon früh Ego-Perspektivdaten als Kern-Trainingsdaten festgelegt. Im Vergleich zur Fernsteuerung von Robotern ist der Erfassungsprozess von Ego-Daten leichter. Ein am Kopf des Menschen befestigtes Handy kann den gesamten Prozess aufzeichnen, in dem beide Hände echte Arbeiten erledigen. Die Erfassungsszenarien können schnell erweitert werden, und die Kosten lassen sich leichter kontrollieren. Auf dieser Basis hat Natural Will schrittweise eine Datenverarbeitungspipeline aufgebaut. Heute erreicht die Vortrainingsdatenmenge von Natura-1 Millionen von Stunden, die hauptsächlich aus menschlichen Bedienvorgängen in der realen Welt stammen.
Ego-Perspektivvideos zeichnen menschliche Hände auf. Wie sich Finger biegen, wie die Handfläche Objekte stützt und wie sich die Kontaktpunkte ändern – all diese Informationen sind in den Videos verborgen. Wenn man am Ende Greifer verwendet, lassen sich die meisten dieser Details nur zu einem einzigen Öffnungs- und Schließvorgang komprimieren.
Wie das Team selbst sagt: „Informationen können von viel zu wenig werden, aber nicht von wenig zu viel.“
Bewegungen menschlicher Hände lassen sich zu Greiferbewegungen vereinfachen, aber Greiferdaten können die Koordination von fünf Fingern nicht ergänzen. Da Natural Will sich für menschliche Betriebsdaten entschieden hat, sind geschickte Hände die passendere Trägerplattform.
Bei der Auswahl der Modellarchitektur testete das Team zunächst verschiedene Lösungen innerhalb von zwei bis drei Wochen: Eine Kategorie ähnelte dem branchenüblichen VLA, die andere legte mehr Wert auf die Effizienz der Bewegungserzeugung. Letztendlich zögerte das Team nicht lange und etablierte schnell die Richtung des „universellen Grundmodells für die physische Welt“.
Es ist kein reines Action Model. Mit zunehmendem Trainingsumfang hat Natural Will auch Sprachverständnis und visuelle Informationen in dasselbe Modell integriert. Das Team ist der Meinung, dass Natura-1 kaum in die bestehenden Kategorien VLA oder WAM eingeordnet werden kann, und definiert es daher als eine unabhängige Route für universelle Grundmodelle der physischen Welt.
Das ist kein bloßes Namensspiel. Startups haben begrenzte Rechenleistung und Finanzmittel. Jeder zusätzliche Trainingslauf des Modells kostet echtes Geld. Bei gleichem Einsatz einer Datenmenge kann eine Architektur mit höherer Lerneffizienz offensichtlich viele Umwege vermeiden.
Nach mehreren Runden des Trainings erreichte die Parametergröße des Modells von Natural Will 50B, was es zu einem der derzeit in der Branche öffentlich bekanntgegebenen Grundmodelle für die physische Welt mit besonders großer Parametergröße macht. Bei einer Datenmenge von nur zehntausenden Stunden sind die Leistungen von 5B- und 50B-Modellen ähnlich. Aber wenn die Datenmenge auf ein größeres Niveau ansteigt, hat das 50B-Modell genug Kapazität, um mehr Erfahrungen aufzunehmen.
Mit anderen Worten: 50B und Millionen von Stunden sind ein abgestimmter Einsatz. Millionen von Stunden liefern dem Modell breitere Erfahrungen, und die 50B-Parameter sind dafür zuständig, diese Erfahrungen aufzunehmen. Nach Auffassung des Teams wird das bereits von großen Sprachmodellen bestätigte Scaling-Gesetz auch in der physischen Welt wirken: Mit dem gleichzeitigen Wachstum von Datenmenge und Modellgröße erwerben Roboter nach und nach neue Fähigkeiten, die früher einzeln trainiert werden mussten.
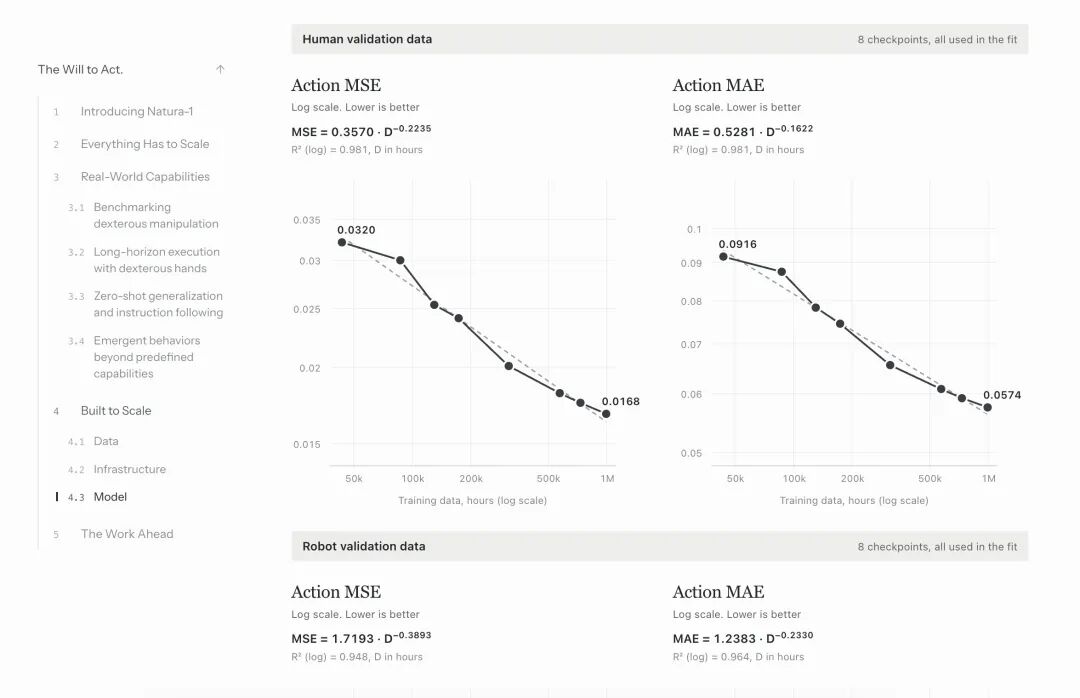
Für ein Startup bedeutet diese Richtung einen höheren Vorabinvestitionsaufwand. Viele Roboterunternehmen führen zuerst Projekte durch und nutzen dann die Einnahmen, um die Forschung und Entwicklung zu unterstützen. Natural Will hingegen entschied sich, zuerst das Datensystem aufzubauen und dann große Modelle zu trainieren. Ersteres sieht sofort Bestellungen in der Gegenwart, Letzteres setzt darauf, dass dasselbe Modell in mehr Szenarien wiederverwendet werden kann, und hat einen größeren industriellen Skaleneffekt.
Neue Daten verbessern das Modell, das verbesserte Modell kehrt zur Überprüfung auf dem Echtgerät zurück, und Fehler während des Tests liefern Hinweise für die nächste Trainingsrunde. Natural Will hofft, auf diese Weise eine nachhaltig evolvierbare Infrastruktur für physische Intelligenz zu schaffen, die die Fähigkeiten von Robotern mit der Anhäufung von Daten stetig wachsen lässt.
03 Nach dem Verlassen der Demo-Phase
Mit der Erweiterung der Modellgröße brachte Natura-1 eine weitere Überraschung mit sich: Das Modell begann, selbst Fehler zu korrigieren.
In einem Test sollte der Roboter das Handy auf dem Tisch greifen und es an eine festgelegte Stelle legen. In frühen Versionen bewegte sich der Roboterarm nach dem ersten verfehlten Greifversuch weiter zur Zielposition, als ob das Handy bereits in seiner Hand läge. Wenn der Arm das Ziel erreichte, bemerkte er manchmal erst, dass die Aufgabe nicht abgeschlossen war, und kehrte zum Ausgangspunkt zurück, um es erneut zu versuchen.
Die neue Version reagiert früher. Wenn die Finger das Handy berühren, es aber nicht fest greifen, bleibt der Roboterarm an Ort und Stelle und passt den Winkel neu an. Manchmal führt er sogar mehrere Versuche nacheinander durch, bis das Handy wirklich vom Tisch abgehoben ist.
Menschen können auf natürliche Weise mit dem Modell über Sprache interagieren, und der Roboter führt dann die Bewegungen aus. Wenn er scheitert, versucht er es selbstständig und korrigiert den Fehler.
Ähnliches trat auch bei der Verwendung von Scheren auf. Wenn die Finger beim ersten Mal von der Öffnung der Scherengriffe abwichen, passte der Roboter die Position weiter nach unten an, bis die Finger den Eingang fanden, und hob dann die Schere auf. Wie das Team mitteilte, wurden nur wenige Beispiele für aufeinanderfolgende Fehlschläge in das Training aufgenommen. Das Modell hat diese Wiederholungsversuche höchstwahrscheinlich aus den Millionen von Stunden menschlicher Bedienvorgänge gelernt – genau wie Menschen manchmal das Handy aus der Hand rutschen lassen und dann als nächstes sofort an Ort und Stelle noch einmal zugreifen.
Dabei geht es auch um die Gedächtnisfähigkeit von Natura-1. Einige frühe Robotermodelle generieren Bewegungen nur auf Basis des aktuellen Bildes, und jeder Frame wirkt wie ein Neubeginn. Das Team von Natural Will beschrieb diesen Zustand mit dem Satz „Every day is the first day“.
Natura-1 bezieht sich auf zuvor gesehene Bilder. Er weiß, dass er gerade einmal gegriffen hat, und kann die Veränderungen vor und nach der Bewegung vergleichen. Bei kurzen Aufgaben von wenigen Sekunden mag diese Gedächtniswirkung begrenzt sein, aber wenn sich die Aufgaben verlängern, wird die Gedächtnisfähigkeit immer unverzichtbarer.
Das Auftauchen der Fehlerkorrekturfähigkeit bringt Roboter näher an echte Arbeitsabläufe heran, aber Natural Will ist der Meinung, dass ein anderer Standard ebenso wichtig ist: Ein einmaliger zufälliger Erfolg zeigt nur, dass das Modell diese Fähigkeit potenziell besitzt. Erst wenn die Aufgabe stabil reproduzierbar ist, kann man sie als eine beherrschte Fähigkeit betrachten.
Nach der Veröffentlichung des Modells plant Natural Will, externe Personen zu den Vor-Ort-Tests einzuladen. Besucher können spontan Befehle eingeben oder mitgebrachte Gegenstände herausnehmen,