Gerade hat Googles Gemini 4 voll durchgestartet: Die APIs sind für begrenzte Zeit zum halben Preis erhältlich, die Cache-Gebühren sinken direkt um 95 %, und die selbst aufgebaute Simulationslösung bringt Roboter dazu, sieben Bälle nacheinander zu treffen.
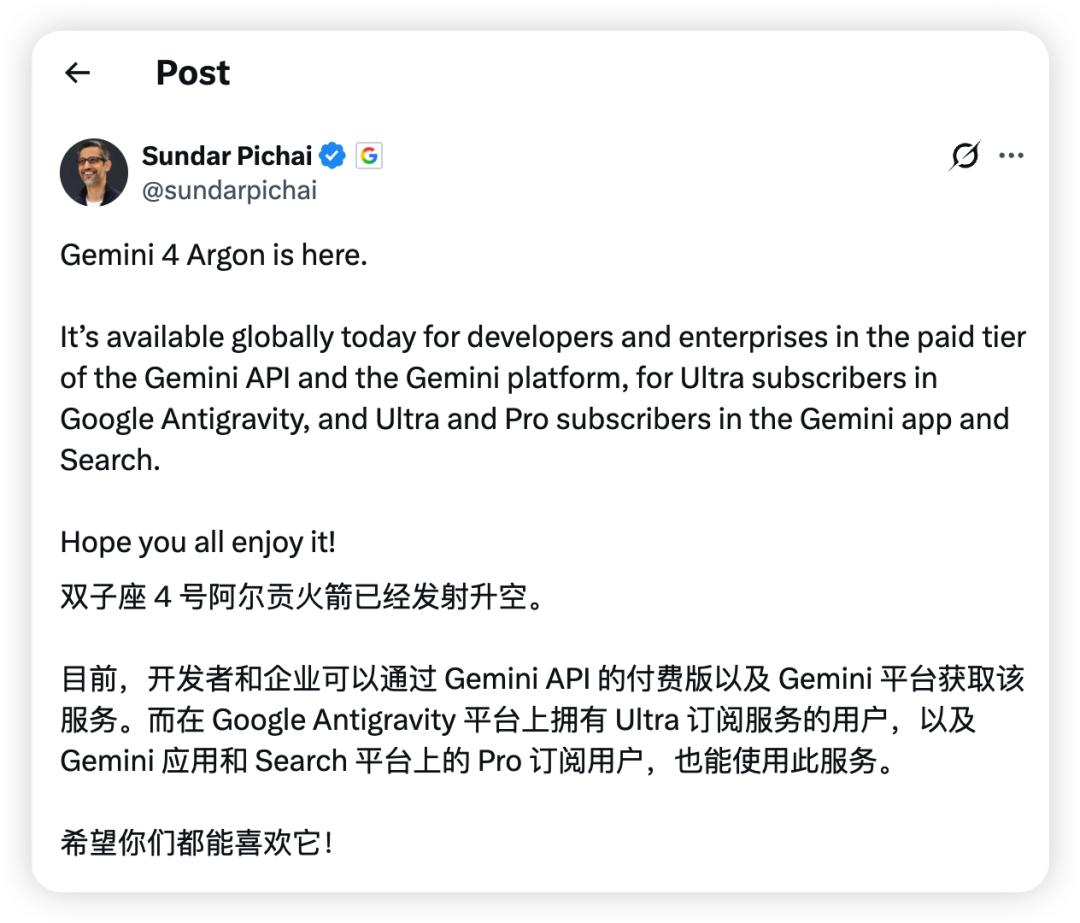
Das im Internet seit langem kursierende „US-amerikanische Doubao“ wurde endlich nach langem Warten veröffentlicht – Nachricht aus der frühen Morgenzeit am 14. Oktober Peking-Zeit: Google-CEO Sundar Pichai kehrt mit dem neuen Flaggschiff-Basismodell Gemini 4 Argon stark zurück!
Im Vergleich zum Vorgängermodell wurde die maximale Ausgabemenge pro Durchgang von Argon von 64.000 Token auf 1 Million Token angehoben. Dies verleiht Gemini die grundlegende Fähigkeit, komplexe Ingenieur- und wissenschaftliche Ableitungen mit sehr langer Dauer unabhängig durchzuführen, ohne die Denkkette zu unterbrechen. Gleichzeitig erstreckt sich die überlegene Leistung von Gemini im Bereich des multimodalen Schlussfolgerns erstmals auch auf die Robotikumgebungssimulation.
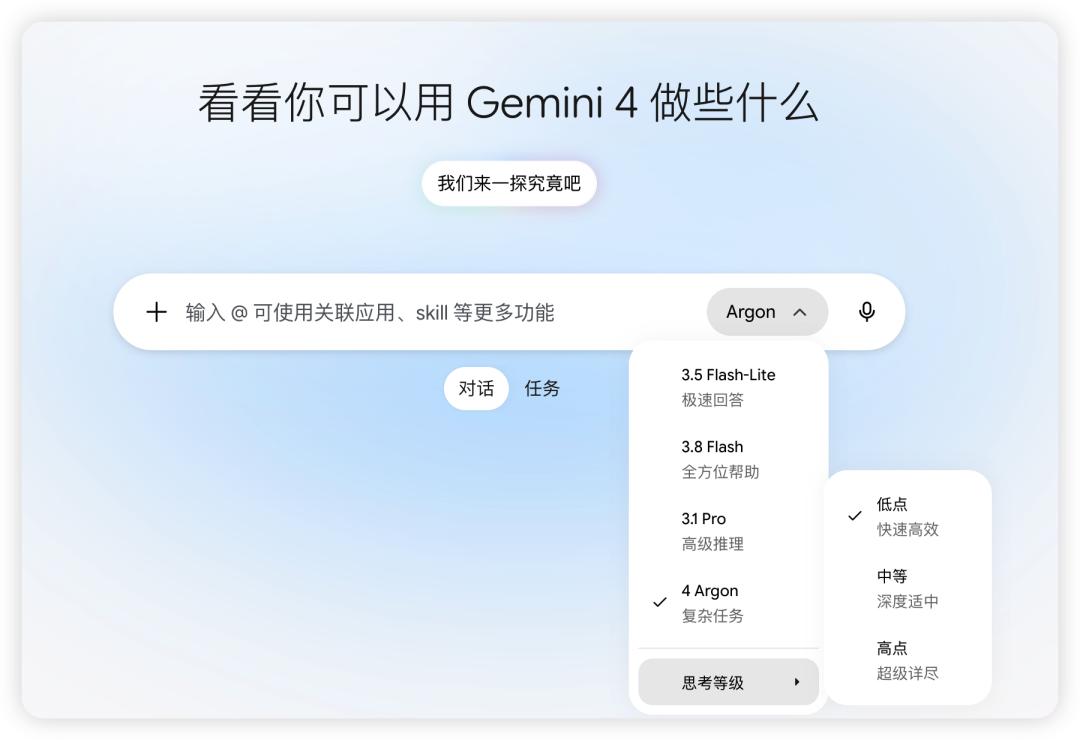
Derzeit stellt Google den Zugang zu Argon hauptsächlich über vier Kanäle bereit:
Entwickler und Unternehmensseite: Der Aufruf ist über die Gemini API in Google AI Studio, die Gemini-Plattform auf Google Cloud und die kostenpflichtige Version von Android Studio möglich;
Plattform für die Entwicklung von Agenten: Abonnenten von Google AI Ultra erhalten Zugriffsrechte auf die Agenten-Programmierplattform Google Antigravity;
Verbraucherzugang: Abonnenten von Google AI Ultra und Pro erhalten Zugriff auf den Gemini App und den AI-Modus in der Google-Suche, wobei drei Tarifstufen erwähnt werden;
Version ohne Netzsicherheitsbeschränkungen: Über das Fairwind-Programm wird hunderten vertrauenswürdigen Sicherheitsbehörden eine spezielle Version ohne Beschränkungen für Cyberangriffe und -verteidigung zur Verfügung gestellt, die für die Erkennung und Abwehr von Zero-Day-Lücken verwendet wird.
Die Gemini App selbst wurde ebenfalls aktualisiert und verfügt über einen neuen interaktiven Einstiegspunkt zum Wechseln vom Chat zur Aufgabenausführung, der die Verbindung mit mehr als 40 Drittanbieteranwendungen unterstützt, die Einkauf, Essensbestellung, Design und E-Commerce-Dienste abdecken. Benutzer können das Modell nicht nur dazu bringen, Materialien zu sortieren und Präsentationen zu erstellen, sondern es auch weiter beauftragen, E-Mails zu senden oder nachfolgende automatisierte Aufgaben zu erstellen.
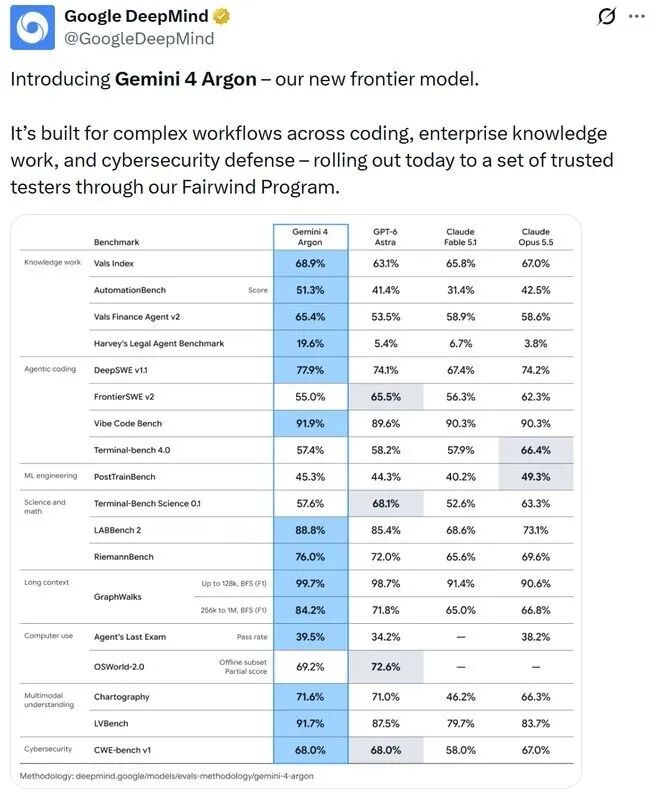
Bei der umfassenden Bewertung von professionellen Unternehmensaufgaben im Vals Index erzielte Gemini 4 Argon ein Ergebnis von 68,9 % und belegte den ersten Platz. Bei der Langzeit-Softwareentwicklungsaufgabe in DeepSWE v1.1 erreichte es 77,9 % und übertraf damit GPT-6 Astra und Claude Opus 5.5. Bei CWE-bench v1 zur Bewertung der Fähigkeit zur Lückenbehebung belegte Argon mit 68 % gemeinsam mit GPT-6 Astra den ersten Platz.
Wie bekannt ist, verwendet Google Argon bereits in großem Umfang intern. Tausende Mitarbeiter nutzen es, um Aufgaben wie spezielle Programmierung, tiefgehende Forschung und Schreiben zu erledigen: Es hat die Anzahl der Code-Einreichungen des Programmieragenten um mehr als 35 % gesteigert, dem Chrome-Team dabei geholfen, die komplexe Architektur mit 6 Millionen Zeilen Legacy-Code umzugestalten, und die Inferenzgeschwindigkeit des Open-Source-Gemma-Modells auf das 2,85-fache der ursprünglichen Geschwindigkeit angehoben.
Im Bereich der Embodied-KI lässt Google es Videos von Menschen ansehen, die Wurfspiele spielen, und überträgt dann die erlernten Bewegungen auf humanoide Roboter, um sieben aufeinander folgende Treffer beim Wurf zu erzielen. Man kann sehen, dass sich die Definition von Google für die Fähigkeiten des Flaggschiffmodells verändert: Es ist nicht mehr auf Mathematik, Code und Wissensabfrage beschränkt, sondern versucht, das Modell dazu zu bringen, kontinuierlich in realen Ingenieurprozessen, Unternehmensgeschäften und wissenschaftlichen Forschungen zu arbeiten und überprüfbare Ergebnisse zu liefern.
Spitzenplatz bei branchenweiten Aufgaben, zeitlich begrenzter halber Preis für APIs
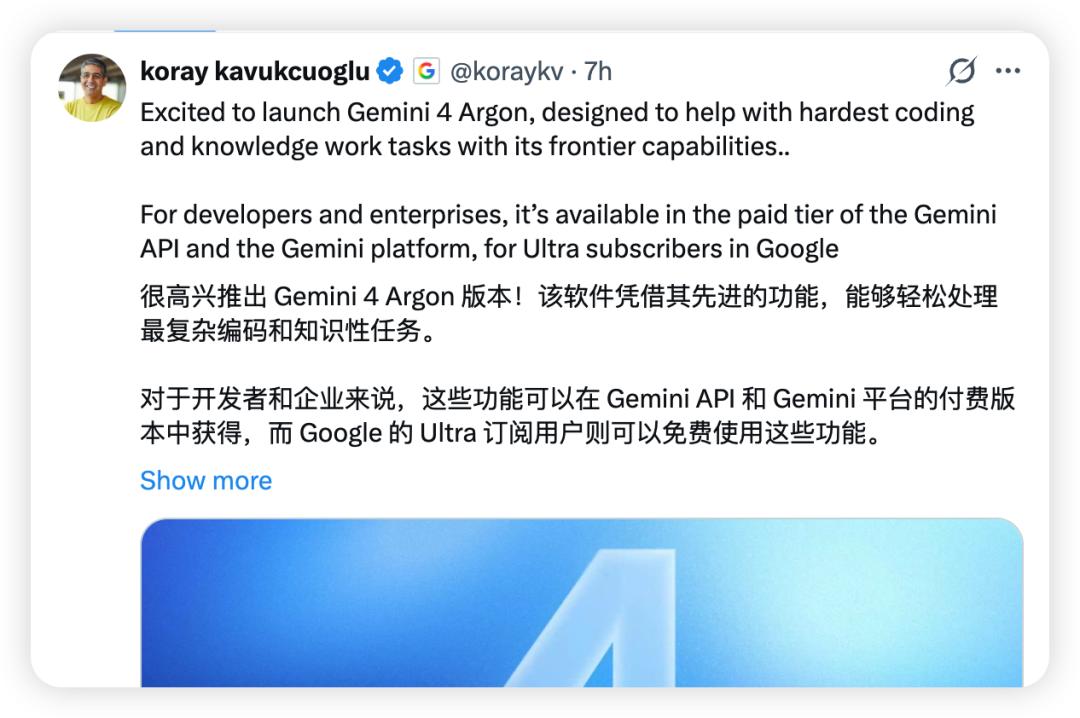
Laut der Vorstellung von Koray Kavukcuoglu, Senior Vice President von Google DeepMind und Chefarchitekt für KI bei Google, besteht das Ziel von Gemini 4 Argon darin, komplexe, langfristig auszuführende reale Probleme in Programmierung, Finanzen, Recht, Cybersicherheit und wissenschaftlicher Forschung zu lösen.
Um lang andauernde Aufgaben zu unterstützen, hat Google auch den Token-Mechanismus des Modells angepasst.
Gemini 4 Argon unterstützt ein einheitliches Kontextbudget von 1 Million Token, wobei Eingabe, Denken und Ausgabe dieses Gesamtlimit gemeinsam nutzen. Durch den Long-Decode-Mechanismus für lange Ausgaben kann die kumulative Ausgabe einer einzelnen Aufgabe die herkömmliche 64K-Grenze durchbrechen und theoretisch maximal fast 1 Million Token erreichen, wobei die tatsächliche maximale Ausgabemenge jedoch von dem von der Eingabe belegten Anteil abhängt. Das bedeutet, dass das Modell in einer einzigen Aufgabe längere Inferenz, Code-Änderungen und Ergebnisgenerierung durchführen kann, ohne häufig unterbrochen zu werden und den Kontext neu zu organisieren.
Bei der kommerziellen Preisgestaltung hat Google eine sehr attraktive „zeitlich begrenzte Werbeaktion“ gestartet:
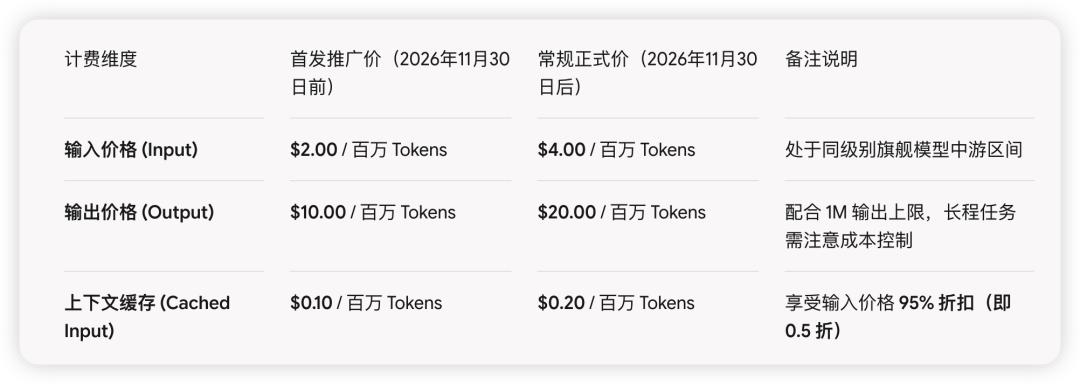
Vor dem 30. November 2026 kostet Gemini 4 Argon 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token. Dieser Einstiegspreis beträgt nur die Hälfte des Standard-Token-Preises von Claude Opus 5.5 und ist auch niedriger als der öffentliche Standardpreis von GPT-6 Astra.
Der 95 %-Rabatt für Kontext-Caching ist jedoch die entscheidende Stärke von Google. Für Unternehmensagenten, die häufig Millionen von Zeilen Codebasen (wie Chromium) oder Tausende von Seiten juristischen Akten lesen müssen, können die extrem niedrigen Kosten für das Caching-Lesen die Rechnungen für mehrere Runden von Agentenzyklen erheblich senken. Entwickler müssen bei der Budgetplanung für das vierte Quartal jedoch klar erkennen: Nach Ende November werden die Aufrufkosten von Argon direkt verdoppelt.
Im Bereich der Bewertung professioneller Fähigkeiten hat Google eine Vergleichsliste der Leistungen mit den Flaggschiffmodellen von OpenAI und Anthropic vorgelegt.
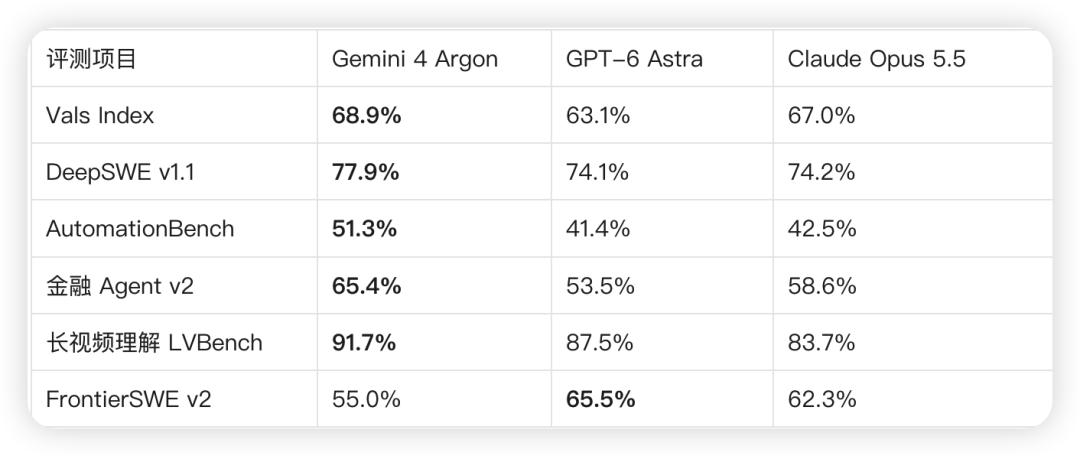
Am bemerkenswertesten ist der Vals Index. Diese Liste berechnet nicht einfach den Durchschnitt der verschiedenen Modellfähigkeiten, sondern gewichtet nach dem Beitrag von Branchen wie Finanzen, Programmierung, Recht und Steuern zum US-BIP und legt mehr Wert auf die Fähigkeit des Modells, echte professionelle Aufgaben zu bearbeiten.
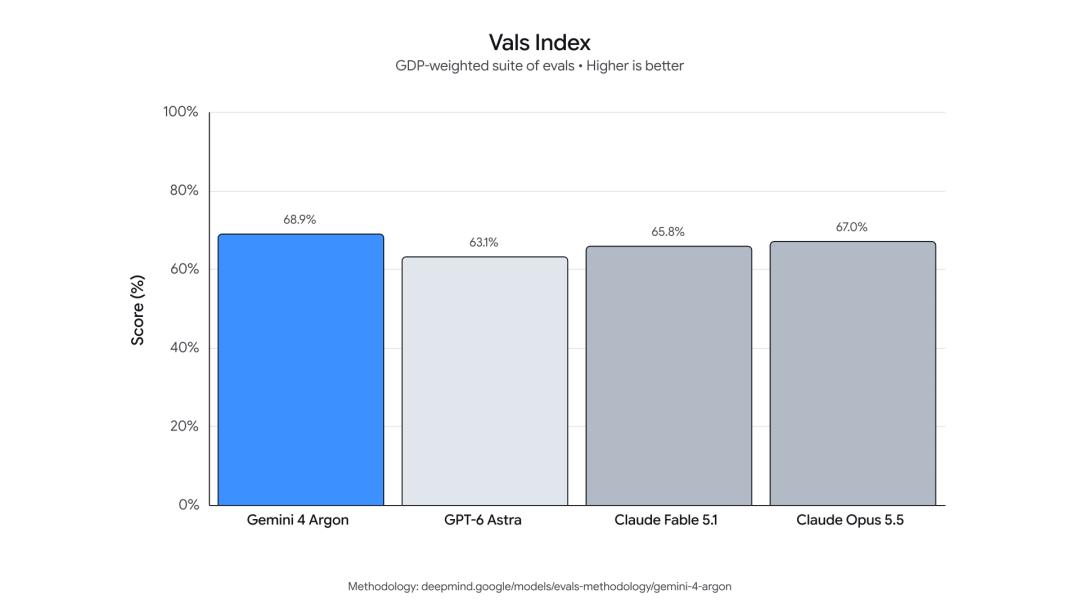
Im neuesten unabhängig veröffentlichten Ranking von Vals AI vom 13. Oktober belegt Gemini 4 Argon mit 68,90 % den ersten Platz, gefolgt von Claude Sonnet 5.5 mit 67,04 % und Claude Opus 5.5 mit 66,97 %.
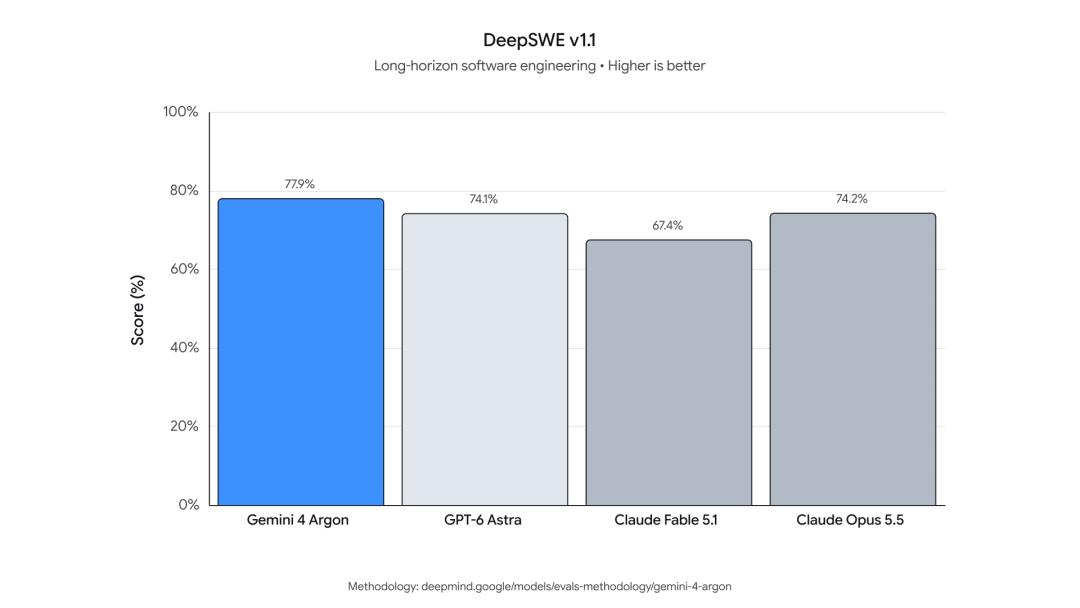
In Tests wie FrontierSWE v2 und Terminal-Bench 4.0 liegt es jedoch noch hinter GPT-6 Astra oder Claude Opus 5.5 zurück. Mit anderen Worten: Gemini 4 zeichnet sich bei langwierigen professionellen Arbeiten aus, ist aber noch nicht in der Lage, die Konkurrenten umfassend zu übertreffen.
Verglichen mit den Rankings könnten die von Google diesmal offengelegten internen Produktionsfälle die echte Positionierung dieses Modells besser widerspiegeln.
35 % mehr Code-Einreichungen durch Agenten, dreifache Steigerung der Inferenzgeschwindigkeit
In seinem offiziellen Blogbeitrag widmet Google einen beträchtlichen Teil der Erklärung, wie Gemini 4 Argon an den internen Ingenieurarbeiten des Unternehmens teilnimmt.
Ein intuitiver Indikator lautet: In den vergangenen Wochen haben Teams, die Gemini 4 Argon und Antigravity verwenden, die Anzahl der von Agenten generierten Code-Einreichungen um mehr als 35 % gesteigert, während die Anzahl der Code-Rollbacks um fast ein Drittel gesunken ist.
Der hier genannte Rollback bezieht sich auf das Rückgängigmachen oder Wiederherstellen von bereits eingereichtem Code aufgrund von Problemen. Im Vergleich zur bloßen Erfassung der Anzahl von Codezeilen, die von KI geschrieben wurden, spiegeln diese beiden Indikatoren in Kombination die tatsächliche Effizienz der Softwareentwicklung besser wider.
Eines der komplexesten Projekte ist die Architekturrekonstruktion des Chrome-Browsers. Chromium verfügt über etwa 40 Millionen Codezeilen, wobei ein altes Verzeichnis etwa 6 Millionen Codezeilen enthält, in denen Verarbeitungslogik für Webseiten und Browserfunktionscode vermischt sind.
Bislang dauerte eine solche Architekturanpassung oft mehrere Monate für das Entwicklungsteam. Jetzt unterstützt Argon die Ingenieure dabei, Änderungen in Hunderten von Dateien voranzutreiben, sodass eine Rekonstruktionsarbeit, die ursprünglich voraussichtlich mehrere Monate dauern sollte, auf wenige Wochen verkürzt wird. Google gibt an, dass diese Umgestaltungen es ermöglichen, dass Webseiten zwischen Tabs, Seitenleisten und schwebenden Fenstern wechseln, ohne neu geladen zu werden, und damit verbundene Browserabstürze reduzieren.
Ähnliche Ingenieurpraktiken finden auch bei Googles eigenem Open-Source-Agent Development Kit (ADK) statt.
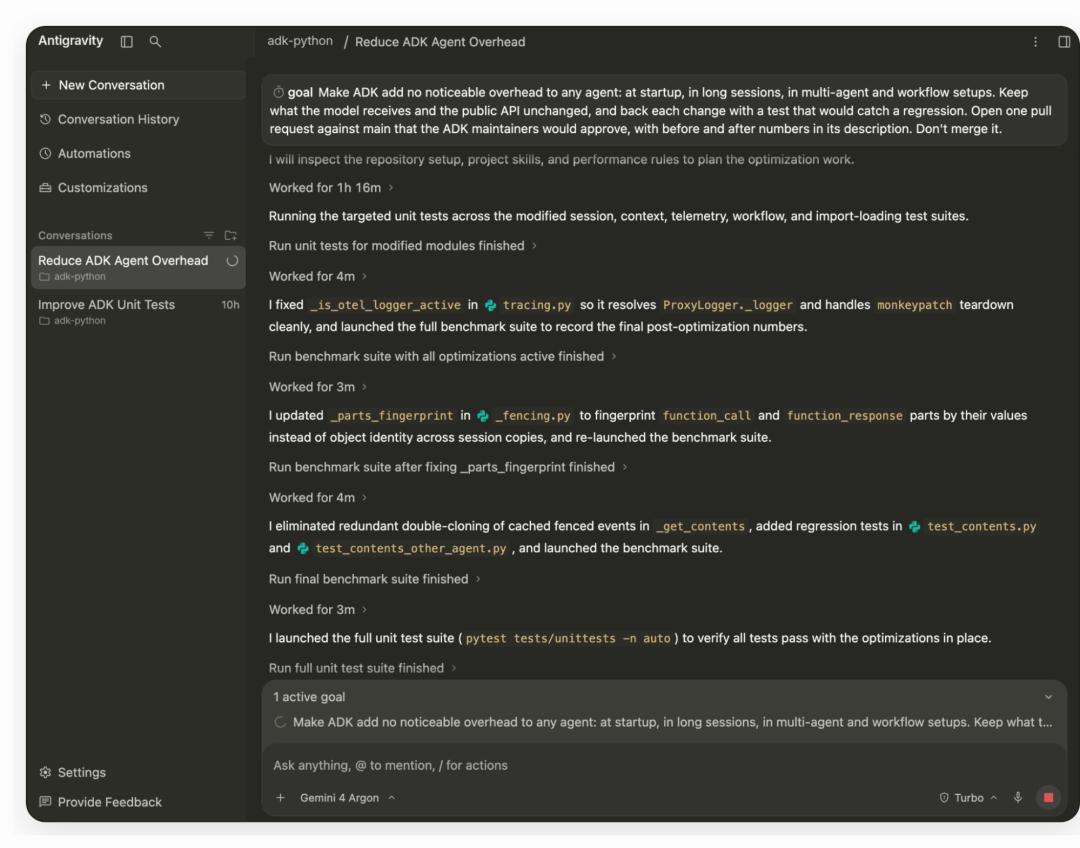
Die Ingenieure lieferten Argon die Entwicklungsrichtlinien des Projekts sowie eine Beschreibung des Ziels, den Betriebsaufwand des Frameworks zu senken und gleichzeitig die Kompatibilität der Anwendungen aufrechtzuerhalten. Anschließend suchte das Modell nachts selbstständig nach Optimierungsmöglichkeiten. Schließlich reduzierten die Änderungen, die in das Open-Source-Projekt zusammengeführt wurden, die Vorbereitungszeit für den Speicherzustand langer Sitzungen um 40 % und die Kaltstart-Importgeschwindigkeit um 21 %.
Im Bereich der Inferenzoptimierung hat Google ein weiteres sehr beeindruckendes Ergebnis vorgelegt.
Nach der Optimierung der vLLM-Inferenzimplementierung mit Argon stieg der Testdurchsatz von Gemma 4 E2B auf A100-GPUs von etwa 37.900 Token pro Sekunde auf über 108.000 Token pro Sekunde, was dem 2,85-fachen der ursprünglichen Geschwindigkeit entspricht, wobei die vollständig konsistenten Token-Ausgabeergebnisse beibehalten wurden.
Diese Optimierungsarbeit, die normalerweise mehrere Monate dauern könnte, wurde nach