Die KI-Szene im Silicon Valley ist völlig außer Rand und Band, wie viel Preis-Leistungs-Vorteil bleibt von Anbietern wie DeepSeek noch übrig?
Die Welle des Rabattausnutzens hat die Welt der großen KI-Modelle erreicht. Diesmal ist es das Silicon Valley, das ausgebeutet wird.
In letzter Zeit hat sich auf dem ausländischen Markt für große KI-Modelle ein besonderer „Subventionswettbewerb“ entfaltet. OpenAI verteilt wild „Guthabenrücksetzkarten“ an Nutzer, und Anthropic zieht mit: Zuerst bot es Startups ein kostenloses einjähriges Nutzungsrecht für Claude Team mit einem zusätzlichen Guthaben von 1000 US-Dollar an, dann folgte ein neuer Vorteil: monatlich kostenloses API-Guthaben, 100 US-Dollar für Max 5x, 200 US-Dollar für Max 20x und maximal 500 US-Dollar für die Team-Version.
Auf der anderen Seite wird der Preispool für kostenlose Modelle immer größer. Elon Musk hat auf der „Plattform X“ angekündigt, dass Grok Bot das Opus 5.5-Modell kostenlos zur Verfügung stellen und ihm den Zugriff auf alle Funktionen der Plattform X gewähren wird. Nachdem OpenAI GPT-6 vollständig eingeführt hat, können auch kostenlose Nutzer die Luna-Version nutzen.
Können die inländischen großen KI-Modelle ihre Preis-Leistungs-Vorteile behaupten, wenn die Hersteller im Silicon Valley wild mit Vergünstigungen werben?
Der von DeepSeek angefeuerte Preiskampf hat das Silicon Valley erreicht
Niedrige Preise, die einst als wichtiger Wettbewerbsvorteil chinesischer Modelle galten, werden zu einem Marktsegment, um das sich Hersteller auf der ganzen Welt gemeinsam bemühen. Neben der direkten Vergabe verschiedener Token-Subventionen senken ausländische Hersteller großer KI-Modelle nun die Nutzungshürden aus mehreren Dimensionen, wie z. B. der grundlegenden Preisgestaltung, der Modellhierarchie und dem Abrechnungsmechanismus.
Beginnend mit GPT-5.6 verfolgt OpenAI nicht mehr die Strategie, mit dem stärksten Modell allein den Markt zu dominieren, sondern teilt die Modelle nach Fähigkeitsstufen in verschiedene Preisstufen ein. Beispielsweise bietet die neueste GPT-6-Serie drei verschiedene Stufen an: Astra ist für die schwierigsten und komplexesten Aufgaben zuständig, Sol bietet ein ausgewogeneres Verhältnis von Leistung und Kosten, während Luna auf Aufrufszenarien mit niedrigeren Kosten ausgerichtet ist.
Darüber hinaus beginnt OpenAI auch, Nutzer durch schrittweise Preissenkungen anzuziehen. Laut offizieller Ankündigung wurden die API-Preise der GPT-5.6-Serie im Juli gesenkt: Der Preis von Terra sank um 20 %, und der Preis von Luna betrug nach der Senkung nur noch 20 % des ursprünglichen Werts. Im August wurden die API- und Guthabenpreise von GPT-5.6 Sol um weitere über 20 % gesenkt, und die Vergünstigungen sollen mindestens bis zum 21. November aufrechterhalten werden.
Besonders bemerkenswert ist, dass bei der Ausführung von GPT-6.1 Sol mit Abonnementguthaben keine Zuschläge für lange Kontexte mehr erhoben werden. In der Aktualisierung vom 12. Oktober erweiterte OpenAI das Standardfenster in Codex und ChatGPT Work von 272.000 auf 500.000, was einem Anstieg von etwa 80 % auf einmal entspricht.
Anthropic hingegen hat den Preiswettbewerb weiter in die Fähigkeiten der Modelle und die spezifischen Arbeitslasten unterteilt. Derzeit listet seine offizielle API-Preisseite mehrere Hauptmodelle auf. Claude Fable 5.1 ist für schwierige Schlussfolgerungsaufgaben und langfristige Agent-Aufgaben ausgelegt, Opus 5.5 konzentriert sich auf langwierige Codierungs- und Wissensarbeiten, Sonnet 5.5 vereint Geschwindigkeit und Fähigkeiten, und Haiku 5.5 ist für hochfrequente Aufgaben mit niedriger Latenz vorgesehen.
Die Preisgestaltung von Haiku 5.5 fällt besonders auf: Im Vergleich zur Vorgängergeneration wurde der Preis direkt um bis zu 90 % gesenkt. Bei weniger als 100.000 Token beträgt der Preis von Haiku 0,10 US-Dollar pro Million Token für die Eingabe und 0,50 US-Dollar für die Ausgabe, was sogar günstiger ist als der Preis von DeepSeek-V4.1 Flash in der Nebenzeitzone. Bei mehr als 100.000 Token liegt der Preis nur 50 % unter dem der Vorgängergeneration, befindet sich aber ebenfalls in einem sehr niedrigen Bereich.
Darüber hinaus schafft Anthropic für Nutzer weitere Kosteneinsparungspotenziale bei Batch-Aufgaben: Sowohl die Eingabe- als auch die Ausgabe-Token der Batch-API erhalten 50 % Rabatt. Am Beispiel von Sonnet 5.5 beträgt der Standardpreis 2 US-Dollar für die Eingabe und 10 US-Dollar für die Ausgabe; bei der Verarbeitung geeigneter nicht Echtzeit-Aufgaben über die Batch-API sinken die Preise auf 1 US-Dollar bzw. 5 US-Dollar.
Google bietet gleichzeitig eine kostenlose Stufe, eine kostenpflichtige Standardstufe sowie verschiedene Servicemodi wie Batch, Flex und Priority an und führt zudem schrittweise Vergünstigungen ein. Am Beispiel von Gemini 3.8 Flash: Nach den offiziell veröffentlichten Preisen beträgt der Standard-API-Eingabepreis dieses Modells bis zum 31. Dezember 2026 0,75 US-Dollar pro Million Token und der Ausgabepreis 3,75 US-Dollar; ab dem 1. Januar 2027 werden die Preise auf 1,50 US-Dollar bzw. 7,50 US-Dollar angepasst.
Was ausländische große Modellanbieter derzeit tun, ist, niedrige Preise zu einem vollständigen Produkt- und Abrechnungssystem zu machen, anstatt nur die Preise der Flaggschiff-Modelle zu reduzieren. Für chinesische Modelle ist der neue Wettbewerbsdruck nicht zu unterschätzen.
Sind chinesische große KI-Modelle nicht so billig wie angenommen?
Wenn man heute über die Preise großer KI-Modelle spricht, sollte man nicht nur prüfen, ob ein bestimmtes Unternehmen teuer ist, sondern zuerst fragen, welche Fähigkeitsstufe angeboten wird und welche Fähigkeiten der Nutzer tatsächlich benötigt. Innerhalb desselben Herstellers kann der Preisunterschied zwischen den Modellen zehn- bis hundertfach betragen.
Im Vergleich zu den API-Preisen haben chinesische große KI-Modelle tatsächlich immer noch einen deutlichen Vorteil bei niedrigen Preisen, was in den letzten Jahren eines der stärksten Wettbewerbsinstrumente chinesischer großer KI-Modelle war.
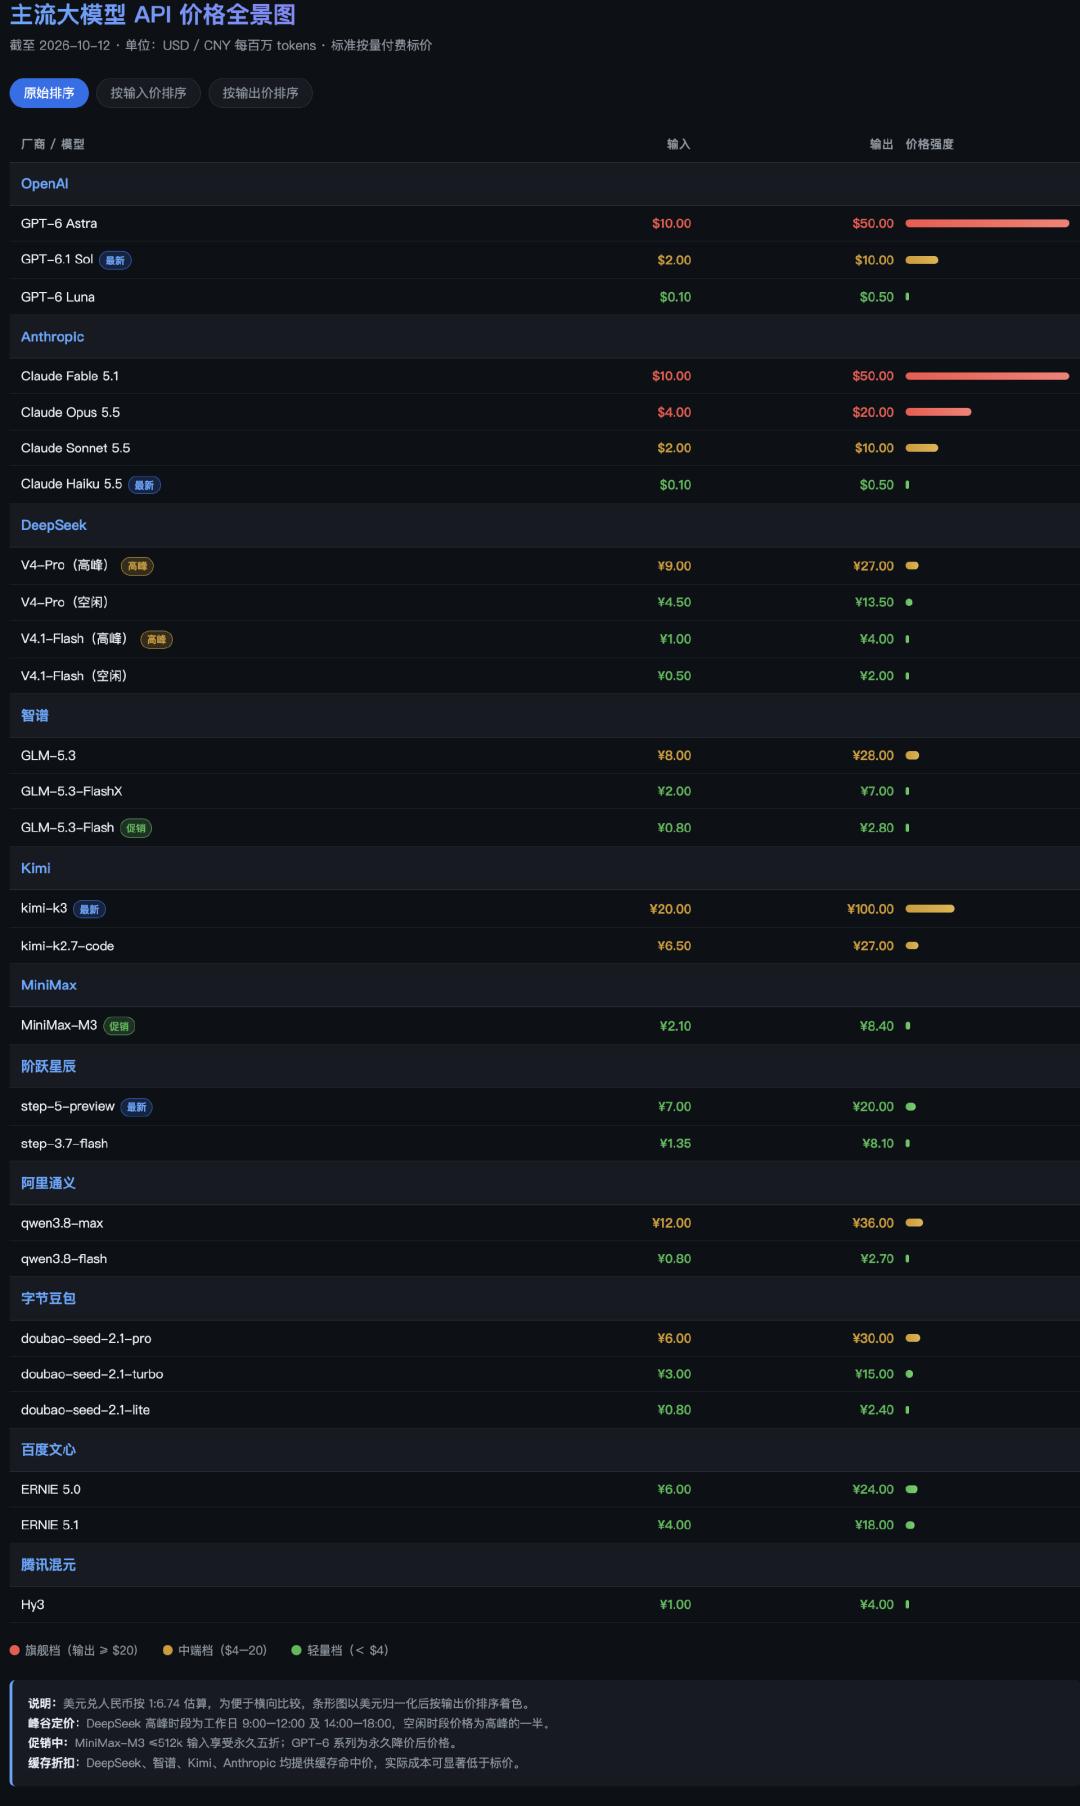
API-Preise der neuesten Modelle verschiedener Hersteller (erstellt von Tech Planet auf Basis öffentlicher Informationen).
In der Praxis ist der Preisvorteil chinesischer Modelle jedoch möglicherweise nicht so stabil wie es auf den ersten Blick scheint. Das Problem liegt in den unterschiedlichen Abrechnungsweisen der Hersteller und der tatsächlichen Produktivität, die man für den gleichen Geldbetrag erhalten kann.
Mit dem explosionsartigen Anstieg der Nachfrage nach KI-Anwendungen konkurrieren Hersteller im In- und Ausland wie OpenAI, Anthropic, Zhipu und Moonshot mit Abonnementpaketen um Nutzergruppen mit hoher Nutzung. In China haben sogar einige Unternehmen für große KI-Modelle Token-Abonnementpakete auf E-Commerce-Plattformen angeboten: Zhipu hat offizielle Flagship-Stores auf Tmall und JD.com eröffnet, während Kimi, MiniMax und StepFun ebenfalls mit Tmall in Verhandlungen stehen.
Nutzer zahlen eine feste monatliche Gebühr und können innerhalb eines bestimmten Guthabens Programmierwerkzeuge und Modelle nutzen. Wenn das Guthaben aufgebraucht ist, können sie auf das Zurücksetzen warten, zusätzliches Guthaben kaufen oder zur API-Zahlung wechseln. Dadurch verlagert sich das Wettbewerbsfeld der Modelle von der Frage „Wie viel kostet eine Million Token?“ hin zu der Frage, wie viel Nutzungsguthaben das Paket bietet, ob die tatsächlichen Aufrufe stabil sind und ob Aufgaben effizient erledigt werden können.
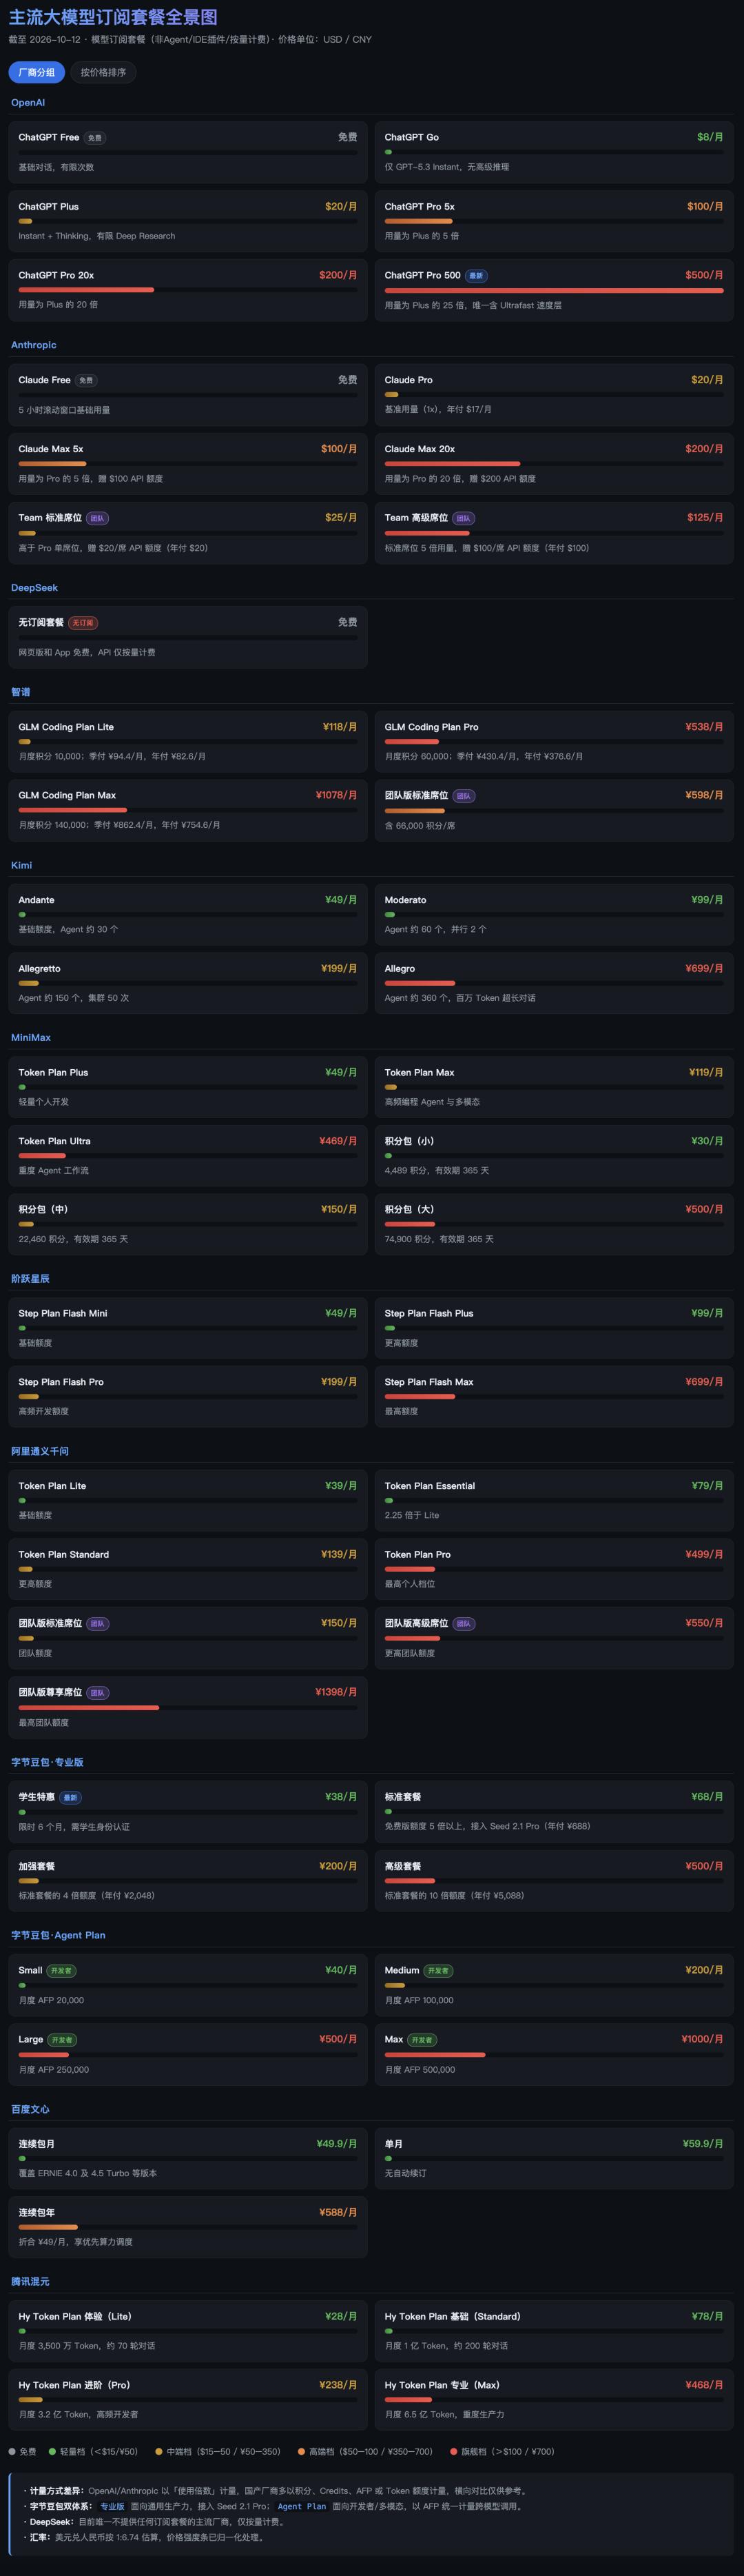
Preise der kostenpflichtigen Abonnementpakete verschiedener Hersteller (erstellt von Tech Planet auf Basis öffentlicher Informationen).
Kürzlich hat SemiAnalysis die Abonnementpakete von OpenAI, Anthropic, Meta, SpaceXAI, MiniMax, Moonshot, Zhipu, Cursor und Cognition nacheinander getestet. Zuerst wurde gemessen, wie viel Abonnementguthaben für Eingabe, Cache-Schreiben, Cache-Lesen und Ausgabe verbraucht wird. Anschließend wurde nach der eigenen Agent-Nutzungsstruktur vom September berechnet, bei der etwa 96,6 % auf Cache-Lesen entfielen. Schließlich wurden die offiziellen API-Preise der einzelnen Hersteller angewendet, um zu ermitteln, wie viel Geld die gleiche Menge an Token kosten würde, wenn sie direkt über die API verarbeitet würden.
Die Ergebnisse zeigen, dass die Subventionsstärke von Claudes Abonnement weit über der chinesischer Modelle liegt. Mit dem 200 US-Dollar teuren Max 20x-Monatspaket kann man mit Sonnet 5.5 einen API-Verbrauch von etwa 12529 US-Dollar erzielen, was dem 62,6-fachen der Monatsgebühr entspricht; bei Opus 5.5 liegt der Wert bei etwa 11726 US-Dollar, was dem 58,6-fachen entspricht.
Obwohl die Monatsgebühr des chinesischen Coding Plans niedriger ist, ist die Subventionsstärke nach der Berechnung nicht sehr hoch. Das 132 US-Dollar teure MiniMax Token Ultra entspricht einem MiniMax-M3-API-Verbrauch von etwa 3088 US-Dollar, was dem 23,4-fachen der Monatsgebühr entspricht; das 168 US-Dollar teure Zhipu GLM Coding Max entspricht etwa dem 11,6-fachen; das 199 US-Dollar teure Kimi Code Ultra entspricht etwa dem 6,7-fachen. Selbst bei dem höchsten Wert von MiniMax beträgt der Gegenwert pro US-Dollar nur etwa 40 % von dem von Claude Sonnet und Opus.
Das Feedback der Endnutzer ist noch intuitiver. „Chinesische Modelle sind für echte Arbeitsaufgaben zu teuer“, klagen viele Nutzer, die große KI-Modelle intensiv nutzen, nach der Berechnung ihrer Ausgaben.
Ein Entwickler, der chinesische Modelle unterstützen möchte, teilte seine Nutzungserfahrung mit Tech Planet. Zuvor nutzte er hauptsächlich Opus 5 für tägliche Codierungsaufgaben, später abonnierte er das Kimi Pro-Paket mit einer Monatsgebühr von 199 Yuan und versuchte, einen Teil seiner Arbeitsaufgaben auf chinesische Modelle zu übertragen. Als Ergebnis verbrauchte eine etwa 6-stündige Codierungsaufgabe 30 % des monatlichen Guthabens. Er besitzt noch ein altes Zhipu GLM-5-Paket mit einer Monatsgebühr von über 400 Yuan: Selbst wenn einzelne Aufgaben nicht parallel ausgeführt werden, ist das Guthaben oft in weniger als 2 Stunden aufgebraucht, sodass es derzeit nur für einige Testaufgaben verwendet werden kann.
Ein anderer Entwickler, der Kimi K3 aufgeladen hat, teilte Tech Planet mit, dass selbst bei relativ einfachen Aufgaben der Token-Verbrauch ungewöhnlich hoch ist. „Ich habe den Kundendienst kontaktiert, um die Rückerstattung des Restguthabens zu beantragen, und nach der Rückerstattung wurde mein Konto gesperrt.“
Diese Situationen spiegeln ein neues Problem im Wettbewerb um das Preis-Leistungs-Verhältnis von Modellen wider: Ein niedriger Token-Einheitspreis bedeutet nicht unbedingt niedrige Kosten pro Aufgabe. Die Vorteile, die chinesische Modelle in der Vergangenheit durch niedrige Token-Einheitspreise aufgebaut haben, stehen nun vor neuen Herausforderungen. Natürlich bedeutet dies nicht, dass chinesische Modelle in allen Szenarien ihre Kostenvorteile verloren haben. Für Nutzer mit geringer Aufruffrequenz, Batch-Schlussfolgerungen, eigenständigen Bereitstellungsanforderungen oder der Notwendigkeit, eigene Geschäftssysteme über API zu verbinden, können chinesische Modelle immer noch Vorteile durch niedrigere Aufrufpreise und flexible Bereitstellungsmöglichkeiten erzielen.
Was wirklich neu berechnet werden muss, sind die Gesamtkosten in verschiedenen Nutzungsszenarien.
Wie kann man im zweiten Halbzeit des Preiskampfs gewinnen?
Wenn API-Einheitspreise, Abonnementpakete und die tatsächlichen Kosten pro Aufgabe gemeinsam auf den Tisch gelegt werden, wandelt sich der Preiswettbewerb zwischen Herstellern großer KI-Modelle von dem bloßen Wettbewerb um niedrigere Preise hin zu der Frage, wie das Budget der Nutzer in verschiedenen Szenarien gedeckt werden kann.
Derzeit konkurrieren Hersteller großer KI-Modelle gleichzeitig um drei Marktsegmente: das Abonnementmarkt für Privatanwender, der API-Markt für Entwickler und der Markt für exklusive Dienstleistungen für Unternehmenskunden.
Die Zahlungslogik der drei Gruppen ist unterschiedlich. Privatanwender interessieren sich mehr dafür, wie viel sie monatlich ausgeben, welche Modelle sie nutzen können und ob es Beschränkungen für das Aufrufguthaben gibt; Entwickler legen mehr Wert auf die Kosten pro Aufruf, Parallelität, Latenz und Stabilität; Unternehmen müssen zudem Aspekte wie Datensicherheit, Servicelevel, Bereitstellungsart und Einkaufsrabatte berücksichtigen.
Verschiedene Märkte bieten Herstellern unterschiedliche Mittel für den Preiswettbewerb. Für Privatanwender können die Nutzungshürden durch kostenlose Stufen, Abonnementpakete und Funktionsvorteile gesenkt werden. Für Entwickler können die Aufrufkosten durch Modelle mit niedrigen Preisen, Cache-Rabatte und Batch-Verarbeitung gesenkt werden. Für Unternehmen müssen durch Mengenrabatte, exklusiven Durchsatz, individuelle Bereitstellung und Vertragspreise die Anforderungen an skalierbare und stabile Geschäftsabläufe erfüllt werden.
Noch wichtiger ist, dass das Preis-Leistungs-Verhältnis eines Modells kein fester Wert ist, der vom Nutzungsszenario getrennt werden kann. Bei demselben Modell können Leistung, Verbrauch und Nutzerbewertung in verschiedenen Aufgaben völlig unterschiedlich sein.
Beispielsweise hat Kimi durch seine Fähigkeiten bei geisteswissenschaftlichen Aufgaben eine Gruppe treuer Nutzer angezogen. Ein Nutzer äußerte sich: „Bei Kimi K3 schmerzt das Herz, wenn das Guthaben bei Textarbeiten verbraucht wird, aber das Ergebnis ist wirklich erstaunlich.“ Ein anderer Nutzer gab offen zu, dass er zwar weiß, dass Kimi teuer ist, aber trotzdem bereit ist, für die Wirkung zu zahlen: „Deshalb bin ich von 49 Yuan über 99 Yuan bis jetzt 199 Yuan immer dabei geblieben.“
Für Modellanbieter sind darüber hinaus die Optimierung der Schlussfolgerungseffizienz, die Verbesserung des Werkzeugaufrufs und die Reduzierung ungültiger Ausgaben ebenso wichtig wie direkte Preissenkungen. Wenn ein Modell dieselbe Aufgabe mit weniger Schlussfolgerungsschritten, weniger Kontext und weniger Wiederholungen erledigen kann, kann die Gesamtkosten auch dann wettbewerbsfähiger sein, wenn der Einheitspreis nicht der niedrigste ist.
Die erste Veränderung, die DeepSeek herbeigeführt hat, bestand darin,