Eine von „Hummer“ veränderte Großwette: Ist Metas zweiter Kampf um die Wende gescheitert?
Am frühen Morgen des 13. Oktober hat Meta, das gerade mit seiner beliebten persönlichen KI-Agent-Anwendung Muse zurück an den KI-Spieltisch gekommen ist, die neue Generation der Flaggschiff-Modellreihe Muse Wonder veröffentlicht, die aus zwei Varianten Muse Wonder und Muse Wonder Full besteht, und damit erneut OpenAI und Anthropic herausgefordert. Derzeit ist nur Wonder Full für zahlende Nutzer zugänglich, aber angeblich wird die neue Modellreihe bald die Erlebnisse in Muse unterstützen.
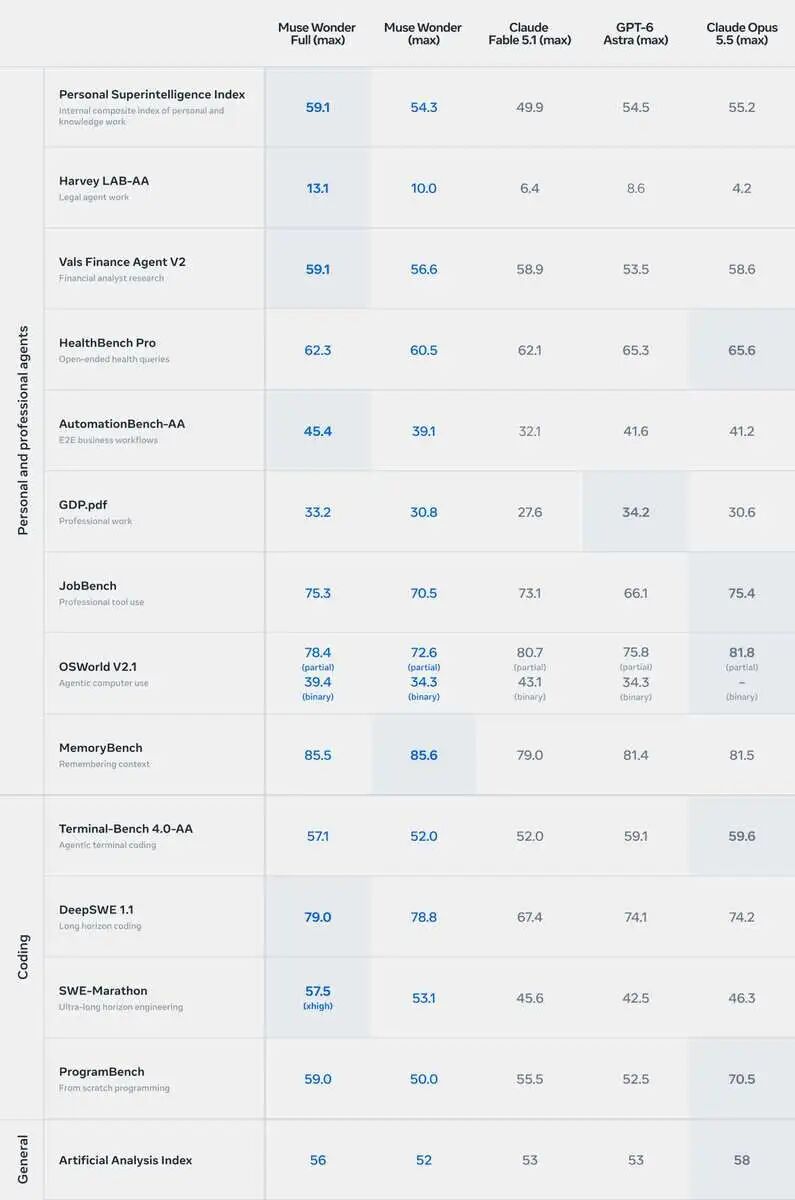
Meta-CEO Mark Zuckerberg schrieb in seinem Threads-Blog: „Muse Wonder ist ein wichtiger Schritt nach vorne, um persönliche Superintelligenz für jedermann verfügbar zu machen.“ Im persönlichen Superintelligenz-Index von Meta erzielte Wonder Full 59,1 Punkte, Claude Opus 5.5 55,2 Punkte, GPT-6 Astra 54,5 Punkte und Claude Fable 5.1 49,9 Punkte.
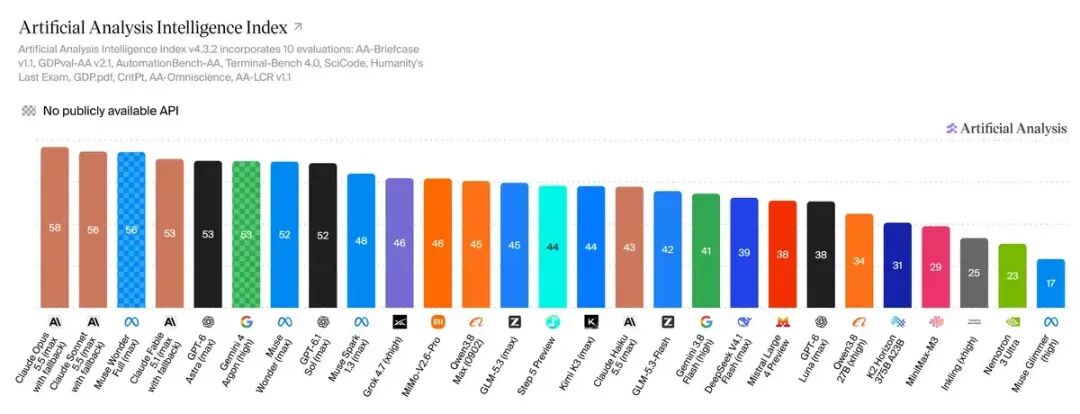
In der Rangliste des umfassenden Intelligenzindex des Drittprüfinstituts Artificial Analysis (diese Rangfolge basiert auf dem gewichteten Durchschnitt von 10 Bewertungen, die KI-Agenten, Programmierung, Allgemeinwissen und wissenschaftliches Schlussfolgern abdecken) steht Opus 5.5 weiterhin auf dem ersten Platz. Wonder Full liegt mit dem günstigeren Claude Sonnet 5.5 von Anthropic gleichauf mit 56 Punkten, nur 2 Punkte weniger als die 58 Punkte von Opus 5.5.
Eine Wette, die von „Hummer“ verändert wurde
Nach der Veröffentlichung des Modells sagte Zuckerberg in einem Interview mit der Financial Times, dass KI bereits fortgeschrittene Mathematik beherrscht, aber noch nicht in der Lage ist, für alle stabil einen guten Kundenservice zu bieten. Der Leiter von Meta AI, Alexandr Wang, beschrieb in dem Interview weiter die ideale Form des persönlichen Agenten: Die Nutzer sollten das Gefühl haben, dass ein ganzes Team von Experten um sie herum ist, einschließlich Helfern aus den Bereichen Recht, Finanzen und Gesundheit.
Diese Vision ist nicht aus der Luft gegriffen. Einen Tag vor der Veröffentlichung von Muse Wonder enthüllte Wang in dem Podcast von David Senra detailliert die Geschichte hinter Muse. Er erwähnte, dass Muse ursprünglich von ihm und Nat Friedman, einer weiteren Schlüsselfigur von Meta Superintelligence Labs, beim „Spielen mit OpenClaw (Hummer)“ entstanden ist.
Laut Wangs Erinnerung ließ Friedman zunächst OpenClaw auf die Überwachungskameras zu Hause zugreifen, um zu überwachen, ob er rechtzeitig Wasser trinkt; anschließend teilte er einen Satz von psychologischen Analyse-Prompts an Wang weiter, damit der Agent anhand persönlicher Informationen wie E-Mails und Fotos mehrere Runden lang kontinuierliche psychologische Analysen durchführt. Nach dem Ausprobieren war Wang zutiefst beeindruckt und beschrieb es so: „Ich hatte das Gefühl, in einer einzigen KI-Erfahrung eine psychologische Beratung erlebt zu haben, die drei Jahren entspricht.“ Daraus erkannten die beiden, dass der persönliche Agent möglicherweise genau die Produktform ist, nach der Meta schon lange sucht.
In dem Blogbeitrag zur Vorstellung von Muse Wonder betonte Meta, dass das Design dieses Modells sowohl den Arbeitsablauf des Agenten als auch die Nutzersicherheit berücksichtigt. Es wird berichtet, dass Muse Wonder über Active Focus (aktive Konzentration) und Active Memory (aktives Gedächtnis) verfügt. Meta erklärte, dass diese beiden Fähigkeiten entscheidend dafür sind, dass der KI-Agent bei komplexen, lang andauernden Aufgaben konzentriert bleibt.
Das Unternehmen definierte Active Focus als „die Fähigkeit, auch bei schwierig werdenden Aufgaben weiter auf das Ziel hinzuarbeiten, andere Methoden auszuprobieren, sich von Fehlern zu erholen und bis zum Ende durchzuhalten, bei Bedarf um Klarstellung zu bitten und vor der Ausführung wichtiger Dinge zunächst eine Bestätigung einzuholen“. Es beschrieb Active Memory als „die Fähigkeit, Inhalte, die für dich wichtig sind, über Gespräche hinweg zu behalten und Details abzurufen, die für die aktuelle Aufgabe relevant sind“.
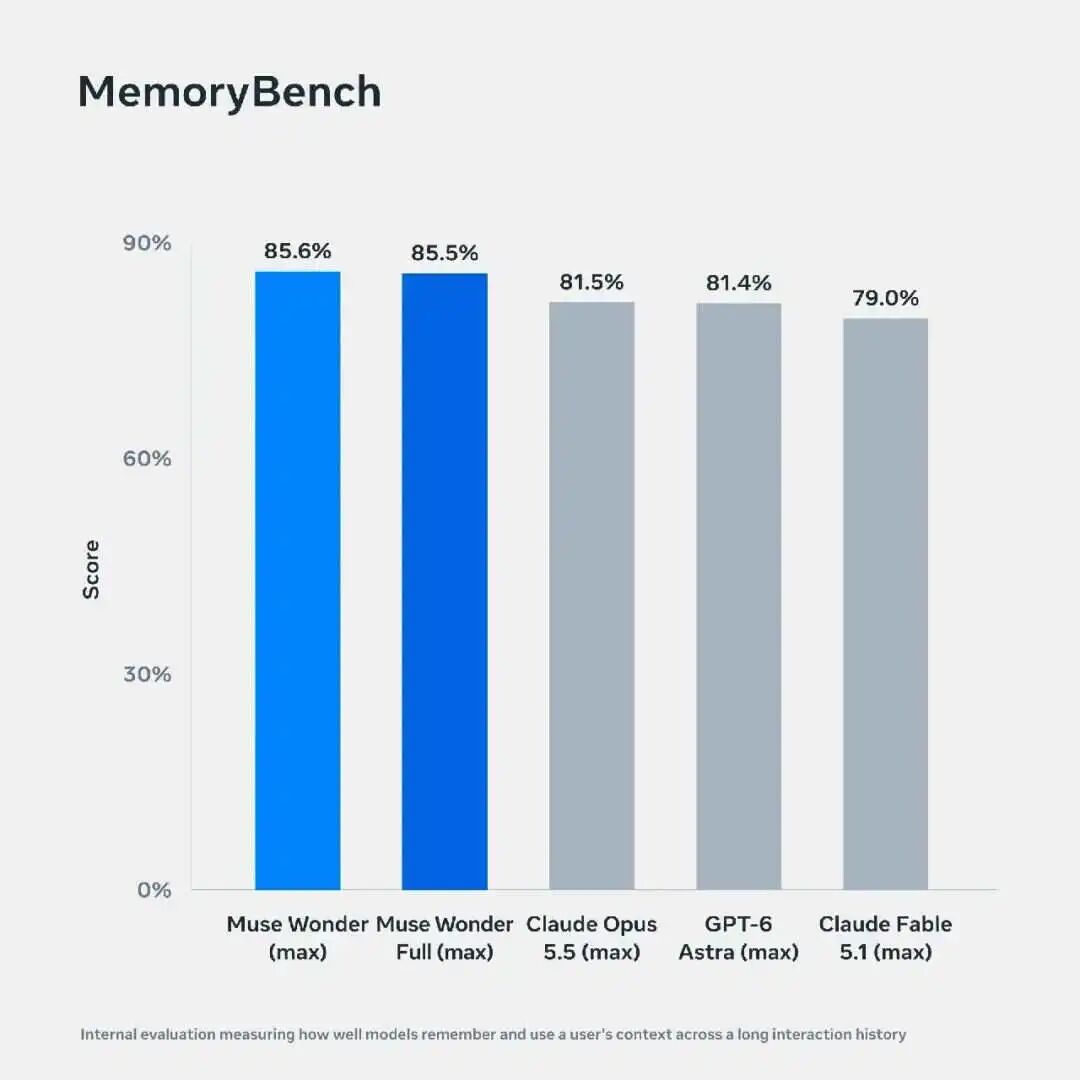
Im MemoryBench-Test erzielte Muse Wonder 85,6 Punkte, was höher ist als die von Meta berichteten Werte von GPT-6 Astra (81,4 Punkte) und Claude Opus 5.5 (81,5 Punkte).
Im Hinblick auf die Sicherheit erklärte Meta, dass das Muse-Wonder-Modell „verhindert, ohne Genehmigung private Informationen weiterzugeben“. Darüber hinaus behauptet Meta, dass diese Modelle auch schädliche Anfragen ablehnen und gleichzeitig Organisationen und Nutzern bei der Cybersicherheitsverteidigung helfen.
Citrini kam nach dem Ausprobieren von Muse Wonder zu dem Schluss, dass Meta tatsächlich die Chance hat, kleinen Unternehmen qualitativ hochwertige Agentendienste anzubieten: Es leistet sowohl bei den Funktionen als auch bei der Ausführungseffizienz hervorragende Arbeit und zeigt auch bei der Bearbeitung finanzbezogener Aufgaben sehr gute Leistungen.
Darüber hinaus schnitt Wonder Full auch auf dem hart umkämpften Gebiet der lang andauernden Programmierung hervorragend ab. Im von Meta veröffentlichten SWE-Marathon-Test erzielte Wonder Full einen Wert von 57,5 %, was deutlich höher ist als die 46,3 % von Claude Opus 5.5 und die 42,5 % von GPT-6 Astra. Im Terminal-Bench 4.0 verbesserte sich das Ergebnis von 33 % bei Muse Spark 1.3 auf etwa 57 %.
Der Programmierung-Agent-Index von Artificial Analysis bestätigte ebenfalls diesen Fortschritt: Muse Code in Kombination mit Wonder Full erzielte 68 Punkte, was dem Wert von Claude Code in Kombination mit Sonnet 5.5 entspricht.
Dieser Kampf zur Rückeroberung der Position hat gerade erst begonnen
Meta hat sehr hohe Erwartungen an Muse Wonder.
Zuckerberg setzte auf der sozialen Plattform X einen hohen Maßstab: „Meta Superintelligence Labs existiert seit mehr als einem Jahr. Muse Spark war eine der ersten Modellreihen, die wir veröffentlicht haben. Und jetzt ist Muse Wonder eine größere, leistungsfähigere Modellreihe, die uns an die Spitze der Technologie führt.“
Kurz nachdem die beeindruckenden Ergebnisse auf den Ranglisten veröffentlicht wurden, geriet Muse Wonder jedoch in der Community in einen Strudel der öffentlichen Meinung.
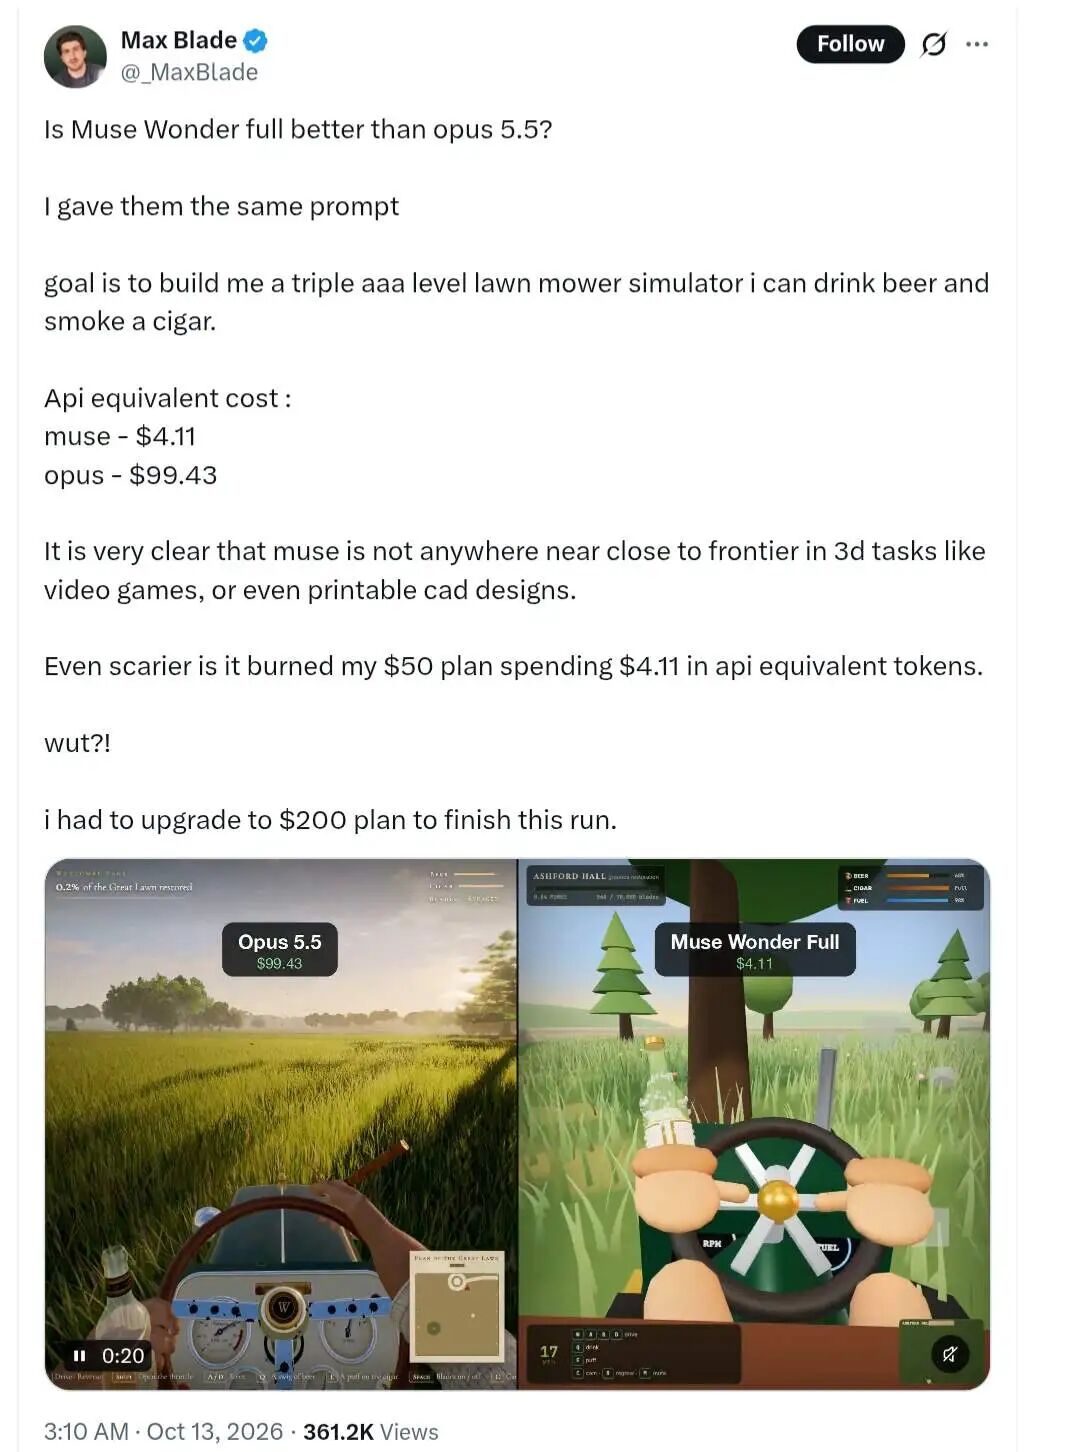
Viele Entwickler stürzten sich begeistert darauf, Muse Wonder Full auszuprobieren, und wurden dann schwer enttäuscht. Ein Nutzer stellte Wonder Full und Opus 5.5 dieselbe Aufgabe: ein 3A-Simulationsspiel zu entwickeln, bei dem man Rasenmäher fahren und gleichzeitig Bier trinken und Zigarren rauchen kann. Er lud ein Vergleichsvideo der beiden Ergebnisse hoch, wobei das Ergebnis von Wonder Full etwas schlechter ausfiel.
Ein anderer Nutzer baute mit Wonder Full eine Raketen-Szene, die 14,3 US-Dollar kostete, aber das Ergebnis sah sehr durchschnittlich aus – es war sogar schlechter als das Werk, das man mit Kimi K3 für 6,9 US-Dollar erstellt hatte.
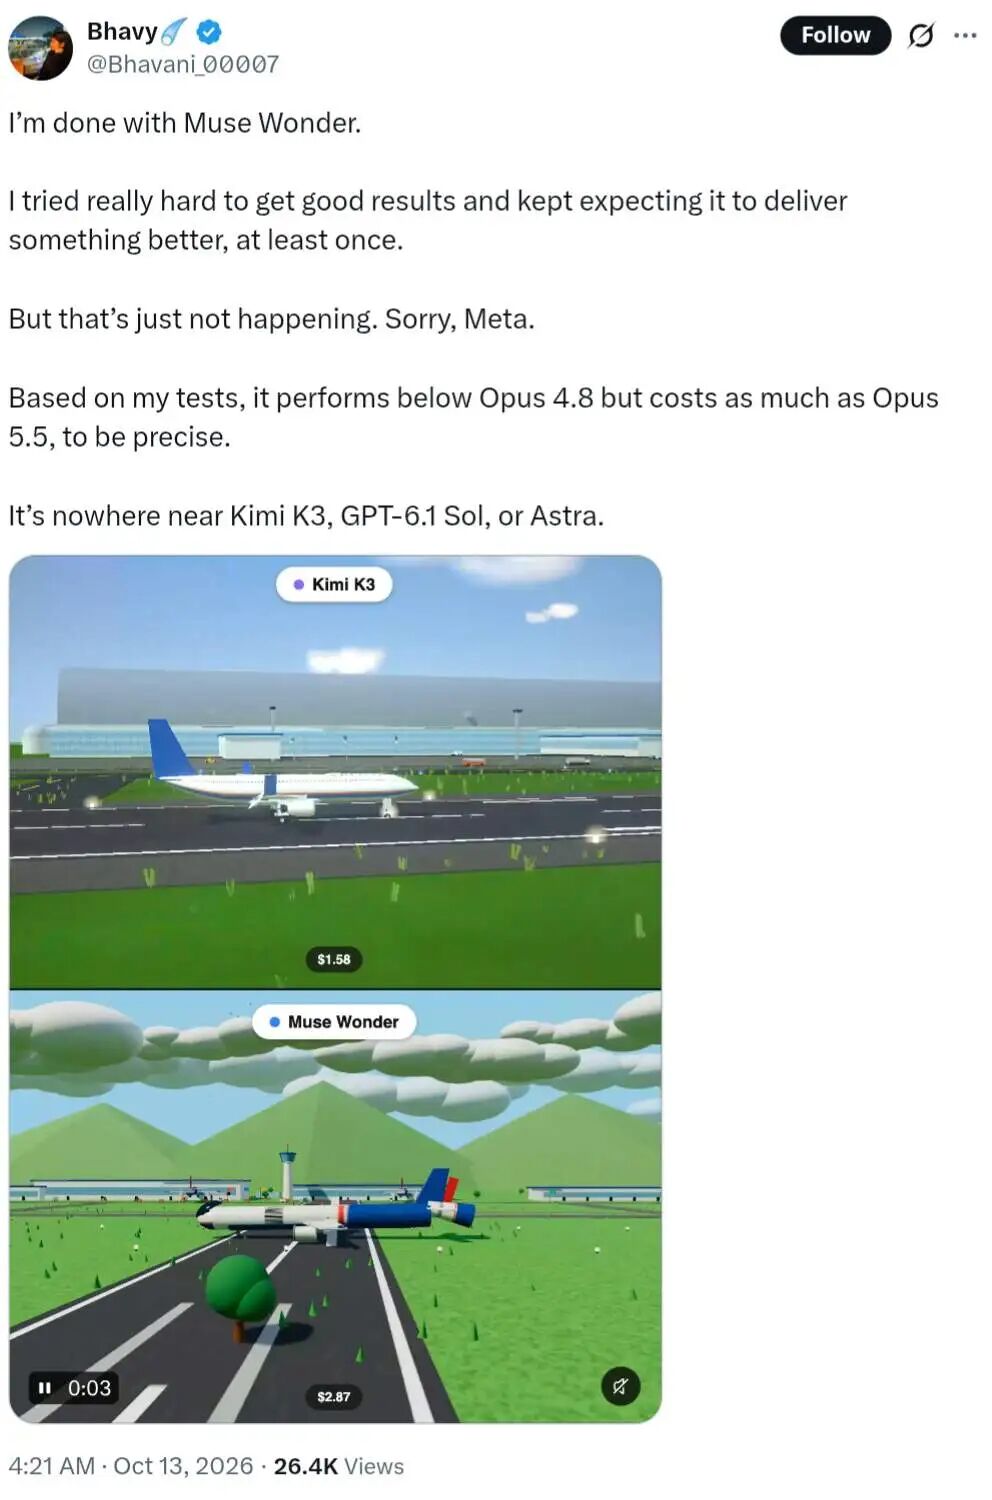
Darauf antwortete Alexandr Wang schnell auf X und gab offen zu, dass das Team das Modell nicht speziell für 3D-Demonstrationsspiele trainiert hat. „Wenn ich jetzt zurückschaue, hätten wir vielleicht mehr solcher Dinge machen sollen.“ Außerdem empfahl er Entwicklern, das neue Modell eher für praktische Programmierarbeiten zu verwenden.
Gleichzeitig gab Wang offen zu, dass die Codierfähigkeit des neuen Modells nicht so gut ist wie die von Opus 5.5, und derzeit werden viele Fehler untersucht.
Wenn der technische Fortschritt die Eintrittskarte für Meta ist, um zurück an den Spieltisch zu kommen, dann zeigt die Umstellung des Geschäftsmodells eine tiefere strategische Absicht. Beide Muse-Wonder-Modelle geben ihre Modellgewichte nicht frei. Die Standardversion von Wonder wird über die Meta Model API und Muse Code angeboten, mit Preisen von 4 US-Dollar pro Million Eingabe-Token, 0,2 US-Dollar für Cache-Eingaben und 20 US-Dollar für Ausgaben. Dieser Preis entspricht dem von Claude Opus 5.5, ist doppelt so hoch wie der Standard-Ein-/Ausgabepreis von GPT-6.1 Sol und 60 % niedriger als der von GPT-6 Astra.
Was die Kosten für bestimmte Aufgaben angeht, so verbraucht Wonder laut Berechnungen von Artificial Analysis bei umfassenden Intelligenzbewertungen durchschnittlich etwa 7,69 Millionen Eingabe-Token und 54.000 Ausgabe-Token pro Aufgabe, was mehrere Runden von Anfragen und Tool-Aufrufen umfasst. Die endgültigen Kosten pro Aufgabe betragen etwa 4,52 US-Dollar, was 183 % höher ist als die 1,60 US-Dollar der Vorgängerversion Muse Spark 1.3 und etwa 39 % höher als die 3,26 US-Dollar von GPT-6 Astra.
Angesichts der hohen Inferenzkosten sagte Zuckerberg in dem Interview ausdrücklich, dass das Wonder-Modell größer ist und die Kosten für Inferenzdienste höher sind, weshalb es derzeit vorrangig zahlenden Nutzern angeboten wird, während der kostenlose Dienst weiterhin hauptsächlich Spark verwendet. Er hofft, in Zukunft die Fähigkeiten auf Wonder-Niveau in eine leichte Form wie Spark zu komprimieren, um Hunderten von Millionen Verbrauchern Dienstleistungen anzubieten.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Xinyan Caijing“ (ID: tech621), Autor: Hua Wei, veröffentlicht mit Genehmigung von 36Kr.