Der Krieg um die KI-Zugangspforten 2.0: Tencent, Alibaba, ByteDance – wer ist der heimliche Champion im KI-Büro-Segment?
Im vergangenen Jahr stammte das sicherste Geld in der KI-Branche aus dem Schreiben von Code, und Programmierer wurden die ersten Angestellten, die bereitwillig Geld für KI ausgaben.
Aber die Durchdringungsrate in den zentralen Codierungsszenarien liegt bereits bei etwa 70 %, und der Markt beginnt, sich nach dem nächsten Szenario umzusehen. Neben Programmierern gibt es weltweit etwa 1 Milliarde Wissensarbeiter.
Also kann KI-Büroarbeit (manche nennen es auch Co-Work oder Arbeits-Agent) den Staffelstab des Codierens übernehmen und zum nächsten Szenario werden, bei dem die Durchdringungsrate stark steigt und das Geschäftsmodell wirklich funktioniert?
In diesem Artikel diskutiert Hai Tun hauptsächlich über KI-Büroarbeit und analysiert sie anhand von vier Punkten:
1. Warum verschiebt sich der Eingang von der Chatbox zum Agenten?
2. Womit funktioniert der Agent? Kann die Technologie eine Barriere bilden?
3. Wer wird zuerst praktisch einsatzbereit: Persönlicher Agent oder Arbeits-Agent?
4. Wie beurteilt man die Gewinnchancen der Hauptakteure am Beispiel des chinesischen Marktes?
Im Folgenden die detaillierte Analyse
I. Der Wandel des KI-Eingangs: Von „mit dir chatten“ zu „für dich arbeiten“
Der Wettbewerb um KI-Eingänge begleitet die Entwicklung der zugrundeliegenden KI-Technologie ständig. Da die Kosten für Rechenleistung aber nicht so sind wie im traditionellen Internetzeitalter, wo die Servicekosten für zusätzliche Nutzer fast null betrugen, funktioniert die „reine Traffic-Strategie“ der Internet-Giganten – zuerst Subventionen, dann Gewöhnung der Nutzer und schlussendliche Monetarisierung – zumindest derzeit nicht mehr.
Im Gegenteil, unter Kostendruck beginnen Plattformgiganten mit Vorteilen bei Technologie, Ökosystem und Traffic, wirtschaftliche Rechnungen aufzumachen. Die niedrige Zahlungsrate im C-Bereich, die dem Niveau von „Wissensbezahlung“ entspricht, und die tägliche Nutzungsdauer, die zu kurz ist, um genügend Werbeinventar freizusetzen, machen den Weg zur Kommerzialisierung der ersten verbreiteten KI-Chatbots extrem schwierig.
Im Vergleich dazu wurde die Zahlungsbereitschaft im Unternehmensbereich geweckt, nachdem der auf Aufgabenerfüllung ausgerichtete Agent aufgetaucht ist, insbesondere bei Technologieunternehmen und IT-Fachkräften. Stichprobenerhebungen von Stack Overflow im April und Oktober 2026 zeigen, dass die Nutzungsrate von Agenten 59 % erreicht und der Anteil der täglichen Nutzer auf 37 % gestiegen ist. 66 % der Entwickler, die KI-Tools verwenden, nutzen Codierungs-Agenten, von denen 73 % sie täglich einsetzen.
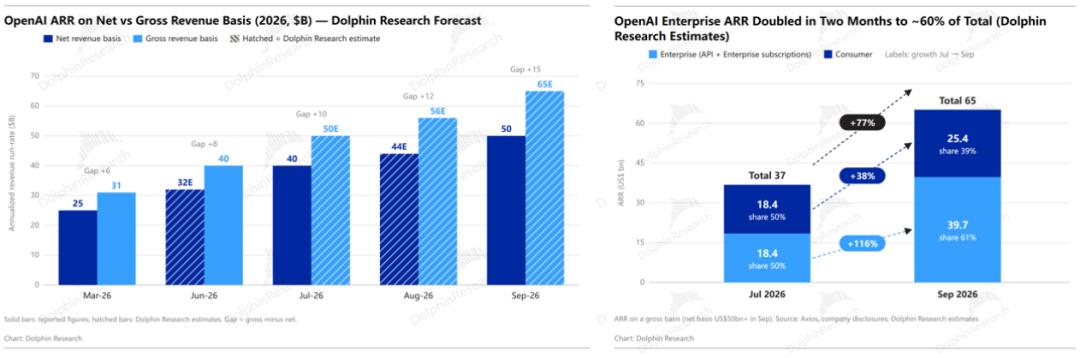
Im Juli dieses Jahres hat das Zahlungsvolumen von OpenAI im B-Bereich (API, Enterprise-Abonnements) das des C-Bereichs überschritten (im April betrug der Anteil noch 40 %) mit einer annualisierten Summe von über 20 Milliarden US-Dollar. Bis Ende September verdoppelte sich das Wachstum. Bei einem gesamten ARR-Umfang von 65 Milliarden US-Dollar (brutto, netto über 50 Milliarden US-Dollar) liegt der Anteil der Einnahmen aus dem B-Bereich bei über 60 %.
Gleichzeitig liegt der ARR-Umfang im C-Bereich nach Rückrechnung Ende September bei etwa 25 Milliarden US-Dollar, was gegenüber Juli um weniger als 40 % gestiegen ist.
Bei der Werbevermarktung ging OpenAI Anfang des Jahres voller Zuversicht auf den Markt, stellte neue Mitarbeiter ein und arbeitete gleichzeitig mit mehreren Drittanbieter-Ökosystemen zusammen.
Aber da die Konversionsrate weiterhin schlecht blieb, sank der CPM-Preis immer wieder: von 60 US-Dollar pro 1000 Impressionen während der Grautestphase auf 15 bis 25 US-Dollar, was dem Preis etablierter digitaler Werbeplattformen entspricht. Gleichzeitig wurde die Mindestausgabenschwelle für die Selbstbedienungs-Werbeplattform von 50.000 US-Dollar direkt auf Null gesenkt.
Der jüngste Fortschritt ist, dass der ARR Ende August 1 Milliarde US-Dollar beträgt – ein Ergebnis, das bereits zehntausende Werbetreibende und mehr als 40 Länder und Regionen abdeckt.
Warum ist die Zahlungsvermarktung von Chatbots so schwierig?
Hai Tun ist der Meinung, dass das Problem nicht darin liegt, dass KI nutzlos ist, sondern dass die Interaktionsform des Chatbots Nutzer von Natur aus daran hindert, die Kosten klar zu berechnen und den Wert der KI zu erkennen. Genauer gesagt umfasst der Wert der KI zwei Aspekte: einerseits die nachprüfbare Effektivität, andererseits der messbare Nutzen in Form von Umsatzwachstum oder Kostenoptimierung.
Aber Chatbots liefern „Vorschläge“ statt „Ergebnisse“. Wie viel Zeit oder Geld sie einsparen, lässt sich in den meisten Szenarien nicht berechnen (Wert kann nicht quantifiziert werden). Daher kann die Qualität des Ergebnisses nur „gefühlt“ werden (keine Selbstprüfung möglich), und Nutzer müssen den gesamten Prozess noch einmal durchgehen, um die Wirkung zu bestätigen.
Wenn die Prüfkosten steigen, lässt sich das Vertrauen der Nutzer in die KI nicht stabil aufbauen, sodass die Nutzungsszenarien immer mehr auf oberflächliche Fragen und Antworten beschränkt bleiben. Die daraus entstehenden rückmeldungsfreien, einfachen und grundlegenden Nutzerdaten tragen kaum zum nachträglichen Training und zur Iteration des großen Modells bei. Die Plattform muss zusätzlich hochwertige Daten und Prüfumgebungen erwerben oder kennzeichnen. Um das Modell zu verbessern, müssen noch höhere Kosten aufgewendet werden, um hochwertige Inhalte aus den täglichen Frage-Antwort-Daten der Nutzer herauszufiltern.
Gleichzeitig führt eine geringere Vertrauensstellung und die Beschränkung auf einfache Aufgaben dazu, dass keine wertvollen Datenvermögen angesammelt werden können. Das führt auch dazu, dass die Wechselkosten für Nutzer sehr niedrig sind: Sobald es einen Chatbot mit besserem Preis-Leistungs-Verhältnis gibt, können sie nahtlos wechseln. Daher können Chatbots zwar die „Nutzerzahl“ auf das Maximum steigern, aber es ist schwierig, gleichzeitig die „Zahlungsrate“ zu erhöhen, die für hohe Nutzerbindung und Loyalität steht.
Warum konnte das Codieren als erstes erfolgreich werden?
Im Gegensatz zur Inhaltsausgabe in der Chatbox zielt der Agent darauf ab, Aufgaben zu erledigen, was den allgemeinen Anforderungen von Unternehmen entspricht. In der Wertformel der KI lassen sich zudem beide Schlüsselfaktoren „Nachprüfbarkeit“ und „Messbarkeit“ umsetzen:
Beim Codieren handelt es sich um ein Szenario mit festem Wissensumfang und nachprüfbarer Richtigkeit (die Funktionsfähigkeit kann automatisch überprüft werden). Gleichzeitig lässt sich der daraus entstehende Mehrwert gut messen: Er entspricht direkt den hohen Gehältern von IT-Fachkräften.
Diese Szenarien, die von Nutzern schnell geprüft werden können und bei denen der wirtschaftliche Wert einer einzelnen Aufgabe sehr hoch ist, umfassen neben dem Codieren auch Finanzabgleich, juristische Compliance-Prüfungen, Datenanalysen, Finanzinvestitionen und Vertriebsstrategien.
Ein größerer Markt entsteht durch die Zusammenführung und Erweiterung dieser Szenarien – zu einer einheitlichen Büroplattform hinter den Unternehmen. Sie dringt tief in die Geschäftsprozesse von Unternehmen ein, bietet die Funktionen traditioneller Bürosoftware und hilft Unternehmenskunden gleichzeitig, mehr Geschäftswachstum durch KI zu erzielen, statt nur auf „Kostensenkung bei Mitarbeitern“ zu setzen.
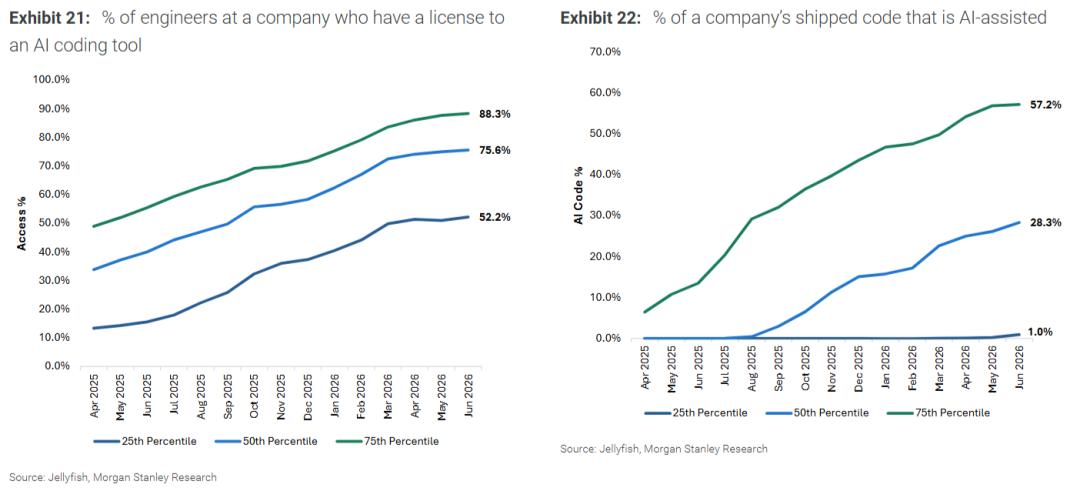
Aber das Szenario der einheitlichen Büroplattform ist keine einfache Kopie des Codierungsszenarios, und sein Entwicklungsweg ist nicht so reibungslos wie beim Codieren (innerhalb eines Jahres stieg die KI-Codierungs-Nutzungsrate bei IT-Mitarbeitern auf über 70 %, und der Anteil des KI-gestützten Codes liegt bei fast 30 %).
Der Schlüssel liegt in drei Einflussfaktoren:
(1) Die Prüfstandards sind vager und komplexer, manche Arbeitsergebnisse lassen sich nicht automatisch prüfen, sondern erfordern eine subjektive Beurteilung der Qualität durch Menschen;
(2) Die Aufgabenkette ist länger, ein Stillstand an jeder kleinen Stelle kann die gesamte Aufgabe blockieren. Zum Beispiel erfordert der Monatsabschluss den gleichzeitigen Zugriff auf Online-Banking, Steuersysteme und unternehmenseigene ERP-Systeme, sodass die Fehlertoleranz bei einzelnen Teilschritten geringer ist;
(3) Aus Gründen der Cybersicherheit wünschen sich Unternehmen mit Sicherheit eine private Bereitstellung. Für diesen Prozess muss die KI-Büroplattform ein FDE-Team beim Unternehmenskunden einsetzen.
Daher ist die Entscheidungskette für die Beschaffung, ob ein Unternehmen auf eine KI-Büroplattform umsteigt oder diese aufrüstet, deutlich länger als bei KI-Codierung, sodass der natürliche Entwicklungsfortschritt nicht so reibungslos wie beim Codieren verläuft.
II. Der Wettbewerb um Agenten: Ist Technologie die zentrale Barriere?
1. Agent = LLM + Harness
Um zu sehen, ob Agenten nachhaltige Vorteile durch technologische Barrieren haben, schauen wir uns zuerst das Funktionsprinzip von Agenten an.
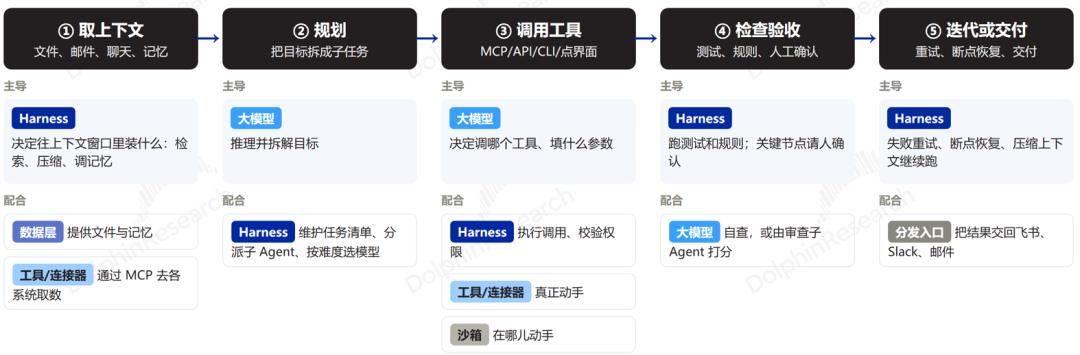
Um eine Aufgabe zu erledigen, umfasst ein Agent hauptsächlich 5 Schlüsselschritte, von denen jeder verschiedene Ebenen von Softwaretools betrifft. Zwei Kerntechnologien sind die Ebene des großen Modells und die Harness-Ebene. Im Allgemeinen ist das große Modell für die Entscheidungsfindung oder die Formulierung von Anforderungen nach dem Denken verantwortlich; Harness ist für die stabile, sichere Ausführung und Prüfung zuständig.
2. Die echte Barriere liegt in den „Daten“
Aus dem Funktionsprinzip von Agenten geht hervor, dass ein Agent, der Aufgaben stabil ausführen und liefern kann, genaue Urteile des großen Modells und gleichzeitig einen zuverlässigen Harness für die stabile Ausführung benötigt.
Woher stammen also die technologischen Barrieren eines führenden Agenten: vom großen Modell oder von Harness?
(1) Harness ist im Wesentlichen eine technische Hülle
Erstens sind das Designkonzept und der zugrundeliegende Ingenieurcode von Harness sehr ausgereift und allgemein gültig, sie gehören zur Betriebsinfrastruktur – Protokolle, Berechtigungen, Sandbox, Archivierung, Benutzeroberfläche usw.
Zweitens sind die Verbindungsprotokolle MCP, Skills usw. für die externe Anwendungsökosysteme von Harness ebenfalls offene Standards geworden. OpenAI hat Codex Harness direkt Open-Source gestellt, und Dots läuft darauf; das Open-Source-Projekt OpenClaw ist auch die Inspirationsquelle für Microsoft Autopilot und Meta Muse.
Daher bildet Harness selbst keine technologische Barriere, und gleichzeitig übernimmt das Modell die Funktionen von Harness. Viele Fähigkeiten, die ursprünglich durch Harness ergänzt wurden, werden derzeit auch in das Modell trainiert.
a. Die Agentenplanung und -ausführung wird in das große Modell integriert (geeignet für parallele Aufgaben)
Ein typisches Beispiel ist Kimi: Seit K2.5 erstmals Agent Swarm eingeführt hat, sodass das Modell selbst entscheidet, Aufgaben zu zerlegen und Unteragenten zuzuweisen, haben K2.6 und K3 dieses Designkonzept fortgeführt und immer mehr Agentenkooperation direkt in das Modell trainiert, statt die sequenzielle Planung über einen externen Harness durchzuführen.
Derzeit verfolgen die führenden Modellanbieter aber hauptsächlich den Weg, das Planungs- und Ausführungsframework von Agenten an Harness zu übergeben. Das große Modell wird nur so trainiert, dass es das Werkzeug „Aufgaben in Teilaufgaben zerlegen“ gut beherrscht, und bei Bedarf werden über das Unteragenten-Werkzeug von Harness mehrere Unteragenten zur parallelen Ausführung eingesetzt.
b. Kontext, Fehlerkorrektur und Planung werden in das große Modell integriert
Darüber hinaus nähern sich die Kontextfenster aller großen Modelle 1 Million an. Planung und Selbstkorrektur werden zunehmend zu Fähigkeiten des Modells selbst, was die Bedeutung von Harness, das für Kontextverwaltung, Komprimierung und Fehlerprüfung zuständig ist, verringert.
(2) Die Modelle konvergieren, und man muss nicht ständig die modernsten Modelle verwenden
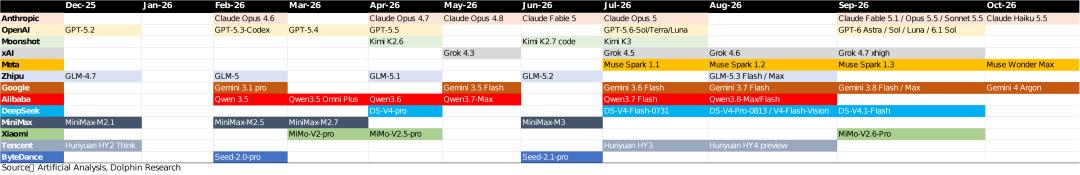
Das große Modell ist die Entscheidungsebene im Hintergrund. Wenn der Unterschied zwischen den zugrundeliegenden „Gehirnen“ zu groß ist, beeinträchtigt dies natürlich das Endnutzererlebnis. Aber derzeit beträgt der Vorsprung der führenden Modelle bei allen Anbietern allgemein 3 bis 6 Monate. Nachdem Open-Source-Großmodelle Mitte des Jahres stark aufgeholt und den Abstand zu den geschlossenen führenden Modellen verkleinert haben, liegen die nordamerikanischen geschlossenen führenden Modelle in den letzten zwei Monaten sehr eng beieinander und haben nacheinander neue Versionen veröffentlicht.
Obwohl geschlossene Modelle durch das Blockieren von Denkketten streng verhindern, dass Konkurrenten sie destillieren, können die Nachzügler die Leistungsverbesserung des großen Modells durch ständige Verbesserung der Trainingsumgebung (Datenrückfluss mit gültiger Feedbackprüfung), also durch mehr nachträgliches Training, erreichen.
Gleichzeitig konvergieren die Unterschiede zwischen den Modellen