Zwischen Liang Wenfeng und Winverse wurde bereits vor langer Zeit eine Brücke aufgebaut.
In öffentlich zugänglichen Quellen hat DeepSeek nur in zwei Unternehmen investiert: Das eine ist das bereits etablierte Unitree, das andere ist das Startup-Unternehmen Winverse AI, über das gerade die Nachricht verbreitet wurde, dass DeepSeek die Führung bei der Investition übernehmen will.
Der Gründer dieses Unternehmens heißt Hu Han. Er war zuvor bei Microsoft Research Asia tätig und arbeitete auch als technischer Leiter des Sprachmodells Hunyuan von Tencent.
Laut ausländischen Medien ist Winverse AI ein Stealth-Startup, also ein Unternehmen, das keine genauen Produktinformationen an die Öffentlichkeit gibt. Als Hu Han Ende Juli von Tencent ausschied, erklärte er jedoch öffentlich, dass sich sein unternehmerisches Vorhaben auf verkörperte Intelligenz und Weltmodelle konzentriere.
Liang Wenfeng hat Investoren persönlich mitgeteilt, dass Weltmodelle nicht wichtig seien. Kaum ein halbes Jahr später hat Liang Wenfeng diese Regel selbst gebrochen.
Warum also hat Liang Wenfeng sich entschieden, zu diesem Zeitpunkt in Winverse AI zu investieren?
Meiner Meinung nach liegt der Grund darin, dass es eine „Brücke“ zwischen Liang Wenfeng und Hu Han gibt.
Wer ist Hu Han?
Der Lebenslauf von Hu Han lässt sich in einem Satz zusammenfassen: Er hat den Weg von „dass Maschinen Bilder verstehen“ bis hin zu „dass Maschinen die reale Welt begreifen“ zurückgelegt.
Er schloss 2008 sein Bachelorstudium an der Tsinghua-Universität ab und erwarb 2014 seinen Doktortitel an derselben Universität. Während seiner Promotionszeit war er als Gastwissenschaftler an der Universität von Pennsylvania tätig und ging nach seinem Abschluss zunächst zum Baidu-Institut für Tiefes Lernen. Im Dezember 2016 trat er Microsoft Research Asia bei, wo er es bis zum Chefforscher und Forschungsmanager brachte.
Während seiner Zeit bei Microsoft Research Asia hat Hu Han die gesamte Entwicklung der Computer Vision von Faltungsnetzwerken bis hin zu Transformern vollständig miterlebt.
Unter seinen veröffentlichten Arbeiten befindet sich das Paper „Relation Networks for Object Detection“ aus dem Jahr 2017, das die Modellierung von „Beziehungen“ in die Objekterkennung einführt. Weiter gibt es die Arbeiten „Deformable ConvNets v2“ und „RepPoints“, die die Erkennungsrahmen im Faltungszeitalter flexibler gestalten.
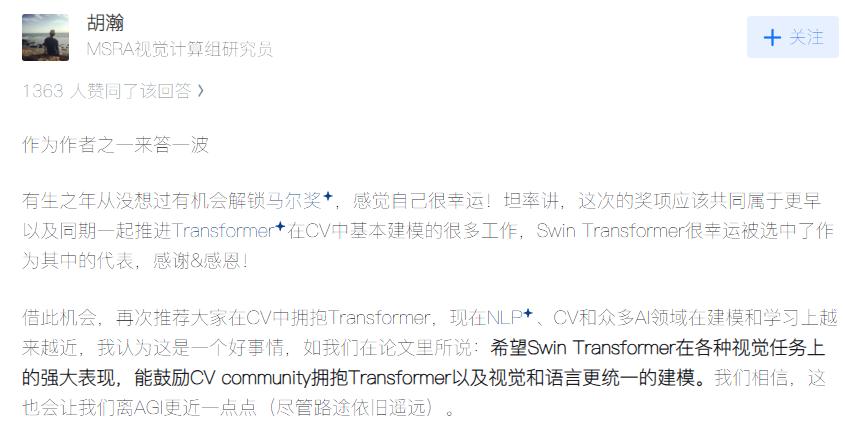
Im Jahr 2021 beteiligte sich Hu Han an der Veröffentlichung des berühmten Papers „Swin Transformer“, das es Transformer, die ursprünglich für Texte entwickelt wurden, ermöglicht, Bilder effizient zu „sehen“.
Obwohl multimodale Modelle heute allgegenwärtig sind, war dies im Jahr 2021 ein sehr bahnbrechender Fortschritt. Daher erhielt dieses Paper den Marr-Preis (den besten Paper-Preis) der ICCV 2021.
Als Hu Han diese Frage auf Zhihu beantwortete, sagte er: „Ich hätte nie im Leben gedacht, dass ich jemals die Chance bekomme, den Marr-Preis zu erhalten“, und betonte, dass der Preis allen Personen gehöre, die früher und zur gleichen Zeit gemeinsam die Einführung von Transformern in den Bereich der visuellen Erkennung vorangetrieben haben.
Nach Swin löste die visuelle Community eine Welle des selbstüberwachten Vortrainings aus, bei der die bisherigen manuellen Annotationen aufgegeben wurden, sodass die Modelle selbst aus riesigen Mengen von Bildern lernen können.
Ende 2021 veröffentlichte das Team von Hu Han das Paper „SimMIM“, das die „Lückentext“-Idee von Googles BERT aufgreift: Ein Teil des Bildes wird verdeckt, und das Modell soll ihn erraten. Die Schlussfolgerung lautet, dass einfachere Designs bessere Ergebnisse liefern.
Darauf folgte „Swin Transformer V2“, das die Vision-Modelle noch größer macht.
Ab diesem Zeitpunkt hat sich die Hauptforschungsrichtung von Hu Han von „Wie man ein besseres visuelles Netzwerk entwirft“ zu „Wie man Modelle skaliert und wie man sie stabil trainiert“ gewandelt.
Und zu dieser Zeit begannen die großen Modelle gerade populär zu werden.
Daher trat Hu Han im Januar 2025 als herausragender Wissenschaftler bei Tencent ein, ersetzte den ausscheidenden Liu Wei und war umfassend für die Forschung und Entwicklung des multimodalen großen Modells Hunyuan verantwortlich. Gleichzeitig war er Tech Lead des großen Modells Hunyuan von Tencent und leitete den Aufbau der grundlegenden Fähigkeiten für das visuelle Verständnis von Hunyuan.
Bei der internen organisatorischen Anpassung von Tencent in der zweiten Jahreshälfte 2025 wechselte er zur Forschungsgruppe für Spitzentechnologie „Frontier“ unter der Abteilung für große Sprachmodelle, war für die Forschung zum multimodalen Verständnis verantwortlich und berichtete direkt an Yao Shunyu. Währenddessen beteiligte er sich an der Voruntersuchung von Weltmodellen.
Im April 2026 veröffentlichte er gemeinsam mit Yao Shunyu das grundlegende Modell für verkörperte VLM namens HY-Embodied-0.5. Im Juli desselben Jahres reichte er seinen Rücktritt ein, um ein eigenes Unternehmen zu gründen. Der Forschungsbereich für visuelle Sprachmodelle wurde von Tian Yonglong, dem ehemaligen Forscher von OpenAI, übernommen.
In den eineinhalb Jahren bei Tencent hat er tatsächlich vier Bereiche abgedeckt: große multimodale Modelle, visuelle Sprachmodelle, Weltmodelle und verkörperte VLM. Die Hauptlinie blieb aber immer das visuelle und multimodale Verständnis.
Obwohl der Lebenslauf von Hu Han wirklich beeindruckend ist, hat Liang Wenfeng angesichts der massiven Erweiterung des Personalbestands bei DeepSeek schon viele beeindruckende Lebensläufe gesehen. Warum hat er ausgerechnet Hu Han ausgewählt?
Eine Brücke zwischen Liang Wenfeng und Hu Han
Um diese Frage zu beantworten, müssen wir zurück zur Autorenliste des oben erwähnten Papers „SimMIM“ gehen.
SimMIM hat insgesamt acht Autoren: Zhenda Xie, Zheng Zhang, Yue Cao, Yutong Lin, Jianmin Bao, Zhuliang Yao, Qi Dai, Han Hu. Der letzte ist Hu Han, der erste ist Xie Zhenda.
In dem Paper befindet sich auch eine Fußnote: Die drei Personen Xie Zhenda, Lin Yutong und Yao Zhuliang waren langjährige Praktikanten bei Microsoft Research Asia.
Das heißt, während seiner Jahre bei Microsoft Research Asia hat Xie Zhenda in der Gruppe von Hu Han geforscht.
Das ist noch nicht alles: Wenn man die gemeinsam von Xie Zhenda und Hu Han verfassten Papiere durchgeht, stellt man fest, dass die beiden schon lange zusammenarbeiten.
Das Paper „PixPro“ aus dem Jahr 2020 mit dem vollständigen Titel „Propagate Yourself“ ist ein Paper zum pixelweisen kontrastiven Lernen. Xie Zhenda ist der Erstautor, Hu Han steht auch in der Autorenliste. Das Paper untersucht, wie man selbstüberwachtes Repräsentationslernen auf Pixelgranularität durchführt.
Bei dem Paper „Swin Transformer V2“ aus dem Jahr 2021 stehen unter den Autoren Ze Liu, Han Hu, Yutong Lin, Zhuliang Yao, Zhenda Xie, Yixuan Wei und andere. Xie Zhenda und Hu Han sind beide wieder dabei.
Bei SimMIM Ende 2021 ist Xie Zhenda der Erstautor, Hu Han der letzte Autor.
Darüber hinaus haben diese drei Papiere eine gemeinsame Linie: Sie drehen sich alle um „selbstüberwachtes Lernen“ und „Skalierung“. Es geht darum, wie visuelle Modelle ohne manuelle Annotationen auskommen und auf größerer Ebene kontinuierlich stärker werden.
Später ging Xie Zhenda zu DeepSeek und wurde Forscher, dessen Forschungsrichtungen AGI sowie Vortraining und Skalierung von Grundmodellen sind.
Auf der Autorenseite von arXiv taucht der Name von Xie Zhenda in einer langen Liste von Arbeiten von DeepSeek auf, darunter DeepSeek-Coder, DeepSeek-V2, DeepSeekMoE, DeepSeek-V3, DeepSeek-R1 und Janus-Pro sowie Einträge zu technischen Berichten im Zusammenhang mit DeepSeek-V4.
Das zeigt, dass Xie Zhenda eng mit dem Aufstieg von DeepSeek in den letzten zwei Jahren verbunden ist.
Am 1. Januar 2026 (mit dem Zeitstempel vom 31. Dezember 2025 auf arXiv) veröffentlichte DeepSeek sein erstes Paper des neuen Jahres „mHC: Manifold-Constrained Hyper-Connections“. Sein Erstautor ist Xie Zhenda.
Zu mHC braucht man nicht viel zu sagen: In der technischen Dokumentation von DeepSeek V4 wird diese Technik als eine der drei großen Architekturinnovationen beschrieben, neben dem gemischten Aufmerksamkeitsmechanismus CSA+HCA und dem Optimierer Muon.
In dem Paper zu mHC gibt es aber noch einen weiteren Autor namens Wei Yixuan. Dieser Name taucht auch in der Autorenliste von Swin V2 auf.
Das bedeutet: Mehr als einer der jungen Leute in der Gruppe von Hu Han bei Microsoft Research Asia ist bereits Kernmitglied von DeepSeek.
Vielleicht hat das damalige Labor von Hu Han neben den Modellen selbst auch die Forschungsintuition und den Geschmack für „Skalierung + stabiles Training“ ausgebildet – genau das, was DeepSeek am meisten schätzt, oder genauer gesagt, was Liang Wenfeng am meisten schätzt.
Die Kernmitglieder von DeepSeek haben einst Seite an Seite mit Hu Han gearbeitet und herausragende Ergebnisse erzielt. Daher sind die Informationskosten praktisch gleich Null.
Duan Yongping hat ein berühmtes Zitat: Investieren bedeutet, in Menschen zu investieren. Liang Wenfeng hat sicherlich schon lange gewusst, wie kompetent Hu Han ist.
Warum investiert Liang Wenfeng, statt es selbst zu machen?
Aber hier gibt es eine Frage: Da DeepSeek selbst über ein starkes Forschungsteam verfügt und seinen Personalbestand auf 500 Personen erweitert hat, warum macht es das nicht selbst, sondern investiert stattdessen?
Nach dem großen Erfolg von DeepSeek-R1 im letzten Frühlingsfest war Liang Wenfeng zeitweise die „zurückhaltendste“ Person in der gesamten KI-Branche. Keine Finanzierung, keine Expansion – aber in diesem Jahr hat sich die Situation geändert.
Laut Berichten ausländischer Medien steht DeepSeek kurz vor dem Abschluss einer neuen Finanzierungsrunde von mindestens 80 Milliarden Yuan, deren Umfang weit über das ursprüngliche Ziel hinausgeht.
Chinesische Medien berufen sich auf informierte Quellen und geben an, dass das ursprüngliche Ziel bei etwa 50 Milliarden Yuan lag, mit einer angestrebten Bewertung von etwa 500 Milliarden Yuan. Die Mittel werden hauptsächlich für das Modelltraining, Rechenzentren und inländische Rechenleistung verwendet.
Weitere ausländische Medien berichten: Diese Summe könnte DeepSeek dazu veranlassen, eine neue Generation von Startups zu fördern und gemeinsam mit ihnen Forschung und Entwicklung zu betreiben.
Liang Wenfeng stimmt den Ideen und dem Niveau von Hu Han zu, und Winverse AI wurde gerade erst gegründet, sodass noch nicht viele Konkurrenten eingestiegen sind. Daher ist Winverse AI praktisch das perfekte Investitionsobjekt.
Im August dieses Jahres ging Unitree Robotics an die Börse. DeepSeek hat sich mit rund 141 Millionen Yuan an der strategischen Platzierung des Börsengangs von Unitree beteiligt, was einem Anteil von etwa 2 % entspricht. Die beiden Seiten werden im Bereich großer KI-Modelle und verkörperter Intelligenz zusammenarbeiten.
Bei der Beschaffung von Modelltrainingsdiensten wird Unitree DeepSeek vorrangig berücksichtigen, und bei der Beschaffung von Robotern wird DeepSeek ebenfalls Unitree vorrangig berücksichtigen.
Durch diesen Schritt hat DeepSeek den „Körper“ für die verkörperte Intelligenz erhalten. Winverse AI könnte hingegen sein „Gehirn“ sein.
Nach Angaben von informierten Personen hat Liang Wenfeng in letzter Zeit intensiv mit Gründern im Bereich der verkörperten Intelligenz ausgetauscht. Innerhalb von DeepSeek werden zwei Wege bewertet: Erstens selbst ein Team aufbauen, zweitens durch Investitionen einsteigen.
Dieser Logik folgend ist die Investition eine sehr „DeepSeek-typische“ Wahl.
Wenn man selbst Roboter baut, braucht man Fähigkeiten in Hardware, Bewegungssteuerung und Erfassung realer Daten – alles Fähigkeiten, die DeepSeek bisher nicht hat. Die Stärke von DeepSeek liegt in Algorithmen, Training und Ingenieureffizienz, nicht in Lieferketten und Hardware-Iterationen.
Die Datenquellen für die verkörperte Intelligenz liegen in der realen Welt, sodass eine große Anzahl von Robotern in realen Szenarien laufen muss. Unitree liefert den Körper, Winverse AI liefert das Modell, DeepSeek liefert Rechenleistung und Grundmodelle – die Arbeitsteilung ist klar wie in einer Fließband.
Am wichtigsten ist: Wenn Hu Han tatsächlich wie in den Enthüllungen berichtet an der grundlegenden Infrastruktur und Modellbeschleunigung arbeitet, bildet er eine komplementäre Beziehung zu DeepSeek.
DeepSeek braucht dringend eine Schnittstelle, über die Sprachmodelle auf die physische Welt zugreifen können.
Laut Berichten von Phoenix New Media könnte der Grund, warum DeepSeek über den Einstieg in die verkörperte Intelligenz nachdenkt, auch der Druck sein, der von GPT-6 ausgeht.
Bei einer Robotersteuerungsaufgabe erreichte GPT-6 Astra eine Erfolgsrate von 95 %, während das Vergleichsmodell nur 40 % erreichte. Branchenkenner sagen zudem, dass OpenAI neben GPT-6 auch separat ein grundlegendes Modell für die verkörperte Intelligenz trainiert.
Personen, die Liang Wenfeng nahestehen, geben an, dass Liang Wenfeng kürzlich erklärt hat, dass DeepSeek im Vergleich zu GPT-6 in einigen Fähigkeiten noch Rückstände hat. Daher will Liang Wenfeng höchstwahrscheinlich im Bereich der verkörperten Intelligenz an OpenAI anknüpfen.
Am selben Tag, an dem DeepSeek plant, die Führung bei der Investition in Winverse AI zu übernehmen, berichteten ausländische Medien, dass OpenAI plant, Sora wiederzubeleben.
Ein Startup-Unternehmen, das vom ehemaligen Sora-Leiter Bill Peebles mitgegründet wurde, führt derzeit Gespräche mit OpenAI, um eine umfassende Nutzungsberechtigung für Sora zu erhalten und es zu professioneller Software für die Filmerstellung anzupassen.
OpenAI könnte einen Teil der Anteile dieses Unternehmens erhalten, im Austausch dafür erhält die Gegenseite das Recht, diese Technik zu modifizieren und kommerziell zu nutzen. Ob die Modellgewichte gemeinsam genutzt werden, ist derzeit noch unklar, und