GPT-6.1 Sol hat über Nacht seine Kapazität um 500k erweitert und ist völlig kostenlos.
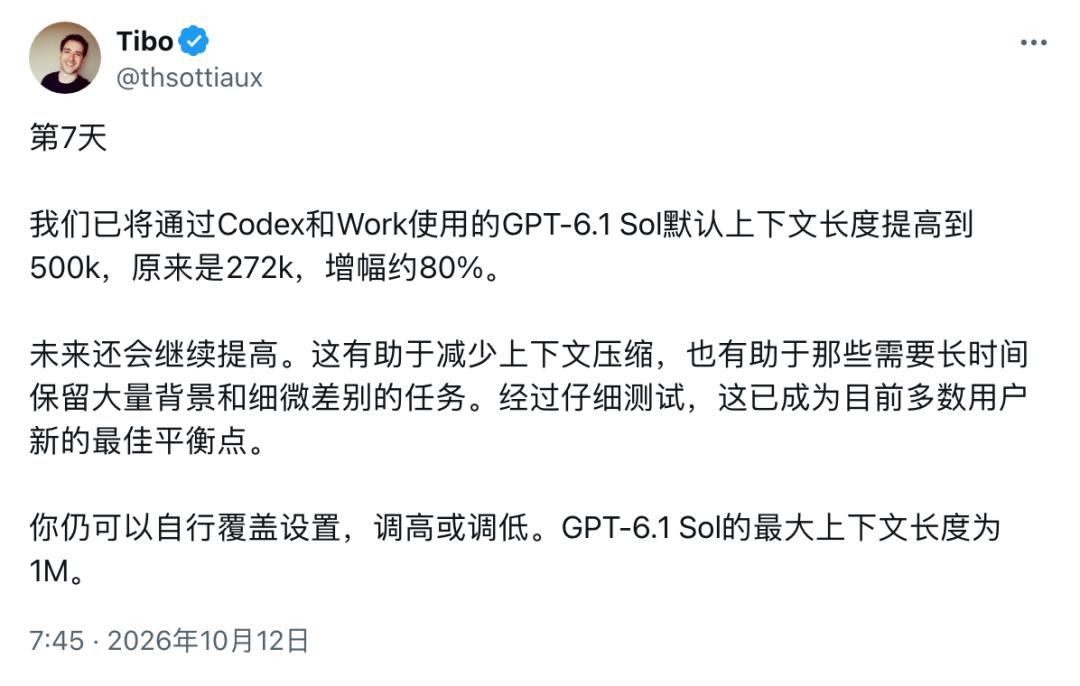
GPT-6.1 Sol hat standardmäßig einen Kontext von direkt 500k!
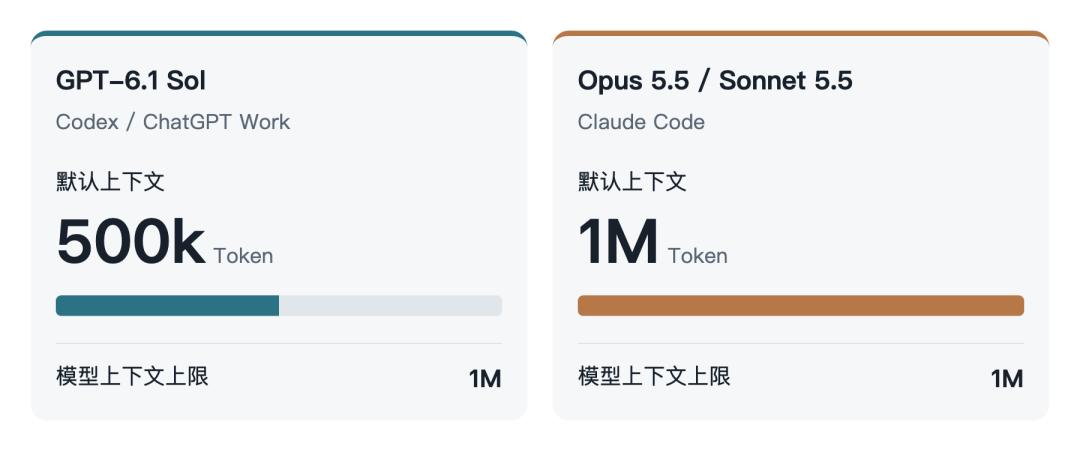
Bei dem Update am OpenAI Day 7 wurde das Standardfenster in Codex und ChatGPT Work von 272k auf 500k erweitert, was einem Anstieg von etwa 80 % auf einen Schlag entspricht.
Unmittelbar danach fügte Tibo noch eine weitere Nachricht hinzu: Bei der Ausführung von GPT-6.1 Sol mit dem Abonnementguthaben wird kein Aufpreis für langen Kontext erhoben.
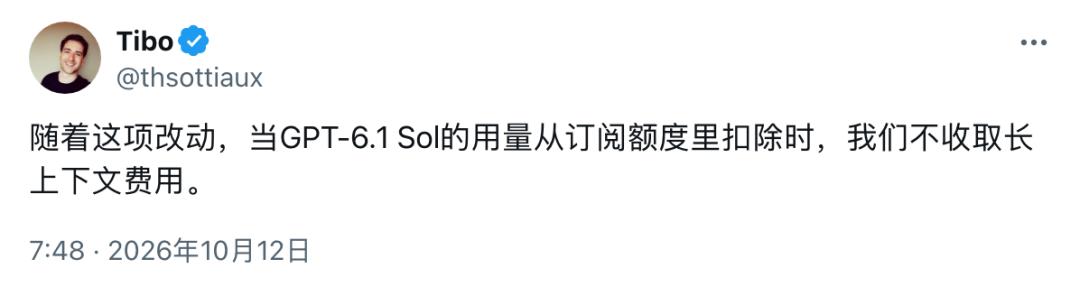
Aufgaben verbrauchen weiterhin normal das Abonnementguthaben, es wird jedoch keine zusätzliche Gebühr mehr erhoben, wenn der Kontext länger wird.
Bei Aufrufen über die API wird weiterhin nach der API-Preistabelle abgerechnet.
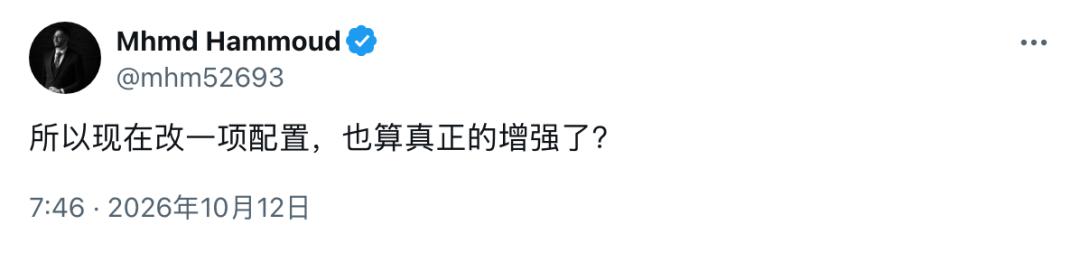
Der Entwickler Mhmd Hammoud fragte jedoch im Kommentarbereich zurück: „Ist das Ändern einer Konfiguration jetzt schon ein echtes Upgrade?“
GPT-6.1 Sol erreicht sprunghaft 500k, der Wunsch ist in Erfüllung gegangen
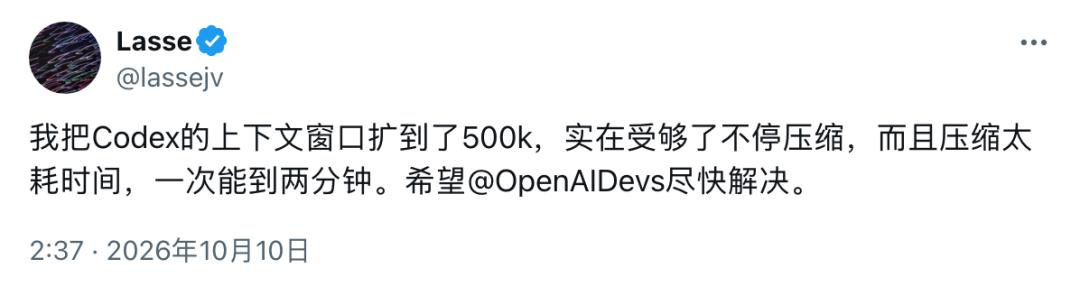
Bevor der Standardwert von 500k veröffentlicht wurde, hatte der Entwickler Lasse das Warten auf die Komprimierung schon lange satt.
Er hatte sich beschwert, dass eine einzelne Kontextkomprimierung bei Codex ihn bis zu zwei Minuten warten lassen kann.
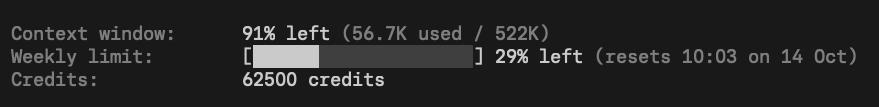
Zwei Tage vor diesem Update stellte er das Fenster selbst auf 500k, veröffentlichte einen Screenshot des Status und forderte OpenAI auf, das Problem der zu langsamen Komprimierung schnell zu beheben.
Wenn Sie Codex zum Abfragen von Dateien, Ändern von Code und Ausführen von Tests verwenden, belegen die gelesenen Codes und Fehlermeldungen den Kontext.
Wenn er fast voll ist, muss er zuerst die vorherigen Dialoge und Arbeitsfortschritte komprimieren und ordnen, um Platz zu schaffen, bevor er weiterarbeiten kann.
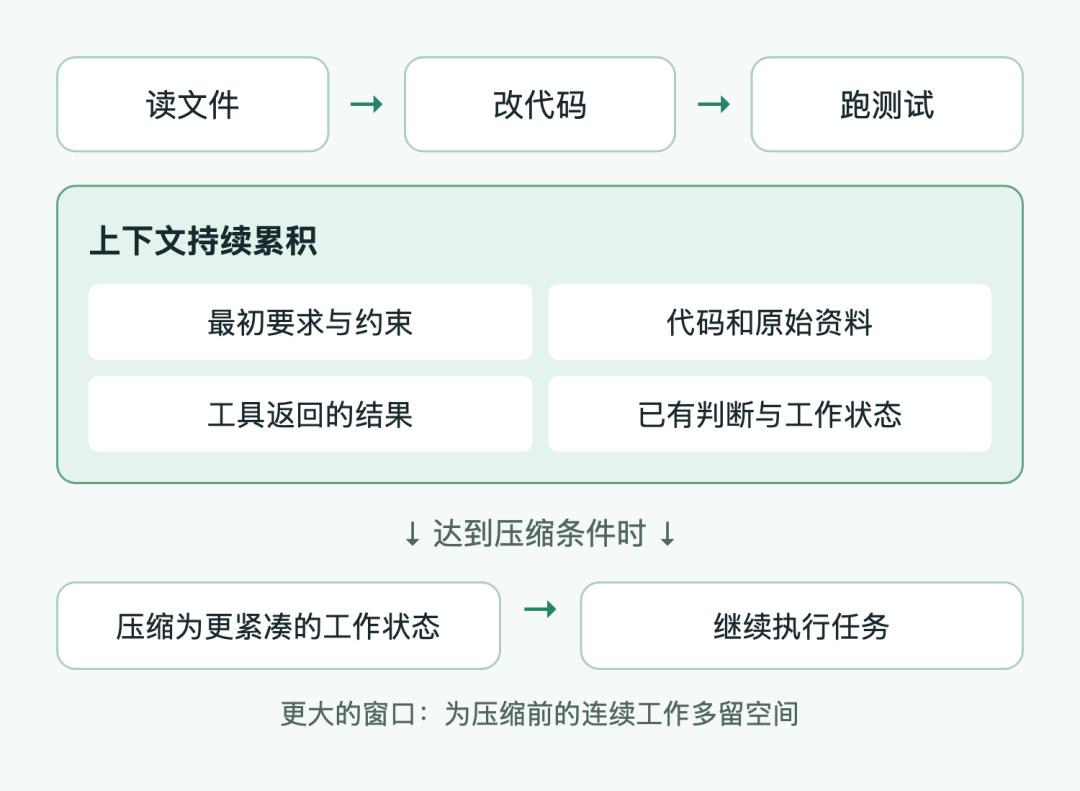
Nachdem die Komprimierung abgeschlossen ist, müssen Sie auch überprüfen, ob er die ursprünglichen Anforderungen nicht vergessen hat.
Zum Beispiel wurde zu Beginn der Arbeit klar gesagt, dass „diese Schnittstelle mit der alten Version kompatibel sein soll“. Wenn nach der Änderung von mehr als einem Dutzend Dateien die neue Funktion funktioniert, die alte Schnittstelle jedoch kaputt ist, müssen Sie am Ende selbst nachbessern.
Laut Tibo kann diese Erweiterung die Komprimierung reduzieren und dem Modell auch ermöglichen, mehr Details in langen Aufgaben zu behalten.
Weniger Komprimierungsvorgänge und weniger Wiederholungen derselben Anforderung – so hilft dieser Wert von 500k wirklich weiter.
Kein Aufpreis, das Guthaben wird trotzdem abgezogen
Das Schlimmste ist, dass die Komprimierung reduziert wird, das Guthaben aber schneller abnimmt. OpenAI ist tatsächlich schon einmal in diese Falle getappt.
Dieses Jahr im Juli hat OpenAI den Kontext in den Produkten von 272k auf 372k erhöht, für die Verwendung durch GPT-5.6 Sol.
Infolgedessen wurde mehr Abonnementguthaben verbraucht als erwartet, und das Team kehrte zu 272k zurück. Die gerade hinzugefügte Kapazität wurde sofort wieder entzogen.
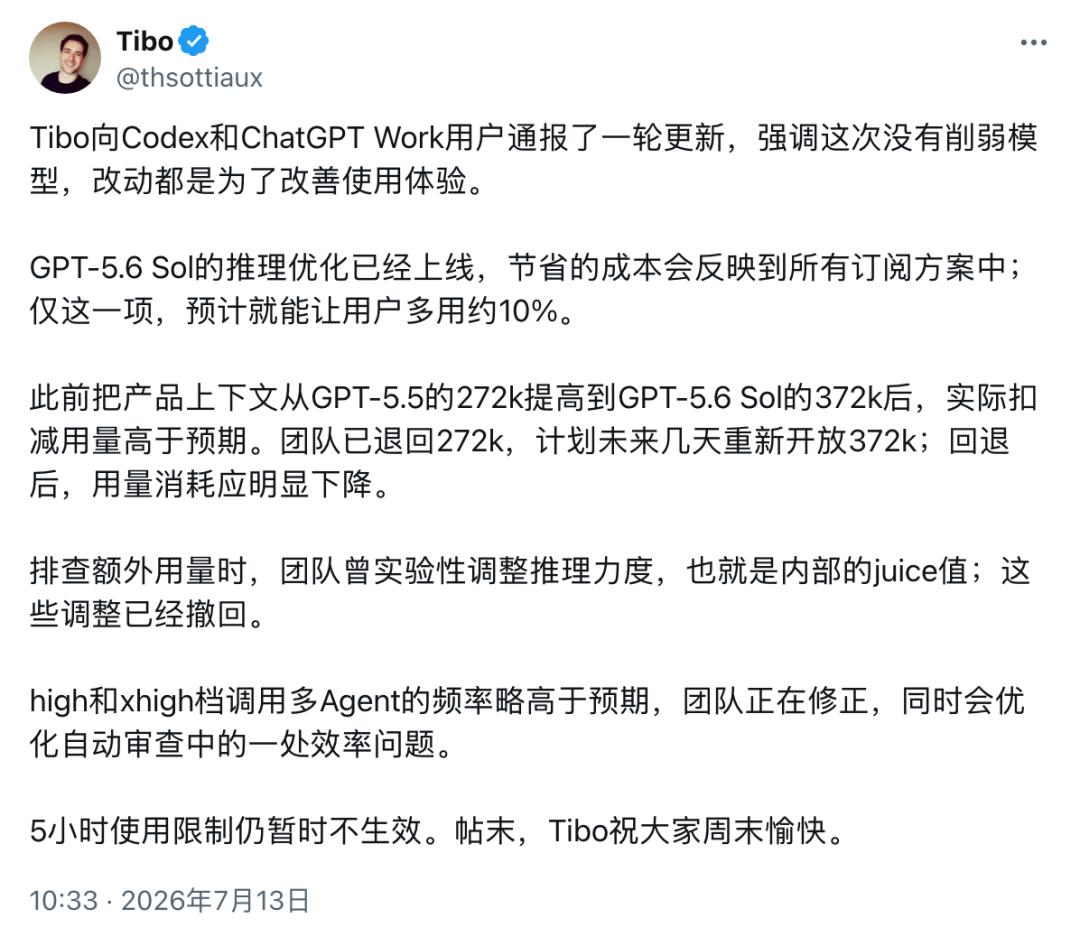
Der Entwickler Theo vermutete damals, dass nach Überschreiten von 272k im Kontext der doppelte Preis berechnet wird.
Tibo korrigierte, dass damals auch keine zusätzliche Gebühr für langen Kontext im Abonnement erhoben wurde. Der übermäßige Verbrauch stammte vom wiederholten Lesen von mehr zwischengespeicherten Inhalten.
Sie haben nur ein Wort „Weiter“ eingegeben, aber der Agent muss weiterhin Code ändern und muss trotzdem die zuvor gelesenen Dateien, Testergebnisse und Anforderungen mitnehmen.
Bei späteren Aufrufen von Tools und weiteren Schlussfolgerungen können diese Inhalte möglicherweise wiederholt gelesen werden.
Der Cache kann bereits verarbeitete Inhalte wiederverwenden, die Lesekosten sind niedriger, aber jedes Lesen wird trotzdem zum Verbrauch gezählt. Wenn die gelesenen Inhalte und die Anzahl der Lesevorgänge zunehmen, summiert sich der Verbrauch.
Kein Aufpreis bedeutet nicht, dass dieselbe Aufgabe definitiv weniger Guthaben verbraucht.
Entwickler möchten weniger auf Komprimierung warten, wollen aber nicht, dass das Guthaben aufgebraucht ist, bevor das Projekt abgeschlossen ist.
Claude hat standardmäßig schon lange eine Million
Trotzdem muss man, um zu sehen, ob 500k ausreicht, es mit Claude vergleichen.
In Claude Code haben Opus 5.5 und Sonnet 5.5 bereits einen Standardkontext von 1M, was dem Doppelten des neuen Standardwerts von Codex entspricht.
Tatsächlich kann die Obergrenze von GPT-6.1 Sol ebenfalls 1M erreichen, und Benutzer können sie manuell erhöhen.
Allerdings gibt OpenAI diesmal standardmäßig 500k an, weil nach Tests diese Einstellung für die meisten Benutzer geeigneter ist.
Bei den Kosten werden diese beiden Claude-Modelle bei API-Aufrufen innerhalb von 1M nach dem Standard-Token-Preis berechnet, und der Preis steigt nicht, wenn der Kontext länger wird.
Bei OpenAI wird diesmal nur der Aufpreis für langen Kontext im Abonnementguthaben erlassen, der API-Preis wird separat berechnet. Die beiden Seiten beziehen sich auf unterschiedliche Abrechnungsbereiche.
Wenn das Fenster auf 1M geöffnet ist, wird es trotzdem manchmal voll. Bei Verwendung dieser beiden Modelle in Claude Code liegt der standardmäßige automatische Komprimierungspunkt bei etwa 967k.
Wenn es sich der Obergrenze nähert, entfernt es zuerst die älteren Tool-Ausgaben im Kontext, z. B. Aufzeichnungen über das Lesen von Dateien und das Ausführen von Befehlen.
Wenn der Platz immer noch nicht ausreicht, wird der Dialog zu einer Zusammenfassung geordnet, die aktuelle Anforderung und der Schlüsselcode werden beibehalten, damit die Aufgabe fortgesetzt werden kann.
Unteraufgaben wie das Abfragen von Dateien können an Unteragenten übergeben werden. Diese haben ihren eigenen Kontext und geben nach Abschluss der Abfrage eine Zusammenfassung des Ergebnisses zurück.
Auf diese Weise kann der Hauptagent mit dem Ergebnis weiterarbeiten, ohne dass der gesamte Suchvorgang in den Hauptdialog eingefügt werden muss.
OpenAI hat angegeben, dass das Standardfenster in Zukunft weiter erhöht wird.
Das Fenster wird größer, aber die Geduld der Entwickler kann nicht mit erweitert werden. Nachdem der Code an die KI übergeben wurde, sollte man weniger warten müssen und weniger oft sagen müssen „Diese Anforderung habe ich schon früher gesagt“.
Referenzmaterialien:
https://x.com/thsottiaux/status/2109430343346581527?s=20
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto Xinzhiyuan, Autoren: Mose, Taozi, veröffentlicht mit Genehmigung von 36kr.