Wollen Sie wissen, wohin die Entwicklung von KI-Chips als Nächstes geht? Wer nicht am Shanghai-Gipfel teilgenommen hat, der braucht nur diesen Artikel zu lesen, und das reicht völlig.
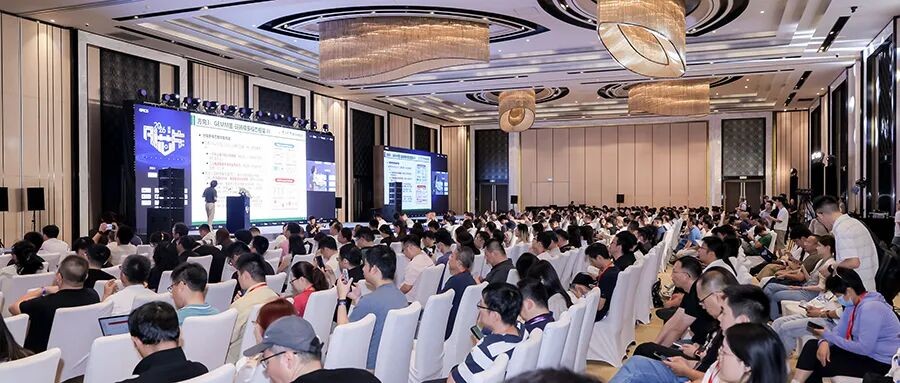
Bericht von Chip Home am 21. September: Der globale Gipfel für KI-Chips 2026 ist kürzlich in Shanghai erfolgreich zu Ende gegangen.
Diese Konferenz wurde von Smart Home initiiert, von der untergeordneten Marke Smart Ape veranstaltet und von Chip Home koordiniert. Unter dem Motto „Auf der Suche nach dem Weg der Chips, gemeinsam vorankommen“ beleuchtet sie umfassend die Schlüsselkette der KI-Rechenleistung von TOPS bis zu Token.
An zwei vollen Tagen haben mehr als 60 hochkarätige Gäste in einer Eröffnungszeremonie, drei Foren und fünf geschlossenen Seminaren konzentriert wertvolle Inhalte zu technologischen Innovationen, praktischen Anwendungen und Branchentrends vermittelt. Mehrere Redner haben auf der Konferenz auch neue Spitzenprodukte angekündigt.
Die Konferenz konzentriert sich auf die Spitzenbereiche der KI-Chips und umfasst Schwerpunktthemen wie Architekturinnovation, 3D-Stapelung, Superknoten, KV-Cache, neuartige Speicher, heterogenes gemischtes Training und Inferenz in Token-Fabriken, Inferenz großer Modelle, Inferenz intelligenter Agenten und Inferenz für verkörperte Intelligenz. Fachbesucher von mehr als hundert Unternehmen im Ökosystem der KI-Chips sind vor Ort gekommen, um sich auszutauschen.
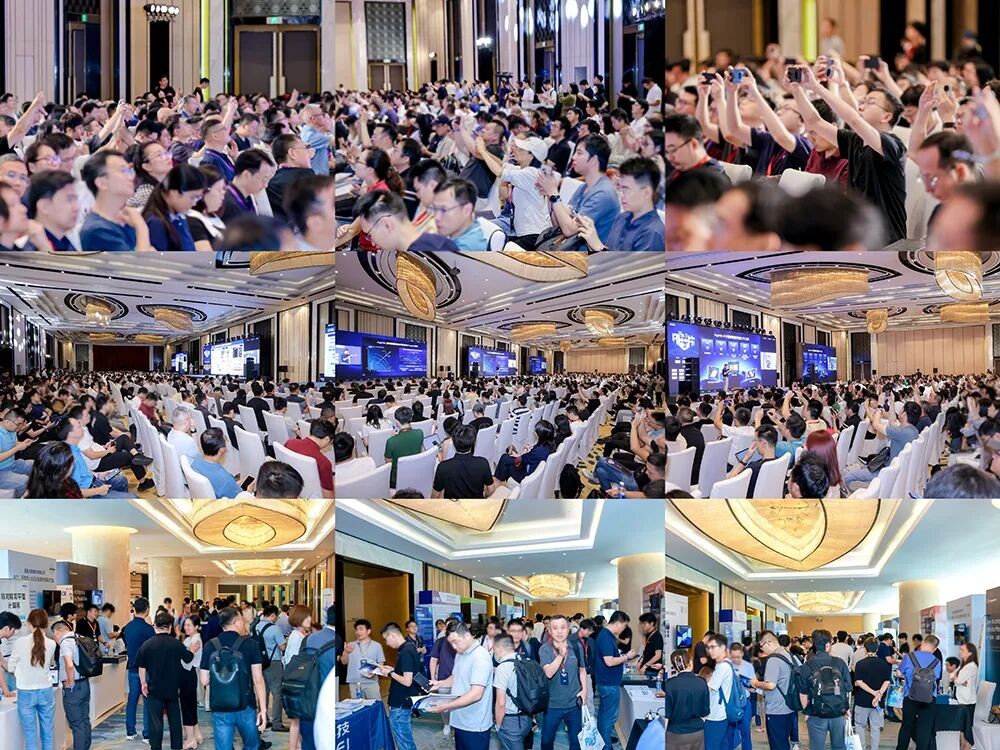
In der Ausstellungsbereich haben Unternehmen wie QuantiX, Nuclei System Technology, Imagination, Advantech, Moffett, Asterfusion, Quxin Chenguang, KEHUA DATA, Bolun Zhihui, Silicore, Advanced Compiler, Henghan Microelectronics und Yanrong Technology ihre neuesten technologischen Produktlösungen präsentiert.
„Vor neun Jahren haben wir den ersten globalen Gipfel für KI-Chips in Shanghai veranstaltet. In den neun Jahren hat der globale Gipfel für KI-Chips seine Spuren bereits in Peking, Shenzhen und Shanghai hinterlassen“, sagte Gong Lvchang, Mitbegründer und CEO von Smart Home, in seiner Ansprache: „Dies ist ein Mikrokosmos unserer fortwährenden Aufmerksamkeit für den gesamten KI-Bereich.“
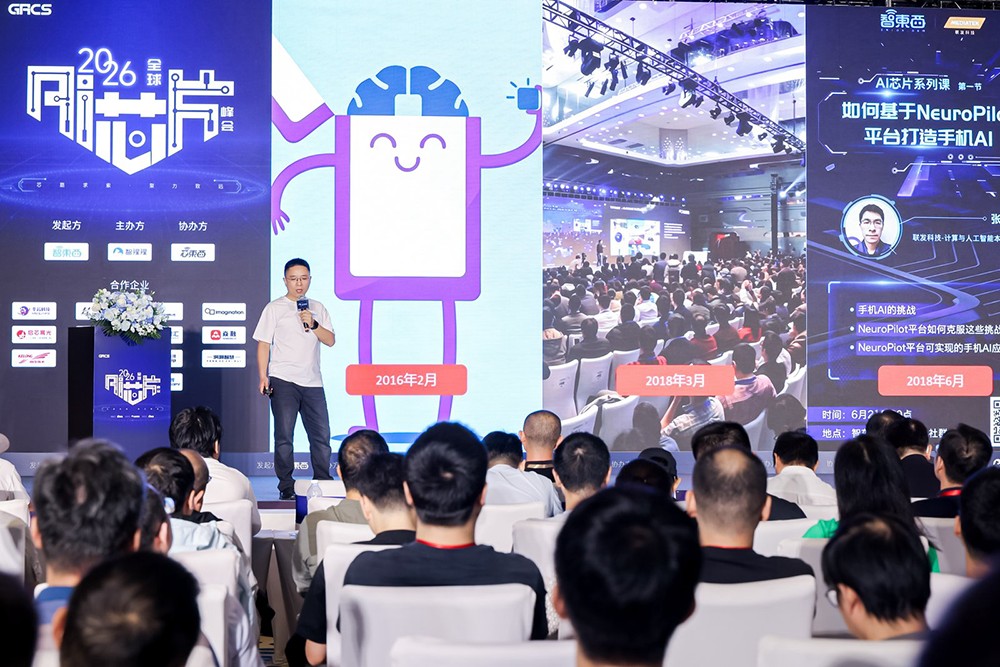
Gong Lvchang, Mitbegründer und CEO von Smart Home
Wir haben die Beiträge von 30 Gästen aus der Eröffnungszeremonie und drei hochrangigen Foren (KI-Chips für große Modelle, Inferenzchips für Agenten, Chips für verkörperte Intelligenz) zusammengefasst, die wichtigsten Punkte sind wie folgt:
I. Wettbewerb der Cloud-KI-Chips! Effiziente Rechenleistung erfordert neue Architekturen – die CPU kehrt in den Mittelpunkt des Zeitalters der intelligenten Agenten zurück
Mit dem Boom der intelligenten Agenten entwickelt sich die globale Struktur der KI-Chip-Industrie ständig weiter. Führende Modellanbieter sind tief an der Anpassung der Chiparchitektur beteiligt, fast jeder Cloud-Computing-Riese entwickelt eigene KI-Chips. Die inländischen KI-Beschleunigerkarten werden zunehmend in großem Umfang eingesetzt, und der Schwerpunkt des Rechenleistungsbetriebs verlagert sich von der rücksichtslosen Eroberung hochwertiger Rechenleistung hin zu einer feinen Betriebsführung, bei der die Kosten von Token und die Auslastung der Rechenleistung im Mittelpunkt stehen.
Wie kann die Effizienz des Trainings und der Inferenz großer Modelle durch technologische Innovationen verbessert werden? Warum erfordert das Zeitalter der intelligenten Agenten eine „sechseckige“ CPU? Welche neuen Lösungen gibt es, um die Engpässe bei Rechenleistung, Speicher und Netzwerk zu überwinden? Wie können große Modelle die Effizienz des Chipdesigns verbessern? Fünf Redner haben auf der Eröffnungszeremonie ihre Ergebnisse und Überlegungen lebhaft vorgestellt.
1. Wang Zhongfeng von der Sun Yat-sen-Universität: Die volle Ausnutzung der Rechenleistung von KI-Chips und die Beteiligung großer Modelle am Chipdesign
Wang Zhongfeng, Dekan der Fakultät für integrierte Schaltungen der Sun Yat-sen-Universität und IEEE/AAIA Fellow, hat die Herausforderungen bei dem Design von KI-Chips und die Entwicklungsrichtung im Zeitalter großer Modelle geteilt. Derzeit ist es zu einem Schlüsselproblem geworden, wie die Spitzenrechenleistung der Hardware in die effektive Rechenleistung für die Modellimplementierung umgewandelt werden kann. Um eine effiziente Implementierung zu erreichen, hat sein Team durch Innovationen bei Komprimierungs- und Quantisierungstechniken den Datenaufwand reduziert und die Inferenzeffizienz durch die Zusammenarbeit von Software und Hardware verbessert.
Bei dem modellgetriebenen Chipdesign hat das Team von Wang Zhongfeng durch das Design von hocheffizienten Beschleunigern für visuelles Mamba, Inferenzbeschleunigern für extrem niedrige BitLLM und mehrschichtigen dünn besetzten Transformator-Beschleunigern Herausforderungen wie Operatoranpassung, Speicherplanung und Nutzung von Dünnbesetzung gelöst. Für die Automatisierung des Chipdesigns, das durch große Modelle unterstützt wird, wurden Innovationen wie die leistungsbewusste Generierung von GEMM-Verilog und das multimodale Framework für die Umwandlung von GEMM-Diagrammen in Code vorgeschlagen.
Wang Zhongfeng ist der Ansicht, dass die Entwicklungsrichtung zur Verbesserung der effektiven KI-Rechenleistung die kooperative Innovation von Modellen, Hardware und Systemdesign sein wird, einschließlich der Erforschung von Modellkompression und Genauigkeitsanpassung mit niedrigeren Bits, der gemeinsamen Optimierung von Operatorfusion und Datenwiederverwendung sowie der Förderung der Modelliteration durch Rückmeldungen aus der Implementierung.
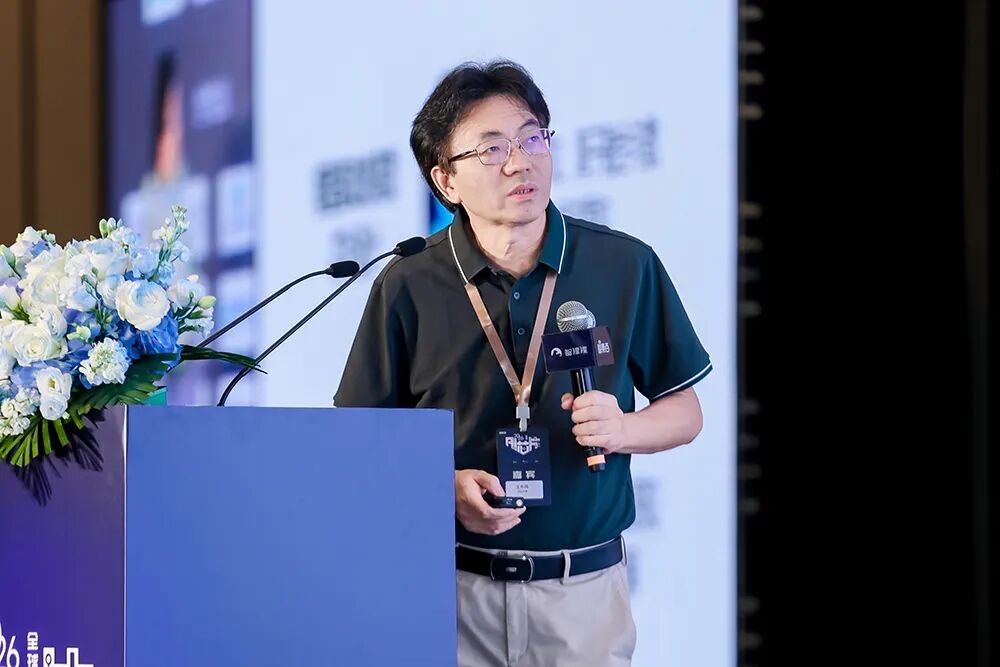
Wang Zhongfeng, Dekan der Fakultät für integrierte Schaltungen der Sun Yat-sen-Universität und IEEE/AAIA Fellow
2. Gao Yu von Intel: Im Zeitalter der intelligenten Agenten kehrt die CPU in die zentrale Position zurück
Gao Yu, Generalmanager der Technologieabteilung von Intel China, sagte, dass der Boom der intelligenten Agenten die Nachfrage nach CPU, Speicher, SSD und Datenschutz steigert, sodass die CPU die Rolle der „Unterstützung“ für die GPU in der Vergangenheit aufgibt und in die zentrale Position des KI-Rechenleistungssystems zurückkehrt.
Der Betrieb eines intelligenten Agenten ist ein zyklischer Prozess, dessen Hauptthread hauptsächlich auf der CPU ausgeführt wird. Die CPU ist für Kontextverarbeitung, Aufruf großer Modelle, Berechtigungsprüfungen, Aufruf von Tools und Ergebnisverarbeitung verantwortlich.
Eine CPU, die für intelligente Agenten geeignet ist, darf nicht nur die Einzelpunktleistung verfolgen, sondern muss ein „sechseckiger Kämpfer“ sein, der gleichzeitig eine höhere Sandbox-Parallelität, IPC und Frequenz, eine größere Speicherkapazität sowie Hardwarebeschleunigungs- und Sicherheitsfunktionen aufweist.
Gao Yu kündigte an, dass Intel auf der zweitägigen Konferenz für technologische Innovation und industrielles Ökosystem (Intel Connection) das Design eines hochdichten CPU-Schranks mit 128 oder 192 integrierten Granite Rapids-Prozessoren vorstellen wird. Ein einzelner Schrank kann 50.000 Agenten gleichzeitig parallel ausführen.
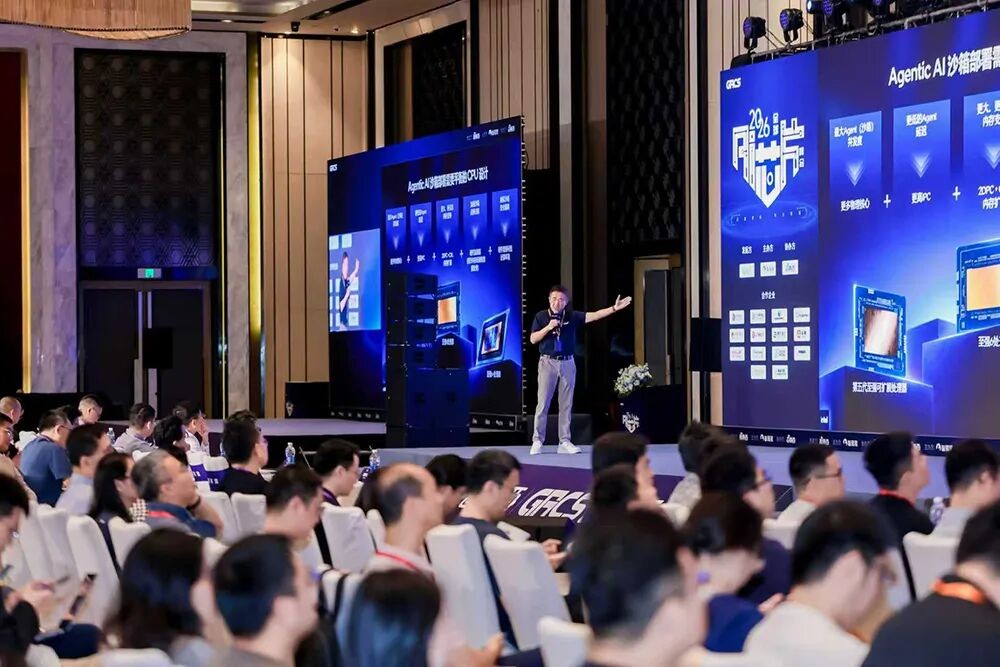
Gao Yu, Generalmanager der Technologieabteilung von Intel China
3. Hu Yang von der Tsinghua-Universität: Verbesserung der Token-Wirtschaftlichkeit durch kooperatives Design auf Wafer-Ebene
Hu Yang, außerordentlicher Professor an der Fakultät für integrierte Schaltungen der Tsinghua-Universität, wies darauf hin, dass der Wert der KI-Infrastruktur nicht nur an der Spitzenrechenleistung eines einzelnen Chips gemessen werden darf, sondern auch die effektive Token-Ausbeute sowie den gesamten Lebenszyklusaufwand für Geräte, Netzwerke, Stromversorgung und Kühlung berücksichtigen muss. Sein Team führt rund um die Token-Wirtschaftlichkeit ein systemweites kooperatives Design von Rechen-Chiplets, Wafer-Chips bis zu Clustern durch.
Für die drei Engpässe bei Kommunikation, Stromverbrauch und Integrationsdichte optimiert das Team das Verhältnis von Rechen-, Speicher- und Kommunikationsressourcen entsprechend den Aufgabenanforderungen sowie den Flächen- und Leistungsbeschränkungen. Auf Systemebene wird die Hochgeschwindigkeitskommunikation in das Innere des Wafers verlegt, und die Verbindung sowie Stromversorgung und Kühlung innerhalb und außerhalb des Wafers werden gemeinsam entworfen, um die Kommunikationswartezeit und den Aufwand für Peripheriegeräte zu reduzieren.
Der Bericht stellt die Forschungsfortschritte bei der Modellimplementierung, der Expertenanordnung und der Cluster-Netzwerkbildung vor. Durch die gemeinsame Optimierung von Token-Mapping und Lastenausgleich der Experten erreicht die MoE-Inferenzlösung bei einer Einschränkung des Token-Ausgabeintervalls von 4 Millisekunden einen Durchsatz pro Chiplet, der 1,84 Mal so hoch ist wie der der Vergleichslösung. Die Stromkosten der Lösung für die Vernetzung zwischen Wafern sind in der bewerteten Konfiguration um 46 % niedriger als bei der Baseline. Die entsprechende Forschung erforscht die Wirtschaftlichkeit auf Wafer-Ebene aus zwei Aspekten: der Verbesserung der effektiven Ausbeute und der Verringerung des Systemaufwands.
Hu Yang betonte, dass die Leistungsvorteile gemeinsam mit den Herstellungs- und Betriebskosten bewertet werden müssen. Das Team hat bereits die durch Wärme verursachte Verformung, die Herstellungs- und Montageausbeute sowie die Anforderungen an Fehlertoleranz und Wärmeabfuhr in das Design einbezogen, gemeinsam mit Qingwei Intelligence einen inländischen Wafer-Chip-Prototyp entwickelt und die Fähigkeiten für das PDK-Design großformatiger Siliziumsubstrate, die Integration von Chiplets und die Systemvalidierung aufgebaut. Außerdem hat es gemeinsam mit Qingwei Intelligence und dem Pujiang-Labor die Softwareinfrastruktur aufgebaut.
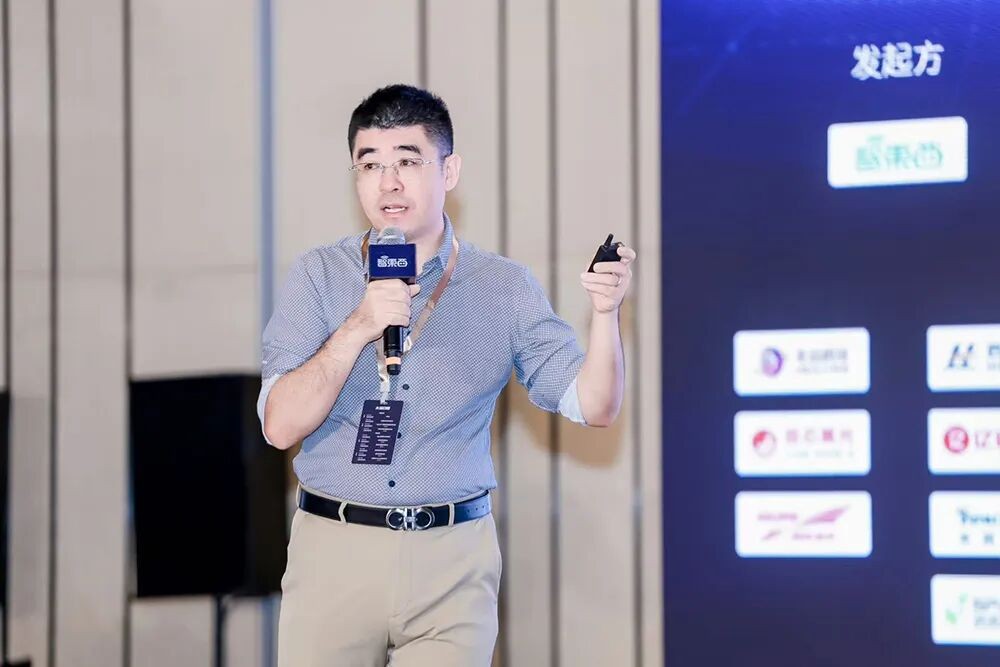
Hu Yang, außerordentlicher Professor an der Fakultät für integrierte Schaltungen der Tsinghua-Universität
4. Xin Xiaoxu von Hmo Intelligent: Das M50 wurde in mehr als 150 Produkten festgelegt, und die 3D-CIM-Architektur hat phasenweise Ergebnisse erzielt
Laut Xin Xiaoxu, Mitbegründer und Produktvizepräsident von Hmo Intelligent, hat Hmo Intelligent als Pionier der integrierten Speicher- und Recheneinheit in den letzten sechs Jahren die Iteration entlang der auf SRAM basierenden Linie der integrierten Speicher- und Recheneinheit durchgeführt und die Architektur der integrierten Speicher- und Recheneinheit erfolgreich aus der akademischen Welt in die Industrie gebracht. Sein Flaggschiffprodukt M50 ist seit einem halben Jahr in Massenproduktion, und die Anzahl der festgelegten Produkte hat mehr als 150 erreicht, wodurch ein geschlossener Geschäftskreislauf entstanden ist.
Für die Probleme der begrenzten Rechenleistung und der schlechten Wärmeabfuhr der in der Industrie verbreiteten 3D-Stapelungstechnologie hat Hmo Intelligent die selbstentwickelte 3D-CIM-Architektur entwickelt, die die Rechenleistung bei gleicher Fläche verdoppelt und den Stromverbrauch sowie den Druck der Wärmeabfuhr erheblich optimiert. Xin Xiaoxu sagte, dass Hmo Intelligent die technologische Entwicklung rund um die neuen Anforderungen an Rechenleistung, Energieeffizienz und Speicherbandbreite der seitenseitigen KI durchführen und die industrielle Erforschung von Chips mit der 3D-CIM-Architektur beschleunigen wird.
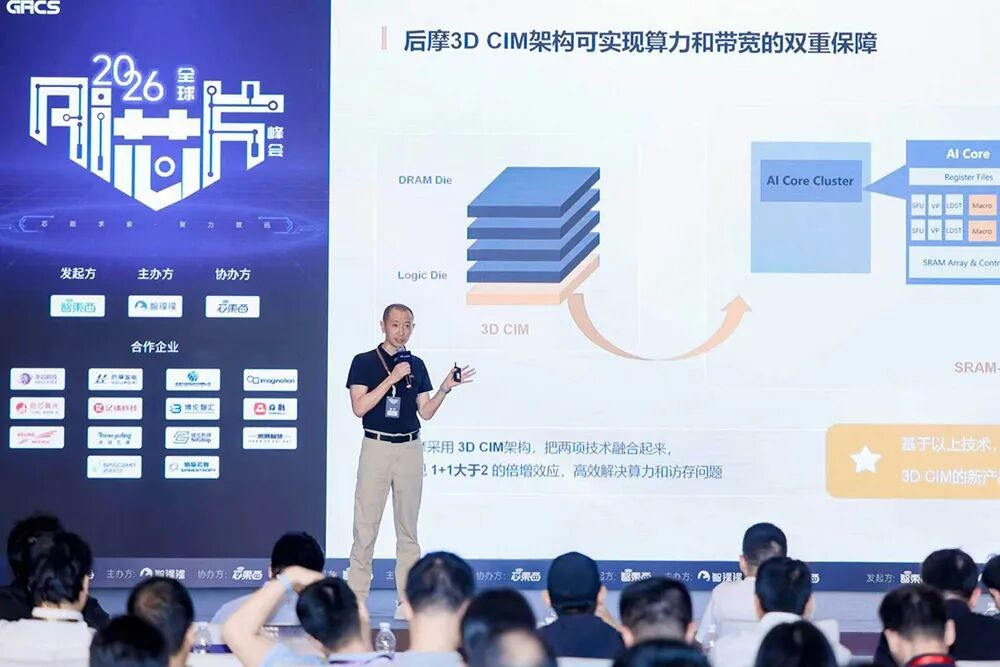
Xin Xiaoxu, Mitbegründer und Produktvizepräsident von Hmo Intelligent
5. Wang Xiaoyang von QuantiX: Zukünftige KI-Chips könnten die neue Architektur aus angepasstem Speicher (HBM+HBF) und Standardverbindung übernehmen
Nach Ansicht von Wang Xiaoyang, Mitbegründer und Vizepräsident von QuantiX, entwickelt sich das Design von KI-Chips allmählich in Richtung Anpassung, Heterogenität und Spezialisierung, was neue Möglichkeiten für die Innovation der Speicherarchitektur bietet. Die Anpassung von HBM-Basis-Dies und der geschichtete HBF-Speicher werden zu neuen Trends.
Der HBM-Speicher hat sich von einem Standardprodukt zu einem kleinen Subsystem entwickelt, das für verschiedene Arbeitslasten tiefgehend angepasst werden muss. HBF verwendet eine angepasste Stapelung von NAND-Flash, um die Bandbreite auf HBM-Niveau zu erreichen, aber die Kapazität ist um eine Grö