Kann das „Meituan“ in der Welt der Embodied Intelligence erfolgreich funktionieren?
Im Jahr 2016 brachte das Unternehmen für autonomes Fahren Comma.ai eine Fahraufzeichnungs-App namens Chffr auf den Markt. Nachdem Nutzer sie heruntergeladen und installiert haben, wird das Mobiltelefon zu einem Fahrtenschreiber. Wenn man es vor die Windschutzscheibe stellt, zeichnet die App automatisch die Daten während des Fahrvorgangs auf und lädt sie anschließend auf den Cloud-Server des Unternehmens hoch, um das Modell für autonomes Fahren zu trainieren.
Dies war einer der frühen Versuche von KI zur Crowdsourcing von Daten in der physischen Welt. Nach der Vorstellung des Gründers konnte das Unternehmen, sobald genügend Fahrzeuge mit dieser App ausgestattet sind, eine enorme Menge an Fahrdaten sammeln, in kurzer Zeit ein leistungsstarkes Modell für autonomes Fahren trainieren und es dann wieder in jedes Fahrzeug einbauen, um einen geschlossenen kommerziellen Kreislauf zu erreichen.
Zehn Jahre später ist dieses Unternehmen nicht zum Hauptakteur im Bereich des autonomen Fahrens geworden. Der Fokus der Branche hat sich längst auf Tesla FSD verlagert, und das autonome Fahren im eigentlichen Sinne ist bis heute nicht eingetroffen.
Heute hat die Branche der verkörperten Intelligenz diese Methode wieder aufgegriffen. Im Ausland gibt es die Index-Plattform von Figure AI, im Inland ist es Mifeng Pai von Mifeng Technology, das zu Zhiyuan gehört.
Ende September veröffentlichte Mifeng Technology offiziell Mifeng Pai, eine Crowdsourcing-Plattform für verkörperte Daten, die aus drei Komponenten besteht: dem selbst entwickelten MEgo-Datenerfassungsgerät, der Mifeng Pai-App und der Datenverwaltungs-Engine MEgo Engine. Sie bezeichnet sich selbst als „die weltweit erste plattformweite Crowdsourcing-Dienstplattform für hochwertige physische KI-Daten aller Kategorien“.
Das Konzept des Crowdsourcing ist am häufigsten bei Lieferplattformen anzutreffen. Es sammelt in kurzer Zeit eine große Menge an Arbeitskräften durch eine Methode mit niedrigen Eintrittshürden und schneller Verwertung. Auf der Daten-Crowdsourcing-Plattform von Mifeng Pai können Nutzer Datenaufgaben annehmen, die für das Training von Robotern benötigt werden, und mit der Erfassung von Daten Geld verdienen. Nachdem Mifeng diese Daten erhalten hat, führt es Vorgänge wie Verwaltung und Einstufung durch und verpackt sie anschließend für das Robotertraining.
Das Problem besteht darin, dass Crowdsourcing nur die „Menge“ löst. Verkörperte Intelligenz ist ein KI-Anwendungsszenario in der physischen Welt, das weitaus komplexer ist als das autonome Fahren. Sie muss nicht nur über ähnliche Local-Motion-Fähigkeiten wie das autonome Fahren verfügen, sondern auch feine Desktop-Operationen durchführen und komplexere physikalische Gesetze verstehen. Das Daten-Crowdsourcing für autonomes Fahren wurde zehn Jahre lang nicht erfolgreich umgesetzt – kann es bei der anspruchsvolleren verkörperten Intelligenz wirklich gut funktionieren?
01. 20 Yuan pro Stunde verdienen: Verkörperte Daten treten in das Zeitalter des Crowdsourcing ein
Ein Kurierfahrer im Logistikzentrum trägt ein Headset, um eine Stunde lang Pakete zu sortieren, eine Mutter trägt das Gerät, um eine Mahlzeit zuzubereiten, und ein Mitarbeiter in einem Tourismusgebiet zeichnet seinen täglichen Vorgang des Preisauszeichnens und Etikettierens auf. Nach dem Hochladen und der Prüfung dieser Daten kann die Vergütung mit 10 bis 20 Yuan pro Stunde abgerechnet werden.
Das ist das Spielprinzip von Mifeng Pai. Nachdem man die App heruntergeladen und geöffnet hat, sieht man zuerst einen Aufgabenbereich mit 22 großen Szenariokategorien, darunter Produktion, Lebensdienstleistungen, Gastronomie, Logistik, Medizin, Wohnen und mehr. Jedes Szenario entspricht Dutzenden oder sogar Hunderten von Aufgaben, die die verbleibenden verfügbaren Plätze und die Vergütung für jede Stunde der Datenerfassung kennzeichnen, die normalerweise zwischen 10 und 20 Yuan liegt.
Wenn man dieses Nebeneinkommen erzielen möchte, muss man zuerst einen Satz Datenerfassungsgeräte beantragen. Der genaue Ablauf besteht darin, sich an den lokalen Servicestandort zu wenden, nach bestandener Prüfung eine bestimmte Kaution und Miete zu zahlen und das Gerät dann per Abholung vor Ort oder per Kurier zu erhalten. Nachdem man die Mifeng Pai-App heruntergeladen und das Gerät gebunden hat, kann man beginnen, konkrete Aufgaben zu übernehmen. Die Miete für das Gerät beträgt 39 Yuan pro Tag und in der Einführungsphase 19 Yuan. Die Aufgabenvergütung setzt sich aus der grundlegenden Preisgestaltung der Stadt und dynamischen Zuschüssen zusammen. Bei einer Berechnung von 10 bis 20 Yuan pro Stunde muss man in der Einführungsphase erst ein bis zwei Stunden gültige Daten erfassen, um die Tagesmiete zurückzuverdienen. Nach der Rückkehr zum regulären Preis sind zwei bis vier Stunden erforderlich.
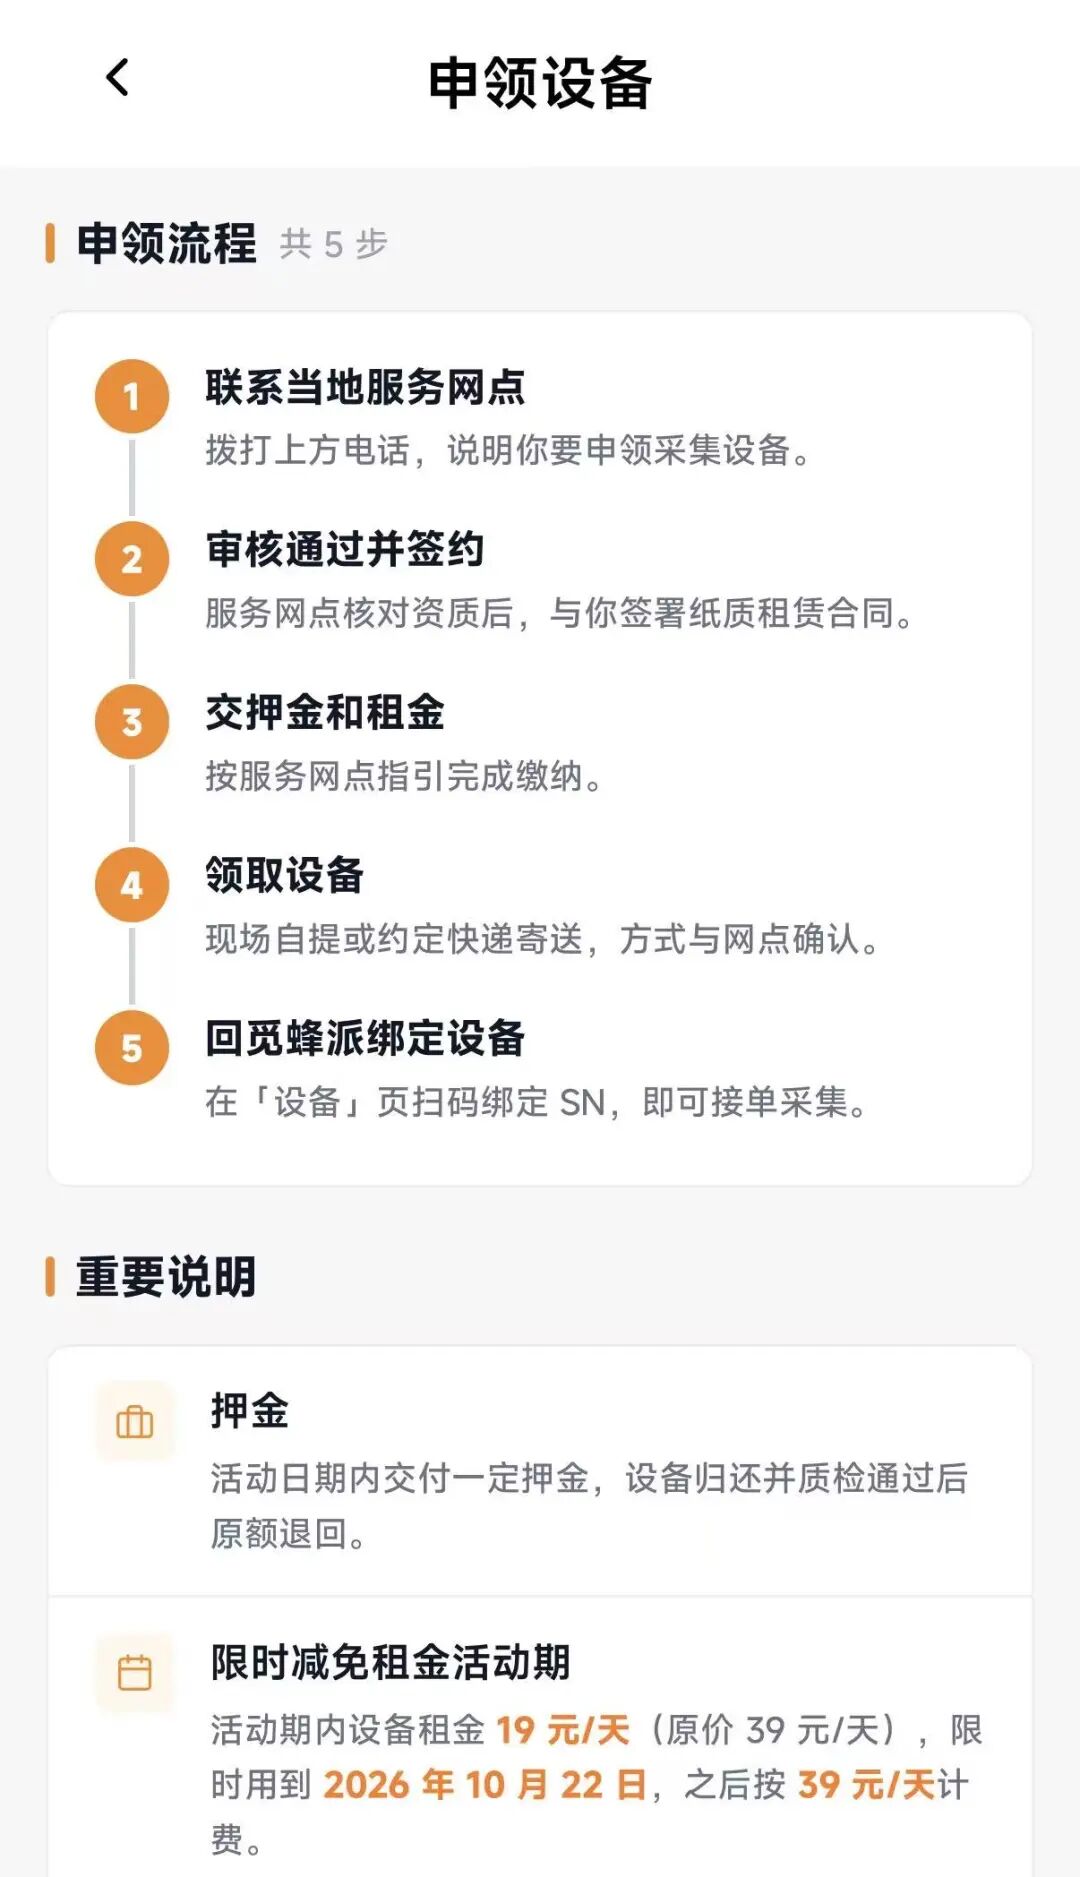
Derzeit ist das von Mifeng Pai ausgegebene Datenerfassungsgerät ein eigenständiges Headset, das Daten nach dem Datenerfassungsansatz von EGO erfasst. Nachdem Nutzer die Daten täglich erfasst und hochgeladen haben, warten sie auf die Genehmigung durch die Plattform, um die entsprechende Vergütung zu erhalten.
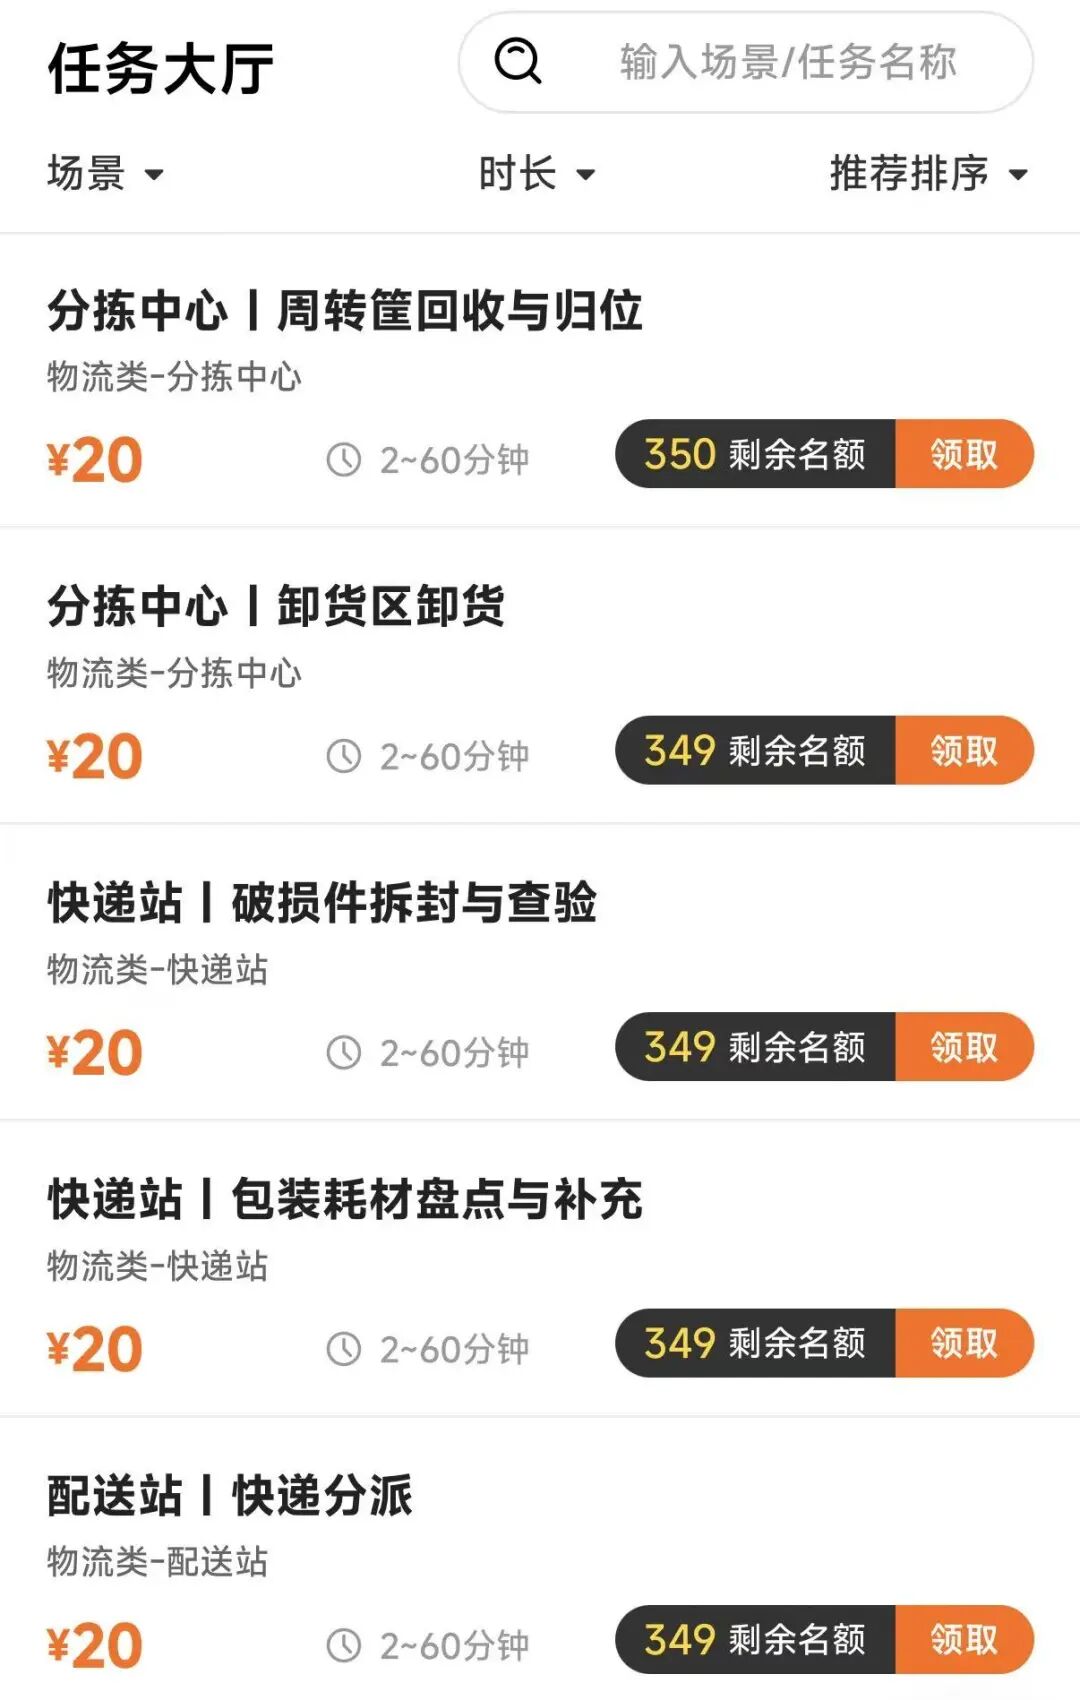
Aus den aktuellen Anzeigen der App geht hervor, dass einige beliebte Aufgabenszenarien, insbesondere Aufgaben im häuslichen Lebensumfeld, bereits vollständig beantragt wurden und keine freien Plätze mehr übrig sind. Bei Szenarien der Produktion und der Logistiksortierung gibt es noch relativ viele verbleibende Plätze. Mehrere Nutzer, die Mifeng Pai ausprobiert haben, haben der Publikation „Dingjiao One“ mitgeteilt, dass der Stückpreis für viele beliebte Aufgaben seit dem Start der Plattform stark gesunken ist. Beispielsweise ist der Preis für einige alltägliche Szenarien im häuslichen Umfeld von 20 Yuan auf 10 Yuan gefallen, aber die Plätze sind nach wie vor sehr begehrt.
Laut offiziellen Daten gab es innerhalb eines Monats des internen Tests von Mifeng Pai etwa 20.000 registrierte Nutzer, die insgesamt 13.000 Aufgaben eingereicht haben. Bei einer einfachen Umrechnung ergibt sich jedoch, dass weniger als eine Aufgabe pro Person eingereicht wurde. Nach der Registrierung muss man noch Geräte mieten und die Prüfung bestehen – die Zahl der Personen, die die Erfassung kontinuierlich durchführen, ist wahrscheinlich weitaus geringer als die Zahl der Registrierungen.
Dass der Bereich der verkörperten Intelligenz an Daten mangelt, ist heutzutage keine Neuigkeit mehr. Der Konsens in der Branche ist, dass ein Modell für verkörperte Intelligenz, um Fähigkeiten auf dem Niveau von GPT-3.5 in großen Sprachmodellen zu erreichen, Daten in der Größenordnung von 100 Millionen Stunden benötigt. Yao Maoqing, Vorsitzender und CEO von Mifeng Technology, erwähnte einmal, dass die weltweit gültigen Daten für verkörperte Intelligenz derzeit nur etwa Hunderttausende Stunden betragen, was eine Lücke von zwei bis drei Größenordnungen bedeutet.
In der ersten Hälfte dieses Jahres haben viele Unternehmen für verkörperte Intelligenz damit begonnen, öffentlich zu erklären, dass sie über Daten in der Größenordnung von Millionen Stunden verfügen – aber es besteht noch eine große Lücke zu 100 Millionen Stunden. Der Gründer eines Unternehmens für Daten der verkörperten Intelligenz sagte der Publikation „Dingjiao One“: Wenn man nur die bereinigten hochwertigen Daten zählt, beträgt der Zeitraum von Millionen Stunden bis zu 100 Millionen Stunden mindestens drei bis fünf Jahre.
Das ist auch der grundlegende Grund, warum Mifeng Technology ein so groß angelegtes Daten-Crowdsourcing initiiert. Wenn man sich nur auf die Hersteller von Roboterkörpern, Datenunternehmen und Modellunternehmen in der Branche verlässt, um Daten zu erzeugen, wird die Generalisierung der verkörperten Intelligenz auf unbestimmte Zeit hinauszögern.
Mifeng Technology wurde im Februar 2026 gegründet und wird von Zhiyuan kontrolliert. Seit April 2025 hat Zhiyuan mehrere Tochterunternehmen ausgegliedert, darunter Zhiding Robotics für kommerzielle Reinigungsroboter, Qingtian Zu für eine Roboter-Mietplattform, Lingjiedian für geschickte Hände und Zhiyuan Kuto für vierbeinige Roboter. Mifeng ist eines dieser Unternehmen, das für die verkörperten Daten verantwortlich ist. Die Branche ist dieser Methode jedoch nicht einhellig positiv eingestellt. Alle diese Tochterunternehmen werden von Zhiyuan kontrolliert und sind gleichzeitig gegenseitig Kunden und gegenseitige Szenarien – es ist für Außenstehende schwer, ihre unabhängige Fähigkeit zur Erzielung von Einnahmen zu erkennen. Einige Investoren von Zhiyuan sind selbst Kunden seiner Produkte. Einige Analysten weisen darauf hin, dass dies zwar nicht gegen Vorschriften verstößt, aber Fragen nach der Glaubwürdigkeit des Wachstums aufwirft.
Mifeng bietet hauptsächlich Datendienste für Datenanforderer wie große Modelle, Roboter und Forschungseinrichtungen an und stellt gleichzeitig Aufträge und Tools für Datenerfasser, Szenarioanbieter und Hardwarehersteller bereit. Darüber hinaus plant es, andere Drittanbieter von Datenunternehmen zur Teilnahme einzuladen, um eine Datendienstplattform aus Eigenbetrieb und Drittanbietern aufzubauen.
Derzeit unterteilen sich die von Mifeng Technology angebotenen Datendienste hauptsächlich in drei Kategorien: Fernsteuerung von echten Geräten, Simulation und Daten ohne eigenen Körper. Letztere umfasst zwei Ansätze: UMI (Erfassung mit handgehaltenem Greifer) und EGO (Ego-Perspektive). Das von der Crowdsourcing-Plattform Mifeng Pai verwendete Datenerfassungsgerät ist hauptsächlich MEgo View, das zur Kategorie der EGO-Geräte gehört. Seine vollständige Form besteht aus einem Headset mit 3 Fischaugenkameras und einer Gruppe von Binokularkameras sowie einem Paar Handgelenkkameras – aber derzeit enthält das auf Mifeng Pai vermietete Gerät nur das Headset.
Darüber hinaus verfügt Mifeng Technology auch über das Greifergerät MEgo Gripper für den UMI-Ansatz. Im Vergleich zu EGO, das nur mit einem Headset visuelle Daten aus der Ego-Perspektive aufzeichnet, ist die Bedienungsschwelle von MEgo Gripper höher und eignet sich nicht für groß angelegtes Daten-Crowdsourcing.
Das Modell selbst ist nicht kompliziert. Was wirklich bestimmt, wie weit dieses Geschäft kommen kann, ist die Kapazität der Branche, in der es angesiedelt ist, sowie der Wettbewerb anderer Akteure in dieser Branche.
02. Drei Datenansätze und drei Arten von Akteuren
Große Sprachmodelle basieren auf einer großen Menge an Textdaten aus dem Internet. Im Vergleich dazu fehlen der Branche der verkörperten Intelligenz dringend benötigte Daten aus der physischen Welt wie visuelle Daten, Tastdaten, Kraftdaten, Gelenkwinkel, räumliche Bewegungstrajektorien und mehr.
Damit Roboter ihren Wert wirklich entfalten können, müssen sie nachweisen, dass sie zwei Dinge tun können: in häusliche Szenarien eintreten, um Hausarbeiten zu erledigen, oder in Fabriken arbeiten. Beides erfordert, dass Roboter über Generalisierungsfähigkeiten verfügen – und diese hängen von einer großen Menge an Daten aus der physischen Welt ab.
Die Nachfrage stützt einen expandierenden Markt. Nach Berechnungen des Yiou Think Tanks betrug der globale Markt für die Erfassung von Daten der verkörperten Intelligenz im Jahr 2024 etwa 737 Millionen US-Dollar. Bis 2031 wird dieser Umfang voraussichtlich 7 Milliarden US-Dollar erreichen, mit einer durchschnittlichen jährlichen Wachstumsrate von 38 %.
Zum Vergleich: Das Prospekt von Unitree Robotics zeigt, dass der Markt für humanoide Roboter bis 2030 voraussichtlich 15 Milliarden US-Dollar erreichen wird. Das Gesamtvolumen des gesamten Datenerfassungsmarktes entspricht etwa der Hälfte des Marktes für Roboter selbst.
Der Wettbewerb auf der Anbieterseite ist intensiv. Bis April dieses Jahres gab es landesweit mehr als 64 geplante oder fertiggestellte Trainingsstätten für die Erfassung von Daten der verkörperten Intelligenz. Zhiyuan hat eine exklusive 4000 Quadratmeter große Datenerfassungsfabrik in Pudong, Shanghai, errichtet. JD kündigte an, das weltweit größte Datenerfassungszentrum für verkörperte Intelligenz mit den umfassendsten Szenarien zu bauen und plant, innerhalb von zwei Jahren 10 Millionen Stunden an Videodaten aus echten Szenarien zu sammeln. Paccini Perception Technology hat eine 12.000 Quadratmeter große Super-Datenfabrik in Tianjin in Betrieb genommen, die voraussichtlich fast 200 Millionen Datensätze pro Jahr erzeugen wird.
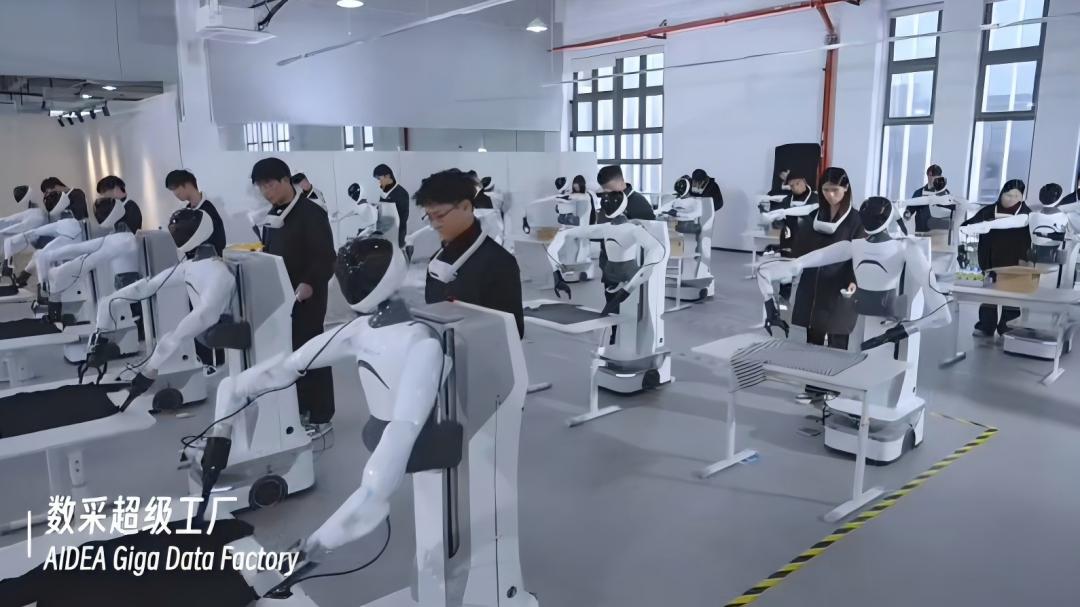
Quelle / Offizielle Website von Zhiyuan Technology
Derzeit gibt es in der Branche hauptsächlich drei Methoden, um das Problem des Datenmangels zu lösen. Der Ansatz der Fernsteuerung echter Geräte liefert die höchste Datenqualität, aber die Ausgabemenge ist am begrenztesten. Bei der Datenerfassung ohne eigenen Körper erfassen Menschen Daten, indem sie Geräte tragen – beispielsweise UMI, EGO und mehr. Die Ausgabemenge ist größer, aber die Daten müssen mehrere Schritte wie Bereinigung, Markierung und Verwaltung durchlaufen, bevor sie verwendbar sind. Schließlich gibt es Simulationsdaten und Videodaten aus dem Internet, die die größte Menge, aber die schlechteste Qualität aufweisen. Sie können zur Unterstützung des Trainings verwendet werden, aber die Menge an gültigen Daten ist sehr gering.
Die meisten Datenerfassungsanbieter setzen nicht nur auf einen einzigen Datenansatz. Aus Sicht des Branchenwettbewerbs lassen sich die derzeitigen Datenanbieter grob in drei Kategorien einteilen.
Die erste Kategorie umfasst die eigenen Daten- und Modellgeschäfte von Herstellern von Roboter-Körpern, vertreten durch Unternehmen wie Unitree, Xinghaitu und Galaxy General. Ihr Vorteil liegt im geschlossenen Kreislauf: Hersteller von Roboter-Körpern können Roboter-Körper vermieten oder verkaufen und anschließend die Daten der echten Geräte zurückkaufen. Gleichzeitig können sie kontinuierlich eigene Daten von echten Geräten erzeugen, und die Daten, die von ihren eigenen Geräten erzeugt werden, weisen keine Unterschiede in der Konfiguration auf, sodass sie leichter an die eigenen Produkte angepasst werden können.
Die zweite Kategorie sind professionelle Datendienstleister, darunter Guanglun Intelligent, Paccini, Lingchu Intelligent, Tashi Zhihang, Shouyi Technology und Mifeng Technology. Die Daten dieser Unternehmen können an verschiedene Unternehmen aus der Ober- und Unterseite verkauft werden, sie haben einen off