Warum haben alle 3D DRAM ins Visier genommen?
In den letzten Monaten ist ein deutlicher Trend im Bereich der KI-Inferenzbeschleuniger zu beobachten. Mehrere Unternehmen haben in ihren Entwicklungsroadmaps angedeutet, DRAM und Rechenkapazität miteinander zu stapeln.
Qualcomm hat die HBC-Technologie (High Bandwidth Computing) vorgestellt, anschließend erklärte Cerebras auf der Hot Chips-Konferenz, dass der CS-6-Chip DRAM-Chips auf seinen Rechenchip stapeln wird. Samsung hat unermüdlich seine zHBM-Technologie beworben und sie als endgültiges Ziel bezeichnet. Es gibt Gerüchte, dass auch Groq LP40 die Verwendung von gestapeltem DRAM in Betracht zieht. Darüber hinaus stellte d-Matrix auf der Deep-Konferenz seinen zweiten Beschleuniger der Generation, Raptor, vor, der ebenfalls mit gestapeltem DRAM ausgestattet ist und eine Zusammenarbeit mit NVIDIA angekündigt hat.
In diesem Artikel erläutere ich die Plausibilität dieses Trends. Ich gehe auf drei spezifische Gründe ein.
1. 3D-DRAM ermöglicht die Architektur mit der höchsten Leistung
2. 3D-DRAM senkt den Stromverbrauch auf unter 0,1 pJ/Bit, wodurch mehr Leistungsbudget für Berechnungen und Netzwerkkommunikation freigesetzt wird.
3. Im Gegensatz zu HBM kann der Zugriff auf 3D-DRAM deterministisch wie bei SRAM realisiert werden.
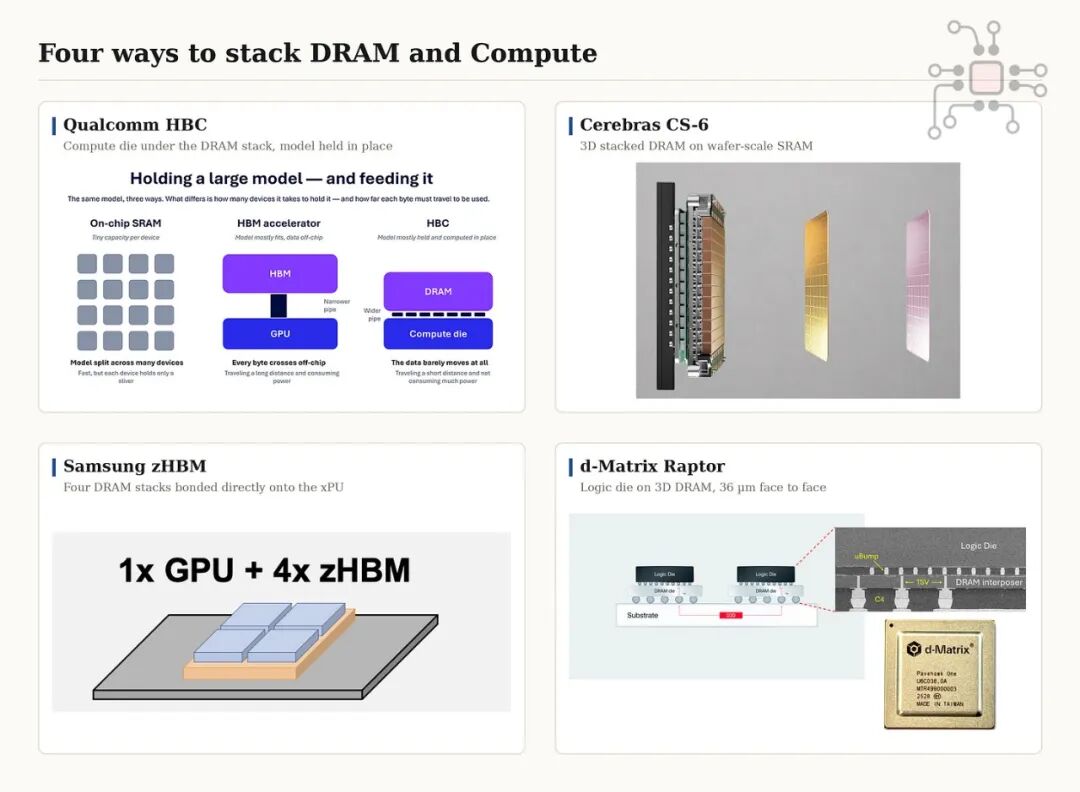
3D-DRAM ermöglicht die beste und leistungsstärkste Architektur
Der spannendste Teil der diesjährigen GTC-Konferenz von Nvidia war das Kamingespräch zwischen zwei Giganten der Technologiebranche – Bill Dally, Chefwissenschaftler von Nvidia, und Jeff Dean, ehemaliger Chefwissenschaftler von Google DeepMind. Beide haben einen unschätzbaren Beitrag zur modernen Informatik geleistet. Unter allen Themen, die sie besprachen, blieb eine Ansicht immer in ihren Köpfen: Die energieeffizienteste und leistungsstärkste Methode zur Verarbeitung von Berechnungen besteht darin, Daten neben den Tensor-Engines zu platzieren und sie möglichst wenig zu bewegen.
„Normalerweise erfordert eine Multiply-Add-Operation für NVFP4 eine Energie von 10 Femtojoule, während das Lesen dieser 4 Bit Daten aus HBM4 (mit einem Energieverbrauch von 3-4 Pikojoule pro Bit) etwa 15 Pikojoule erfordert. Das bedeutet, dass der Energieverbrauch für das Lesen eines NVFP4-Werts aus dem externen Speicher 1000 Mal so hoch ist wie für die Durchführung einer Multiply-Add-Operation. Aber das Lesen von SRAM erfordert nur etwa 10 Femtojoule Energie. Der Schlüssel zur Senkung des Energieverbrauchs liegt darin, die Datenübertragung zu vermeiden.“ Billy Dally, GTC 2026
Dies ist im Grunde das Architekturkonzept hinter Beschleunigern wie Groq, Cerebras und d-Matrix: SRAM befindet sich am selben Ort wie die Recheneinheiten. Obwohl SRAM in Bezug auf Bandbreite, Latenz und Energieverbrauch pro Bit deutlich besser als DRAM ist, reicht seine Kapazität schnell nicht mehr aus. 3D-DRAM ist der einzige Weg, um den Sprung in die nächste Stufe zu schaffen, der die SRAM-ähnliche Bandbreite beibehält und gleichzeitig die Kapazität um eine Größenordnung erhöht.
Ähnlich wie bei der auf SRAM basierenden Architektur kann bei 3D-DRAM jeder Tensor-Kern über einen eigenen dedizierten Speicherblock verfügen und über dedizierte Leitungen Lese- und Schreibvorgänge durchführen. Diese Kapazität und Bandbreite gehört vollständig dem jeweiligen Tensor-Kern, was sich von HBM unterscheidet, bei dem der Speicher normalerweise als ein einheitlicher Pool betrachtet wird, auf den alle Tensor-Kerne gemeinsam zugreifen.
Jeff Dean verglich diese ideale Architektur mit gestapeltem DRAM auf der Rechenebene mit einem Flipperautomaten: Man öffnet die Schleusen, und die Daten fallen wie Schneebälle auf die dedizierten Tensor-Kerne.
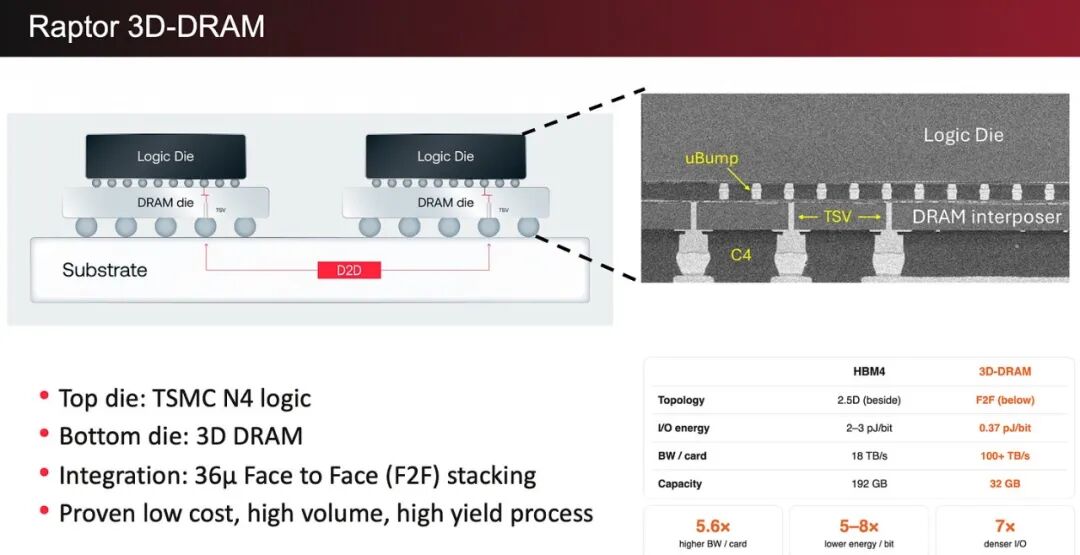
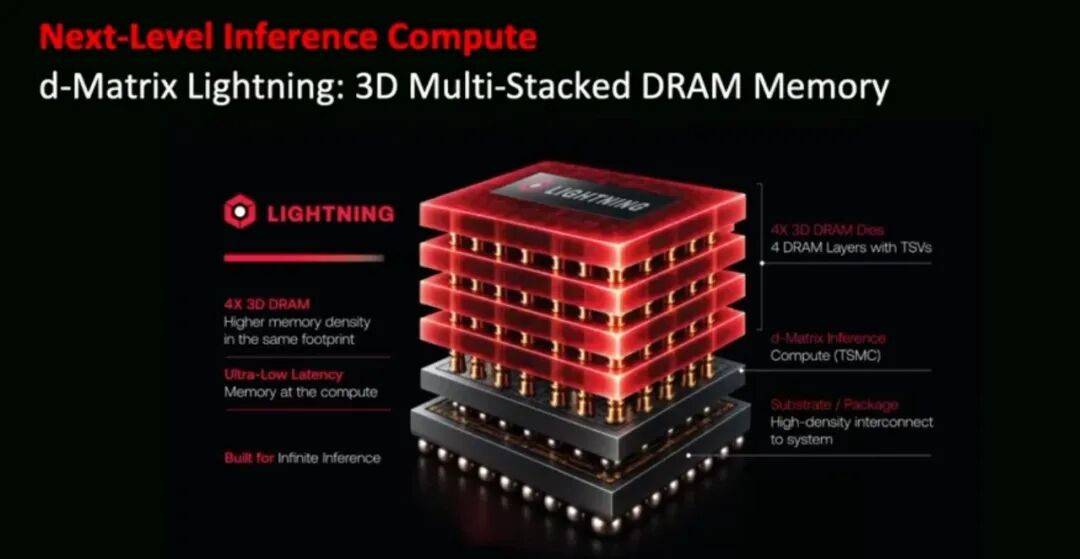
Werfen wir nun einen genauen Blick auf den Raptor-Beschleuniger, den d-Matrix auf der Hot Chips-Konferenz vorgestellt hat. Er ist der erste 3D-DRAM-Beschleuniger, zu dem eine große Menge detaillierter Informationen veröffentlicht wurde.
Gehäusearchitektur: Jedes Raptor-Gehäuse enthält 4 Chips.
Chiplet-Design: Jeder Chiplet in diesem Gehäuse hat eine „Sandwich“-Struktur, die aus einem Rechenchip und einem gestapelten DRAM-Chip besteht.
Rechenanordnung: Jeder Chip verfügt über 256 Tensor-Engines, denen jeweils 3 dedizierte DRAM-Bänke zugewiesen sind, mit dedizierten Leitungen für Lese- und Schreibvorgänge.
Interkonnektion: Jede DRAM-Bank verfügt über einen 256-Bit-Bus. Das bedeutet, dass auf einem einzelnen Chip 196.000 Datenkanäle zwischen Recheneinheiten und Speichereinheiten vorhanden sind. Daher verfügt jede Tensor-Engine über einen 768-Bit-Bus, der mit ihrem dedizierten DRAM verbunden ist.
One Raptor Chiplet = 256 Tensor Cores x 3 banks x 256 bit-bus/bank = 196K data lanes
One Raptor Package =4 chiplets x 196K = ~800K data lanes
Im Vergleich dazu verfügt die GPU im Blackwell-Gehäuse nur über 8.000 Datenkanäle zwischen sich und ihren 8 HBM3E-Stapeln, und das Rubin-Gehäuse mit 8 HBM4-Stapeln verfügt nur über 16.000 Datenkanäle.
Der Vorteil einer um eine Größenordnung erhöhten Kanalanzahl liegt darin, dass jeder Kanal mit einer niedrigeren Frequenz von etwa 500-700 MHz betrieben werden kann, ohne die Bandbreite von über 11 Gbps pro Pin zu benötigen, wie bei HBM4, sowie die daraus resultierenden Probleme bei der Signalintegrität/Leistungsintegrität (SI/PI) und der Komplexität des Designs. Der Betrieb von 196.000 Kanälen bei einer so niedrigen Frequenz hat einen weiteren großen Vorteil, den wir im nächsten Abschnitt ausführlich erläutern werden.
Was die Zahlen angeht,
1. d-Matrix gibt an, dass seine Leistung auf jedem Chippaar (8 Chipsätze) basiert, wie in der folgenden Abbildung gezeigt. Dieses Chippaar kann eine Speicherbandbreite von über 100 TB/s bereitstellen;
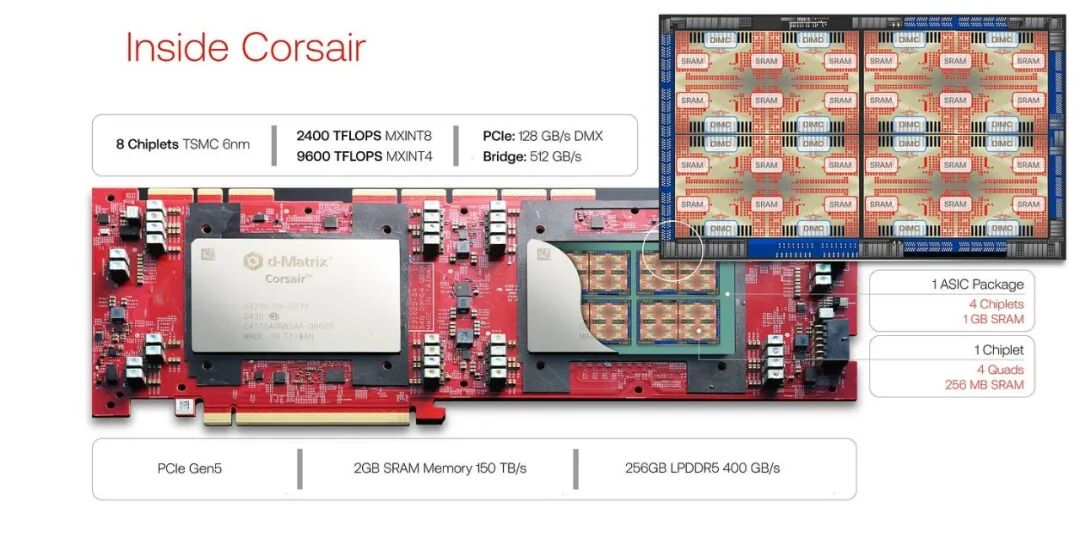
2. Im Vergleich zu den 2 GB SRAM der ersten Generation von Corsair-Beschleunigerkarten wird Raptor mit 32 GB gestapeltem DRAM ausgestattet;
3. Auf Rakebene bieten 18 Rechenschächte mit jeweils 8 Raptor-Gehäusen insgesamt eine 3D-DRAM-Kapazität von 2,3 TB und eine Speicherbandbreite von 7,2 PB/s. Im Vergleich dazu hat ein NVL-Rack mit 72 Rubin-GPUs eine HBM4-Bandbreite von 1,6 PB/s;
Und das ist erst die erste Generation von auf 3D-DRAM basierenden Beschleunigern.
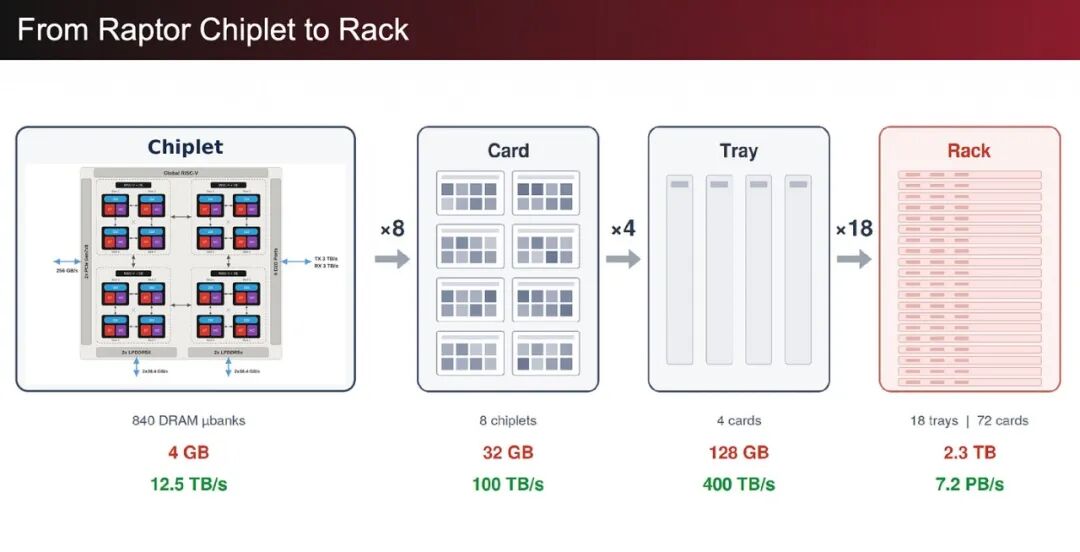
Der Kernpunkt ist: Mehrere Unternehmen haben die Vorteile von auf SRAM basierenden Inferenzbeschleunigern ausführlich erläutert. Aus Sicht der Entwicklungsroadmap ist 3D-DRAM der einzige Weg, um den nächsten Sprung zu schaffen, der die SRAM-ähnliche Bandbreite beibehält und gleichzeitig die Kapazität erhöht.
3D-DRAM senkt den Stromverbrauch auf < 0,1 pJ/Bit
Der Aspekt des Stromverbrauchs ist eigentlich leicht zu verstehen.
Bei HBM ist der Energieverbrauch der DRAM-Array selbst kein Problem. Das eigentliche Problem liegt in der Übertragung von Daten zwischen dem Speicherstapel und dem Rechenchip über das Zwischenschicht-Substrat. Um eine so große Kapazität zu überwinden, werden leistungsstarke Treiber benötigt, und jeder Abschnitt auf dem Pfad erhöht den Energieverbrauch – Daten laufen quer durch das HBM-Substrat zu den Bumps, hinunter durch das Zwischenschicht-Substrat, wieder hinauf zu den Bumps des Rechenchips und dann wieder quer durch den Rechenchip zum Zielort. Alle diese Schritte summieren sich zu einem Energieverbrauch von etwa 2,5 pJ pro Bit.
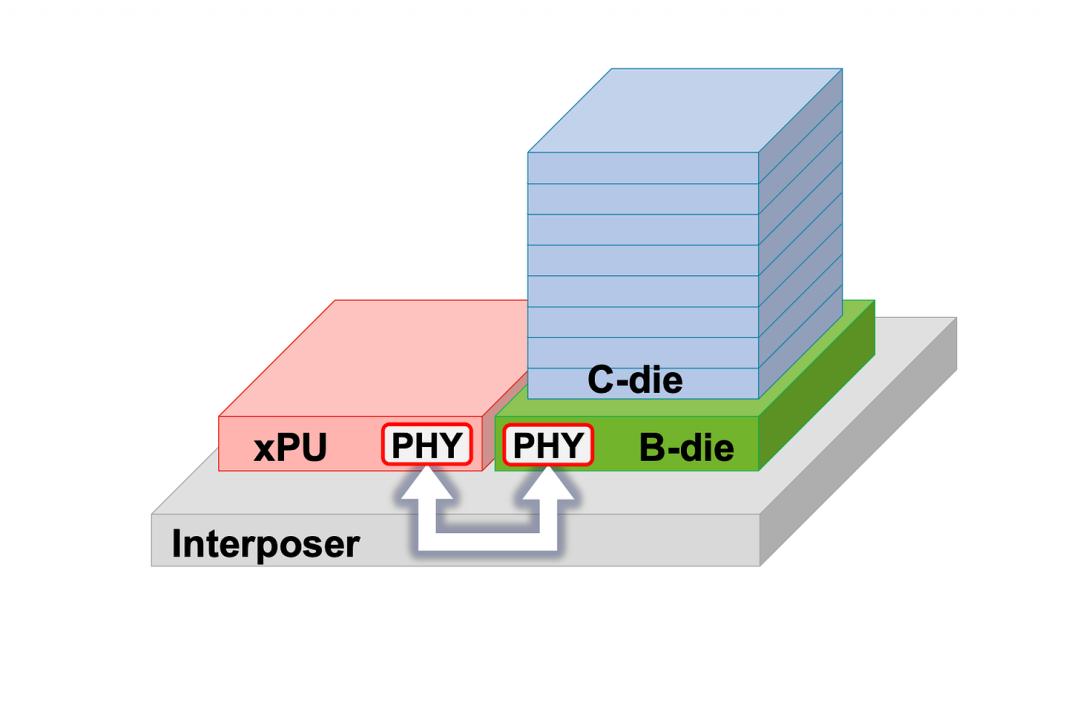
Wenn DRAM direkt auf dem Rechenchip gestapelt wird, ist leicht vorstellbar, wie kurz die Übertragungsdistanz der Daten von der DRAM-Bitzelle zum Ausführungspunkt der Berechnungen ist. Dadurch entfällt das Zwischenschicht-Substrat vollständig, und der Stromverbrauch sinkt auf 0,35-0,4 pJ/Bit.
Um den Unterschied zwischen 2,5 pJ/Bit und 0,4 pJ/Bit intuitiver zu verstehen, können wir ihn mit der Bandbreite multiplizieren und in Watt umrechnen. Das Extrahieren von 100 TB/s Daten aus einem HBM-Stapel erfordert einen Stromverbrauch von 2000 W, während das Extrahieren aus 3D-DRAM 296 W erfordert. Denken Sie genau darüber nach: Der Stromverbrauch für das Extrahieren von 100 TB/s Daten aus HBM ist um eine Größenordnung höher als bei 3D-DRAM. Die Herleitung dieser Zahlen wird im Folgenden ausführlich erläutert.
HBM power for 100TB/s = 2.5 pJ/bitx 100 TB/s x 8 bits = 2000W
3DD power for 100TB/s = 0.37 pJ/bit x 100 TB/s x 8 bits = 296W
Dies zeigt sich auch in der zHBM-Präsentation von Samsung. Sie haben nachgewiesen, dass der durch zHBM eingesparte Stromverbrauch in einem 1200-W-GPU-System zur Erhöhung der Rechenkapazität verwendet werden kann.
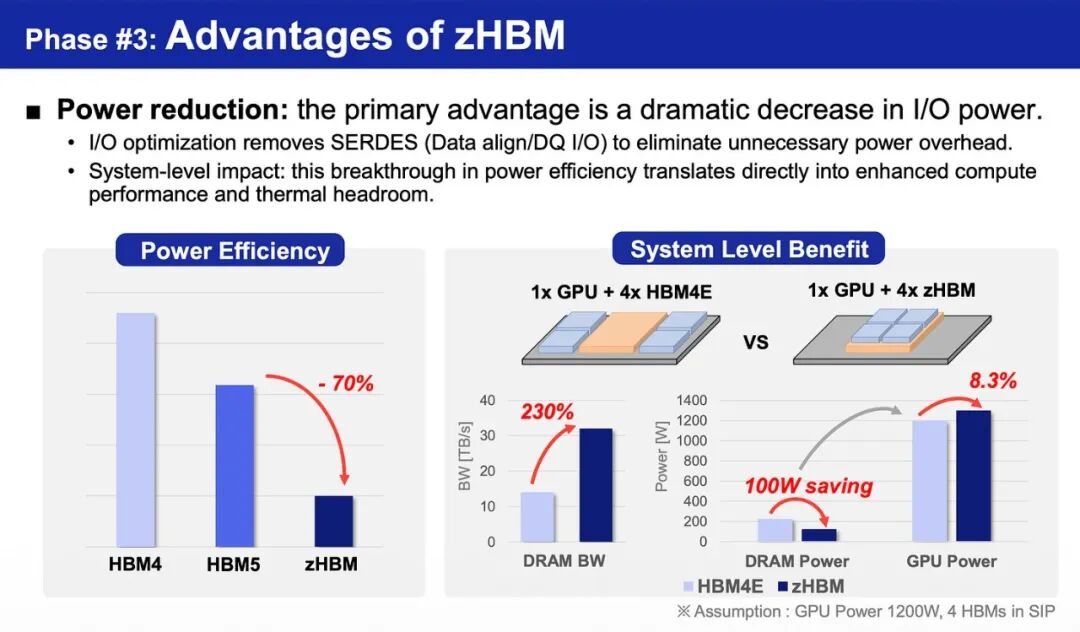
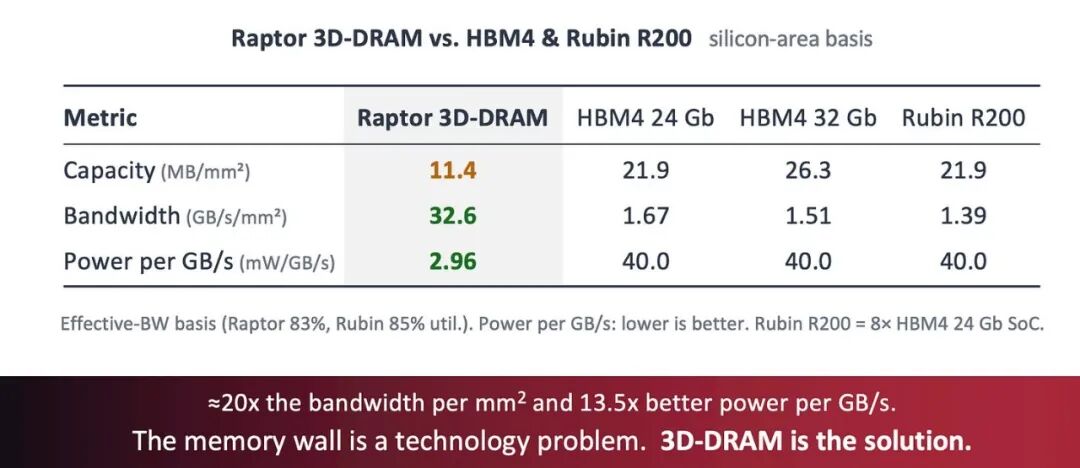
Aber der Kernpunkt ist, dass 0,37 pJ/Bit nicht der Mindestwert ist.
Raptor verbindet die beiden Chips mit Mikro-Bumps im Abstand von 36 Mikrometern. Neben einem so kleinen Pad erscheint ein 4-Nanometer-Transistortreiber sehr klein, während das Pad, sein elektrostatischer Entladungsschutz und die Leitungen zum Pad nach On-Chip-Standards eine größere Kapazität bilden. Auf der DRAM-Seite ist die Situation ähnlich.
Die Hybrid-Bonding-Technologie verkleinert die Chipgrößen erheblich. Der Pin-Abstand verringert sich von 36 Mikrometern auf einzelne Mikrometer, und die Pad-Größe verkleinert sich entsprechend. Die Leitungslänge zwischen dem Treiber im Rechenchip und dem DRAM wird stark verkürzt, und die Kapazität sinkt entsprechend. Dadurch wird der Energieverbrauch weiter von etwa 0,4 pJ/Bit auf etwa 0,1 pJ/Bit gesenkt.
Die Deterministik von 3D-DRAM
Gut, der letzte Teil meiner Darstellung ist: DRAM ist berüchtigt für seine Unbestimmtheit.
HBM, LPDDR und ähnliche Speicher durchlaufen beim Start einen Initialisierungsprozess, der als Training und Kalibrierung bezeichnet wird. Während dieses Prozesses führt das HBM-PHY auf dem Rechenchip Lesezentrierungs- und Schreibzentrierungsalgorithmen aus. Es schreibt vordefinierte Muster in den Speicher, liest diese Muster zurück und scannt den Phasenrotator auf jedem Kanal, um das Zentrum des Datenauges zu finden. Ich habe diesen Prozess hier vereinfacht beschrieben. Wenn Sie daran interessiert sind, habe ich die Details in anderen Artikeln ausführlich erläutert.
Das Training ist erst der Anfang. Nach dem Start gibt es drei Dinge, die dazu führen, dass DRAM sich unbestimmt verhält.
1. Änderungen von Spannung und Temperatur führen zu einer Verschiebung des optimalen Augendiagramms, sodass das PHY