Das heiße Geld und die Zukunft der KI gehören in diesem Moment den chinesischen Pendants von Alexandr Wang.
Ein etwa ein Jahr altes Unternehmen steht an einem Verhandlungstisch mit einer Bewertung von 2,5 Milliarden US-Dollar.
Im September berichteten ausländische Medien, dass Alibaba die Lead-Runde einer 300-Millionen-Dollar-Finanzierung für UniPat, ein Unternehmen für KI-Training und -Bewertung, übernehmen will. Die Bewertung in dieser Runde beträgt etwa 2,5 Milliarden US-Dollar, und Investoren wie Tencent und HSG haben ebenfalls Interesse an einer Teilnahme geäußert.
Diese Zahl gehörte einst zu den Star-Projekten der beiden vorherigen KI-Gründungsbooms: Moonshot AI, das hinter Kimi steht, erreichte eine Bewertung von etwa 2,5 Milliarden US-Dollar, als es etwa ein Jahr alt war; das Unternehmen hinter dem KI-Programmierungstool Cursor erreichte diese Bewertungsstufe, als es etwa zwei Jahre alt war.
Das eine baut große Modelle auf, das andere war die heißeste Fähigkeitsrichtung der letzten Jahre. Dieses Mal handelt es sich um ein Unternehmen, das Trainingsdaten und Bewertungsdienste für Modelle bereitstellt.
Zuvor arbeitete Li Kuan, Gründer von UniPat, im Tongyi AI-Labor von Alibaba an Nachschulungsanalysen, Datensynthese und verstärktem Lernen.
Das Interessante an dieser Kombination ist: Mitarbeiter, die aus Modellteams stammen, beginnen, Trainingsmaterialien für Modellteams herzustellen, während große Technologieunternehmen in der Liste der Investoren auftauchen.
In den Vereinigten Staaten gab es bereits eine ikonische Persönlichkeit mit einer "umgekehrten" Laufbahn. 2016 gründeten Alexandr Wang und Lucy Guo gemeinsam Scale AI, das mit der Datenannotierung für autonomes Fahren begann und schrittweise in das Geschäft mit Trainingsdaten und Bewertungen für große Modelle einstieg. Als Meta 2025 Anteile erwarb, betrug die Bewertung von Scale über 29 Milliarden US-Dollar, und Wang wechselte zu Meta. Er hat bereits gezeigt, wie nah ein Datenanbieter am Kern der Modelle stehen kann.
In China gibt es natürlich auch Datenunternehmen: Firmen wie Haitian Ruisheng bieten bereits seit langem Datenerfassungs-, Annotierungs- und Datendienste für große Modelle an. Die neue Entwicklung heute ist, dass Personen, die direkt an der Nachschulung von Modellen, Agent-Produkten und internen Bewertungen beteiligt waren, nun selbst in dieses Geschäft einsteigen.
Neben UniPat haben ehemalige Mitarbeiter von MiniMax Copula Lab gegründet; das Kernteam von Intelligent Knowledge stammt aus dem Seed-Team von ByteDance.
Die Chance, die sie gemeinsam erkennen, ist: Je näher Modelle an der realen Arbeitswelt sind, desto schwieriger ist es, die für das Training benötigten Daten aus vorhandenen Inhalten im Internet zu finden.
Die intelligente Produktion und Fertigung erstreckt sich zunehmend auf Datenunternehmen. Große Technologieunternehmen kommen mit Beschaffungsbedarf, Investoren suchen eifrig nach Zielobjekten, und Mitarbeiter aus Modellteams machen sich selbstständig.
Die "Prüfer", die im Inneren der Basismodelle arbeiteten, gründen nacheinander eigene Unternehmen
Aus den früheren Forschungsarbeiten des UniPat-Teams lässt sich der Ursprung dieses Geschäfts ableiten.
Bevor er Gründer wurde, arbeitete Li Kuan im Tongyi AI-Labor an Nachschulung, Datensynthese und verstärktem Lernen und begann bereits zu erforschen, wie man schwierige Aufgaben für Modelle entwickelt.
In dem im Juli 2025 veröffentlichten WebSailor-Papier war er der Erstautor und einer der drei Projektleiter. Das Team synthetisierte komplexe Suchaufgaben, um Modelle zu lehren, Beweise zu finden, Tools aufzurufen und kontinuierlich zu schlussfolgern, und erforschte, wie durch verstärktes Lernen die Fähigkeit von Agenten zur Ausführung von Aufgaben verbessert werden kann.
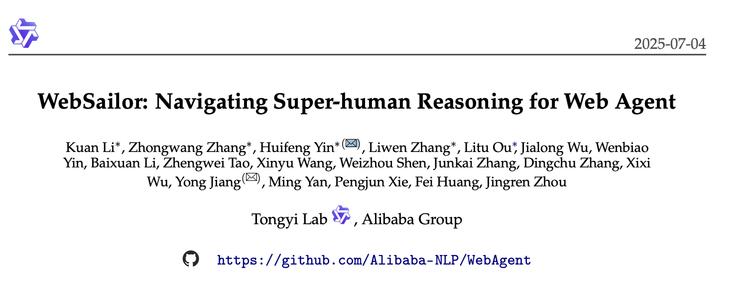
Yin Huifeng, der ebenfalls Projektleiter von WebSailor war, wurde später Mitglied von UniPat.
Der Mitbegründer und CTO Chen Liang forschte zuvor in den Multimodal-Teams von Qwen und Moonshot AI, und auf seiner persönlichen akademischen Homepage wurde bereits im August 2025 die Nachricht über die Gründung eines Unternehmens für Agent-Daten und Umgebungen für verstärktes Lernen aufgezeichnet.
Dieses Team beherrscht die Methode, Aufgaben rund um die fehlenden Fähigkeiten von Modellen zu entwickeln und diese Aufgaben dann zum Trainieren und Prüfen der Modelle zu nutzen. Nach der Gründung des Unternehmens wurden diese Forschungserfahrungen durch eine Reihe von öffentlichen Bewertungen präsentiert.
In diesem Januar veröffentlichte UniPat BabyVision, um die grundlegende visuelle Denkfähigkeit von Modellen zu prüfen. Im Mai testete Terminal-X die Fähigkeit von Programmier-Agenten, komplexe technische Aufgaben zu lösen, auf mehrfache Anforderungsänderungen zu reagieren und Versionsupdates durchzuführen; ExpertEval bewertete die fachliche Urteilskraft in medizinischen, finanziellen und rechtlichen Szenarien; SaaS-Bench prüfte, ob Agenten mehrere Geschäftssoftware durchlaufen können, um einen vollständigen Arbeitsablauf abzuschließen; das im Juli veröffentlichte Vibe-Coding Arena holte zudem echte Experten ein, um in mehrfachen Programmierzusammenarbeiten zu bewerten, wie Agenten Anforderungen verstehen, Feedback annehmen und Fehler korrigieren.
Die Prüfungsaufgaben entwickeln sich von "ob die Antwort richtig ist" hin zu "vielfältigen realen Arbeitsaufgaben".
Papiere und Benchmarks waren lange Zeit der einzige Weg für die Außenwelt, UniPat kennenzulernen.
Diese Zurückhaltung ist auch die gemeinsame Tendenz dieser neuen Welle von Daten-Startups: Sie sind bereit, über Technologie zu sprechen, erwähnen aber selten konkrete Geschäfte. Schließlich können Forschungsergebnisse öffentlich sein, aber für wen welche Fähigkeiten ergänzt werden, wie Daten hergestellt werden und wie die Abnahme erfolgt, betrifft bereits die Forschungsrichtung der Kunden und die eigenen geschäftlichen Barrieren.
Ein beteiligter Praktiker sagte uns, dass obwohl die Nachricht über die Finanzierung erst kürzlich bekannt wurde, UniPat tatsächlich bereits mehrere Finanzierungsrunden absolviert hat. Alibaba als der in dieser Runde bekanntgegebene Lead-Investor stellt sowohl Kapital als auch Rechenleistung zur Verfügung, wobei das Volumen der Rechenleistung jährlich mehrere zehn Millionen Yuan beträgt.
Ein anderer Praktiker erläuterte, dass die Zusammenarbeit zwischen UniPat und Alibaba sich hauptsächlich auf Nachschulungsdaten für verstärktes Lernen konzentriert, einschließlich Programmierabläufen und Mehrfach-Tool-Aufgaben unter verschiedenen Betriebsframeworks für Agenten. Zuerst werden kostengünstige Trainingsexperimente an kleineren Modellen durchgeführt, um wirksame Datenlösungen auszuwählen, dann wird die Produktion und Auslieferung ausgeweitet und die Prüfung an großen Modellen vorgenommen.
Dies ist eine tiefgehende kooperative Anpassung: Kunden kaufen nicht nur Materialien, sondern auch den experimentellen Prozess zur Suche nach wirksamen Materialien. Öffentliche Benchmarks sind nur ein Einstiegspunkt. Unter der Oberfläche versucht UniPat, zu einer externen Quelle für Datenforschung und -entwicklung für Modellanbieter zu werden.
Im Gegensatz zu UniPat, das ebenfalls auf den Datenbedarf von Modellanbietern reagiert, legt Intelligent Knowledge den Schwerpunkt darauf, wie Expertenwissen organisiert und kontinuierlich produziert werden kann.
Der Gründer und CEO Wang Sheyang war zuvor verantwortlich für die Datenarchitektur des Seed-Modells bei ByteDance und arbeitete auch an der Datentechnik für das medizinische große Modell von Douyin; der CTO Li Kuanye war ehemaliger Dateningenieur für Basismodelle bei ByteDance und arbeitete an der Datensynthese für verstärktes Lernen und dem Aufbau von Umgebungen.
Im Mai 2025 stellte Wang Sheyang öffentlich fest, dass qualitativ hochwertige Experten-Daten immer wichtiger werden, aber benutzerfreundliche Produktionswerkzeuge noch immer hauptsächlich in großen Technologieunternehmen verfügbar sind. Daher nutzt Intelligent Knowledge die Plattform "Yimian Qianshi", um Experten zu suchen, auszuwählen und zu organisieren, und unterstützt dann die Aufgabenproduktion und Qualitätskontrolle mit Xpert Studio. Im Juni dieses Jahres gab das Unternehmen bekannt, dass es Investitionen von Jinqiu Fund und Yaotu Capital erhalten hat.
Aus den Ansatzpunkten dieser beiden Unternehmen lassen sich die unterschiedlichen Verwendungsmöglichkeiten von internen Modellerfahrungen erkennen: UniPat ist näher an Modenexperimenten, während Intelligent Knowledge näher an Produktionsszenarien ist.
Copula Lab, das in diesem Jahr von ehemaligen Mitarbeitern von MiniMax gegründet wurde, verfügt ebenfalls über einen ähnlichen Erfahrungshintergrund im Team.
Eine mit dem Unternehmen vertraute Person erwähnte, dass Gründer Liang Li in der ersten Hälfte dieses Jahres das Unternehmen verließ, um sich selbstständig zu machen. Zuvor war sie verantwortlich für das Agent-Geschäft von MiniMax und baute die interne Bewertung auf; der technische Mitbegründer Cai Jiaren war früher Open-Source-Leiter bei MiniMax und Algorithmus-Ingenieur für Nachschulungsdaten und beteiligte sich an der Konstruktion von Nachschulungsdaten für den Programmierbereich der M2-Modellreihe.
Ihre Erfahrungen verbinden Produkte und Modelle: Auf der einen Seite muss beurteilt werden, ob die Arbeit des Benutzers abgeschlossen ist, auf der anderen Seite muss diese Beurteilung in Trainingsziele umgewandelt werden. Nach unseren Informationen hat Copula Lab ebenfalls bereits Investitionen erhalten.
Modellerfahrung, Nachschulungsszenarien und boomende Finanzierung bilden die drei Merkmale der heutigen neuen Datenunternehmen.
Dies bietet auch eine neue Möglichkeit der Arbeitsteilung in der Branche: Modellanbieter behalten das Kerntraining bei und überlassen die Datenproduktion, die mehrere Szenarien abdeckt und ständig aktualisiert werden muss, externen Partnern, die sie selbst "herangebildet" haben; Gründer wandeln die Erfahrung aus der Betreuung eines einzigen Labors in Produkte um, die mehreren Parteien dienen.
Modelle beginnen, "Fähigkeiten zu kaufen", das Daten-Geschäft verändert sich
Hinter diesem Phänomen steht ein größerer Hintergrund: Die Logik, nach der Modellanbieter Daten kaufen, verändert sich gerade: Früher kauften sie hauptsächlich Trainingsmaterialien, heute wollen sie direkt die Verbesserung der Fähigkeiten erwerben.
Ein Forscher, der für die Modellbewertung verantwortlich ist und auch an der Nachschulung teilnimmt, gab uns ein Beispiel: Wenn ein Satz von Daten keine Änderung der Modellarchitektur erfordert und nach der Nachschulung die Leistung in Programmier-Ranglisten um drei Punkte steigt, "würden Sie es kaufen? Sie würden es auf jeden Fall kaufen."
Diese drei Punkte sind sowohl eine Leistung, die der Außenwelt gezeigt wird, als auch eine interne Grundlage zur Bewertung der F&E-Effekte.
Zum Beispiel baut das Modellteam einen "Fähigkeitsbaum", listet die Fähigkeiten auf, die das Modell entwickeln soll, und die Ranglisten, die es erreichen will, und sucht dann nach entsprechenden Trainingsmaterialien. Für Bereiche, die von öffentlichen Daten nicht abgedeckt werden, werden Daten gekauft oder selbst hergestellt: Die Aufgaben finden, bei denen das Modell versagt, neue, schwierigere Aufgaben rund um die fehlenden Fähigkeiten entwickeln, dann erneut trainieren und erneut bewerten.
Ranglisten werden dadurch gleichzeitig zu Zeugnissen, Trainingsplänen und Einkaufsleitfäden.
Das ist auch der Grund, warum Benchmarks zu einem wichtigen Einstiegspunkt für diese neue Welle von Datenunternehmen werden. Eine Bewertung, die gemeinsame Schwachstellen aufdeckt, oder ein Modell, das bei einer bestimmten Art von Aufgaben deutliche Fortschritte macht, kann andere Teams dazu bringen, nach Daten zu suchen, die ähnliche Verbesserungen bewirken können.
Aber um diese Nachfrage zu befriedigen, müssen Datenanbieter komplexere Aufgaben bewältigen.
Agenten sollen lernen, wie man Arbeit erledigt. Im Internet gibt es eine große Menge an Code, aber es wird nicht automatisch der vollständige Ablauf der Bearbeitung eines Softwarefehlers mitgeliefert: wie man das Problem lokalisiert, Tools aufruft, fehlgeschlagene Versuche korrigiert, es erneut versucht und schließlich bestätigt, dass das Problem behoben ist.
Neue Datenprodukte enthalten daher gleichzeitig Aufgaben, Betriebsabläufe, Ausführungsumgebungen und Bewertungsstandards. Nehmen wir das von Intelligent Knowledge veröffentlichte Terminal RL Data als Beispiel: Es liefert nicht nur Aufgaben, sondern auch Softwareumgebungen, Testskripte und Referenzlösungen, sodass das Modell die Aufgaben tatsächlich ausführen kann und die Ergebnisse durch Tests überprüft werden.
Die Maßnahmen ausländischer Unternehmen zeigen diese Veränderung bereits.
Im Februar 2026 gab Scale AI an, dass fast die Hälfte der neuen Datentrainingsprojekte Umgebungen für verstärktes Lernen betreffen; im Juli kündigte Mercor die Übernahme von Deeptune an, um sein eigenes Expertennetzwerk mit der Fähigkeit des anderen zur Rekonstruktion von Unternehmenssoftware und zum Aufbau von Trainingsumgebungen zu verbinden.
Diese Datennachfrage erklärt zwei Dinge: Warum sich diese neue Welle von Gründern hauptsächlich aus Modellunternehmen rekrutiert, und warum Modellanbieter eine externe Datenversorgungsschicht benötigen.
Der Vorteil der "UniPats" besteht nicht nur darin, dass sie die Einkäufer kennen, sondern dass sie selbst die Nachfrageseite waren: Sie wissen, wie die Schwachstellen von Modellen erkannt werden, wie eine Aufgabe in Trainingsmaterial umgewandelt wird und wie Experimente zur Bewertung der Wirkung entwickelt werden.
Gleichzeitig steigen die Kosten für die wiederholte Organisation von Experten und den Aufbau von Systemen, je mehr Branchen betroffen sind. Im Vergleich zu internen Abteilungen von Modellanbietern haben externe Unternehmen die Möglichkeit, Werkzeuge, Expertennetzwerke und Umgebungen wiederzuverwenden, die Fähigkeiten, die sie bei einem Projekt erworben haben, in die nächste Lieferung einzubringen und diese durch mehrfachen Verkauf zu amortisieren.
Derzeit wächst der Bedarf großer Technologieunternehmen an Nachschulungsdaten viel schneller als die Produktionsgeschwindigkeit von qualitativ hochwertigen Angeboten.
Mehrere Praktiker beschreiben dieses Geschäft als "extrem profitabel": Obwohl es eine große Menge an Vortrainingskorpora gibt, sind Daten in der Nachschulung, die die Schwachstellen von Modellen direkt beheben können, noch viel knapper. Nach ihren Erfahrungen können 10.000 bis 100.000 qualitativ hochwertige Datensätze für eine bestimmte Fähigkeit eine deutliche Verbesserung der Nachschulung bewirken.
Dadurch rücken die Produktpreise und die Unternehmensbewertung von Datenunternehmen immer näher an den F&E-Wert heran.
Die Erkenntnis, die Alexand