Zweiwöchentliche Iterationen, Preise ab 1.000 US-Dollar: Dieses Unternehmen will Post-Training für „jedermann zugänglich“ machen.
In den letzten Monaten ist das Post-Training zum zentralen Thema in der KI-Branche geworden.
Unternehmen für Basismodelle erweitern den Umfang von RL; Anwendungsunternehmen überlegen auch, wie sie ihre eigenen Post-Training-Prozesse auf der Grundlage von Aufgabenverläufen und Nutzerfeedback aus dem realen Geschäftsbetrieb aufbauen können.
Sie weisen auf dieselbe Veränderung hin: Die Erfahrungen, die Modelle in realen Umgebungen sammeln, werden zu Rohstoffen für die nächste Generation von Intelligenz.
Dies führt auch zu einem anomalen Phänomen.
Die aktivsten Open-Source-Modelle der Welt stammen aus China, aber die Drittanbieter-Plattformen für Post-Training, die sich um diese Modelle bilden, entwickeln sich im Ausland schneller.
Thinking Machines Labs Tinker, Fireworks, Together AI, Prime Intellect und Applied Compute sind bereits aus verschiedenen Positionen in diesen Markt eingetreten, aber es gibt nur wenige unabhängige Plattformen in China mit einer ähnlichen Positionierung.
Jetzt macht Mind Lab genau das.
Diesen Juli veröffentlichte es Macaron V1 auf Basis von GLM-5.2; am 23. September veröffentlichte es dann Macaron V1.1 auf Basis von GLM-5.3 und führte gleichzeitig die Post-Training-Plattform Mint Recursive ein, die hinter V1.1 steht.
Laut offiziellen Angaben von Mind Lab unterstützt Mint Recursive als unternehmensorientierte Post-Training- und Inferenzplattform Open-Source-Modellreihen wie GLM, Qwen, DeepSeek, Kimi und MiniMax. Derzeit gibt es drei Kooperationsformen: gemeinsames Training durch FDE-Experten, automatisiertes Training auf der Plattform und eigenständiges Training durch Unternehmen.
Für ein Neo Lab in einem kommerziellen Unternehmen ist dieser Schritt sehr praktisch: Nachdem sie einige technische Ergebnisse erzielt haben, wollen sie von Papern und Laboren zur Markteinführung übergehen.
Macaron V1 beweist, dass Mind Lab „sein eigenes Modell“ nachtrainieren kann, während Mint Recursive nun die Frage beantwortet, ob es diese Fähigkeit an mehr Unternehmen weitergeben kann.
1
Nach der Veröffentlichung des Modells beginnt das Lernen erst
Sehen wir uns zuerst das neu veröffentlichte Modell an.
In Fortführung der Idee von V1 ist Macaron V1.1 ein Modell mit 752B Parametern, das aus den 744B Basisgewichten von GLM-5.3 und vier Gruppen von LoRA mit jeweils etwa 2B besteht, die jeweils für Chat, Agent, Codierung und generatives UI zuständig sind.
Die von Mind Lab veröffentlichten Testergebnisse zeigen, dass V1.1 bei allen 7 Bewertungen höhere Punktzahlen erzielt als das ursprüngliche GLM-5.3; und auf den Drittanbieter-Ranglisten DeepSWE v1.1, SWE-Marathon und AutomationBench hat es Opus 5 übertroffen oder gleichgezogen.
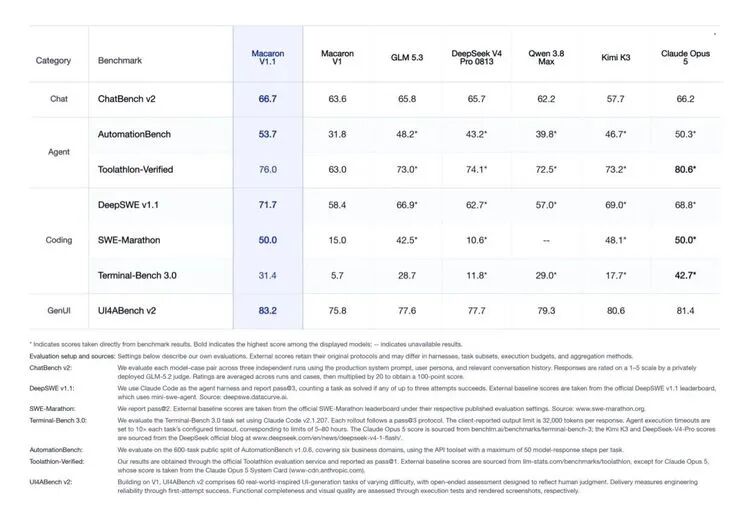
Diese Laufzeitwerte zeigen anschaulich, dass die hinzugefügten etwa 8B Parameter die Leistung des Modells tatsächlich verbessert haben. Was genau es an der Leistung verändert hat, zeigt auch, welche Probleme Mind Lab seiner Meinung nach das Modell lösen muss.
Bei langwierigen Codierungsaufgaben benötigt V1.1 weniger Schritte und Token, um die Aufgabe abzuschließen. Der Kernansatz besteht darin, SWE-Verläufe auf Datenebene in fünf Phasen zu standardisieren – Reproduktion, Lokalisierung, Bearbeitung, Überprüfung und Wiederherstellung – um Erkundungsrunden mit geringer Relevanz zu reduzieren.
In komplexen Büroumgebungen hat V1.1 insbesondere die Sicherheit beim Aufruf von Werkzeugen verstärkt. Das Modell soll nicht nur wissen, wie man Werkzeuge aufruft, sondern auch wissen, wann es nicht eingreifen soll, um zu vermeiden, dass es die Absichten und den Autorisierungsbereich des Nutzers überschreitet.
Diese Änderungen entsprechen genau den häufigsten Problemen, auf die Unternehmen bei der Verwendung von Modellen stoßen. Mit Mint Recursive hat Mind Lab diese Runde der Modellaktualisierung in nur zwei Wochen abgeschlossen.
Die Logik von Mint Recursive ist nicht kompliziert: Sie teilt eine Modellaktualisierung in mehrere Schritte auf – Bewertung, Datenvorbereitung, Training, erneute Bewertung und Bereitstellung – sodass das Post-Training wiederholt nach demselben Prozess ablaufen kann.
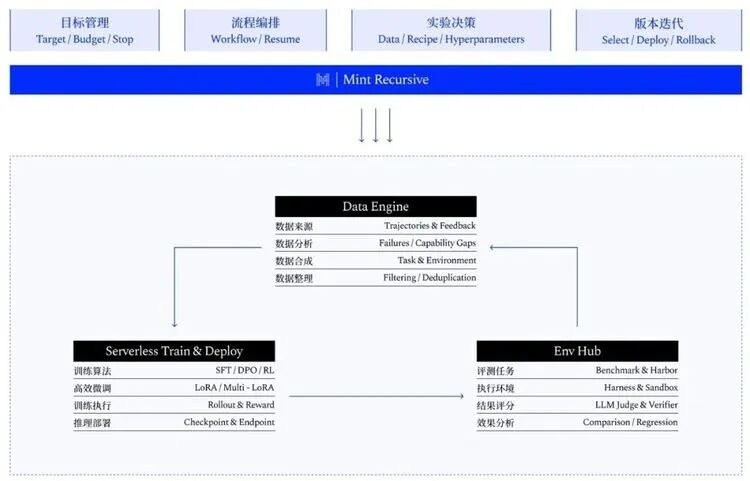
Laut offizieller Angabe ist der erste Schritt für Unternehmen bei der Verwendung von Mint Recursive, ihr eigenes Benchmark zu erstellen – also eine Reihe von Aufgaben und Kriterien, mit denen beurteilt wird, ob das Modell die Arbeit richtig erledigt hat.
Die Plattform lässt das Basismodell zuerst eine Runde der Benchmark-Bewertung durchlaufen, speichert die Verläufe der Aufgabenausführung und hilft dem Team zu sehen, an welchem Schritt das Modell einen Fehler macht, bevor es entscheidet, welche Probleme durch Post-Training gelöst werden sollen.
Zum Beispiel möchte ein Unternehmen sein eigenes Büro-Agent trainieren. Neben der Frage, ob die Aufgabe abgeschlossen wurde, könnte es auch daran interessiert sein, wie viele Schritte und Token es verwendet hat. Wenn man nur das Endergebnis betrachtet, werden ineffiziente Pfade des Modells leicht übersehen.
Anschließend können Unternehmen vorhandene Daten sortieren oder neue Trainingsbeispiele basierend auf fehlgeschlagenen Aufgabenverläufen erstellen, Trainingsmethoden wie SFT, DPO oder Reinforcement Learning auswählen und je nach Budget und Aufgabenanforderungen entscheiden, ob LoRA oder eine vollständige Parameteraktualisierung verwendet werden soll.
Die neu trainierte Version kann direkt bereitgestellt oder zur Überprüfung an das ursprüngliche Benchmark zurückgeschickt werden. Wenn die Wirkung die Anforderungen erfüllt, wird sie in Betrieb genommen, und die nach der Inbetriebnahme gesammelten Probleme können wiederum Material für die nächste Trainingsrunde werden.
Der Schlüssel dieses Prozesses liegt darin, dass es sich um einen integrierten und nachhaltigen Prozess mit „demselben Maßstab“ handelt.
Das Problem vieler Modelltrainingsprojekte besteht darin, dass vor und nach dem Training unterschiedliche Bewertungsmaßstäbe verwendet werden: Das Datenteam verfolgt eine Wirkung, das Trainingsteam optimiert eine andere Gruppe von Indikatoren, und die Geschäftsabteilung verwendet nach der Inbetriebnahme einen dritten Satz von Standards zur Abnahme.
Mit Mint Recursive können Unternehmen das Modell über den gesamten Lebenszyklus verwalten: Von der Frage, warum es trainiert werden soll, über das, was es trainiert hat, bis hin zu der Version, die gerade in der Produktionsumgebung läuft – es wird kontinuierlich entlang derselben Aufzeichnungen iteriert.
Ein separat trainiertes vertikales Modell verliert schnell an Wert, wenn das Basismodell aktualisiert wird; Ein System, das ständig „die nächste Version“ erzeugen kann, kann erst zu einem langfristigen Vermögenswert werden.
2
Unternehmen die Kontrolle über die Evolutionsrichtung des Modells geben
Dies entspricht auch den aktuellen Anforderungen von Unternehmen.
In der Vergangenheit war eine der zentralen Überlegungen von Unternehmen bei der Verwendung großer Modelle, welche API sie wählen sollten.
Aber nachdem Basismodelle ständig Open-Source werden und die Rangfolge der Modellfähigkeiten sich ständig ändert, wird es immer schwieriger, durch die Auswahl eines bestimmten Modells selbst langfristige Barrieren aufzubauen. Heute ist GLM das am besten geeignete Modell, aber in einigen Monaten könnte es Kimi, Qwen, DeepSeek oder MiniMax sein.
Alle Unternehmen können das Modell austauschen, aber egal wie sie es austauschen, das Wichtigste ist das Verständnis jedes Unternehmens für sein eigenes Geschäft.
Dieser Unterschied ist im Agent-Szenario noch ausgeprägter. Allgemeine Modelle können Werkzeuge aufrufen, verstehen aber nicht unbedingt die Geschäftsregeln, Kostenanforderungen und Autorisierungsgrenzen eines Unternehmens. Unternehmen müssen zunehmend Aufgabenverläufe, Expertenurteile und Nutzerfeedback in Erfahrungen umwandeln, die das Modell lernen kann, um die Verbesserungsrichtung und die Inbetriebnahmestandards des Modells zu kontrollieren.
Aus dieser Perspektive bedient Mint Recursive diese Anforderung auf vier Ebenen: Niedrige Einstiegshürden, hohes Kosten-Leistungs-Verhältnis, nachhaltige Iteration und hohe Freiheitsgrade – sodass Unternehmen einsteigen können, es sich leisten können, es langfristig zu trainieren, und dass professionelle Teams es auf ihre eigene Weise weiter vertiefen können.
Niedrige Einstiegshürden kommen zuerst vom Benchmark.
In der Vergangenheit haben viele Unternehmen bei der Auswahl von APIs bereits interne Aufgabenbanken und Bewertungsstandards angesammelt; In der Phase des Post-Trainings können diese Materialien genau der Ausgangspunkt sein, um zu beurteilen, wo das Modell geändert werden muss und ob es nach dem Training korrekt geändert wurde.
Dies erklärt auch, warum die frühen Kunden von Mint Recursive sich auf Finanzwesen, KI für Wissenschaft und Gesundheitswesen konzentrieren: Sie haben einen hohen Grad an KI-Integration, haben bereits klare Geschäftsregeln, Bewertungsmethoden und Aufgabendaten angesammelt und müssen nicht von Grund auf definieren, was es bedeutet, dass „das Modell die Sache richtig erledigt“.
Die zweite Ebene ist ein hohes Kosten-Leistungs-Verhältnis, sodass Unternehmen es sich leisten können.
Das Training mit vollständigen Parametern ist für die meisten Unternehmen immer noch zu aufwändig. LoRA aktualisiert nur eine kleine Anzahl neuer Parameter, sodass die Wirkung zuerst mit geringem Aufwand überprüft werden kann. Laut der Preisangabe auf der offiziellen Website von Mind Lab beginnen die Preise für spezielle Modelltrainingsdienste bei mindestens 1000 US-Dollar.
Nvidia fasste im Juli dieses Jahres den Kernindikator des Post-Trainings als „Intelligence per Dollar“ zusammen. Unternehmen interessieren sich genau dafür, ob ein begrenztes Budget eine echte Geschäftsverbesserung bringen kann. Auf Mint Recursive können verschiedene LoRAs dasselbe ständig residente Basismodell teilen, Training und Bereitstellung werden nach tatsächlichem Verbrauch abgerechnet, und es muss nicht für jede Geschäftsversion ein vollständiges Modell kopiert werden.
Die dritte Ebene ist die Fähigkeit zur Iteration. Basismodelle iterieren, die Art und Weise, wie Modelle in Unternehmen eingeführt werden, iteriert, und sogar das eigene Geschäft und die Nutzer von Unternehmen iterieren. In Mint Recursive kann jedes LoRA separat trainiert, bewertet, in Betrieb genommen und zurückgezogen werden; Neue Probleme, die in der Produktionsumgebung auftreten, können in die nächste Trainingsrunde einfließen. Alte LoRAs können mit der Aktualisierung des Basismodells veralten, aber das eigene Benchmark, die Daten und die Bewertungsstandards des Unternehmens können weiterhin wirksam bleiben.
Zuletzt, und am wichtigsten, der Freiheitsgrad. Während des gesamten Zyklus kann das Unternehmen das Schema selbst anpassen, sowie Ziele, Budget und Einschränkungen festlegen, damit das System bei der Auswahl von Daten, Algorithmen und Parametern unterstützt.
LoRA ist nur eine der Lösungen, die Mint Recursive bietet. Die Plattform unterstützt gleichzeitig das Training mit vollständigen Parametern und ermöglicht die Auswahl von Methoden wie SFT, DPO und Reinforcement Learning. Unternehmen können Basismodell, Daten, Algorithmus und häufig verwendete Loss direkt konfigurieren oder über Python SDK benutzerdefinierte Verlustfunktionen, Reinforcement-Learning-Umgebungen und Trainingszyklen erstellen, um die ursprünglichen Trainingscodes von verl, TRL, OpenRLHF oder PyTorch zu migrieren.
Erst durch die Kombination dieser Ebenen können Unternehmen mit einem einmaligen Experiment mit kontrollierbaren Kosten beginnen und dann den Trainingsumfang schrittweise entsprechend der Wirkung erweitern.
Mint Recursive ist sich klar darüber: Unternehmen müssen nicht zuerst zu einem Modellanbieter werden, um mit dem Training ihrer eigenen Modelle zu beginnen.
3
Von der Anwendung zum Lab und zurück zum Markt
Oberflächlich gesehen strukturiert Mint Recursive das Post-Training nur in die Schritte Bewertung, Daten, Training und Bereitstellung. Was diese Vorgänge tatsächlich unterstützt, ist die Infra-Fähigkeit, die Mind Lab seit 2025 beim Post-Training von Billionen-Parameter-Modellen wie Kimi K2 angesammelt hat.
Um diesen Dienst zum Laufen zu bringen, hat das Team mehrere Arten von Problemen gelöst: Das Aufteilen riesiger Modelle auf eine große Anzahl von GPUs zum Training, um lange Wartezeiten für Rechenleistung zu vermeiden; Die Sicherstellung, dass Modelle bei der Generierung von Daten und beim Training konsistente Berechnungspfade durchlaufen, um „falsches Lernen“ zu reduzieren; Und durch asynchrones Training und LoRA-Hot-Upgrades können Training, Inferenz und Versionswechsel gleichzeitig durchgeführt werden. Die zugehörigen Fähigkeiten sind auch in gängige Ökosysteme wie Megatron-Bridge, VERL und AReaL integriert, um den Aufwand für Unternehmen bei der Migration vorhandener Trainingscodes zu reduzieren.
All diese Arbeiten führen zu einem Ergebnis: Für Unternehmen sieht es wie ein einziger API-Aufruf aus, während die Plattform das verteilte Training, die Zustandsverwaltung und die Fehlerwiederherstellung hinter dem Billionen-Parameter-Modell übernimmt.
An diesem Punkt ist es interessant, auf die Veränderungen zurückzublicken, die bei diesem Unternehmen stattgefunden haben. Ein Anwendungsteam, das an persönlichen Agenten arbeitet, hat ein Labor ausgebrütet, das sein eigenes Modell trainiert, und nun hat es das System zum Trainieren von Modellen herausgebracht, um Unternehmen zu bedienen.
Um den persönlichen Agenten Macaron zu entwickeln, muss man zuerst verstehen, wie man eine bestimmte Person versteht: Seine Vorlieben merken, seine Gewohnheiten kennen, sodass vergangene Interaktionen für den nächsten Dienst nützlich sind. Das Team konzentrierte sich von hier aus auf das persönliche Gedächtnis, und Mind Lab ging noch einen Schritt weiter – können diese Erfahrungen in die Parameter einfließen und die Art und Weise verändern, wie das Modell Aufgaben verarbeitet?
Um dieses Problem zu lösen, haben sie geforscht, LoRA-Modelle trainiert und die Infra aufgebaut, die diese Arbeiten unterstützt. Bei Mint Recursive werden diese Fähigkeiten, die ursprünglich für die eigene Erkundung gedacht waren, zu Produkten verarbeitet, die auch andere Unternehmen nutzen können.
Von der Anwendung zum Lab und dann vom Lab zurück zum Anwendungsmarkt: Probleme im Produkt werden zu Forschungsrichtungen, und die Werkzeuge, die während des Forschungsprozesses erstellt werden, werden zu neuen Geschäftsmöglichkeiten.
Allerdings gibt es schließlich unterschiedliche Anforderungen, wenn man das eigene Produkt bedient und externe Kunden bedient. Bei Macaron und Mind Lab wusste das Team, welche Probleme es lösen wollte, und konnte Produkt- und Trainingsschema ständig anpassen. Bei Unternehmenskunden ändern sich Aufgaben, Daten und Budget, und die Kunden haben sich möglicherweise noch nicht einmal klar gemacht, was genau sie vom Modell erwarten.
Bisher hat es aus seinen eigenen Anwendungsproblemen eine Reihe von Forschungs- und Ingenieurfähigkeiten angesammelt; Ob es diese Fähigkeiten nutzen kann, um die Probleme anderer stabil zu lösen, wird darüber entscheiden, ob Mint Recursive zu einem langfristigen Geschäft werden kann.