Eine selbstiterative Nachtrainingsplattform entwickeln: Mind Lab strebt danach, mehr Unternehmen in die Lage zu versetzen, über eigene Modelle zu verfügen.
Text | Xinyi Wang
Redaktion | Yuxin Zhang
Wenn Sie in letzter Zeit mit Investoren geplaudert haben, werden Sie zu einem Schluss kommen: Die Aufmerksamkeit im KI-Kreis kehrt erneut zu Modellen und KI-Infrastruktur (KI-Infra) zurück. Die Modelle entsprechen der aktuellen Abkühlung der Anwendungen, wobei die Popularität zu den vorgelagerten Bereichen verlagert wird; einer der Schwerpunkte von KI-Infra liegt auf Post-Training-Plattformen und Inferenzplattformen.
Gestern veröffentlichte Mind Lab ihre neuesten Errungenschaften: die branchenorientierte Post-Training- und Inferenzplattform für Modelle Mint Recursive sowie das Modell Macaron-V1.1, das auf dieser Plattform post-trainiert wird.
Macaron-V1.1 ist ein Modell mit 752B Parametern, das auf Basis von GLM-5.3 post-trainiert wurde. Im Juli erzählte uns Chen Kaijie, Gründer von Mind Lab, dass zwischen Macaron-V1-Preview, das auf GLM-5.1 basiert, und Macaron-V1, das auf GLM-5.2 basiert, weniger als ein Monat lag. Die Iteration beschleunigt sich weiter: Wie bekannt ist, brauchte Macaron-V1.1 für die Iteration von der Vorgängerversion weniger als zwei Wochen.
Macaron-V1.1 besteht aus einem Basismodell mit 744B Parametern und vier LoRA-Expertenmodulen mit je 2B Parametern, wobei die vier LoRAs jeweils für Chat, Agent, Coding und Generative UI zuständig sind.
Von der 1B-LoRA bei V1 zur heutigen 2B-LoRA erforschen sie derzeit die idealere Größe der Expertenparameter. Aus den Benchmark-Ergebnissen geht hervor, dass sich V1.1 im Vergleich zu V1 auf allen 6 Agent-Ranglisten vollständig verbessert hat, wobei es bei SWE-Marathon (langreicher KI-Programmierfähigkeit) besonders hervorragende Leistungen zeigt.
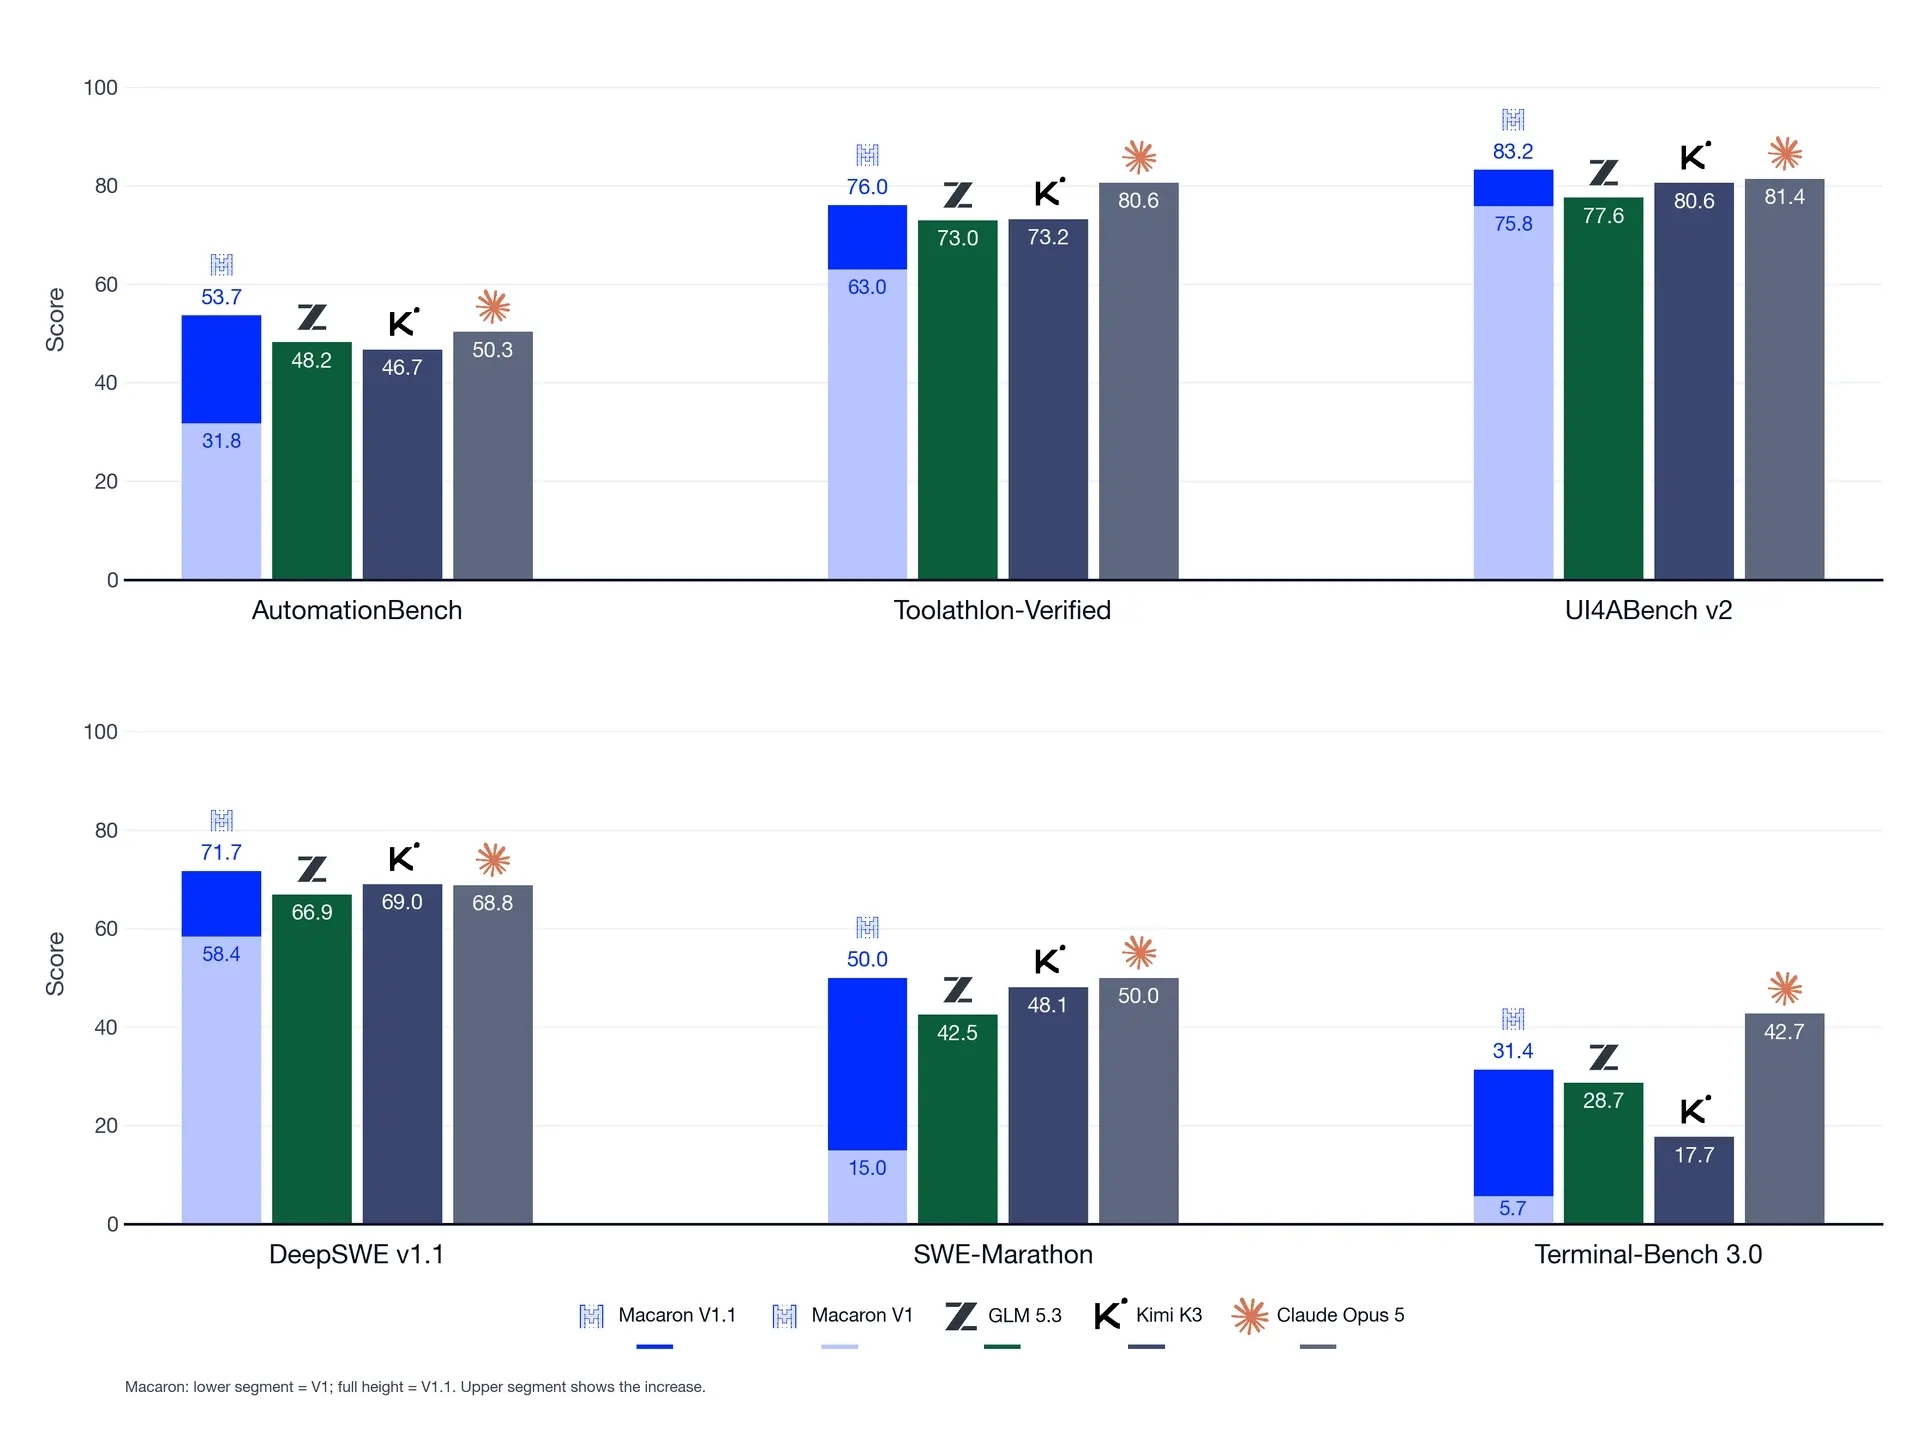
△Leistung von Macaron-V1.1 im Benchmark, Quelle: Unternehmen
Besonders bemerkenswert ist, dass Macaron V1.1 vollständig auf Basis von Mint Recursive trainiert wurde.
Mint Recursive ist eine Post-Training- und Inferenzplattform, deren Arbeitsablauf Bewertung, Daten, Post-Training und Bereitstellung der Inferenz umfasst. Nutzer können die Trainings- und Bereitstellungsfunktionen der Plattform über API und Python SDK aufrufen. Außerdem kann sie Rückmeldungen aus der Produktionsumgebung einbinden, damit sich das Modell bei echten Aufgaben kontinuierlich verbessert. Dieser Ablauf wurde von Mint Recursive bereits bei der Iteration des Modells Macaron V1.1 erfolgreich umgesetzt.
Genau zu diesem Zeitpunkt hat Mind Lab eine Reihe von Ergebnissen veröffentlicht und das in der vergangenen Zeit im Bereich kontinuierliches Lernen und Infrastruktur angesammelte Know-how in einen Satz von extern verfügbaren Diensten umgewandelt.
Infrastruktur für das Post-Training
Es überrascht nicht, dass Mind Lab gleichzeitig Modelle und Infrastruktur entwickelt.
Bereits im Januar dieses Jahres haben sie die frühe Form von Mint Recursive vorgestellt – eine Infrastrukturplattform für LoRA-Training und -Inferenz, die Kunden die vollständige Lösung für den gesamten Prozess des Post-Trainings von großen Modellen bietet.
Gleichzeitig wird die Investition in die Infrastruktur-Ebene allmählich zu einem Branchenkonsens.
Vor einigen Tagen veröffentlichte Tang Jie, Gründer und Chefwissenschaftler von Zhipu, einen langen Artikel auf X, in dem er die neuesten Fortschritte bei der Verbesserung der KI durch KI erläuterte: Sie ließen den Infra-Agent, der von GLM-5.3 gesteuert wird, die eigene Inferenz-Engine von GLM-5.3 automatisch optimieren, sodass ein Cluster aus mehr als 100.000 inländischen Chips in weniger als zwei Wochen den End-to-End-Durchsatz auf das Dreifache des ursprünglichen Basiswerts steigerte.
Was Zhipu derzeit tut, besteht darin, die KI dazu zu bringen, die Inferenzschicht der Infrastruktur selbst zu verbessern. Obwohl das Modell ebenfalls an der Optimierung seiner selbst beteiligt ist, wollen die Beteiligten unterschiedliche Probleme lösen: Mind Lab möchte eine Post-Training-Plattform entwickeln, die den gesamten Prozess vom Post-Training bis zur Bereitstellung der Inferenz optimieren soll, einschließlich Schritten wie Daten, Bewertung, Bereitstellung und Sammlung von Rückmeldungen.
Die Mint Recursive-Plattform besteht aus drei Modulen: Train & Deploy (Training und Bereitstellung), Env Hub (Umgebungszentrum) und Data & Experience (Daten und Erfahrung). Diese Plattform unterstützt Algorithmen wie Modell, SFT (Supervised Fine-Tuning), RL (Reinforcement Learning), DPO (Preference Training) und Fine-Tuning mit allen Parametern und ist mit Open-Source-Modellen verschiedener Größen wie GLM, Qwen, DeepSeek, Kimi und MiniMax kompatibel. Nach Abschluss des Trainings kann das Modell mit einem Klick bereitgestellt werden, und es gibt ein zugehöriges Bewertungssystem, das die Vorbereitung für die nächste Runde des Modelltrainings trifft.
Im September letzten Jahres veröffentlichte Thinking Machines Lab, gegründet von Mira Murati, ehemaliger CTO von OpenAI, einen technischen Blog mit dem Titel *LoRA Without Regret*, der theoretisch und experimentell bewies, dass LoRA bei richtiger Vorgehensweise die gleiche Wirkung wie das Fine-Tuning mit allen Parametern erzielen kann. Seitdem ist LoRA fast zu einem allgemein angewandten Verfahren im Bereich des Post-Trainings geworden.
Erwähnenswert ist, dass Mind Lab das Post-Training-Paradigma „LoRA“ stets im Auge behält. Diesmal gehen sie auf diesem Weg noch einen Schritt weiter: In Mint Recursive gestalten sie sowohl das Training als auch die Bereitstellung mit LoRA zu einem serverlosen Modell: Kunden müssen keine GPUs kaufen und keine Cluster verwalten, sondern können die Kosten direkt nach der Menge der verarbeiteten Token abrechnen.
Auf der Trainingsseite möchte Mint Recursive erreichen, dass das Modell intelligenter wird: Mit der LoRA-Methode werden nur eine kleine Anzahl neuer Parameter trainiert, um anhand der Geschäftsziele kontinuierlich aus den Geschäftsrückmeldungen zu lernen und die Fähigkeiten iterativ zu verbessern, sodass das Modell das Geschäft besser versteht. Gleichzeitig können die Kosten für das Post-Training von Unternehmen erheblich gesenkt werden.
Auf der Bereitstellungsseite sind die vier Geschäftsversionen, die den vier LoRA-Expertenmodulen entsprechen, jeweils ein leichtgewichtiges Adapter (externes Plugin), die an dasselbe Basismodell angehängt sind. Diese Adapter stören sich gegenseitig nicht und sind sehr flexibel: Jeder Adapter kann separat aktualisiert, in Betrieb genommen und außer Betrieb genommen werden, und historische Versionen bleiben erhalten, damit Kunden sie vergleichen und zurücksetzen können. Kunden können auch einen Adapter in das Basismodell zusammenführen, um ein vollständiges, unabhängiges Modell zu erhalten.
Das ist genau der Kerngedanke von LoRA: Das Basismodell wird gemeinsam genutzt, und in jedem Geschäftsszenario wird nur ein gezieltes Post-Training durchgeführt. Der Vorteil liegt darin, dass die Kosten für das Post-Training, die Bereitstellung und die Iteration des Modells stark gesenkt werden können und die Anpassung der Gewichte flexibler wird.
Jeder Schritt des Post-Trainings, wie die erforderlichen Daten, Bewertungen und Rückmeldungen, ist auf die Unterstützung der Infrastruktur angewiesen. Von der Durchführung des Post-Trainings bis zur Entwicklung der Infrastruktur für das Post-Training ist die Wahl von Mind Lab sehr natürlich.
Aber bevor sie die Antwort von Mint Recursive vorlegten, haben sie viele Vorbereitungen getroffen:
Im Jahr 2025 begann Mind Lab mit der Forschung zum Post-Training an Modellen mit Billionen von Parametern wie Kimi K2, und die Infrastruktur von Mint Recursive wurde zu dieser Zeit erstmals aufgebaut;
Anschließend, Ende 2025, trugen sie LoRA-RL mit 1T Parametern, das erste seiner Art in der Branche, zu NVIDIA Megatron-Bridge bei und ergänzten Megatron um Erfahrungen im leichtgewichtigen Reinforcement Learning für ultra-große Basismodelle;
Mitte 2026 beteiligten sie sich an mehreren Open-Source-Projekten wie dem Reinforcement-Learning-Trainingsrahmen veRL von Volcano Engine und dem nächsten Trainings-Backend megatron_lite von NVIDIA und lieferten einige Lösungen für LoRA und Reinforcement Learning;
Im Juli 2026 wurde die Macaron-V1-Serie offiziell veröffentlicht und als Open-Source bereitgestellt, wodurch die Wirksamkeit dieses Trainingsverfahrens bei Aufgaben wie Agent und Coding bestätigt wurde.
Die Infrastruktur ist sehr wichtig, aber nicht alle Unternehmen können eine Infrastruktur entwickeln und es ist auch nicht für alle notwendig, eine eigene Infrastruktur separat zu entwickeln.
Der technische Schwierigkeitsgrad des Post-Trainings von Billionen-Modellen übersteigt die Vorstellungskraft bei weitem. Die Speicherverwaltung bei verteiltem Training, die Genauigkeitsausrichtung der Konsistenz von Training und Inferenz sowie das Hot-Update von Gewichten bei asynchronem Reinforcement Learning sind für ein Startup schwierige Herausforderungen.
Chen Kaijie erzählte uns, dass das Reinforcement Learning für das Training kleiner Modelle eigentlich sehr einfach ist. Sobald der Umfang jedoch wächst, wird der Schwierigkeitsgrad sehr groß, insbesondere da sie auf dem Reinforcement Learning noch die kontinuierliche Lernmethode mit LoRA überlagert haben.
Derzeit bietet Mint Recursive hauptsächlich drei Arten von Diensten an: Das Training wird gemeinsam von Experten und Unternehmen in einer Form ähnlich FDE abgeschlossen; automatisiertes Training auf der Plattform; eigenständiges Training von Unternehmen über API und Python SDK.
Trainieren Sie ein eigenes Modell für das Unternehmen
Immer mehr Unternehmen möchten ein eigenes Modell besitzen, das ist auch der Grund, warum das leichtgewichtige Post-Training und das Trainingsparadigma des kontinuierlichen Lernens hoch geschätzt werden.
Aus Sicht der praktischen Umsetzung ist der Unternehmensbereich möglicherweise das Szenario mit dem größten Bedarf an angepassten Modellen. „Allgemeine große Modelle können nur 20 % bis 30 % der Szenarien in verschiedenen Branchen abdecken, und die restlichen 70 % bis 80 % müssen durch vertikales kontinuierliches Lernen optimiert werden“, erwähnte Chen Kaijie.
Der ausländische Markt hat diesen Trend bereits vorab bestätigt. Fireworks AI, ein Unternehmen aus dem Silicon Valley, das sich mit der Inferenz von Open-Source-Modellen und dem Hosting des Post-Trainings befasst, erreichte im Juli dieses Jahres eine Bewertung von 17,5 Milliarden US-Dollar, sein ARR überstieg 1 Milliarde US-Dollar und die tägliche verarbeitete Token-Menge überschritt 40 Billionen.
Qiao Lin, CEO von Fireworks AI, erwähnte in einem Gespräch mit HSG: „Das Post-Training ist nicht mehr ein exklusives Spiel der Modellteams. Nachdem KI-Produkte den Produkt-Markt-Fit (PMF) erreicht haben und mit der Skalierung begonnen haben, ist das Post-Training fast eine Pflichtlektion, die sie nicht umgehen können.“
Konkret gesehen liegt der Wettbewerbsvorteil von KI-Produktunternehmen im Vergleich zu Modellanbietern in den Daten, echten Aufgaben, Rückmeldungen und Präferenzen, die aus der tatsächlichen Nutzung durch Nutzer entstehen. Mehr als 95 % des Datenverkehrs auf der Fireworks-Plattform stammen von kundenspezifisch fein abgestimmten dedizierten Modellen, nicht von allgemeinen Basismodellen. Diese Logik wurde von Qiao Lin als „Besitz der eigenen Intelligenz“ definiert.
Die Entscheidung von Anwendungsunternehmen, eigene Modelle zu entwickeln, trifft immer mehr Unternehmen zu – Der Wettbewerbspunkt von KI-Anwendungen wandelt sich allmählich vom Produkt selbst zur Erfahrungsintelligenz des Produkts, einschließlich der eigenen Urteile, des Geschmacks, der Geschäftsdaten und des Verständnisses für Kunden.
Das einzigartigste Vermögen von Anwendungsunternehmen stammt aus der echten Produktionsumgebung: Sie wissen genau, was Nutzer erreichen wollen, welche Ergebnisse als gut gelten, wo wiederholt Fehler auftreten und wie Fachkräfte die Ergebnisse tatsächlich beurteilen. Wie können Unternehmen ihre eigene Intelligenz besitzen und Branchenerfahrungen in das Basismodell einbinden?
Was Mint Recursive versucht, ist Unternehmen dabei zu helfen, ihr eigenes Bewertungssystem, Belohnungsmechanismus und Trainingsdaten aufzubauen und das Post-Training zu einem geschlossenen Kreislauf der kontinuierlichen Iteration zu machen: Das Modell sammelt nach der Bedienung von Nutzern Daten aus echten Aufgabenszenarien, und die Spuren jeder Interaktion – egal ob erfolgreich oder fehlgeschlagen – werden vollständig aufgezeichnet.
Dabei sind die Spuren von Fehlern sehr wertvoll: Wo ist der Fehler passiert, warum ist er passiert und wie sollte er behoben werden? Nachdem die Plattform Probleme und Lösungen gefunden hat, werden diese Urteile und Spuren direkt zu neuen Trainingsdaten. Nach dem erneuten Training mit neuen Daten und der Inbetriebnahme entstehen neue Rückmeldungen, die wiederum als Eingabe für die nächste Runde des Trainings dienen, und so weiter im Zyklus.
Der Schritt des Env Hub (Umgebung) in der Plattform wird leicht übersehen, aber er ist besonders entscheidend. In einem technischen Blog von Nvidia über Agentic Reinforcement Learning wird erwähnt, dass für das Reinforcement Learning von Agenten Umgebungen benötigt werden, um Datensätze, Prüfprogramme und Zustände zu definieren. Die Umgebung ist nicht nur ein Trainingsplatz für das Modell, sondern auch ein Bewertungsplatz. Bewertung, synthetische Daten und Reinforcement Learning können alle in einer einzigen Umgebung abgeschlossen werden.
Obwohl die rekursive Funktion in Mint Recursive sich noch in einer frühen Phase befindet – Menschen befinden sich immer noch im rekursiven Kreislauf, und es ist noch weit entfernt von dem vollständig automatisierten Training des Modells selbst – ist die Richtung der Modelliteration sehr klar. Für Kunden ist nicht das Modell selbst wichtiger, sondern die praktischen Geschäftsszenarien vor Ort und die einzigartigen echten Geschäftsdaten, die das Unternehmen besitzt.
Bildquelle | Zur Verfügung gestellt von dem Unternehmen
Folgen Sie uns gerne~
Wir freuen uns auf den Austausch~
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto "Intelligentes Emergieren"