Qwens neuer Top-Manager gibt sein erstes öffentliches Debüt – kann Liu Dayiheng dem Druck standhalten?
Wenn man fragt, wer im chinesischen KI-Bereich am meisten unter Druck steht, stehen Liang Wenfeng, Yang Zhilin, Yao Shuny u und Tang Jie alle auf der Liste der am stärksten belasteten Personen. Aber ab jetzt lastet auch ein nicht zu unterschätzender Druck auf Liu Da Yiheng.
Am 4. März hinterließ Lin Junyang die Nachricht „Abschied, mein geliebtes Qwen“, und Qwen trat in eine halbjährige Phase ohne oberste Führungskraft ein.
Anfangs wurde die Position des Leiters von Qwen vorübergehend von Zhou Jingren, dem CTO von Alibaba Cloud, übernommen. Später fusionierte die Abteilung für das Tongyi-Großmodell mit dem Labor für zukünftiges Leben zur Token Foundry-Abteilung, die direkt von Wu Yongming geleitet wird.
Am 22. September auf dem Hauptforum der Hangzhou Yunqi-Konferenz trat Liu Da Yiheng, der 2021 zu Alibaba stieß und in der Ära nach Lin Junyang für die Richtungen Vortraining, Nachtraining und Programmierung zuständig war, nach der Rede von Wu Yongming, dem CEO der Alibaba Group, als Leiter von Qwen vor die Öffentlichkeit.
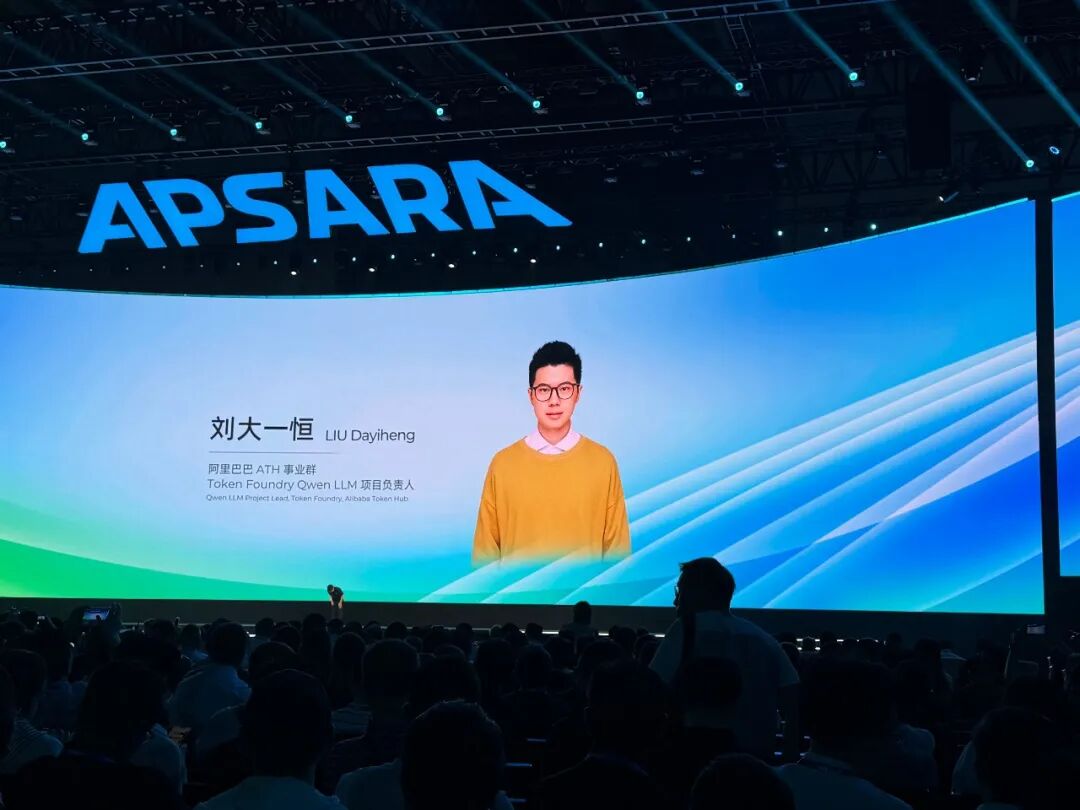
Dies war auch sein erster öffentlicher Auftritt als neuer oberster Leiter von Qwen.
Was das Open-Source-Ökosystem betrifft, ist Qwen nach wie vor weltweit führend: 3 Milliarden Downloads, 300.000 abgeleitete Modelle und mehr als 460 Open-Source-Modelle belegen seit langem die Spitzenplätze auf Hugging Face.
Aber was das Modell selbst betrifft, ist die Situation für Qwen nicht optimistisch. Das Flaggschiff-Modell Qwen 3.8 Max belegt zwar den ersten Platz im Agentic Index von Artificial Analysis, steht aber nur auf dem siebten Platz im Intelligenzindex.
Als Liu Da Yiheng heute auf die Bühne trat, stellte er nicht nur eine Roadmap vor, sondern gab auch eine klare Stellungnahme ab: Was wird Qwen antreiben, um weiter voranzukommen, nachdem es seine zentrale Führungskraft verloren hat und zahlreiche Konkurrenten im In- und Ausland aufholen?
Ist Liu Da Yiheng in der Lage, dem Druck standzuhalten?
Die Roadmap von Qwen
Auf der Yunqi-Konferenz definierte Wu Yongming die drei Grundpfeiler des „Zeitalters der Maschinenintelligenz“ als KI-Modelle, KI-Chips und KI-Cloud. Er stellte zwei Feststellungen auf: Die gesamte Denkleistung der Maschinen in der Zukunft wird mehr als das 1000-fache der menschlichen Denkleistung erreichen, während dieser Anteil heute weniger als 3 % beträgt; das heutige KI-Programmieren ist vergleichbar mit der elektrischen Lampe im Jahr 1882 – es ersetzt bestehende Arbeitsabläufe, reicht aber noch nicht aus, um ein neues Zeitalter einzuläuten.
Gleichzeitig erklärte Wu Yongming, dass das Qwen-Team Fortschritte bei der rekursiven Selbstverbesserung (RSI) macht und die Modelle in Zukunft auf einen Umfang von 5 bis 10 Billionen Parametern erweitern wird.
Unmittelbar danach betrat Liu Da Yiheng als Leiter von Qwen die Bühne, um die zukünftige Roadmap von Qwen vorzustellen.
Auf der Grundlage dieser Feststellungen gliedert sich die Roadmap von Qwen grob in fünf Hauptrichtungen.
Die erste Richtung ist die Selbstverbesserung, also das von Wu Yongming erwähnte RSI.
Qwen3.8-Max ist bereits in der Lage, unter fast vollständiger Abwesenheit menschlicher Beteiligung eigenständig Trainingsabläufe aufzubauen, Trainingsdaten zu erstellen, Experimente zu entwerfen und Fehler zu lokalisieren. Es hat mehr als einen Monat lang kontinuierlich iteriert und 33 gültige Iterationsrunden abgeschlossen.
Das Ergebnis ist, dass seine Bewertungspunktzahl im Artificial Analysis-Test von 40 auf 45 gestiegen ist, was einer Verbesserung von etwa 12,5 % entspricht.
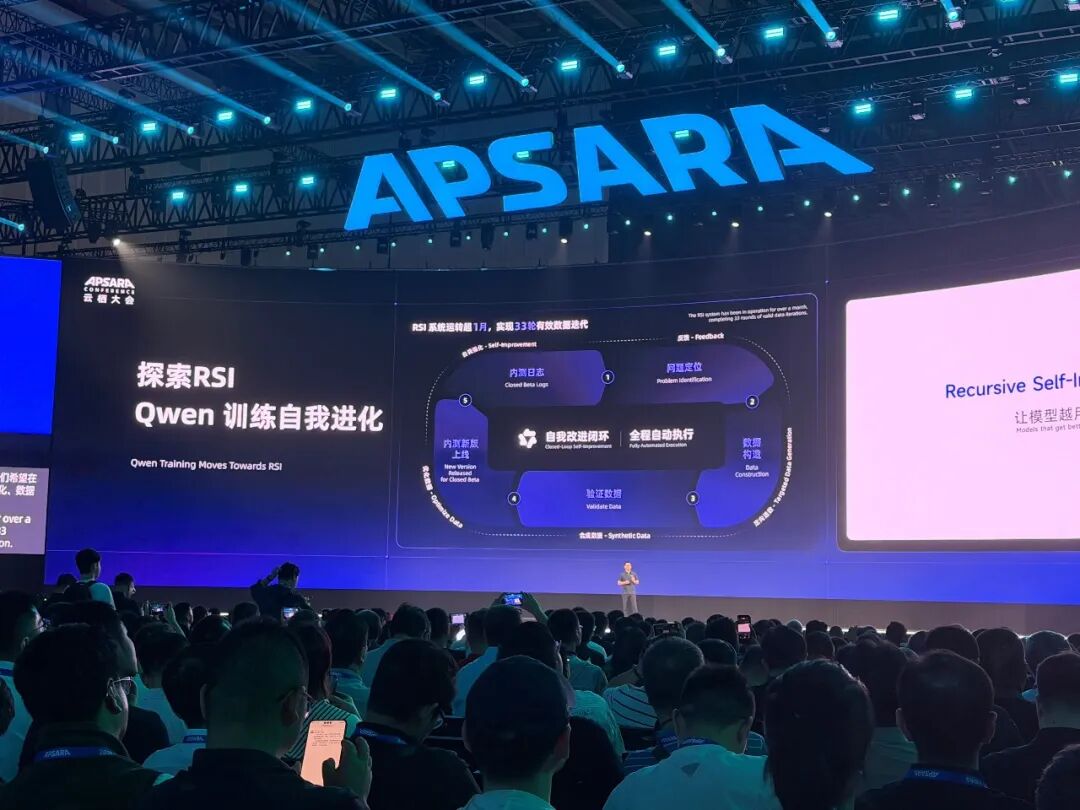
Auf der Ebene der Hardware-Kooperation hat es eigenständig die neue Architektur von T-Head angepasst, wodurch der Durchsatz einer einzelnen Instanz des Inferenz-Frameworks um 96 % gesteigert wurde. Bei der kooperativen Gestaltung von Chips wurde die Fläche der physischen Implementierung um 42 % reduziert, indem nur auf die Spezifikation des Busmoduls zurückgegriffen wurde, 60 Stunden lang selbst iteriert wurde und mehr als 10.000 Aufrufe von EDA-Tools durchgeführt wurden.
Aber Liu Da Yiheng erklärte, dass RSI derzeit nur „vorläufig in Bereichen wie Modelltraining, Inferenz und kooperativer Gestaltung von Chips und Modellen eingesetzt wird“ und noch keinen ausgereiften Zustand ohne menschliche Beteiligung erreicht hat.
Die zweite Richtung ist die Iteration der Architektur.
Qwen4, das auf einer neuen Generation von Architektur basiert, befindet sich bereits in der Trainingsphase. Auf der Open-Source-Seite wird Qwen4-27B vorrangig veröffentlicht. Für die nachfolgenden Modelle Qwen4.5 und Qwen5 ist geplant, den Parameterumfang auf 5 Billionen bis 10 Billionen zu erweitern.
Liu Da Yiheng betonte in seiner Rede, dass die Erweiterung des Parameterumfangs nach wie vor einer der Kernpfade zum KI auf menschlichem Niveau (ASI) ist. Gleichzeitig hat Qwen3.8-Flash die nächste Generation von Architektur vorab als Open Source veröffentlicht, wodurch die Trainingskosten offiziell um fast 90 % gesenkt wurden.
Die dritte Richtung ist die einheitliche Verarbeitung aller Modalitäten.
Liu Da Yiheng ist der Ansicht, dass Qwen3.8-Omni das Zeichen dafür ist, dass Qwen in die Phase der einheitlichen multimodalen Verständnisfähigkeit eingetreten ist.
Die zugehörigen Produkte umfassen das Bildmodell Qwen-Image-3.1, das Sprachmodell Qwen-Audio-3.1, das Simultandolmetschmodell Qwen3.8-LiveTranslate, sowie Musikmodelle, Weltmodelle und ein nächstes Generation von Videogenerierungsmodell, das voraussichtlich im November veröffentlicht wird.
Die vierte Richtung ist Offenheit als Open Source.
„Der Wert der KI sollte nicht nur wenigen Unternehmen gehören, sondern zu einer grundlegenden Fähigkeit werden, die alle Nutzer auf der Welt zugänglich ist, die sie nutzen und mit der sie gestalten können“, sagte Liu Da Yiheng. „Wir wollen mehr Menschen die Möglichkeit geben, KI zu erschwinglichen Preisen zu nutzen, auf KI zuzugreifen und an der Gestaltung von KI teilzunehmen.“
Anschließend erklärte Liu Da Yiheng, dass Qwen auch in Zukunft an dem Prinzip der Offenheit als Open Source festhalten wird.
Laut den von Liu Da Yiheng vorgelegten Daten hat Alibaba insgesamt mehr als 460 Modelle als Open Source veröffentlicht. Die Qwen-Serie wurde weltweit mehr als 3 Milliarden Mal heruntergeladen und umfasst mehr als 300.000 abgeleitete Modelle, was weltweit den ersten Platz bedeutet.
Zwei Monate nach der Veröffentlichung von Qwen3.8-27B überstieg die Gesamtzahl der Downloads der gesamten Qwen-Serie die der Open-Source-Modelle wie DeepSeek und Llama, sodass sie zur Modellserie mit den meisten positiven Bewertungen auf Hugging Face wurde.
Die fünfte Richtung ist die Implementierung auf Endgeräten und Endbenutzerplattformen.
Auf Desktop-Geräten kann das quelloffene 27B-Modell lokal ausgeführt werden. Auf mobilen Geräten hat Alibaba das vollständige Stack-System für KI-Smartphones Qwen Intelligence veröffentlicht, das Smartphones in die Lage versetzt, komplexe auf mehrere Anwendungen verteilte Aufgaben zu erledigen.
Darüber hinaus umfasst dies auch KI-Brillen, Desktop-Roboter sowie den auf RISC-V basierenden Prozessor Xuan Tie C950, der Qwen3.8-27B nativ ausführen kann.
Diese fünf Richtungen laufen nicht getrennt voneinander ab, sondern bilden zusammen die umfassende KI-Strategie von Alibaba.
RSI beantwortet die Frage „Wie kann sich das Modell selbst verbessern“, die Architekturiteration beantwortet die Frage „Wie hoch kann die Leistungsgrenze sein“, die multimodale Verarbeitung beantwortet die Frage „Was kann das Modell verstehen“, die Open-Source-Offenheit beantwortet die Frage „Wer kann das Modell nutzen“ und die Implementierung auf Endgeräten beantwortet die Frage „Wo kann das Modell eingesetzt werden“.
Sie dienen alle gemeinsam dem von Liu Da Yiheng genannten Ziel des „Realwelt-Agenten“, sodass sich das Modell von einem reinen Dialogsystem zu einem System entwickelt, das Aufgaben eigenständig erledigen kann.
Bei seinem ersten öffentlichen Auftritt, bei dem er aus dem Hintergrund in die Öffentlichkeit trat, hat Liu Da Yiheng bereits die drei Bereiche Hardware, Software und Strategie abgedeckt.
Über Liu Da Yiheng
Liu Da Yiheng stammt aus Zigong in der Provinz Sichuan. Sein Name „Da Yiheng“ ist ungewöhnlich, sodass viele Leute zunächst annahmen, dass es sich um seinen Spitznamen bei Alibaba handelt.
2012 trat er in die Fakultät für Informatik der Sichuan-Universität ein. 2015 wurde er aufgrund seines ersten Gesamtplatzes in das kombinierte Bachelor-Master-Doktor-Programm „3+2+3“ aufgenommen, sein Betreuer war Professor Lü Jiancheng.
2017 ging Liu Da Yiheng zu einem Austauschprogramm an die Nationaluniversität von Singapur. 2020 erwarb er seinen Doktortitel in Informatik an der Sichuan-Universität.
Vom Bachelor-Studium bis zum Doktorat blieb er an der Sichuan-Universität, er hat keinen ausländischen Bildungsabschluss und keinen Hintergrund der Tsinghua-Universität oder Peking-Universität. Dies unterscheidet sich von dem im KI-Bereich üblichen Karrierepfad „Bachelor an einer renommierten einheimischen Universität – Doktorat im Ausland – Berufserfahrung bei einem großen Technologiekonzern“.
Sein erster Auftritt in der Öffentlichkeit hängt mit einer wissenschaftlichen Arbeit zusammen.
2019 veröffentlichte er eine Arbeit auf der Jahrestagung der Association for Computational Linguistics (ACL), dies war das erste Mal, dass ein Doktorand der Sichuan-Universität Ergebnisse auf der ACL veröffentlicht hat.
Er erwähnte später in einem Interview, dass er nicht selbst seine Bewerbung eingereicht hat – nachdem die Arbeit veröffentlicht wurde und die Universitätswebsite über seine Forschungsergebnisse berichtet hatte, hat Huawei ihn von sich aus kontaktiert.
Danach wurde Liu Da Yiheng mit einem Schlag weithin bekannt.
2019 nahm er am globalen offenen Langzeitwettbewerb „Natural Questions“ (NQ) teil, der von Google veranstaltet wurde.
Die Aufgabe dieses Wettbewerbs lässt sich zusammenfassen: Das System soll eine gesamte Wikipedia-Seite durchlesen und dann die Frage beantworten, die der Nutzer in die Google-Suchmaschine eingegeben hat.
Er hat zwei Schwierigkeitspunkte: Erstens handelt es sich um lange Dokumente – eine Wikipedia-Seite umfasst oft Tausende von Wörtern mit hoher Informationsdichte. Zweitens ist es ein offenes Themengebiet, für das es keine vordefinierten Fragescopes gibt und in dem alles abgefragt werden kann.
Lange Dokumente und offene Themengebiete waren zu dieser Zeit die beiden anerkannt schwierigsten Problemtypen in der Verarbeitung natürlicher Sprache.
Es war sehr schwierig, in diesem Wettbewerb einen vorderen Platz zu belegen, da auch Teams wie Google AI und IBM Research an dem Wettbewerb teilnahmen.
Trotzdem erreichte das von Liu Da Yihengs Team vorgestellte Modell bei der Einreichung den ersten Platz weltweit und hielt diesen drei Monate lang. Dabei übertrug ein einzelnes Modell erstmals alle Testindikatoren dieses Wettbewerbs die Leistung eines einzelnen Menschen, und das integrierte Modell belegte den ersten Platz auf der öffentlichen Rangliste weltweit.
Das von Liu Da Yiheng entwickelte Projekt heißt RikiNet, der Name steht für „Reading Wikipedia“ also „Neuronales Netz, das Wikipedia liest“. Sein Kernprinzip besteht darin, die gesamte Wikipedia-Seite als Lesematerial zu verwenden und dann die Antwort auf der gesamten Seite zu lokalisieren.
RikiNet besteht aus zwei Modulen: Das eine ist ein „dynamischer Absatz-Doppelaufmerksamkeitsleser“, der dafür zuständig ist, Fernabhängigkeiten in sehr langen Texten zu erfassen und irrelevante Inhalte herauszufiltern; das andere ist ein „mehrstufiger kaskadierender Antwortvorhersager“, der die hierarchische Beziehung zwischen langen Antworten (Absätzen) und kurzen Antworten (Textfragmenten) nutzt, um nacheinander die Position der kurzen Antwort, den Absatz mit der langen Antwort und den Antworttyp vorherzusagen.
2020 wurde er nach mehrstufigen Auswahlverfahren von Huawei in die höchste Kategorie des „Genius-Jugend-Programms“ aufgenommen. Er war der erste Student im Südwesten Chinas, der in die höchste Kategorie aufgenommen wurde, und einer von nur 5 Personen im ganzen Land in diesem Jahr, mit einem maximalen Jahresgehalt von 2 Millionen Yuan.
2021 trat er als „Alibaba Star“ im Rahmen des Hochschulrecruitments in das Labor für Sprachtechnologie des Alibaba Damo Academy ein und beteiligte sich an der Entwicklung von Qwen.
Er hat einmal selbstironisch gesagt: „Ich bin weder ein Genie, noch bin ich mehr ein Jugendlicher.“
Bei Qwen war Liu Da Yiheng lange Zeit für das Vortraining zuständig und leitete die Entwicklung der gesamten Sprachmodellserie von Qwen 1 bis Qwen 3.5. Er beteiligte sich tief an der Entwicklung der Qwen-Serien für Multimodalität, Programmierung und Mathematik (Qwen-Math) und hat insgesamt an der Veröffentlichung von mehr als 300 Qwen-Modellen als Open Source mitgewirkt.
Auch in den technischen Berichten der berühmtesten Modelle der Qwen-Serie, Qwen2.5 und Qwen3, steht Liu Da Yihengs Name unter den Autoren.
Liu Da Yiheng ist einer der wenigen Personen im Team, die gleichzeitig die drei Kernmodule Vortraining, Programmierung und Nachtraining abdecken. Das Vortraining bestimmt die grundlegende Fähigkeit des Modells.
Das Nachtraining wie Verstärkungslernen, Ausrichtung, Inferenz und Agenten bestimmt die praktische Leistungsfähigkeit von Qwen in Geschäftsszenarien. Die Programmierung bestimmt die Kommerzialisierungsfähigkeit von Qwen.
Aus diesem Grund hat Liu Da Yiheng in seiner ersten öffentlichen Rede die vollständige Roadmap von Qwen vorgestellt – für ihn war dies nichts anderes als ein langer vorbereiteter Arbeitsbericht.
Nach mehreren Umstrukturierungen braucht Qwen eine Person, die „die Lage stabilisieren kann“. Die Position des Leiters von Qwen kann nur Liu Da Yiheng übernehmen.
Der Unterschied zwischen Liu Da Yiheng und Lin Junyang
In den letzten drei Jahren war das öffentliche Bild von Qwen weitgehend mit der Person von Lin Junyang verbunden.
Er wurde im März 1993 geboren und ist sogar jünger als Liu Da Yiheng.
Nach seinem Abschluss 2