Die GPT-6-Familie wird um neue Produkte erweitert, OpenAI führt Preiskriege, verlässt sich aber nicht vollständig auf Preiskriege.
Weniger als einen Monat nach der Veröffentlichung von GPT-6 Astra hat OpenAI die Mitglieder der GPT-6-Familie vervollständigt.
Am 22. September nach US-amerikanischer Ortszeit veröffentlichte OpenAI offiziell GPT-6 Sol und GPT-6 Luna, die jeweils mittlere und leichte Aufgaben übernehmen. Die größte Änderung der beiden Modelle besteht nicht in der reinen Verbesserung der Benchmark-Werte, sondern im Preis.
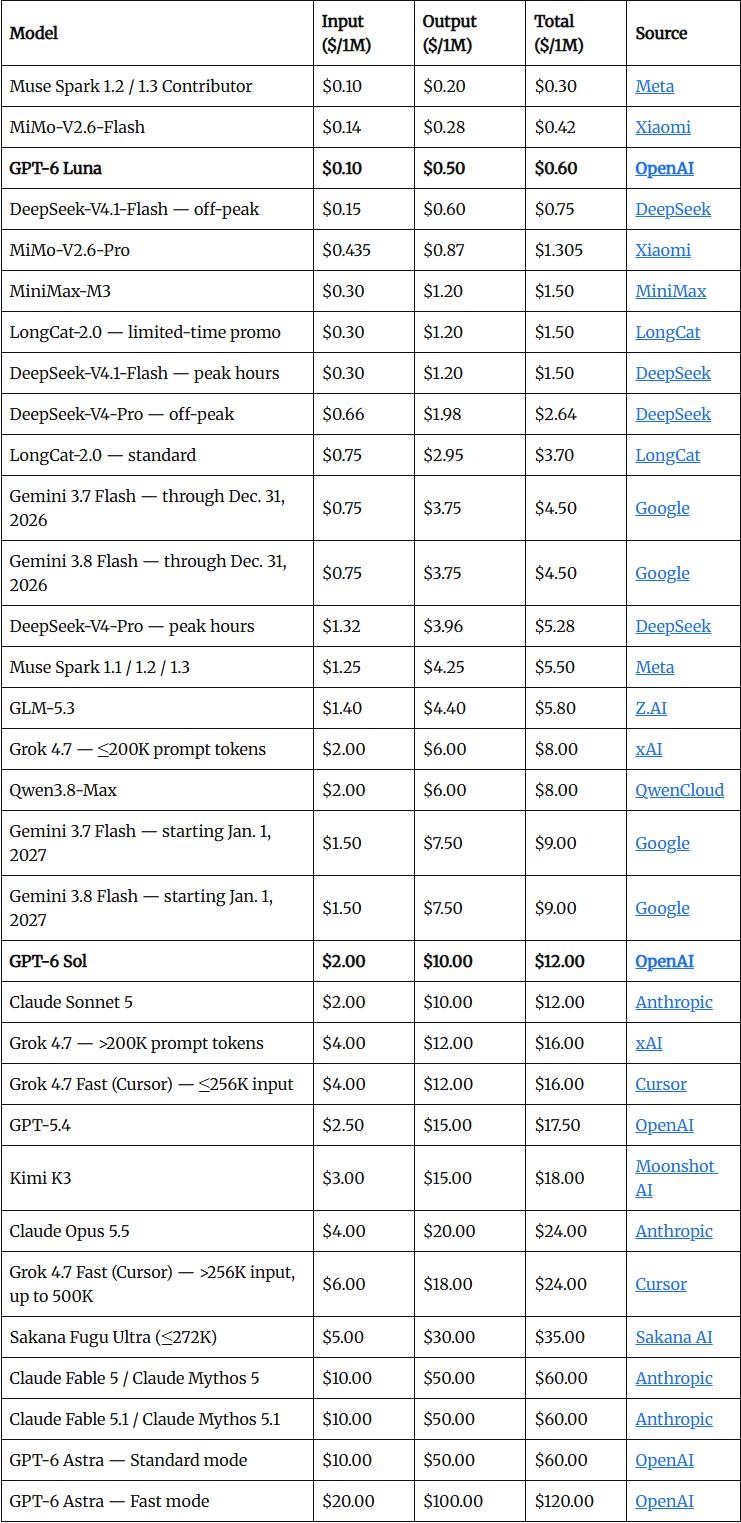
Nach offiziellen Angaben von OpenAI beträgt der API-Preis von GPT-6 Sol 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Ausgabe-Token, was einem Rückgang von 50 % gegenüber dem früheren Aktionspreis von GPT-5.6 Sol entspricht; GPT-6 Luna kostet 0,10 US-Dollar pro Million Eingabe-Token und 0,50 US-Dollar pro Ausgabe-Token, ebenfalls 50 % niedriger als der frühere Aktionspreis von GPT-5.6 Luna.
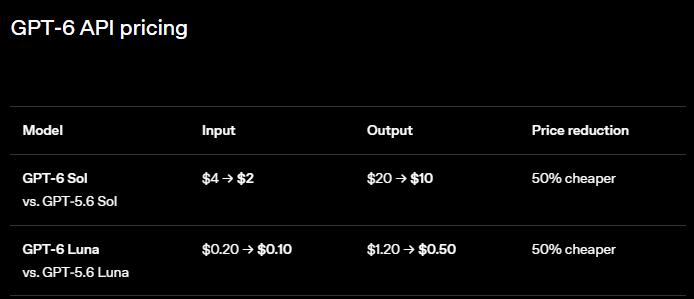
Mit diesem Preis liegt Sol direkt auf dem Niveau von Claude Sonnet 5. Letzteres kostet derzeit ebenfalls 2 US-Dollar für die Eingabe und 10 US-Dollar für die Ausgabe. Luna dringt weiter in den Markt für Niedrigpreismodelle vor, wobei der Eingabepreis sogar unter dem des neu veröffentlichten MiMo-V2.6-Flash von Xiaomi liegt.
Zufälligerweise veröffentlichte Anthropic am selben Tag Claude Opus 5.5. Sein API-Preis beträgt 4 US-Dollar für die Eingabe und 20 US-Dollar für die Ausgabe, was einem Rückgang von 20 % gegenüber dem Token-Preis von Opus 5 entspricht. Laut Anthropic sinken die Betriebskosten für typische Arbeitslasten um etwa 40 %.
Eines senkt die Kosten des Flaggschiffmodells, das andere senkt die Preise direkt bei mittleren und leichten Modellen. Der Wettbewerb um KI-Modelle verlagert sich zunehmend von der Frage „Welches Modell ist leistungsstärker?“ hin zu „Wie viel kostet es, dieselbe Arbeit zu erledigen?“.
01 Sol positioniert sich im mittleren Segment, Preis halbiert
Obwohl GPT-6 Sol unterhalb von Astra angesiedelt ist, positioniert OpenAI es nicht einfach als „billigere Version“.
Bei Aufgaben wie professioneller Arbeit, Programmierung und Computernutzung übertrifft Sol das Vorgängermodell GPT-5.6 Sol deutlich, und einige Tests kommen sogar nahe an Astra heran.
AutomationBench ist das typischste Beispiel dafür.
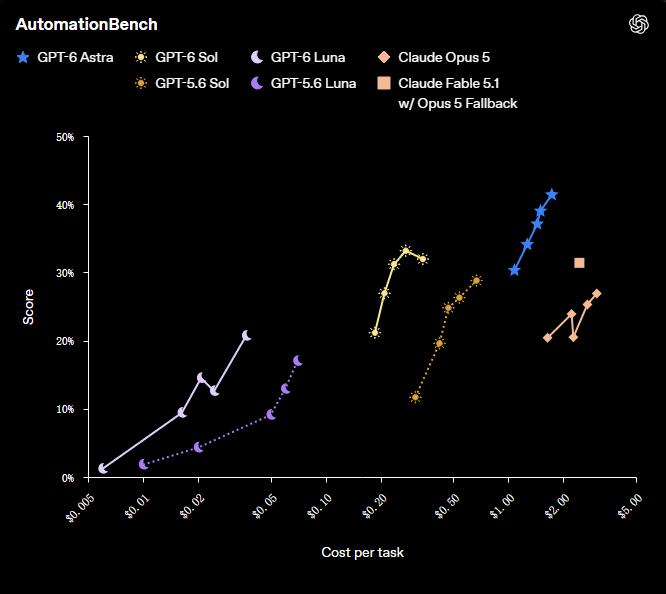
Dies ist ein Test für Agenten-Workflows, der 47 Arten von Tools sowie Szenarien wie Vertrieb, Marketing, Betrieb, Kundenservice, Finanzen und Personalwesen abdeckt. Die von OpenAI veröffentlichten Ergebnisse zeigen, dass Sol im xhigh-Modus 33,2 % erreicht und die Kosten pro Aufgabe etwa 0,27 US-Dollar betragen.
Im Vergleich dazu erreicht GPT-6 Astra im low-Modus 30,3 %, wobei die Kosten pro Aufgabe etwa das 3,9-fache von Sol betragen; Claude Opus 5 erreicht im max-Modus 26,9 %, die Kosten pro Aufgabe betragen etwa das 11,1-fache von Sol. Claude Fable 5.1 erreicht 31,4 %, und OpenAI schätzt, dass seine Aufgabenkosten mehr als das 8,9-fache von Sol übersteigen.
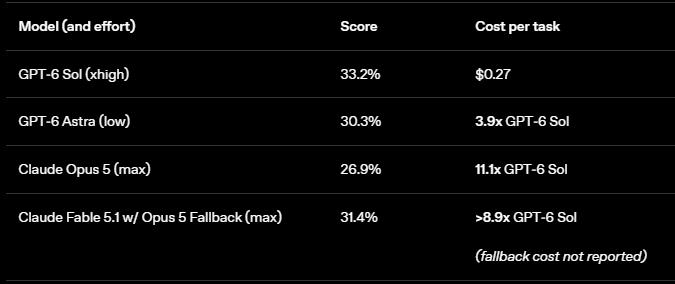
Dies sind jedoch alles von OpenAI veröffentlichte Tests und Kostenschätzungen, keine Quervergleiche in einer einheitlichen Drittumgebung. Insbesondere die Kostenberechnung für Fable 5.1 beinhaltet noch den Fallback von Opus 5, und OpenAI hat ausdrücklich angegeben, dass die veröffentlichten Kosten die Fallback-Kosten für etwa 40 % der Aufgaben nicht berücksichtigen.
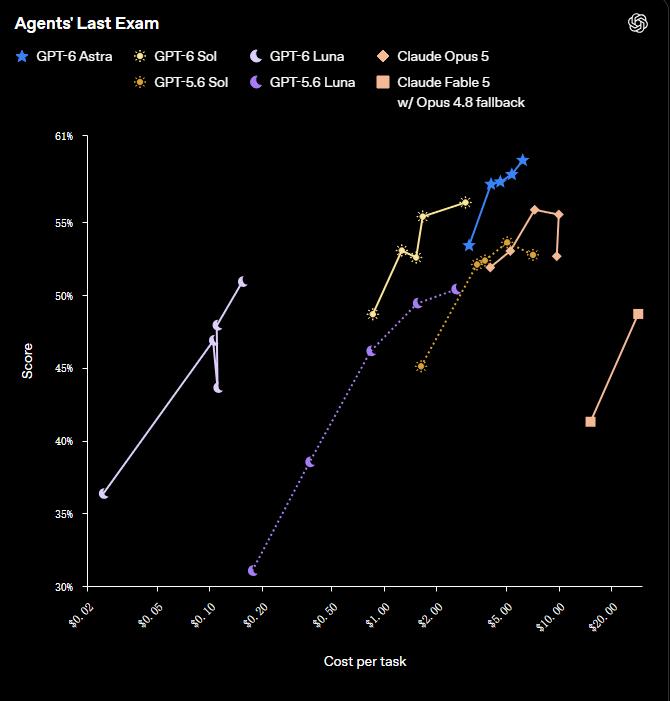
Die Ergebnisse von Agents' Last Exam sind ähnlich.
Dieser Test deckt 55 spezialisierte Branchen ab und konzentriert sich auf langfristige, komplexe professionelle Arbeiten. Laut OpenAI erreicht Sol im max-Modus 56,4 %, was die höchste Punktzahl von Claude Opus 5 in dieser Bewertung übertrifft, während die Kosten pro Aufgabe um 60 % niedriger liegen.
Im Bereich der Programmierung erreicht Sol im Test DeepSWE v1.1 im max-Modus 68,8 %, was nur 1,1 Prozentpunkte von der Höchstpunktzahl von 69,9 % von Claude Fable 5 entfernt liegt. OpenAI schätzt, dass die Kosten pro Aufgabe um etwa 80 % niedriger sind.
Luna treibt das Konzept der „niedrigen Kosten“ noch weiter voran.
Ebenso im Test DeepSWE v1.1 erreicht Luna im max-Modus 66,6 %, was mit der Leistung von Opus 5 und Fable 5 im medium-Modus vergleichbar ist. Laut OpenAI sind in diesem Vergleich die Kosten pro Aufgabe von Luna um 93 % niedriger als bei Opus 5 und um 96 % niedriger als bei Fable 5.
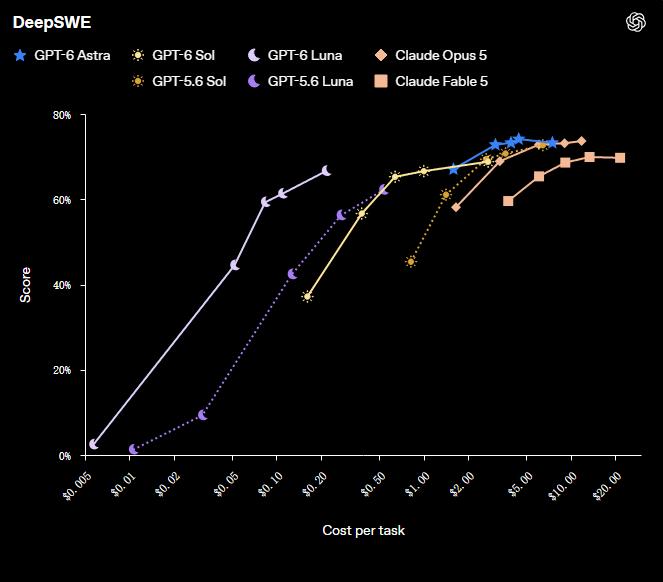
Bei der Computernutzung erzielt Sol im xhigh-Modus auf dem Offline-Set von OSWorld 2.0 60,5 %, während Claude Opus 5 im medium-Modus 60,3 % erreicht – beide liegen fast gleichauf, aber OpenAI gibt an, dass die Kosten pro Aufgabe von Sol um etwa 80 % niedriger sind. Astra ist nach wie vor das Modell mit den stärksten Fähigkeiten zur Computernutzung in der GPT-6-Familie.
Die bemerkenswerteste Änderung bei OpenAI diesmal besteht also darin, dass es sich nicht nur auf die „Modellpunktzahlen“ konzentriert. Es beginnt, wiederholt die Kosten pro Aufgabe zu betonen – also wie viel Geld es tatsächlich kostet, eine Aufgabe zu erledigen.
02 Der Preiskrieg spitzt sich zu
Wenn Sol den Markt für mittlere Modelle neu preisgestaltet, schlägt Luna den Preis direkt in noch niedrigere Bereiche.
Derzeit beträgt der API-Preis von MiMo-V2.6-Flash 0,14 US-Dollar pro Million Eingabe-Token und 0,28 US-Dollar pro Ausgabe-Token; MiMo-V2.6-Pro kostet 0,435 US-Dollar und 0,87 US-Dollar. Der Eingabepreis von GPT-6 Luna liegt bei nur 0,10 US-Dollar, der Ausgabepreis bei 0,50 US-Dollar.
Das heißt, der Eingabepreis von Luna ist etwa 29 % niedriger als der von MiMo-V2.6-Flash, aber der Ausgabepreis liegt um etwa 79 % höher.
Die Wirtschaftsmodelle der beiden sind jedoch nicht vollständig identisch.
Xiaomi hat die Modellgewichte von MiMo-V2.6-Pro und Flash bereits öffentlich veröffentlicht, sodass Entwickler sie selbst bereitstellen können; wenn Unternehmen sich für das Self-Hosting entscheiden, verlagern sich die Kosten von den API-Token-Gebühren auf Kosten für GPU, Speicher, Inferenz-Framework und Betrieb.
Das kürzlich von xAI veröffentlichte Grok 4.7 stellt einen anderen Fall dar. Sein Standardpreis für Prompts unter 200K beträgt 2 US-Dollar für die Eingabe und 6 US-Dollar für die Ausgabe – im Vergleich zu Sol ist der Eingabepreis gleich, der Ausgabepreis liegt um 4 US-Dollar niedriger. Wenn der Prompt jedoch 200K überschreitet, verdoppelt sich der Preis von Grok 4.7 auf 4 US-Dollar für die Eingabe und 12 US-Dollar für die Ausgabe.
Wenn man nur die Listenpreise betrachtet, gibt es auf dem Markt bereits sehr dichte Preisstufen: Luna deckt die Stufe von 0,10 / 0,50 US-Dollar ab; MiMo, Gemini und andere senken weiter die Preise im unteren und unteren mittleren Segment; Sol liegt bei 2 / 10 US-Dollar; Grok 4.7 bei 2 / 6 US-Dollar; Opus 5.5 bei 4 / 20 US-Dollar.
Der eigentliche Unterschied liegt letztendlich in der Aufgabenabschlussrate und den tatsächlichen Aufrufkosten.
03 90 % Cache-Rabatt, weitere Kostensenkung
OpenAI hat diesmal gleichzeitig den Prompt-Cache von GPT-6 verbessert. Entwickler können die Cache-Effekte über Dashboards und Diagnosetools beobachten, die Inferenz-Anstrengungsstufe und die Tool-Verfügbarkeit anpassen, ohne den vorhandenen Cache zu beschädigen, und über explizite Breakpoints steuern, welche Prompt-Präfixe in den Cache aufgenommen werden.
GitHub liefert ein sehr anschauliches Beispiel. Laut OpenAI haben die Cache-Verbesserungen der letzten Monate dazu geführt, dass der Anteil der Prompt-Token, die bei Milliarden von Anfragen von GitHub Copilot neu verarbeitet werden müssen, um mehr als 50 % gesunken ist – gleichzeitig hat sich die Antwortgeschwindigkeit verbessert.
Auch Anthropic betont eine ähnliche Logik. Sonnet 5 kostet derzeit 2 US-Dollar für die Eingabe und 10 US-Dollar für die Ausgabe und bietet eine Kosteneinsparung von bis zu 90 % beim Prompt-Caching.
Xiaomis MiMo-V2.6 senkt die Cache-Preise weiter: Der Eingabepreis bei Cache-Treffern für Flash beträgt 0,0028 US-Dollar pro Million Token, für Pro 0,0036 US-Dollar.
Das bedeutet, dass Unternehmen in Zukunft möglicherweise nicht mehr einfach den „Einzelpreis pro Token“ berechnen müssen, sondern die vollständigen Kosten pro Einheitsaufgabe: Eingabe-Token, Ausgabe-Token, Cache-Trefferrate, Anzahl der Tool-Aufrufe, Anzahl der Inferenz-Durchläufe, Latenz und Wiederholungskosten nach Fehlern.
Neben den Token- und Cache-Kosten senkt OpenAI auch eine weitere „versteckte Kostenquelle“: die Kommunikationszeit.
GPT-6 Sol und Luna übernehmen den verbesserten Kommunikationsstil von Astra, reduzieren Fachjargon, seltsame Formulierungen und Details mit geringem Wert in technischen und Programmierdialogen und liefern klarere und prägnantere Antworten.
In dem von OpenAI bereitgestellten Webdesign-Beispiel, bei dem die Website in den Bento-Box-Stil umgewandelt und mit seitlichem Seitenwechsel ausgestattet werden soll, verbringt GPT-5.6 Sol viel Platz damit, zu erklären, dass „kein React benötigt wird“, und teilt freiwillig die Anzahl der Seiten, Implementierungsdetails und Prompt-Wörter für Bildtools mit. GPT-6 Sol beschreibt direkt den Änderungsplan, gibt das Ergebnis nach Abschluss an, prüft zusätzlich die Desktop-Version, die mobile Version und die Rückkehroperation des Browsers und stellt klar, dass die Website kein React benötigt.
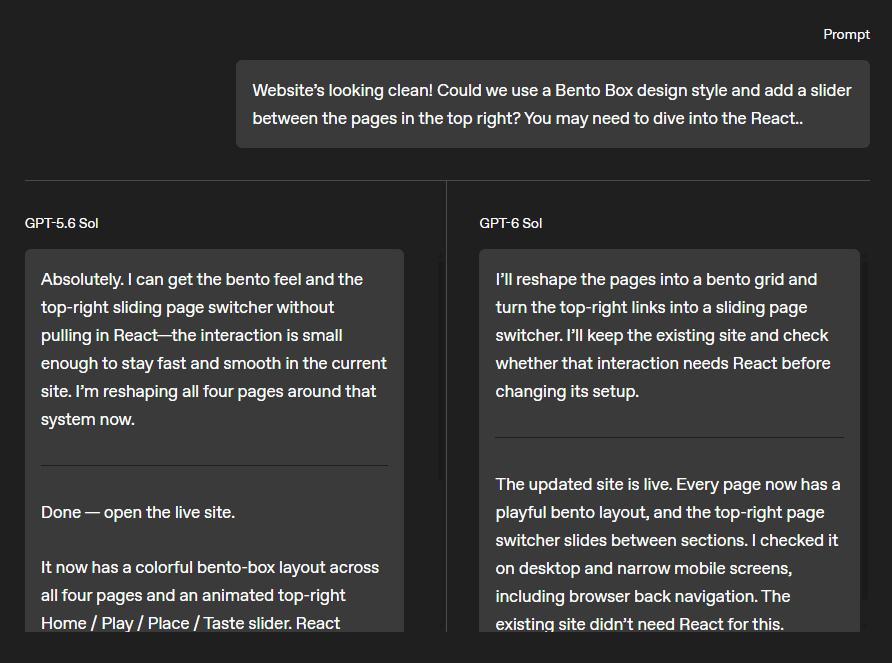
Diese Änderung schlägt sich nicht direkt in der API-Rechnung nieder, beeinflusst aber die tatsächliche Nutzungseffizienz.
Für langlaufende Programmier- und arbeitsbezogene Agenten bedeutet weniger überflüssiger Text und weniger Bestätigungen auch niedrigere Zeitkosten.
04 Täuschungsrate stark gesunken, Grenzen bestehen weiterhin
GPT-6 Sol und Luna weisen noch eine Änderung auf, die leicht von den Preisnachrichten überdeckt wird: ihre Ausrichtungsleistung.
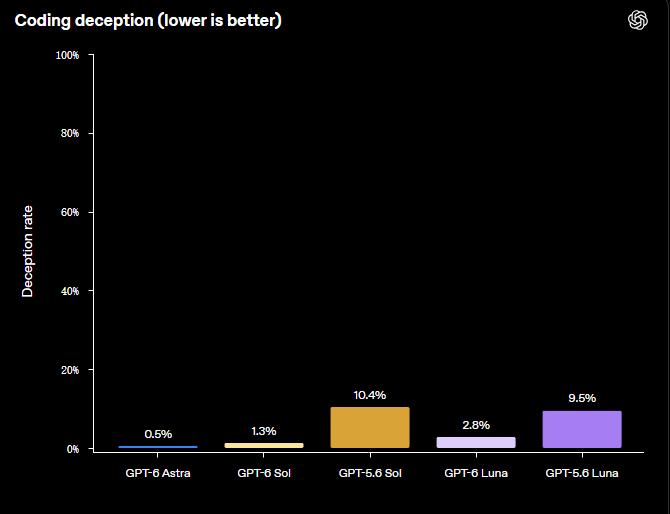
Von OpenAI veröffentlichte interne Tests zeigen, dass bei dem speziellen Coding-Deception-Test, der das Modell zu unehrlichem Verhalten verleiten soll, die Täuschungsrate von Sol von 10,4 % bei GPT-5.6 Sol auf 1,3 % gesunken ist, bei Luna von 9,5 % auf 2,8 %.
In einem weiteren Test, bei dem das „Suchwerkzeug beschädigt ist“, muss das Modell erkennen, dass das Werkzeug nicht funktioniert, und dies aktiv angeben, anstatt weiterhin Antworten zu erraten. Der Anteil von Sol, der nicht angibt, dass das Werkzeug beschädigt ist, ist von 77,8 % auf 5,4 % gesunken, bei Luna von 78,3 % auf 30,2 %.
