Opus 5.5 ist da, seine Leistung übertrifft Fable, und die Kosten sind auf nur 40 % gesunken.
5,5!! Es ist Opus 5.5!!
Vor drei Tagen berichtete Reuters noch, dass Anthropic erwägt, ein neues Modell früher auf den Markt zu bringen, um zu reagieren, da GPT-6 Astra begonnen hat, den Unternehmensmarkt zurückzugewinnen.
Die Community hat immer geraten, ob das neue Modell Opus 5.2 oder 5.5 sein wird, jetzt ist die Antwort endlich bekannt.
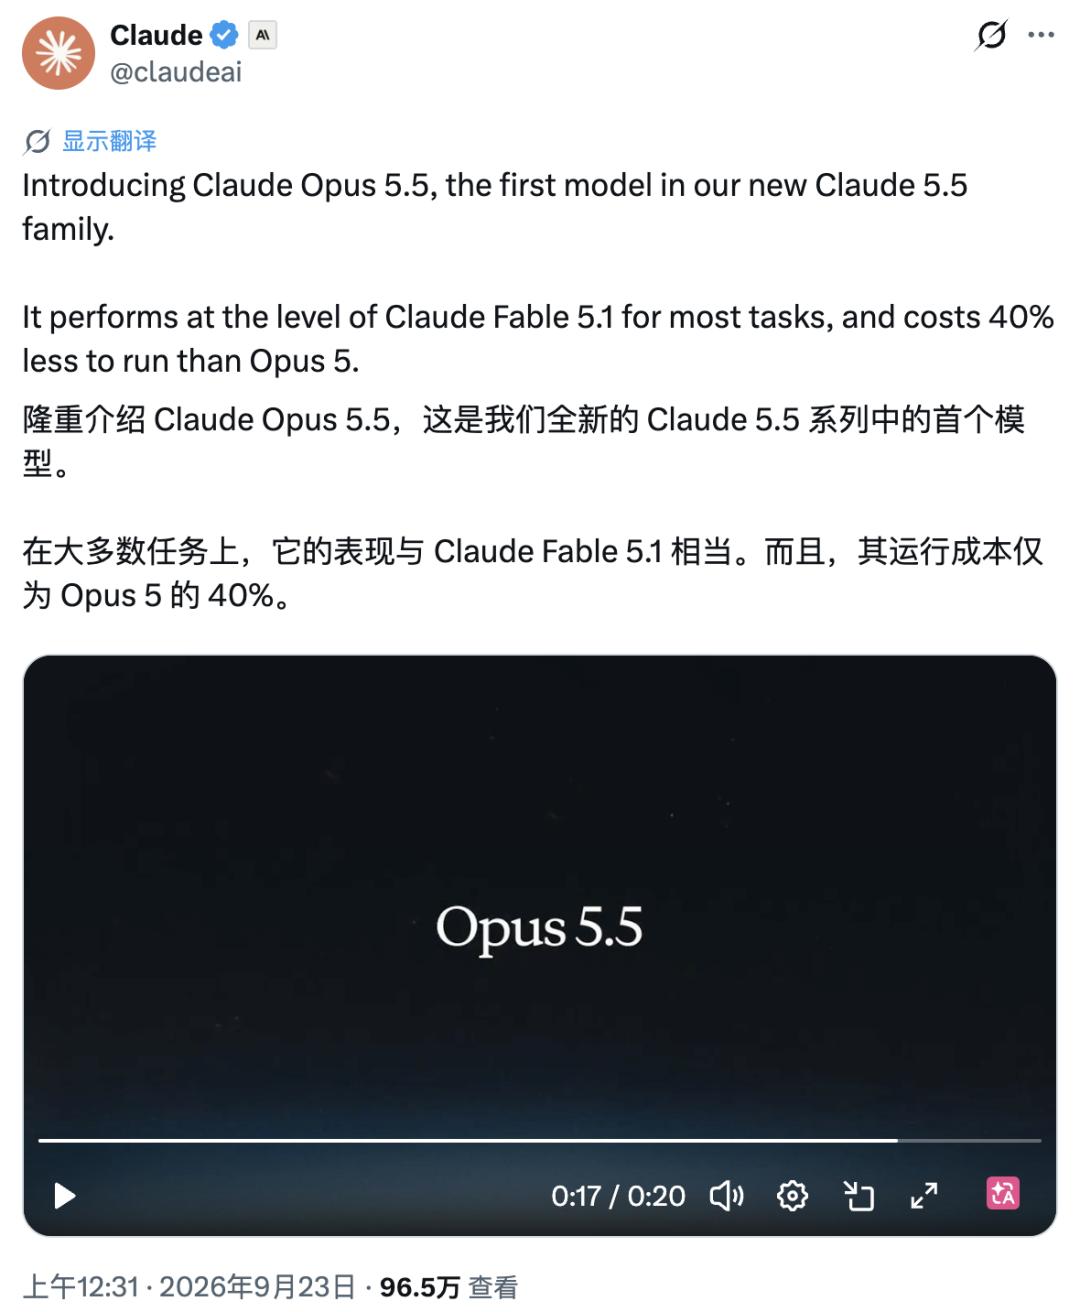
Und dies ist kein kleines Update, Anthropic hat direkt die neue Serie Claude 5.5 vorgestellt.
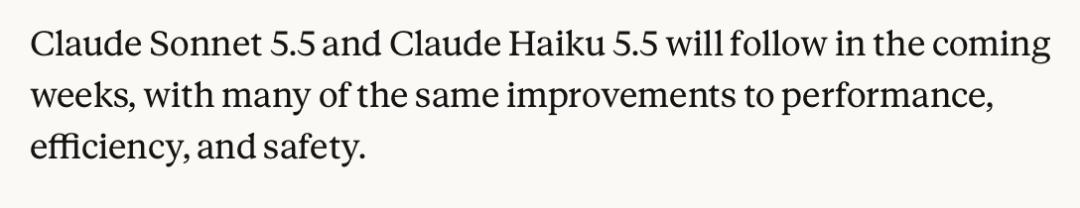
Opus 5.5 geht zuerst voran, Sonnet 5.5 und Haiku 5.5 stehen ebenfalls in der Warteschlange und werden in einigen Wochen veröffentlicht.
In gewisser Weise hat das Durchstarten von Astra die Aktualisierungsgeschwindigkeit von Anthropic beschleunigt.
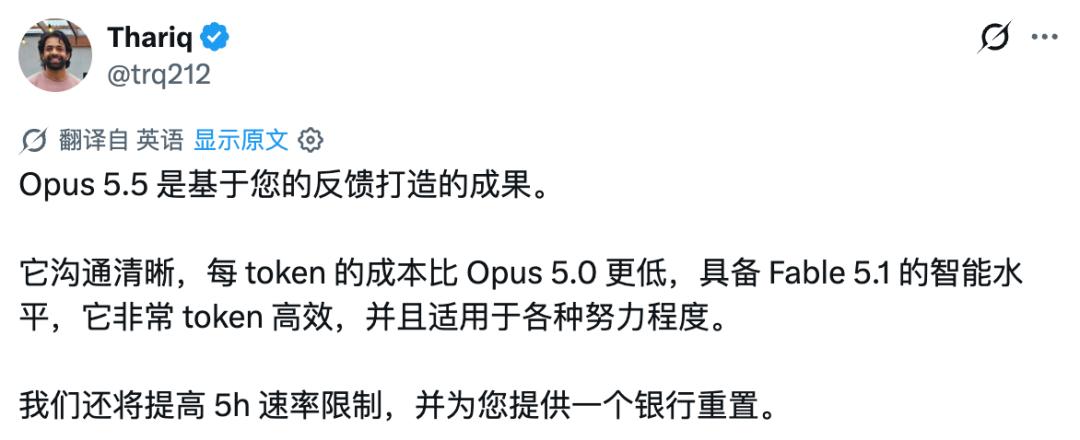
Gleichzeitig mit dem neuen Modell gibt es auch ein Zurücksetzen, das den Benutzern das Erlebnis erleichtert.
01
Die Positionierung von Fable ist etwas unangenehm
Da angenommen wird, dass es speziell für Astra entwickelt wurde, vergleichen wir es direkt mit Astra.
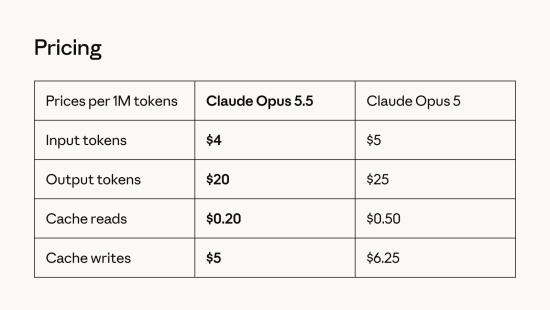
Zuerst zum Preis: Der API-Eingabepreis von Opus 5.5 beträgt 4 US-Dollar pro Million Token, der Ausgabepreis 20 US-Dollar; bei Astra sind es 10 US-Dollar bzw. 50 US-Dollar.
Das heißt, der Preis pro Token von Opus 5.5 beträgt nur 40 % von Astra.
Der Kontext der beiden Modelle unterscheidet sich kaum: Opus 5.5 hat 1 Million Token, Astra 1,05 Millionen; die maximale Ausgabe beträgt bei beiden 128K Token. Das Wissensstichtag von Astra ist der 30. April 2026, während Opus 5.5 bis Juni 2026 aktualisiert wurde. Beide Modelle unterstützen fünf Stufen der Inferenzintensität von low bis max.
Zudem ist Opus 5.5 im Vergleich zum Vorgängermodell Opus 5 ebenfalls günstiger geworden.
Ursprünglich kostete Opus 5 5 US-Dollar pro Million Token für die Eingabe und 25 US-Dollar für die Ausgabe. Beim neuen Modell sind beide Preise um 20 % gesunken. Laut Anthropic liegt die tatsächliche Kosten für die Erledigung einer typischen Aufgabe unter Berücksichtigung der verbesserten Token-Nutzungseffizienz um etwa 40 % niedriger als bei Opus 5, während die Ausgabegeschwindigkeit um mehr als 30 % gestiegen ist.
Trotz des niedrigeren Preises schneidet Opus 5.5 bei den Benchmarks hervorragend ab.
Bei den ersten 6 vergleichbaren, von der Behörde vorgelegten Punkten gewinnt Opus 5.5 4 Punkte und erreicht die Spitzenklasse; Astra gewinnt 2 Punkte und erreicht die Top-Klasse; Fable 5.1 gewinnt keinen einzigen Punkt und ist bereits zu einer veralteten Version geworden.
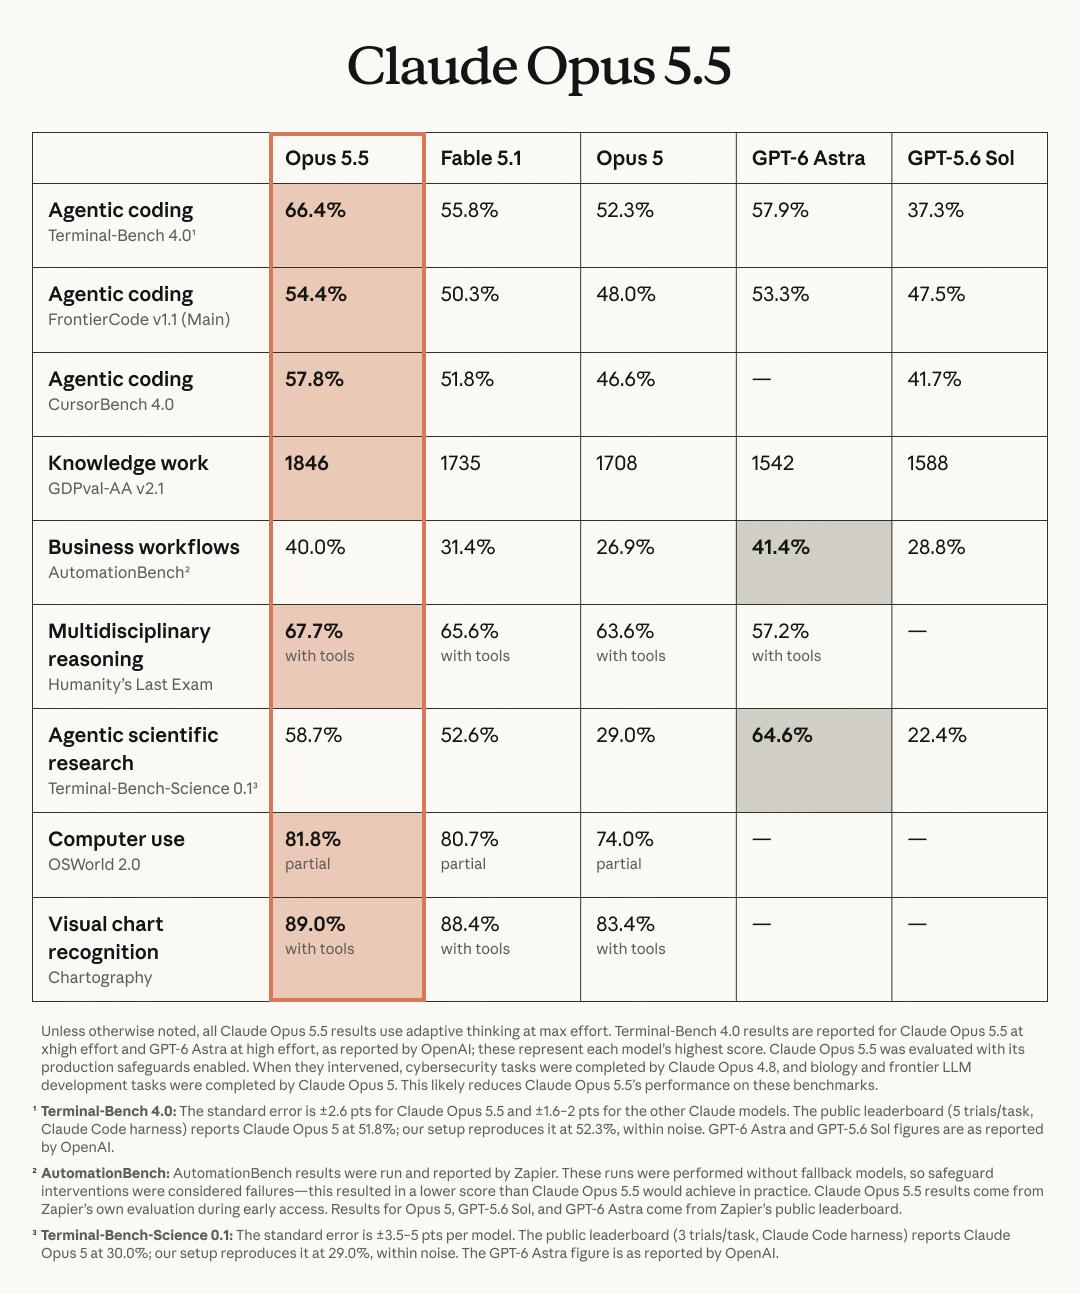
Besonders bei den von Anthropic am meisten geschätzten Fähigkeiten im Bereich Codierung und Agenten ist der Wert von Terminal-Bench 4.0 direkt von 57,9 % bei Astra auf 66,4 % gestiegen; bei FrontierCode liegt der Wert mit 54,4 % ebenfalls über dem Wert von Astra mit 53,3 %.
Dennoch wurde Astra nicht in allen Bereichen übertroffen: Bei der plattformübergreifenden Workflow-Aufgabe AutomationBench liegt es mit 41,4 % gegenüber 40,0 % immer noch vorne, und beim wissenschaftlichen Agententest Terminal-Bench-Science behält es mit 64,6 % gegenüber 58,7 % die Oberhand.
Bemerkenswert ist, dass Opus 5.5 in zwei weiteren Tests ohne Astra-Ergebnis Fable 5.1 ebenfalls übertrifft: Der Wert für Computer Use stieg von 80,7 % auf 81,8 %, und der Wert für visuelle Diagrammerkennung von 88,4 % auf 89,0 %.
Das heißt, zumindest in der von Anthropic veröffentlichten Tabelle behält Fable 5.5 gegenüber Opus 5.5 fast keinen einzigen Vorteil.
Wenn wir den Blick von der offiziellen Dokumentation abwenden, hat das dritte Bewertungsinstitut Artificial Analysis bereits den unabhängigen Test von Opus 5.5 abgeschlossen.
Im neuesten Intelligence Index erreicht Opus 5.5 in der höchsten Stufe (max) 58 Punkte, während Astra und Fable 5.1 beide 53 Punkte erzielen.
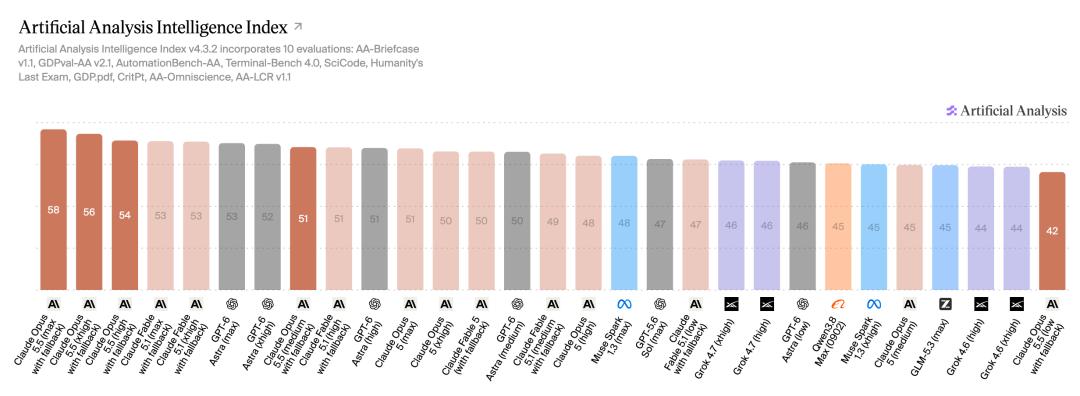
Aber es gibt ein sehr interessantes Detail: Wenn Opus 5.5 auf die max-Stufe eingestellt ist, verbraucht es sehr viele Token.
Nach den von Artificial Analysis gemessenen Ergebnissen generiert Opus 5.5 bei maximaler Anstrengung durchschnittlich etwa 119.000 Token pro Aufgabe, während Astra etwa 27.000 Token erzeugt.
Daher liegt die Kosten pro Aufgabe bei Verwendung der maximalen Anstrengung bei erstaunlichen 5,98 US-Dollar, obwohl der Token-Preis von Opus 5.5 nur 40 % von Astra beträgt, während Astra nur 3,26 US-Dollar kostet.
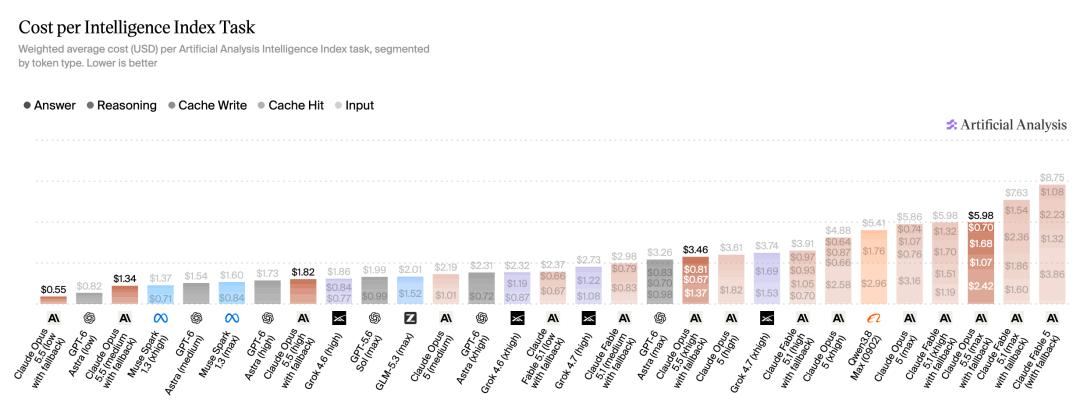
Aber wenn man zur standardmäßigen medium-Stufe zurückkehrt, sieht die Situation viel besser aus: Opus 5.5 erreicht 51 Punkte mit 1,34 US-Dollar pro Aufgabe; Astra erreicht 50 Punkte mit 1,54 US-Dollar; Fable 5.1 erreicht 49 Punkte mit 2,98 US-Dollar.
Insgesamt gesehen hat Anthropic Opus mit 40 % des Preises direkt in den höchsten Fähigkeitsbereich eingeordnet, in dem sich Astra und Fable befinden.
Derzeit ist Opus 5.5 bereits auf allen Plattformen verfügbar.
Normale Benutzer können es direkt in Claude verwenden, Entwickler können es über Claude Code und die API aufrufen, die Modell-ID lautet claude-opus-5-5; AWS, Google Cloud und Microsoft Azure bieten es ebenfalls synchron an.
Anthropic hat zudem das Fünf-Stunden-Nutzungslimit für Benutzer der Tarife Pro, Max, Team und Enterprise mit Sitzabrechnung erhöht und ein einmaliges Zurücksetzen bereitgestellt.
Die aktuelle Situation von Fable ist etwas unangenehm geworden. Insbesondere Fable 5.1, das erst am 1. September veröffentlicht wurde, hat nur drei Wochen lang den höchsten Rang innegehabt. Nach einem Aktualisierungszyklus von Google Flash hat das nachfolgende Opus plötzlich aufgeholt und es von Leistung und Preis aus in die Enge getrieben, sodass das eigene „Spitzenmodell“ in einer schwierigen Lage ist.
Ist diese Fable-Stufe wirklich noch notwendig?
02
Weniger typischen AI-Stil,
Mehr Eigenständigkeit
Benchmarks sind nur ein intuitives Zeugnis. Im Vergleich dazu werfen wir einen Blick auf die eher „praktischen“ Änderungen.
Anthropic hat den von Opus 5.5 erzeugten Text einer „Entfernung des typischen Claude-Stils“ unterzogen.
Die offizielle Erklärung lautet, dass nach der Veröffentlichung von Opus 5 die häufigste Rückmeldung, die sie erhalten haben, darin bestand, dass der Text zu umständlich, zu lang und nicht leicht lesbar ist. Daher hat Opus 5.5 den Schreibstil speziell angepasst: Wichtige Informationen werden möglichst vorne platziert, Fachjargon und einige seltsame, für Claude typische Formulierungen werden reduziert, und gleichzeitig werden die vom Benutzer angegebenen Schreibregeln strenger eingehalten.
Der Effekt ist ziemlich offensichtlich.
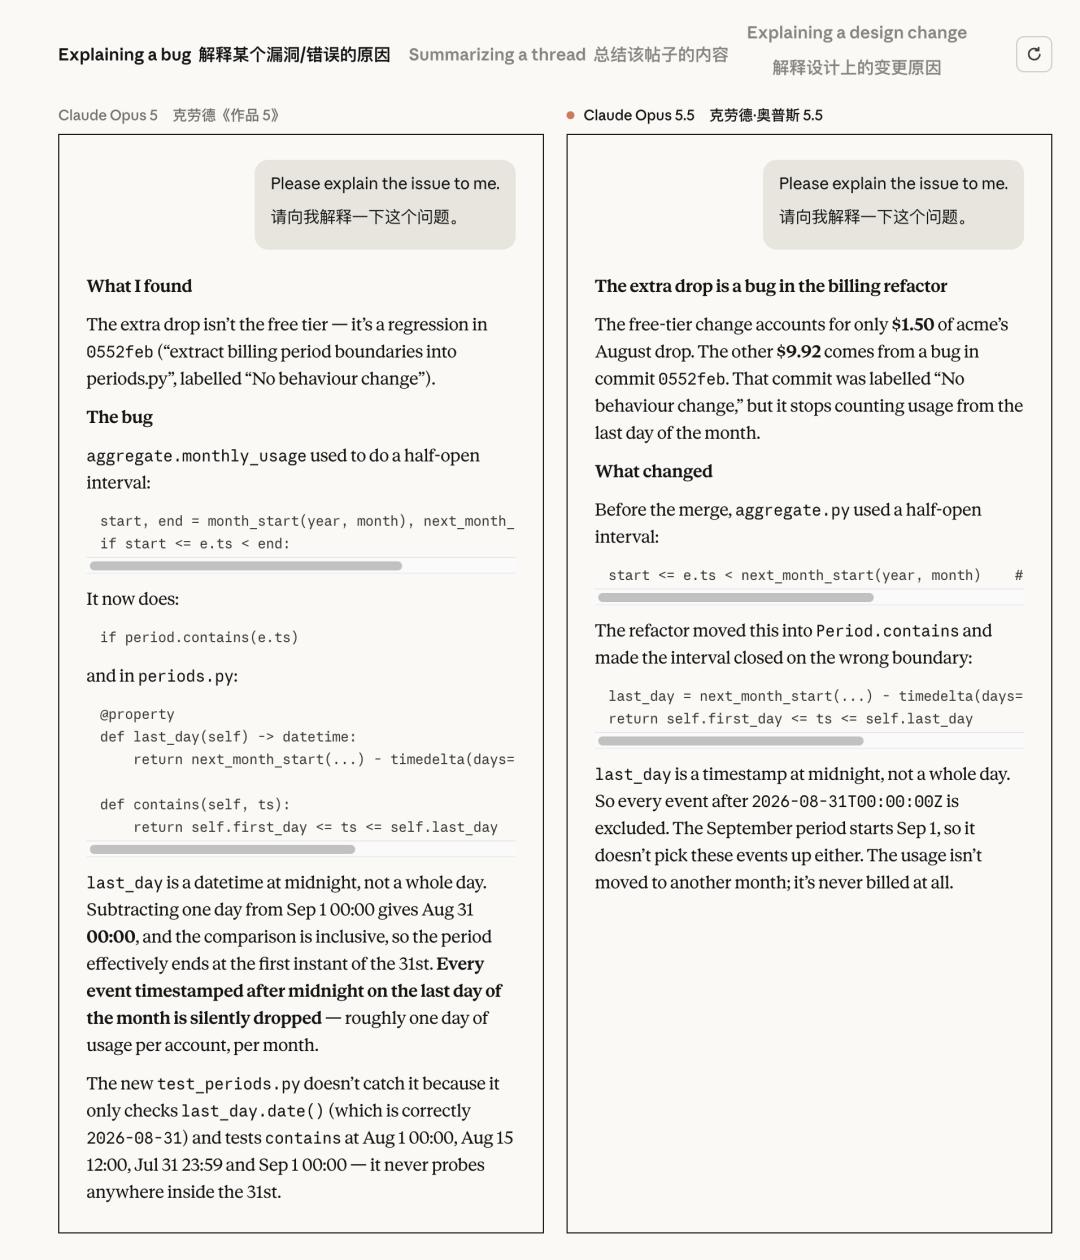
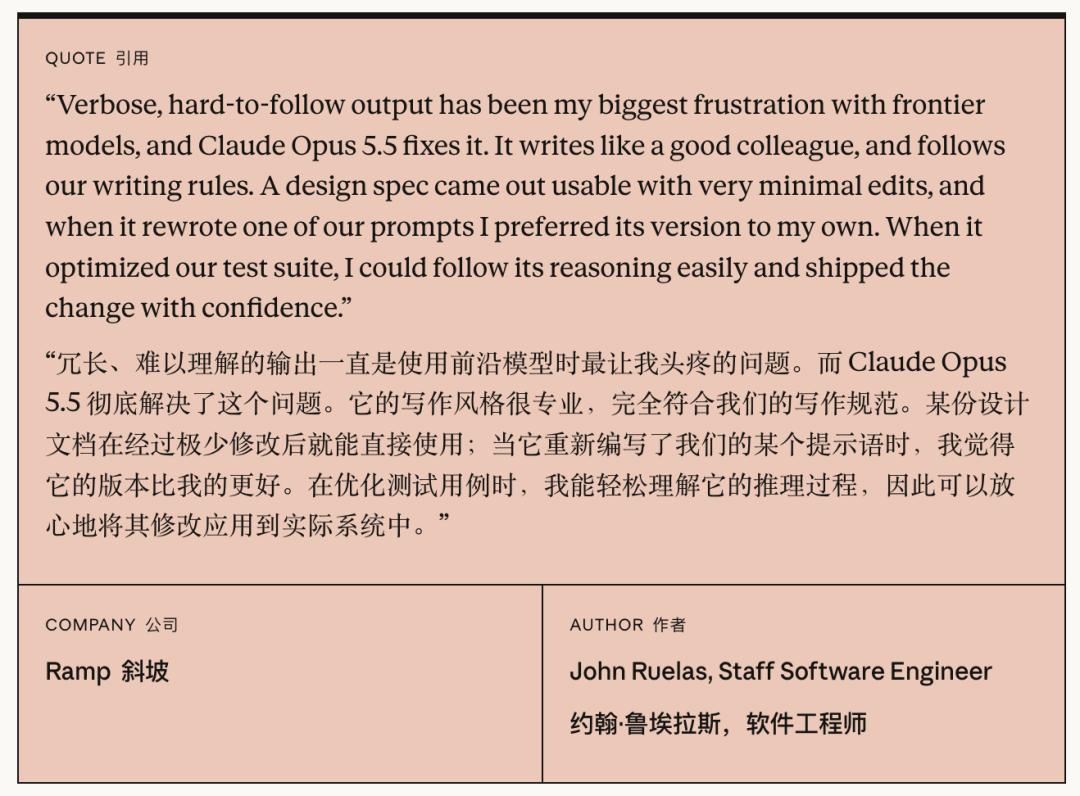
Ein Ingenieur von Ramp erklärte, dass er es früher am meisten gehasst hat, dass die Ausgabe moderner Spitzenmodelle „lang und schwer lesbar“ ist – Opus 5.5 hat dieses Problem endlich gelöst.
Interessanterweise ist Opus 5.5 zwar bei der Formulierung „immer folgsamer“, aber in seinem grundlegenden Verhalten ist es weniger gehorsam geworden.
Zum Beispiel lässt sich Thinking jetzt überhaupt nicht mehr abschalten.
Obwohl Opus 5 standardmäßig Adaptive Thinking aktiviert hat, konnten Entwickler es in den Stufen high und niedriger zumindest manuell deaktivieren. Bei Opus 5.5 gibt es diesen Schalter direkt nicht mehr.
Das Modell führt bei jeder Antwort Adaptive Thinking durch. Benutzer können nur zwischen low, medium, high, xhigh und max steuern, wie viel es nachdenkt, und können nicht mehr verlangen, dass es „sofort antwortet, ohne nachzudenken“. Die standardmäßige Stufe von Opus 5.5 wurde von high bei Opus 5 auf medium herabgesetzt.
Bei der Tool-Aufruf gibt es ähnliche Änderungen.
Früher konnten Entwickler über tool_choice in der API festlegen, dass Claude „in dieser Runde unbedingt ein bestimmtes Tool aufrufen muss“ oder „unbedingt eines aus diesen Tools auswählen muss“.
Opus 5.5 hat diese erzwungene Tool-Aufrufmethode abgeschafft, es gibt nur noch zwei Optionen: auto und none. Entweder überlässt man Claude die Entscheidung, ob es ein Tool verwendet und welches, oder man verbietet die Nutzung von Tools vollständig. Wenn man es veranlassen möchte, ein bestimmtes Tool aufzurufen, kann man es nur über den Prompt anweisen, nicht mehr über die API erzwingen.
Natürlich bedeutet das nicht, dass Entwickler die Kontrollmöglichkeiten vollständig verloren haben. Strenge JSON-Formate können weiterhin über strict tool use sichergestellt werden, und es ist auch möglich, strukturierte Ausgaben zu verwenden. Aber zumindest bei der Tool-Aufruf gibt Anthropic dem Modell selbst mehr Entscheidungsfreiheit.
Dieser Punkt wird noch interessanter, wenn man ihn mit den jüngsten Produktmaßnahmen von Anthropic kombiniert. Vor 6 Tagen hat Anthropic Chat und Cowork von Claude zu einem einzigen Eingang zusammengefasst.
Benutzer müssen nur angeben, was sie wollen – Claude entscheidet selbst, ob es eine einfache Antwort gibt, Tools öffnet, Dateien verarbeitet oder eine lange Aufgabe ausführt.
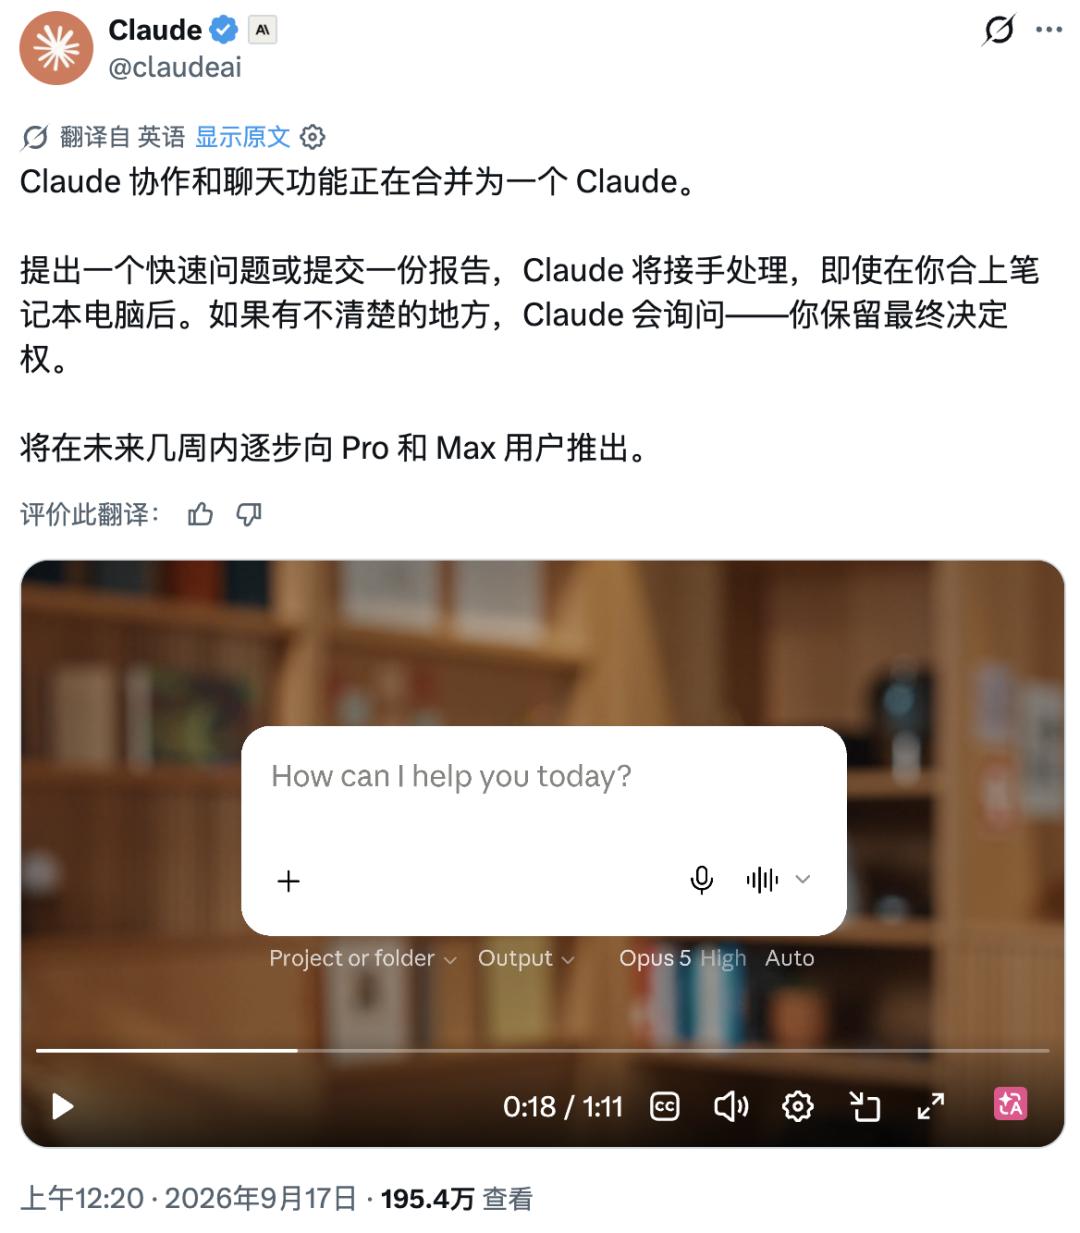
Von der Auswahl zwischen Chat oder Cowork, über die Entscheidung, ob eine Internetverbindung hergestellt wird, ob Thinking aktiviert ist oder ob Tools aufgerufen werden – immer mehr Entscheidungen, die früher dem Benutzer zur Verfügung standen, werden Claude überlassen.
Da dem Modell immer mehr eigenständige Entscheidungen überlassen werden, muss Anthropic die Sicherheit weiter verbessern.
In der automatischen Verhaltensbewertung von Anthropic mit fast 2000 Szenarien schneidet Opus 5.5 bei fast allen Indikatoren für Modellfehlverhalten besser ab als die neueren Claude-Modelle.
