GPT-6 Sol und Claude Opus 5.5 konkurrieren am selben Tag miteinander, wer ist der „König des Preis-Leistungs-Verhältnisses“
Gerade eben haben OpenAI und Anthropic fast gleichzeitig neue Modelle vorgestellt: OpenAI bringt GPT-6 Sol und GPT-6 Luna auf den Markt; Anthropic veröffentlicht Claude Opus 5.5, dessen Leistung direkt an Fable 5.1 heranreicht.
Laut OpenAI basieren GPT-6 Sol und GPT-6 Luna auf dem zuvor führenden Grundgerüst von GPT-6 Astra. Der Schwerpunkt liegt darauf, die Kernvorteile von Astra im Bereich Schlussfolgerung und Multimodalität nach unten zu verlagern und eine leichtere Version mit höherem Durchsatz neu zu gestalten. Das heißt, GPT-6 Astra übernimmt die Rolle der Fähigkeitserforschung, während Sol und Luna die Aufgabe der skalierten Anwendung dieser Fähigkeiten übernehmen.
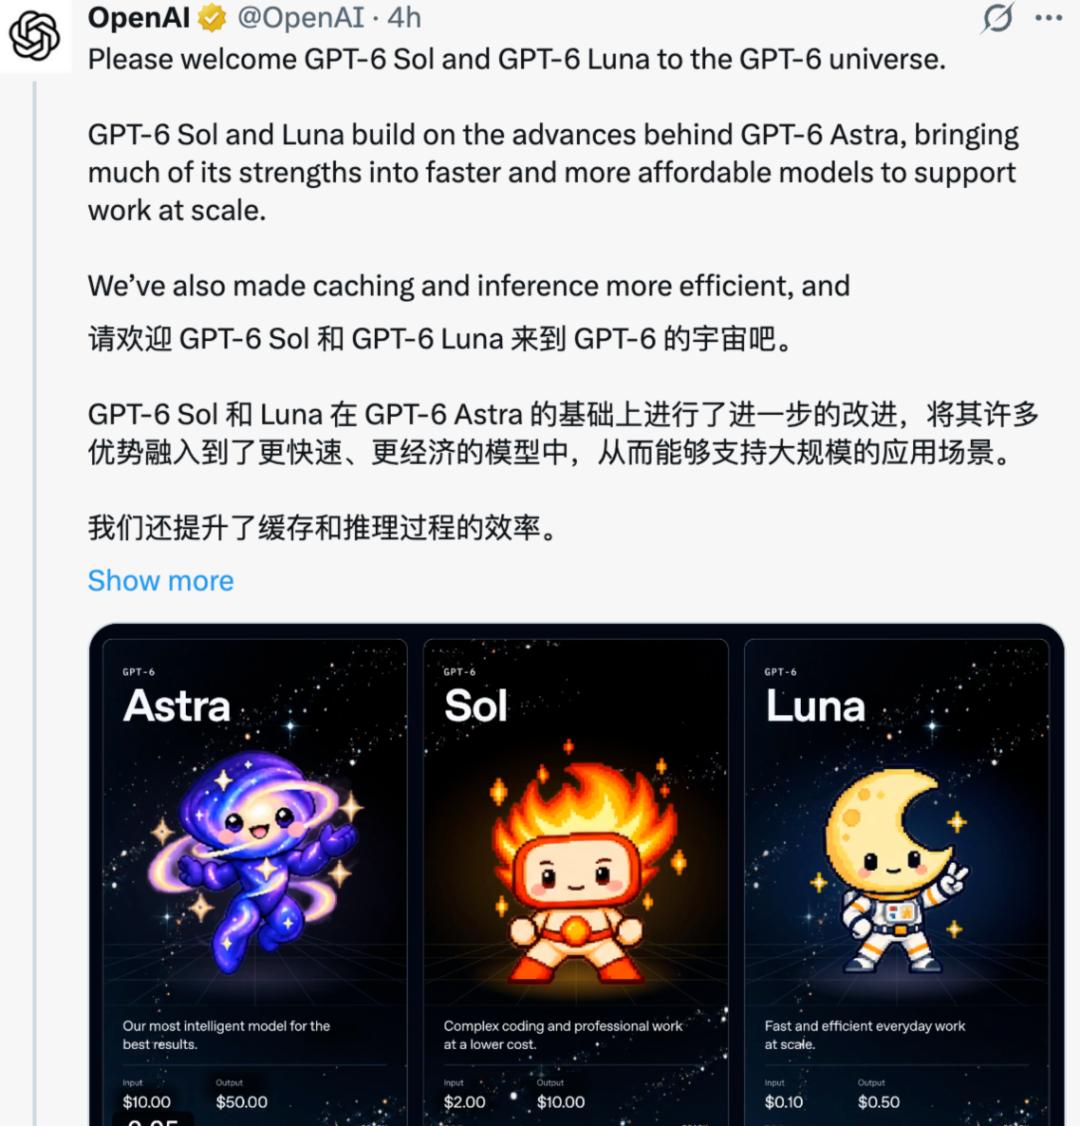
Der Preis wird direkt halbiert: Im Vergleich zum Aktionspreis von GPT-5.6 sinken die Preise von Sol und Luna um 50 %.
Anschließend veröffentlichte Sam Altman einen Beitrag auf sozialen Plattformen und betonte, dass dies der notwendige Weg für OpenAI ist, die „allgemeine Zugänglichkeit von Intelligenz“ voranzutreiben – damit Entwickler nicht mehr von teuren Rechenleistungskosten eingeschränkt werden.
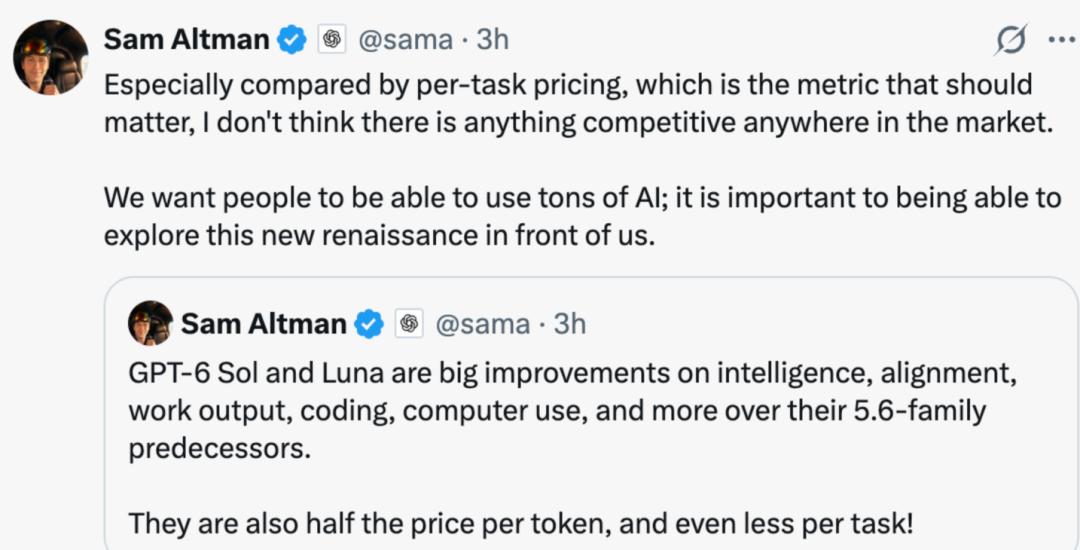
„Insbesondere beim Vergleich der Kosten pro Aufgabe (per-task pricing) – und das ist der Indikator, auf den wir unserer Meinung nach wirklich achten sollten – bin ich der Ansicht, dass derzeit kein Produkt auf dem Markt echte Wettbewerbsfähigkeit aufweist.
Wir hoffen, dass Menschen KI in großem Umfang nutzen können, da dies für die Erkundung dieser neuen „Renaissance“ vor uns sehr wichtig ist. Nur wenn mehr Menschen KI umfassend nutzen können, lassen sich die Möglichkeiten dieser technologischen Umwälzung wirklich freisetzen.“
Das von Anthropic vorgestellte Modell ist hingegen Claude Opus 5.5.
Als Hochleistungsmodell der Claude-Serie setzt Opus 5.5 die Schwerpunktlegung von Anthropic in den Bereichen komplexe Aufgaben, Codegenerierung und Unternehmensworkflows fort.
Laut Anthropic sinken die Kosten von Opus 5.5 bei typischen Aufgaben im Vergleich zu Opus 5 um etwa 40 %, und die Ausgabegeschwindigkeit steigt um mehr als 30 %.
Im Folgenden werfen wir einen genauen Blick darauf.
OpenAI stellt GPT-6 Sol und Luna vor:
Astra-Fähigkeiten für die skalierte Anwendung verfügbar machen, Preis wird halbiert
Laut OpenAI wurde GPT-6 Astra Anfang dieses Monats vorgestellt, das intelligenteste und am besten ausgerichtete Modell der Welt. Da die realen Arbeitsaufgaben jedoch unterschiedliche Umfänge, Rhythmen und Budgetanforderungen aufweisen, werden GPT-6 Sol und GPT-6 Luna eingeführt.
Wenn GPT-6 Astra eine neue Generation intelligenter Modelle einleitet, ermöglichen diese beiden Modelle durch die Verbesserung der Kosteneffizienz, dass mehr Menschen diese intelligente Fähigkeit nutzen können.
OpenAI ist der Ansicht, dass die Verbesserung der Modellfähigkeiten zwar wichtig ist, aber die Kosten pro Aufgabe ebenfalls ein wichtiger Faktor für Unternehmen bei der Bereitstellung von KI sind. Daher wurden diesmal vor allem der Caching-Mechanismus und die Effizienz der Schlussfolgerung optimiert, und die eingesparten Kosten werden an die Nutzer weitergegeben.
Blog-Link: https://openai.com/index/introducing-gpt-6-sol-and-luna/
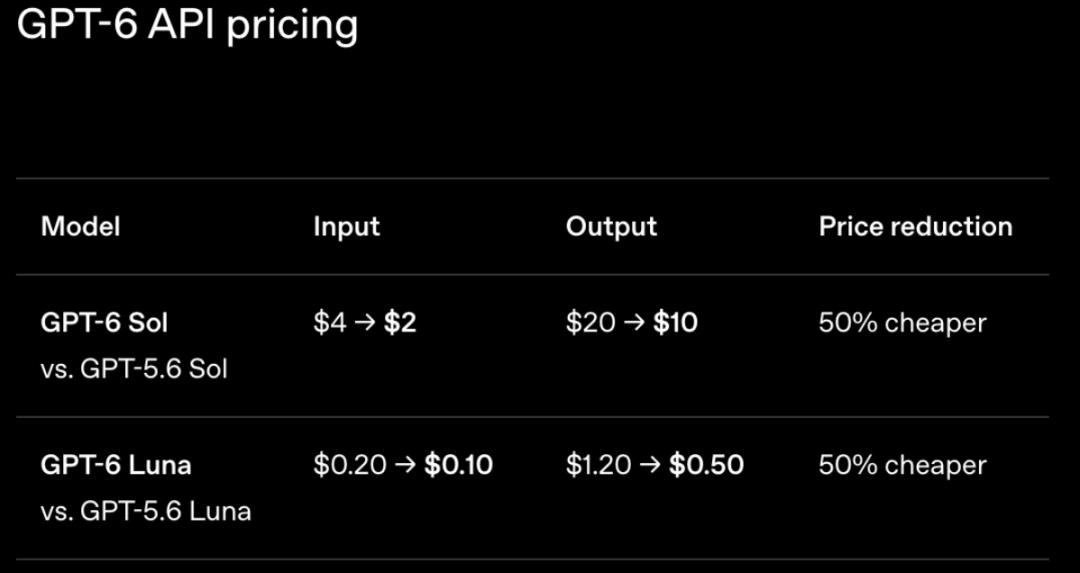
Im Vergleich zu GPT-5.6 sinken die API-Preise von GPT-6 Sol und Luna um 50 %.
GPT-6 Sol: Der Eingabepreis sinkt von 4 USD pro Million Token auf 2 USD; der Ausgabepreis sinkt von 20 USD pro Million Token auf 10 USD.
GPT-6 Luna: Der Eingabepreis sinkt von 0,20 USD pro Million Token auf 0,10 USD; der Ausgabepreis sinkt von 1,20 USD pro Million Token auf 0,50 USD.
Die Preise sind gesunken, aber die Leistung ist nach wie vor überzeugend.
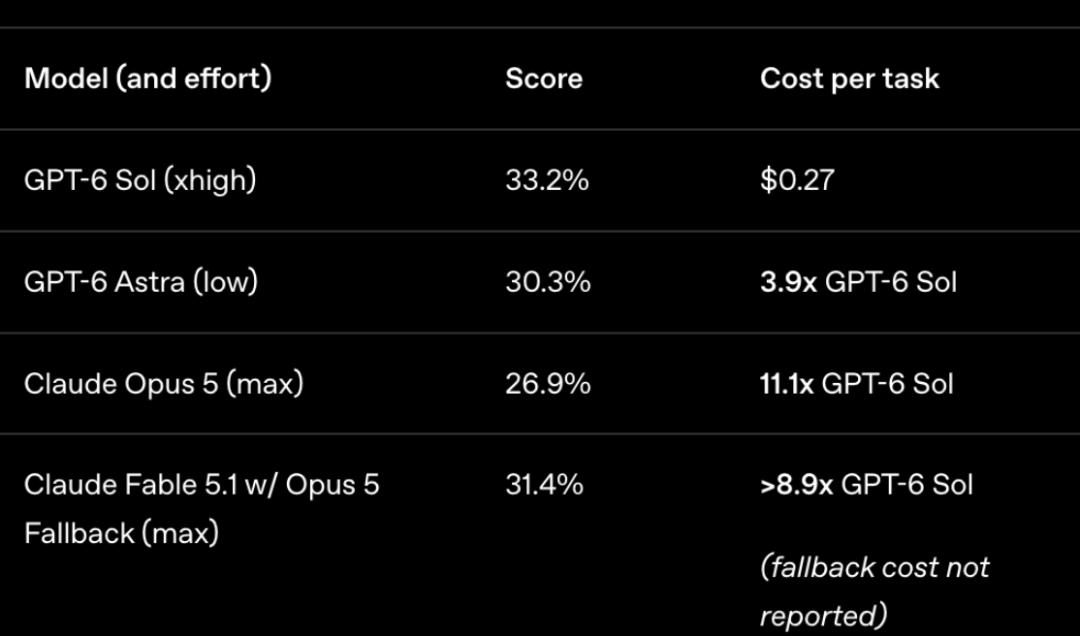
Im AutomationBench-Test (der unternehmensweite Workflows über verschiedene Anwendungen hinweg bewertet) übertrifft GPT-6 Sol bei höchster Schlussfolgerungsintensität (xhigh effort) die Höchstleistung von Claude Opus 5, während die Kosten pro Aufgabe nur 9 % von denen von Opus 5 betragen.
Bei hoher Schlussfolgerungsintensität hingegen verbessert sich GPT-6 Luna im Vergleich zum Vorgängermodell um 5,4 Prozentpunkte, während die Kosten pro Aufgabe um 58 % sinken.
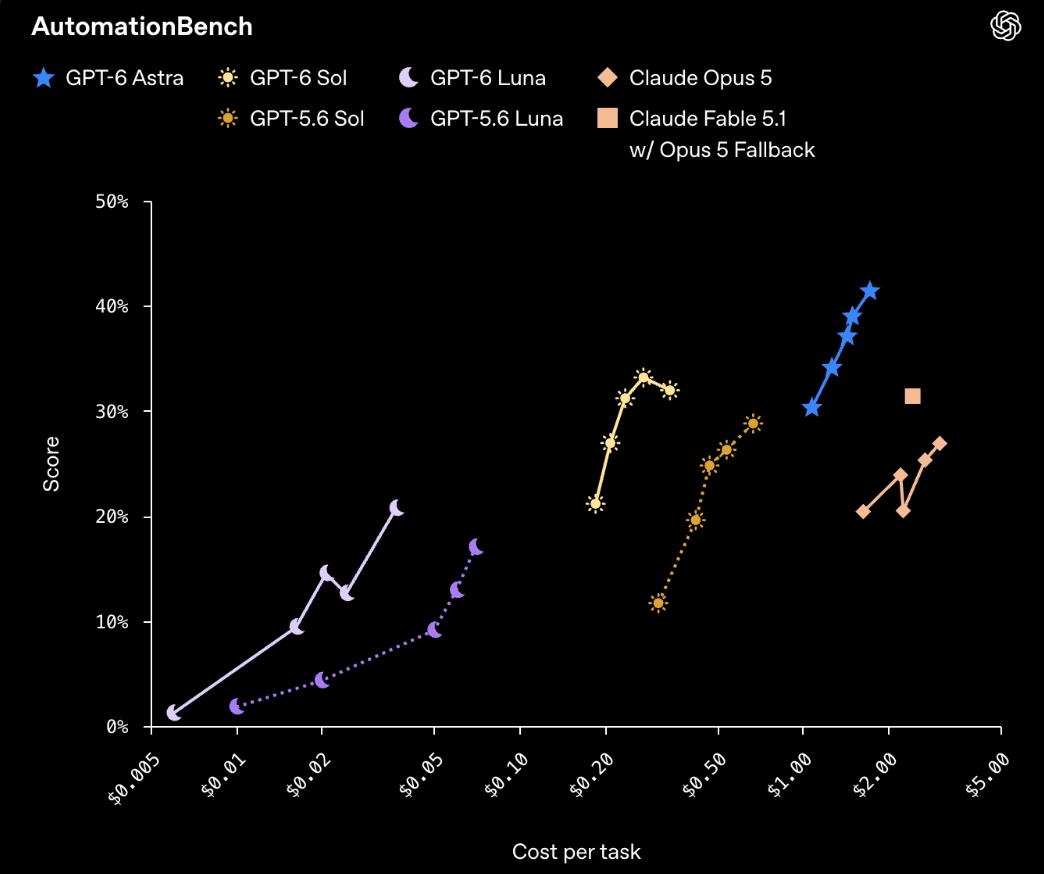
Gleichzeitig übertrifft GPT-6 Sol Claude Fable 5.1 zu niedrigeren Kosten und übertrifft sogar GPT-6 Astra bei niedriger Schlussfolgerungsintensität.
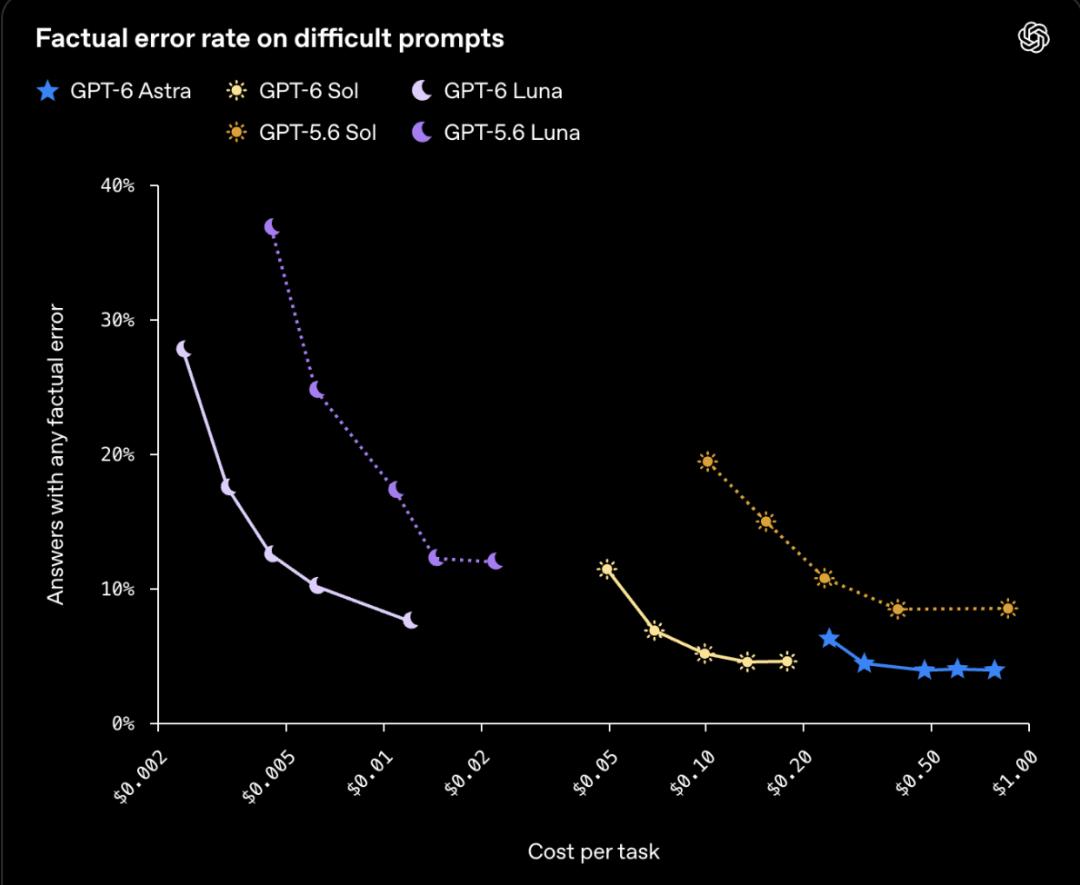
Bei internen Tests zur Faktenrichtigkeit, die auf anonymisierten echten Nutzerdialogen basieren (in denen Nutzer zuvor Modellfehler markiert haben), beträgt die Anzahl der Fehler von GPT-6 Sol etwa die Hälfte der des Vorgängermodells, erreicht eine Zuverlässigkeit nahe dem Niveau von Astra und ist gleichzeitig kostengünstiger.
Auch GPT-6 Luna weist deutliche Verbesserungen auf: Bei höherer Schlussfolgerungsintensität erreicht es das Niveau von GPT-5.6 Sol zu etwa einem Hundertstel der Kosten.
Eine weitere wichtige Veränderung zeigt sich im Bereich der Softwareentwicklung: Da Coding Agent zunehmend komplexere Aufgaben übernimmt, werden die laufenden Betriebskosten zu einem wichtigen Faktor für Entwicklungsteams.
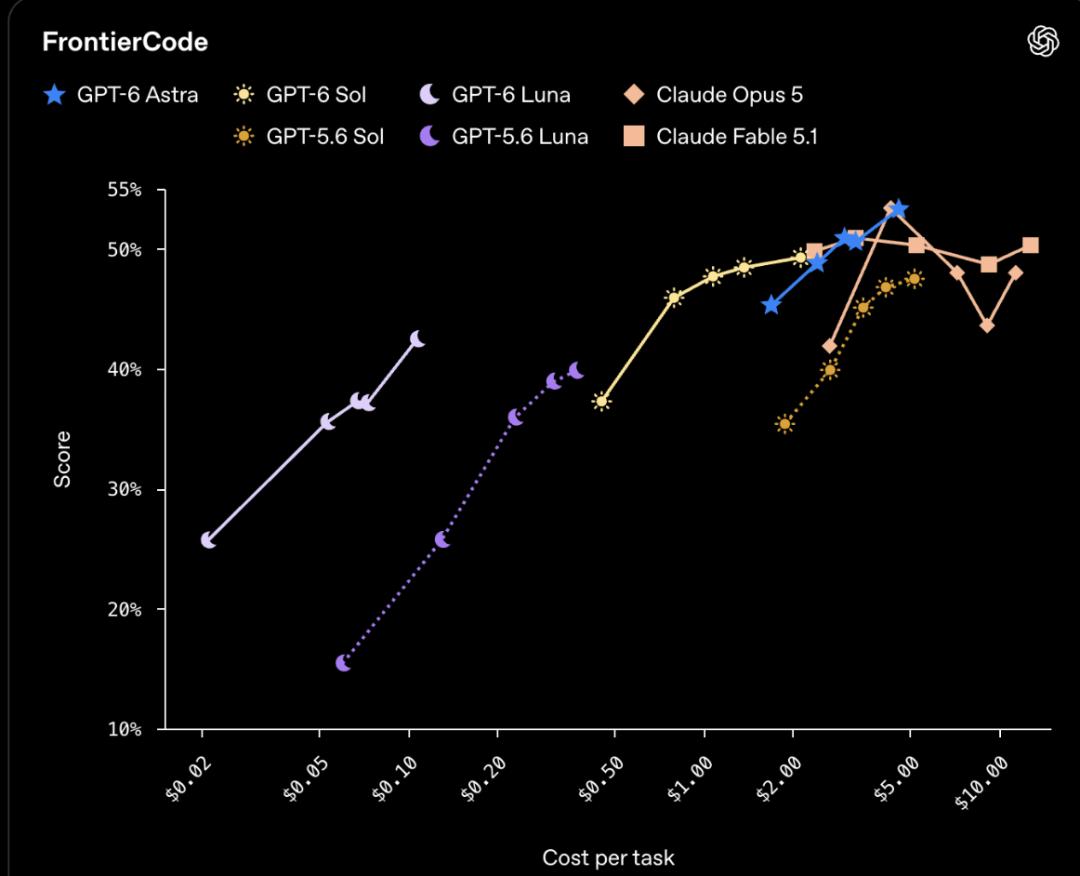
Im Bereich der Programmierfähigkeiten gibt OpenAI an, dass GPT-6 Sol und Luna ihre starken Code-Fähigkeiten beibehalten und durch niedrigere API-Preise Entwicklern mehr Raum für Experimente bieten, sodass Teams Codex mutiger für komplexe Aufgaben einsetzen können.
Im FrontierCode-Test zeigt GPT-6 Sol eine deutliche Verbesserung im Vergleich zu GPT-5.6 Sol und erreicht zu niedrigeren Kosten das Niveau von Claude Fable 5.1 xhigh.
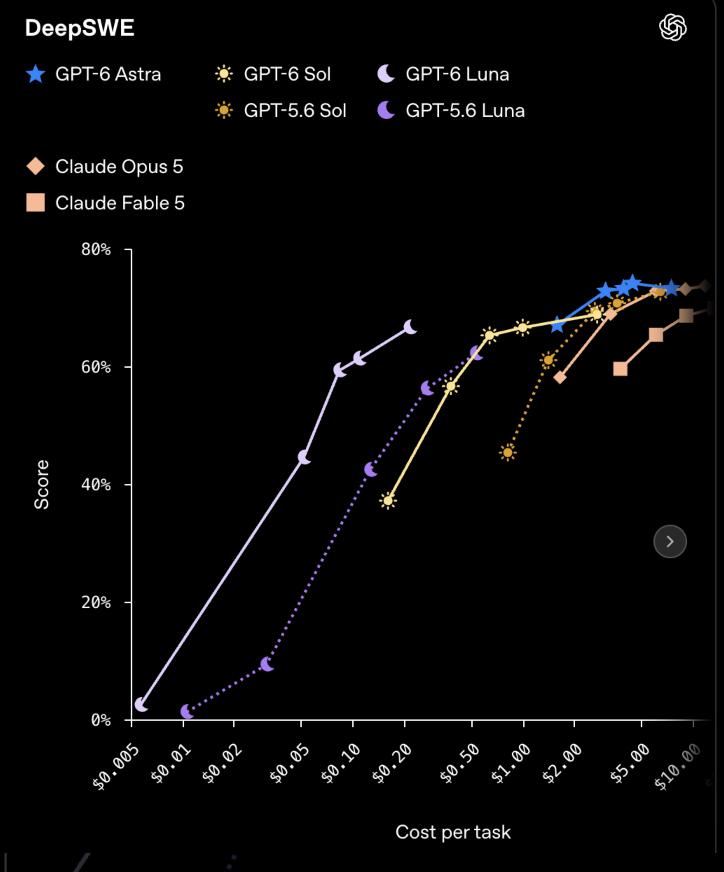
Im DeepSWE v1.1-Test: GPT-6 Sol erreicht bei höchster Schlussfolgerungsintensität eine Punktzahl von 68,8 %, was nur 1,1 Prozentpunkte unter dem Spitzenwert von 69,9 % von Claude Fable 5 liegt. Die Kosten pro Aufgabe sinken jedoch um etwa 80 %. GPT-6 Luna erreicht bei höchster Schlussfolgerungsintensität 66,6 % und nähert sich der Leistung von Claude Opus 5 und Fable 5 bei mittlerer Schlussfolgerungsintensität an.
In diesen Vergleichen: sinken die Kosten pro Aufgabe von Luna im Vergleich zu Opus 5 um 93 %; im Vergleich zu Fable 5 um 96 %.
Dies könnte darauf hindeuten, dass das Ziel von OpenAI nicht einfach darin besteht, ein stärkeres Modell zu entwickeln, sondern das Modell mit den niedrigsten Kosten pro Einheit an Intelligenz zu finden.
Im Bereich der Computerbetriebsfähigkeit bieten GPT-6 Sol und Luna eine höhere Kosteneffizienz als die Vorgängermodelle.
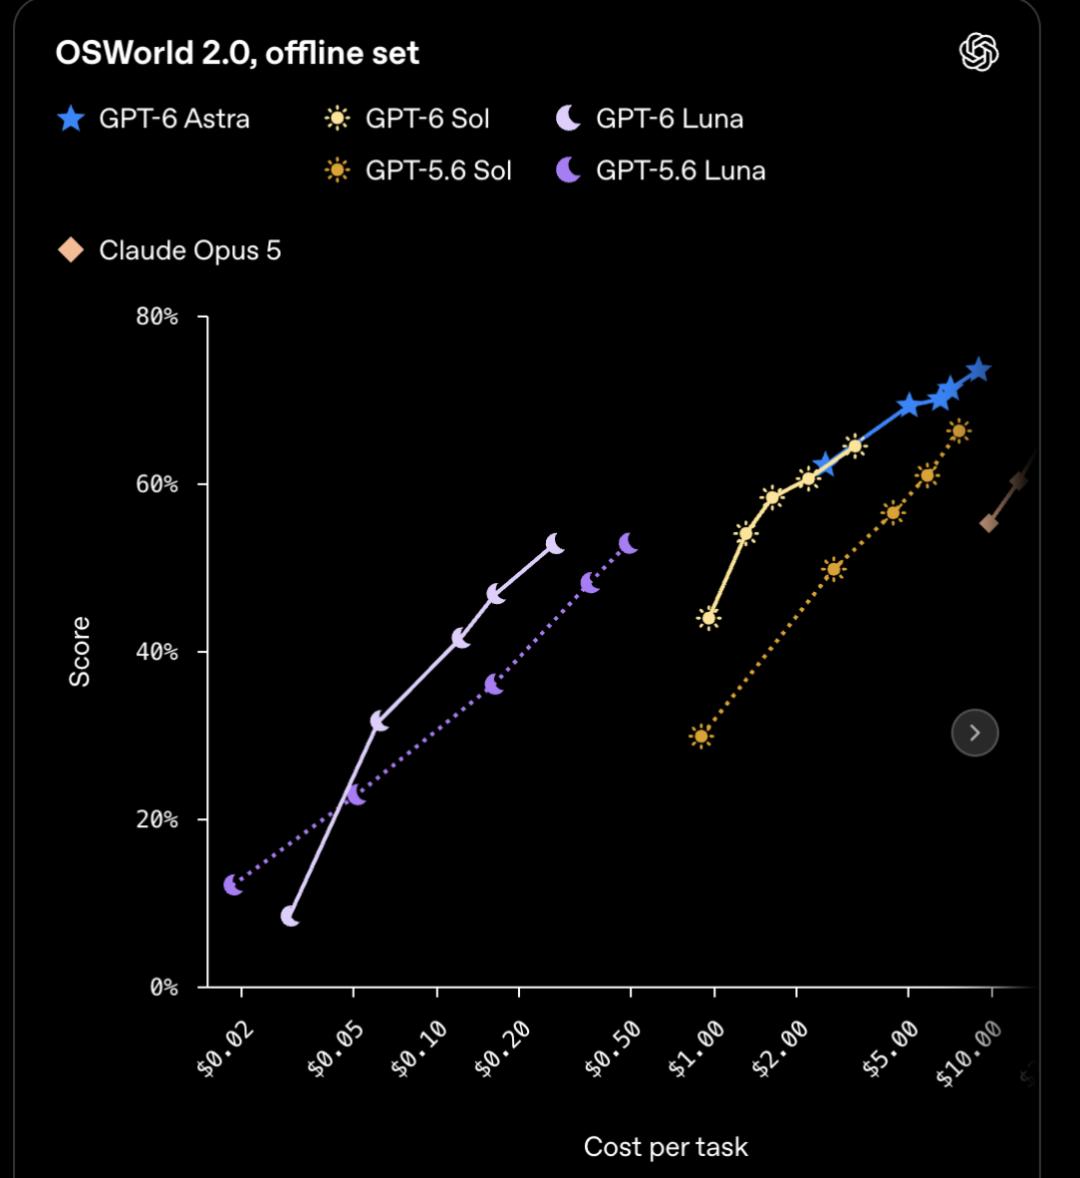
Im OSWorld 2.0 Offline-Test erreicht GPT-6 Sol bei höchster Schlussfolgerungsintensität eine Leistung, die der von Claude Opus 5 bei mittlerer Schlussfolgerungsintensität ähnelt:
GPT-6 Sol: 60,5 %
Claude Opus 5: 60,3 %
Die Kosten pro Aufgabe von GPT-6 Sol sinken jedoch um etwa 80 %, und GPT-6 Luna (max) kann GPT-5.6 Sol (medium) übertreffen, während die Kosten nur ein Zehntel davon betragen.
Neben dem gesunkenen Modellpreis hat OpenAI außerdem den Caching-Mechanismus für lange Aufgabenszenarien von Agent optimiert und das Prompt Caching von GPT-6 verbessert, wodurch die standardmäßige Cache-Trefferquote höher wird. Dadurch kann Agent mehr Kontext wiederverwenden, schneller reagieren und einen Rabatt von 90 % auf das Lesen von zwischengespeicherten Eingabe-Token erhalten.
Das bedeutet, dass der zukünftige Wettbewerb um Modelle nicht nur ein Wettbewerb um die Fähigkeiten der Modelle selbst ist, sondern auch um die Effizienz der gesamten Schlussfolgerungsinfrastruktur.
Anthropic: Opus 5.5 ist da, Fable-Level-Fähigkeiten
Auf der anderen Seite der Veröffentlichung von OpenAI legt Anthropic diesmal ebenfalls großen Wert auf „Effizienz“.
Claude Opus 5.5 ist das erste Modell der Claude 5.5-Serie. Anthropic hat ihm eine sehr klare Positionierung gegeben: Bei den meisten Aufgaben erreicht es das Niveau von Claude Fable 5.1, aber im Vergleich zu Opus 5 sinken die Betriebskosten bei typischen Aufgaben um etwa 40 %, und die Ausgabegeschwindigkeit steigt um mehr als 30 %.
Blog-Link: https://www.anthropic.com/claude-opus-5-5/
Werfen wir zuerst einen Blick auf die Fähigkeiten.
In der von Anthropic veröffentlichten Headline-Comparison-Table liegt Opus 5.5 bei allen aufgeführten Punkten über Fable 5.1.
Auf Terminal-Bench 4.0 erreicht Opus 5.5 66,4 %, während Fable 5.1 55,8 % erzielt; bei FrontierCode v1.1 Main liegt das Verhältnis bei 54,4 % zu 50,3 %; bei GDPval-AA v2.1 für echte Wissensarbeit beträgt das Ergebnis 1846 zu 1735.
Agentische Codierung, Wissensarbeit und Computerbetrieb sind im Wesentlichen die Hauptrichtungen der Fähigkeitsverbesserung dieser Opus-Generation. Die offizielle Veröffentlichung von Anthropic bezeichnet es ebenfalls als deutliches Upgrade gegenüber Opus 5.
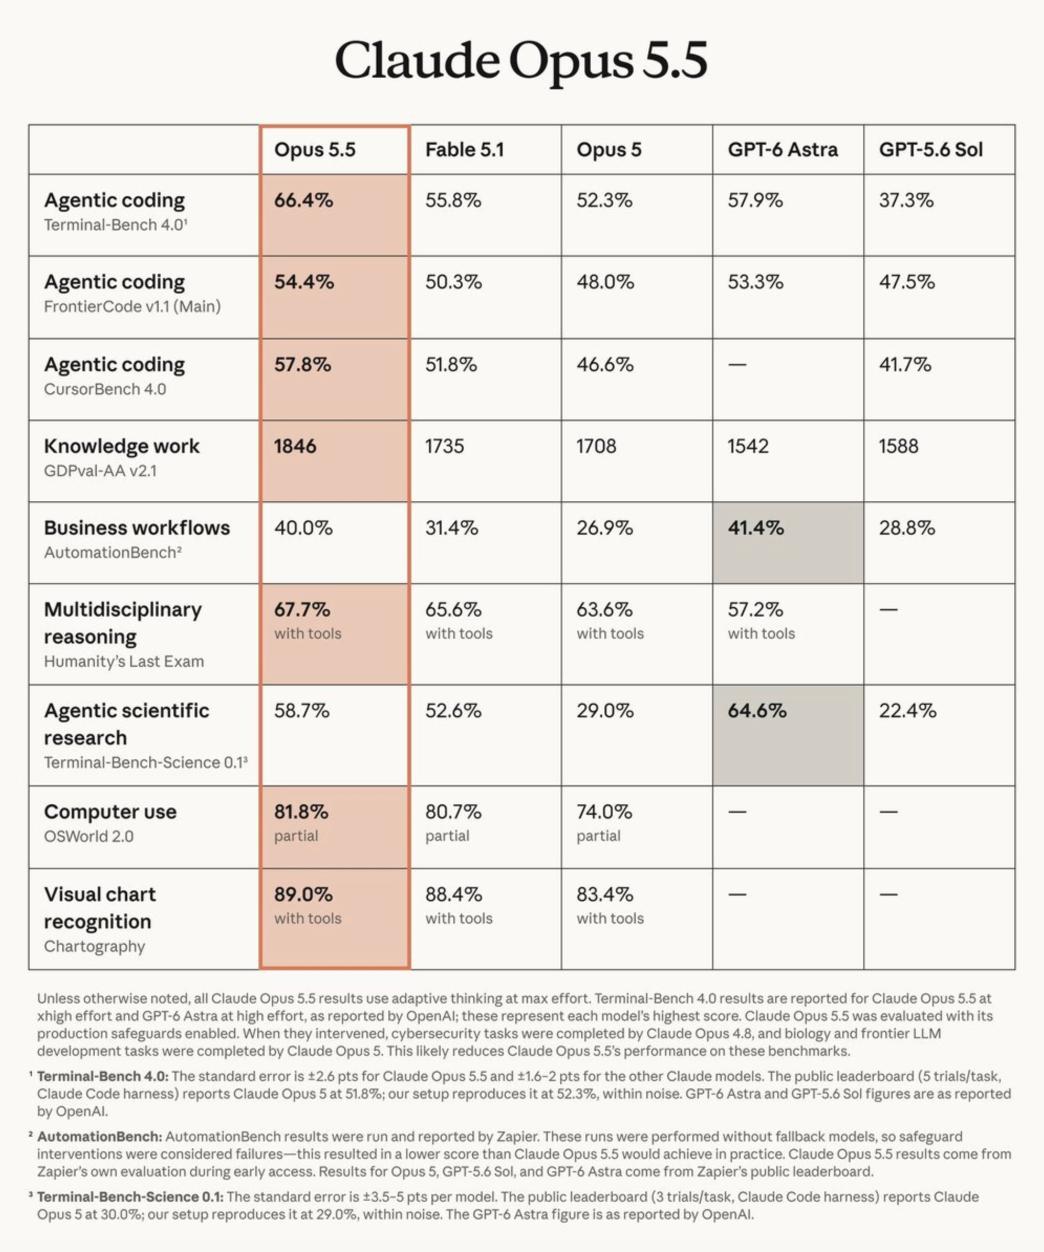
Das bedeutet natürlich nicht, dass „Opus 5.5 Fable 5.1 in allen Punkten übertroffen hat“. Die Harness, Tools und Schlussfolgerungsintensitäten, die bei verschiedenen Benchmarks verwendet werden, sind nicht vollständig identisch; selbst in der eigenen Tabelle von Anthropic behält GPT-6 Astra bei Projekten wie AutomationBench und Terminal-Bench-Science höhere Ergebnisse.
Man kann jedoch deutlich sehen, dass der zuvor klare Fähigkeitsunterschied zwischen Opus und Fable schnell schrumpft.
Aus der API-P