GPT-6 Sol schlägt die gesamte 5.6-Produktlinie, der Preis beträgt ein Fünftel von Astra, Luna ist günstiger als Liang Wengu, Codex wird am Dienstag zurückgesetzt.
GPT-6 Sol, Luna wurde mitten in der Nacht veröffentlicht, der API-Preis wurde direkt halbiert!
Astras verbesserte Trainingsmethode wird auch für diese beiden Modelle verwendet, sodass sie auch die Verbesserungen von Astra in Bereichen wie der Computernutzung erben.
Was gibt es noch zu sagen, das bedeutet, dass die 5.6-Serie direkt überholt wurde.
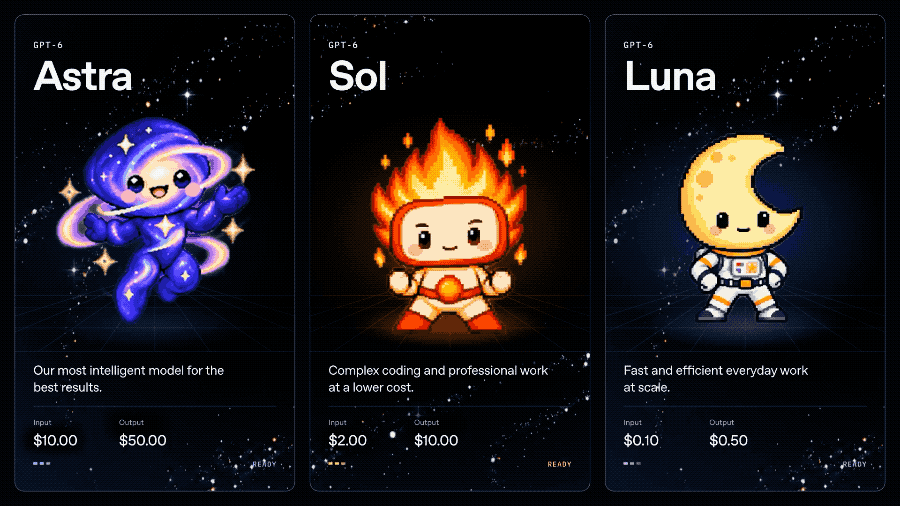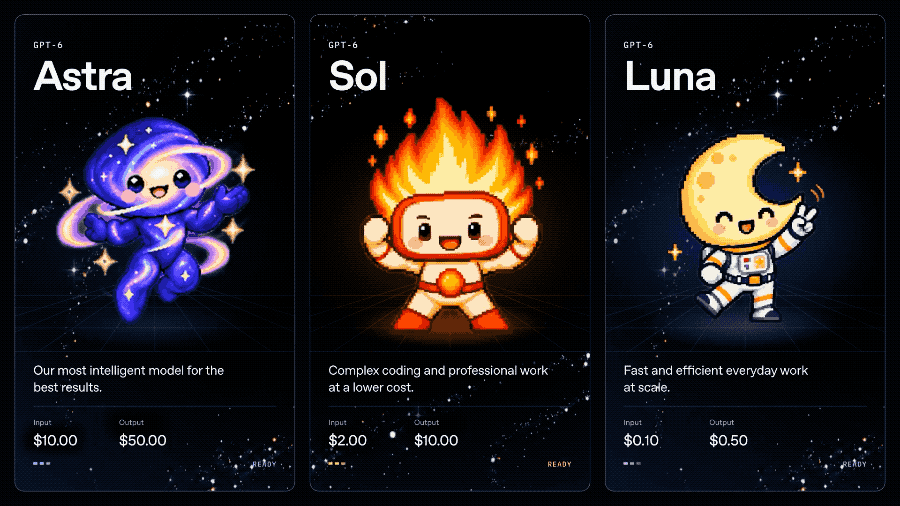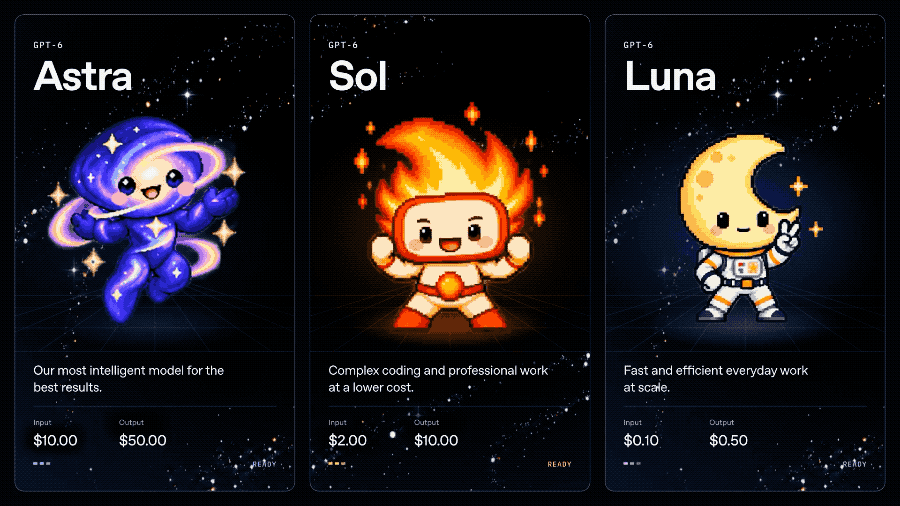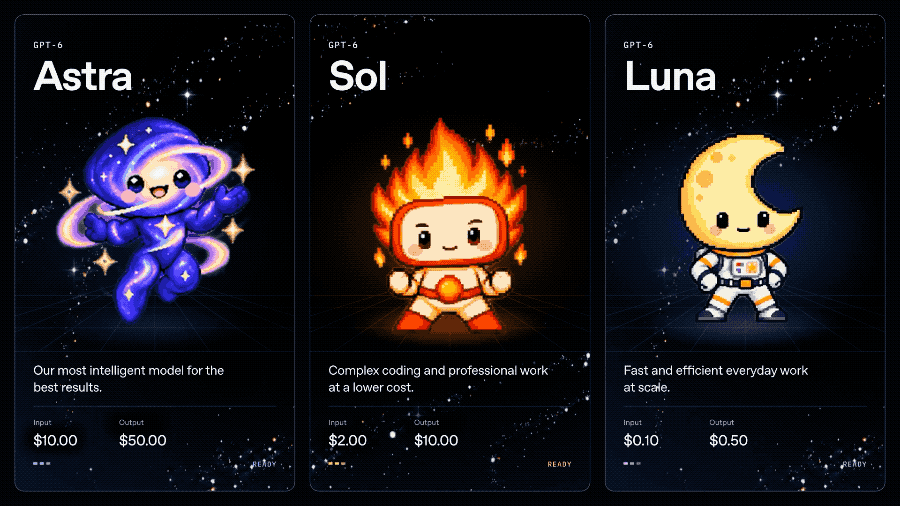
Jetzt übernimmt Astra in der Serie die frühere Rolle von Sol, Sol übernimmt die frühere Rolle von Terra, und Luna bleibt die gleiche wie zuvor.
Die Nische von Terra wurde direkt vollständig verdrängt.
Im Vergleich zur 5.6-Serie wurde die API-Preisgestaltung der 6-Serie direkt um 50% gesenkt, wobei der Preis für die Ausgabe von Luna sogar etwas mehr als 50% reduziert wurde.
Außerdem ist der Eingabepreis von Luna sogar etwas günstiger als der Liang Wengu-Preis (0,15 $) von DeepSeek-V4.1 Flash, es ist nur unklar, ob die Cache-Trefferquote mithalten kann.
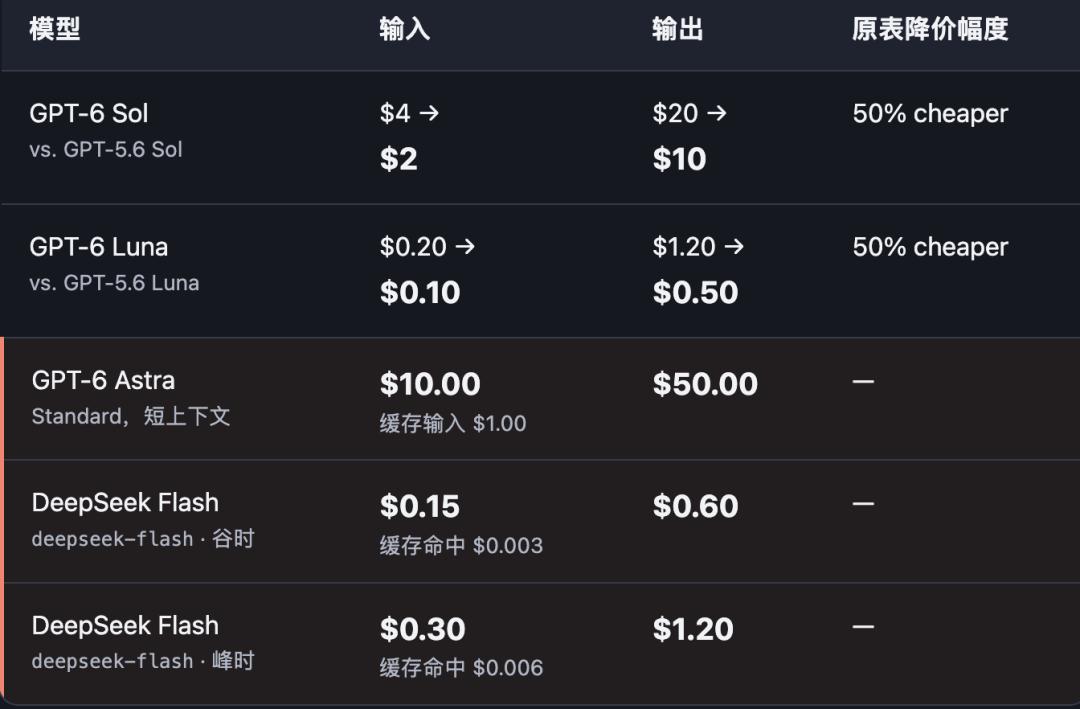
Warum ist das Upgrade sogar günstiger geworden?
OpenAI gibt an, dass dies auf die Effizienzsteigerungen im Cache- und Inferenzprozess zurückzuführen ist, und die eingesparten Kosten werden direkt an Nutzer und Entwickler weitergegeben.
Man sollte Sam Altman für 24 Stunden den Titel "König der Ultraman" verleihen.
Mit einem Zehntel des Preises konkurriert es direkt mit Fable
Nach der Lektüre der gesamten Veröffentlichung habe ich zuerst eine Erkenntnis gewonnen: Bei GPT-6 Sol sollte man den Max-Modus besser nicht aktivieren.
Die Leistungssteigerung ist begrenzt, aber die Preissteigerung ist erheblich, es lohnt sich mehr, direkt Astra zu verwenden. Bei einzelnen Benchmarks schneidet der Max-Modus sogar schlechter ab als der xHigh-Modus.
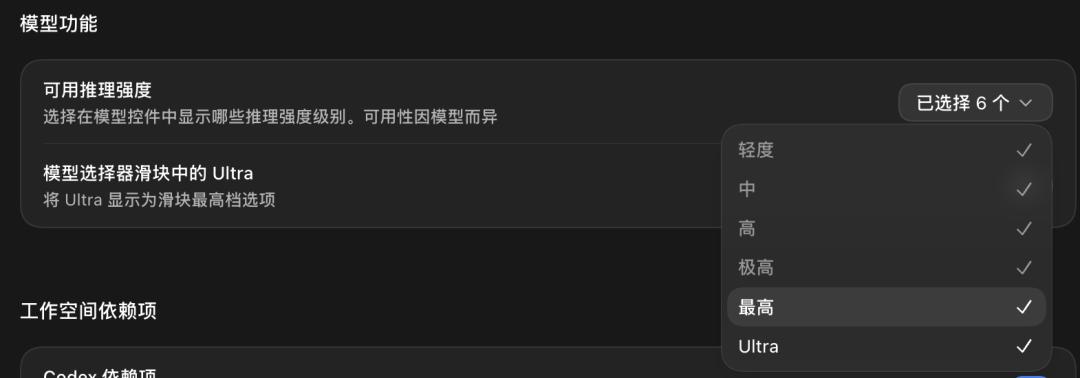
Was? Du weißt nicht, wie man den Max-Modus in Codex aktiviert?
Du kannst ihn in den Einstellungen auswählen, er ist standardmäßig deaktiviert. Jetzt weißt du auch, warum er standardmäßig aus ist.
Gemäß der AutomationBench-Benchmark haben die beiden Stufen High und xHigh von GPT-6 Sol bereits das Niveau von Light und Medium von Astra erreicht.
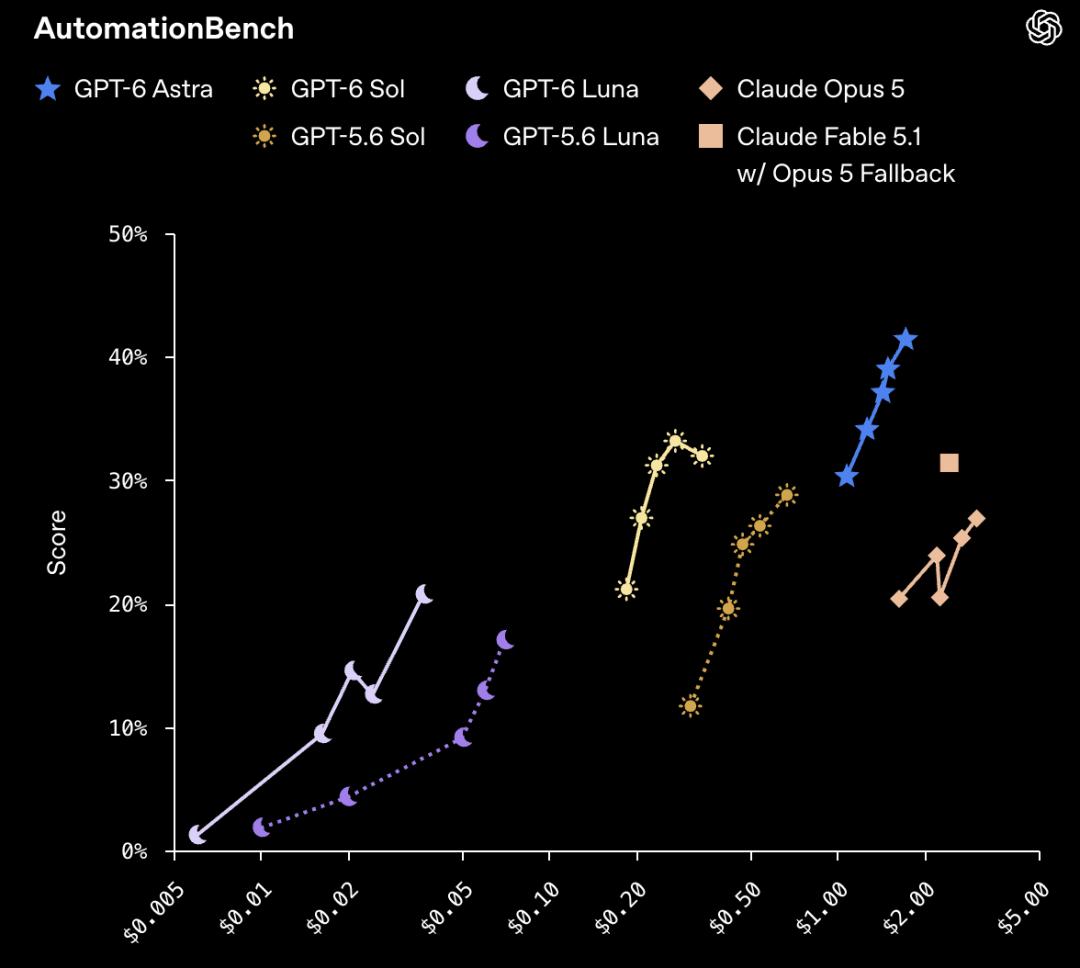
AutomationBench misst die Fähigkeit von KI, End-to-End-Geschäftsprozesse auf 47 Tools in sechs Bereichen: Vertrieb, Marketing, Betrieb, Kundenservice, Finanzen und Personalwesen auszuführen.
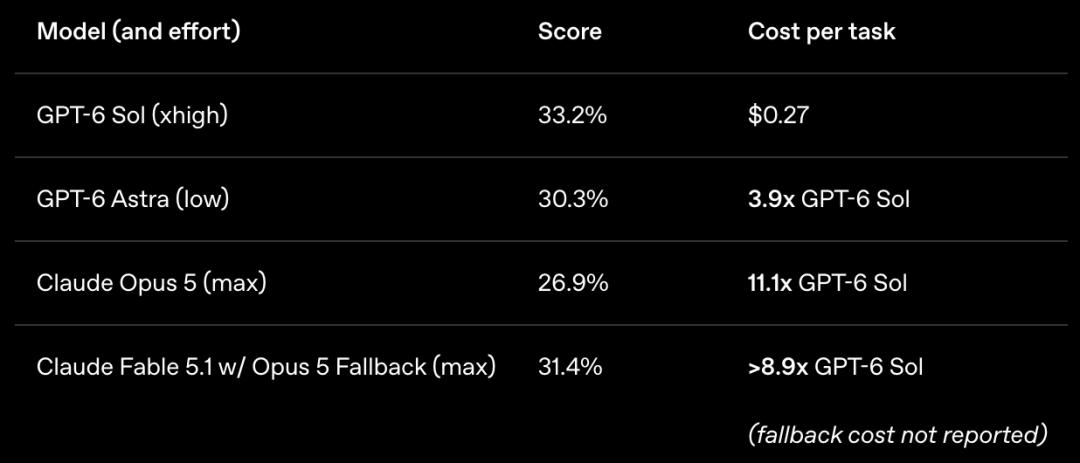
Zum Vergleich: Claude Opus 5 erreicht im Max-Effort-Modus einen ähnlichen Punktwert wie GPT-6 Sol im Medium-Modus, aber die Kosten pro Aufgabe sind 11,1 Mal so hoch wie bei Sol.
Die Kosten von Claude Fable 5.1 sind mehr als 8,9 Mal so hoch wie bei Sol, und dazu kommen noch die zusätzlichen Kosten, die dadurch entstehen, dass bei etwa 40% der Aufgaben auf Opus 5 zurückgegriffen wird.
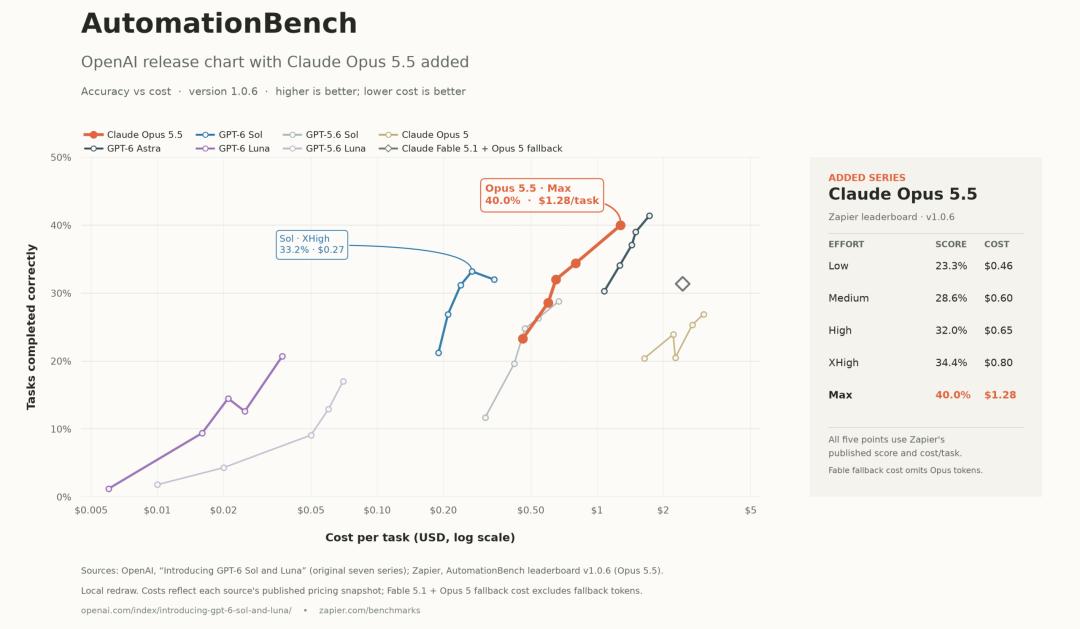
Um die Fähigkeit von GPT-6 Sol zur Computernutzung zu testen, habe ich es gebeten, auch die Ergebnisse des neu erschienenen Opus5.5 in das Diagramm einzutragen.
Daraus geht klar hervor, dass die Max-Stufe von Opus5.5 das Niveau von GPT-6 Astra erreicht hat, und der Preis erreicht auch das Niveau von Astra.
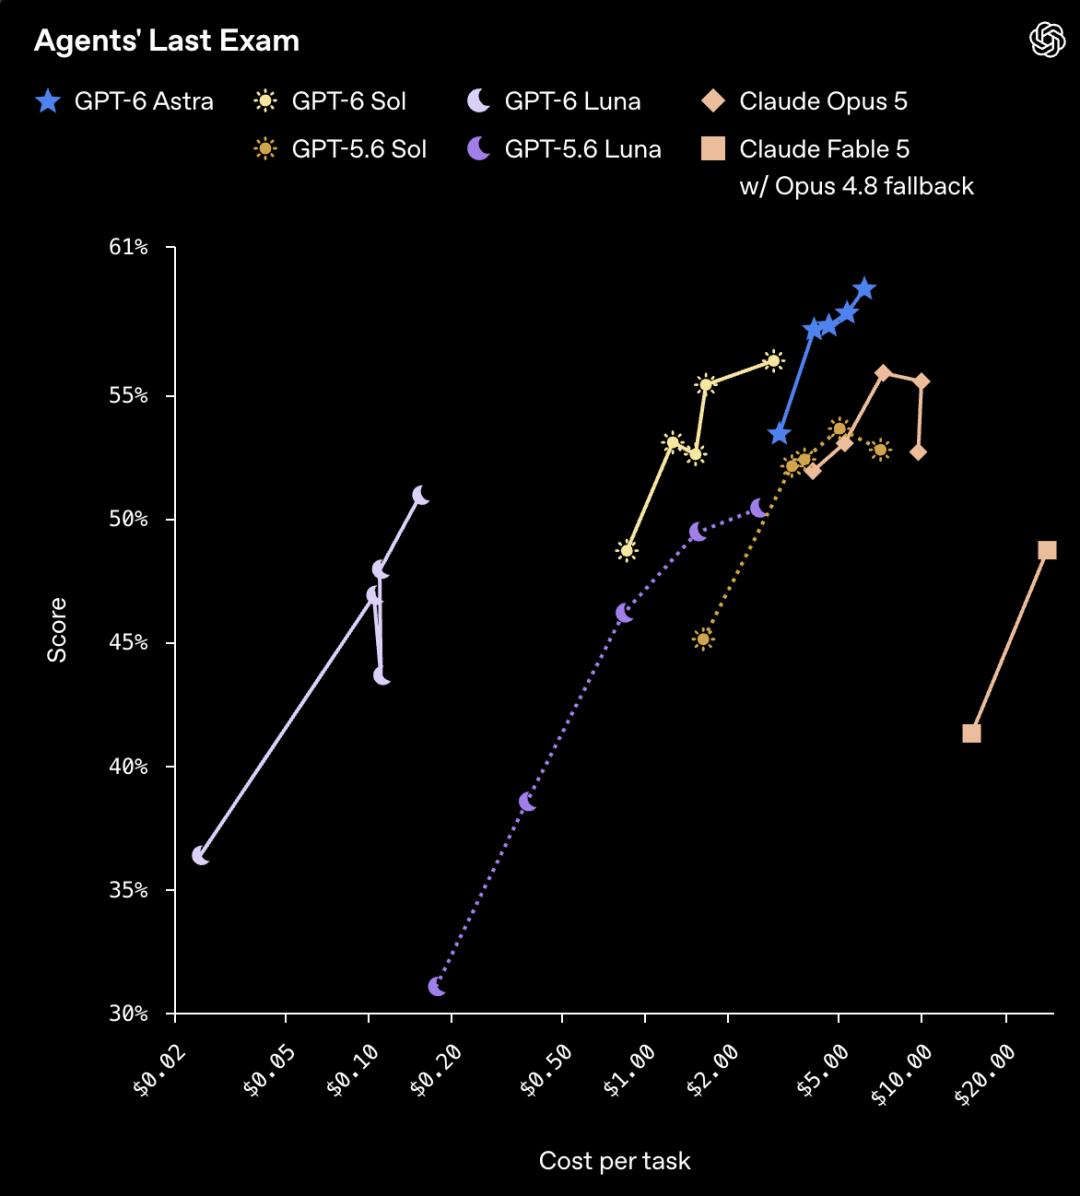
Bei dem Test "Agents' Last Exam" werden dieses Mal langfristige Aufgaben geprüft, die 55 Teilbranchen abdecken.
GPT-6 Sol erreicht im Max-Effort-Modus einen Punktwert von 56,4%, der den Höchstwert von Claude Opus 5 in diesem Test übertrifft, und die Kosten sind gleichzeitig um 60% niedriger.
Die Programmierung ist der Kernbereich, der dieses Mal vorgestellt wird.
OpenAI hat eine Reihe interner Daten veröffentlicht: Die Nutzung von Coding-Agenten im Unternehmen ist exponentiell gestiegen. Umgerechnet auf die API-Preise übersteigt der tägliche Token-Verbrauch des mittleren Forschers bereits 600 US-Dollar, und der des 90-Perzentil-Forschers übersteigt 7000 US-Dollar.
Da die Aufgaben, die Programmieragenten übernehmen, immer länger und komplexer werden, werden die Kosten für die kontinuierliche Nutzung immer wichtiger. Genau das ist das Problem, das Sol und Luna lösen sollen.
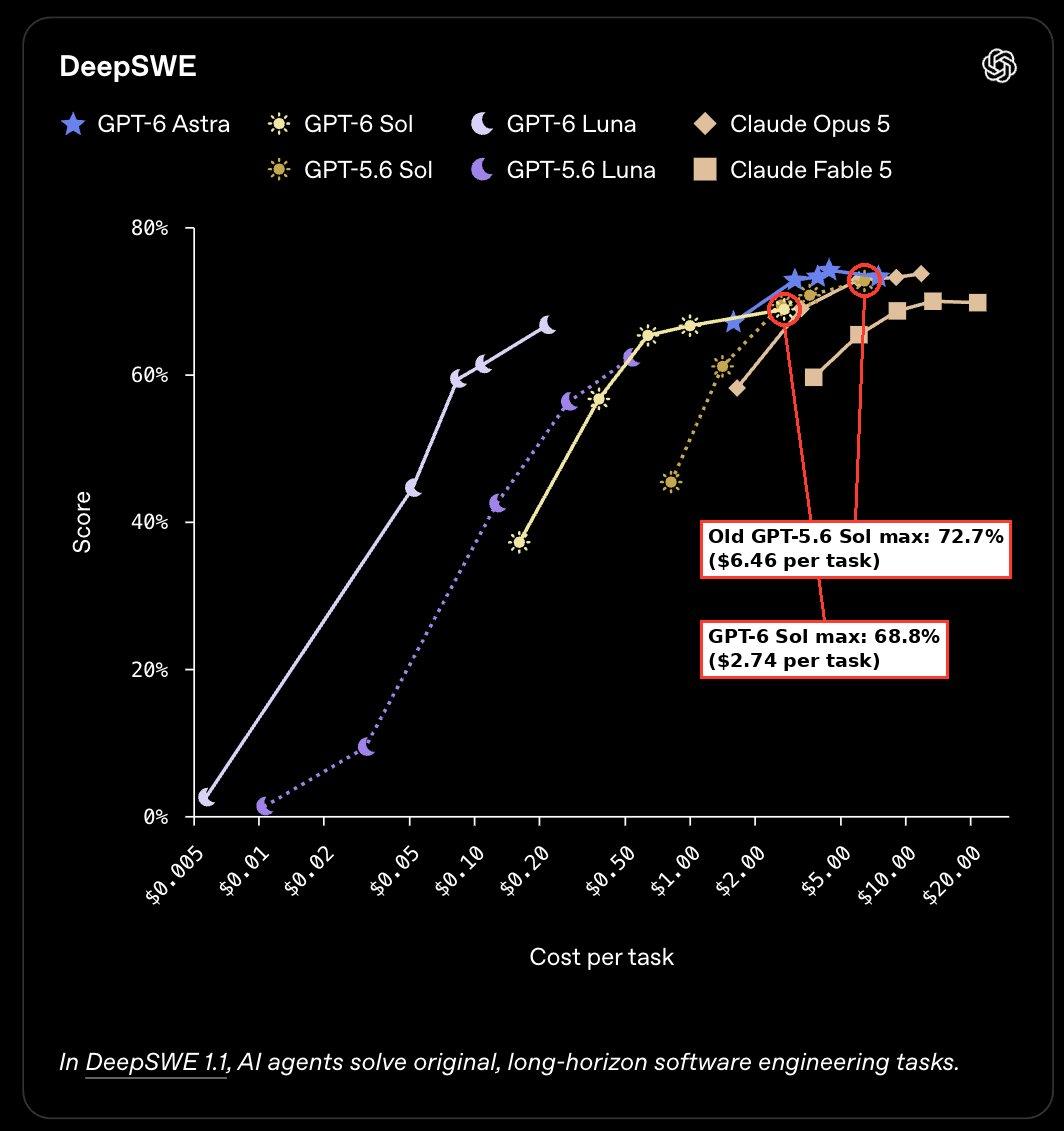
Auf DeepSWE v1.1 (das die Fähigkeit von KI testet, komplexe Softwareentwicklungsaufgaben in echten Codebasen zu lösen) ist GPT-6 Sol nicht wirklich besser als 5.6 Sol, aber es ist deutlich günstiger.
GPT-6 Luna erreicht im Max-Effort-Modus einen Punktwert von 66,6%, der dem Niveau von Claude Opus 5 und Fable 5 im Medium-Effort-Modus entspricht. Die Kosten sind um 93% bzw. 96% niedriger.
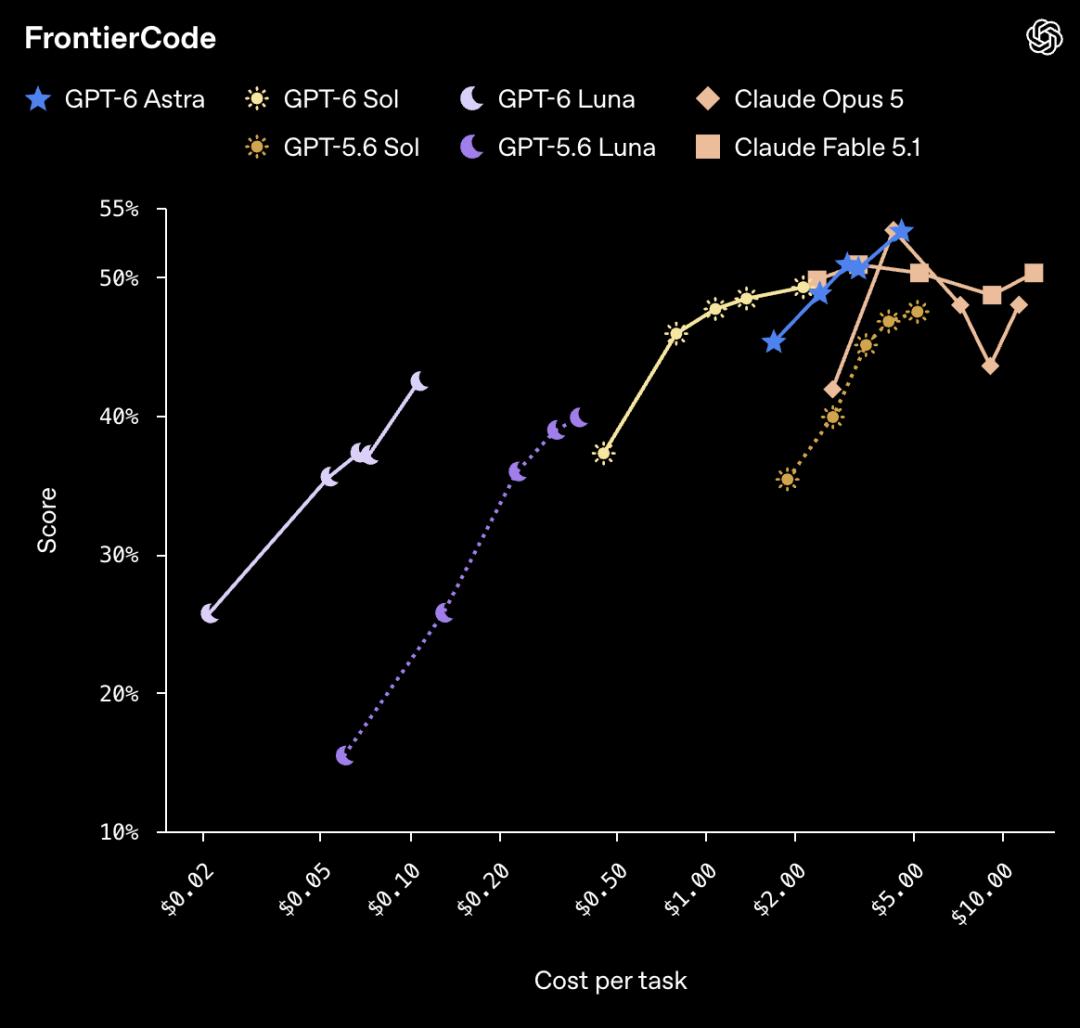
Auf FrontierCode, das von Cognition entwickelt wurde (um zu bewerten, ob der von KI geschriebene Code den Standard erreicht, um in eine echte Codebasis aufgenommen zu werden), hat GPT-6 Sol im Vergleich zu GPT-5.6 Sol ebenfalls eine deutliche Verbesserung gezeigt und kann die Leistung von Claude Fable 5.1 xHigh zu niedrigeren Kosten erreichen.
Auf dieser Benchmark sind die Stufen von Claude wieder durcheinander geraten.
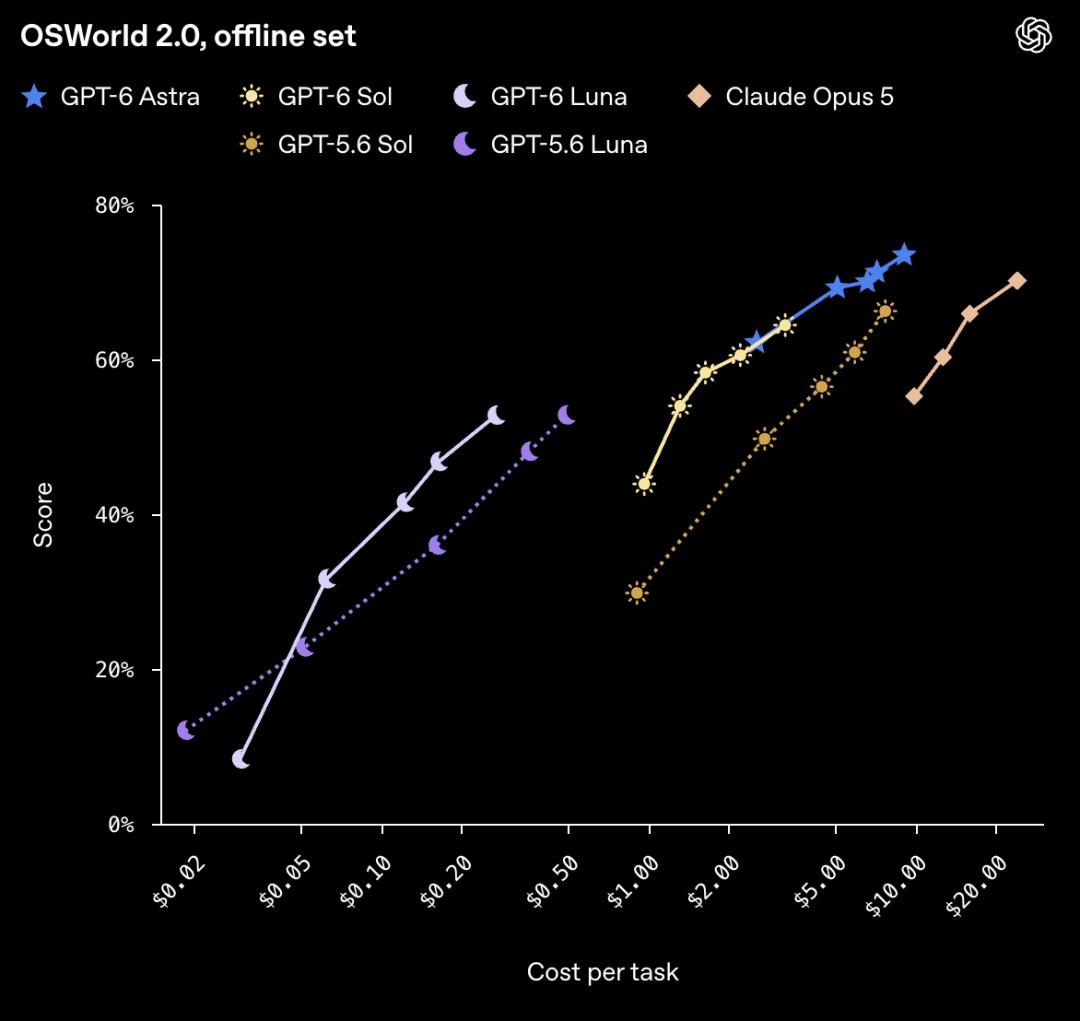
Bei der Computernutzung ist Astra nach wie vor das zuverlässigste Modell.
GPT-6 Sol ist lediglich günstiger als 5.6 Sol, das Niveau über der High-Stufe übertrifft 5.6 nicht wesentlich.
GPT-6 Luna übertrifft im Max-Effort-Modus die Leistung von GPT-5.6 Sol im Medium-Effort-Modus, und die Kosten betragen nur ein Zehntel des letzteren.
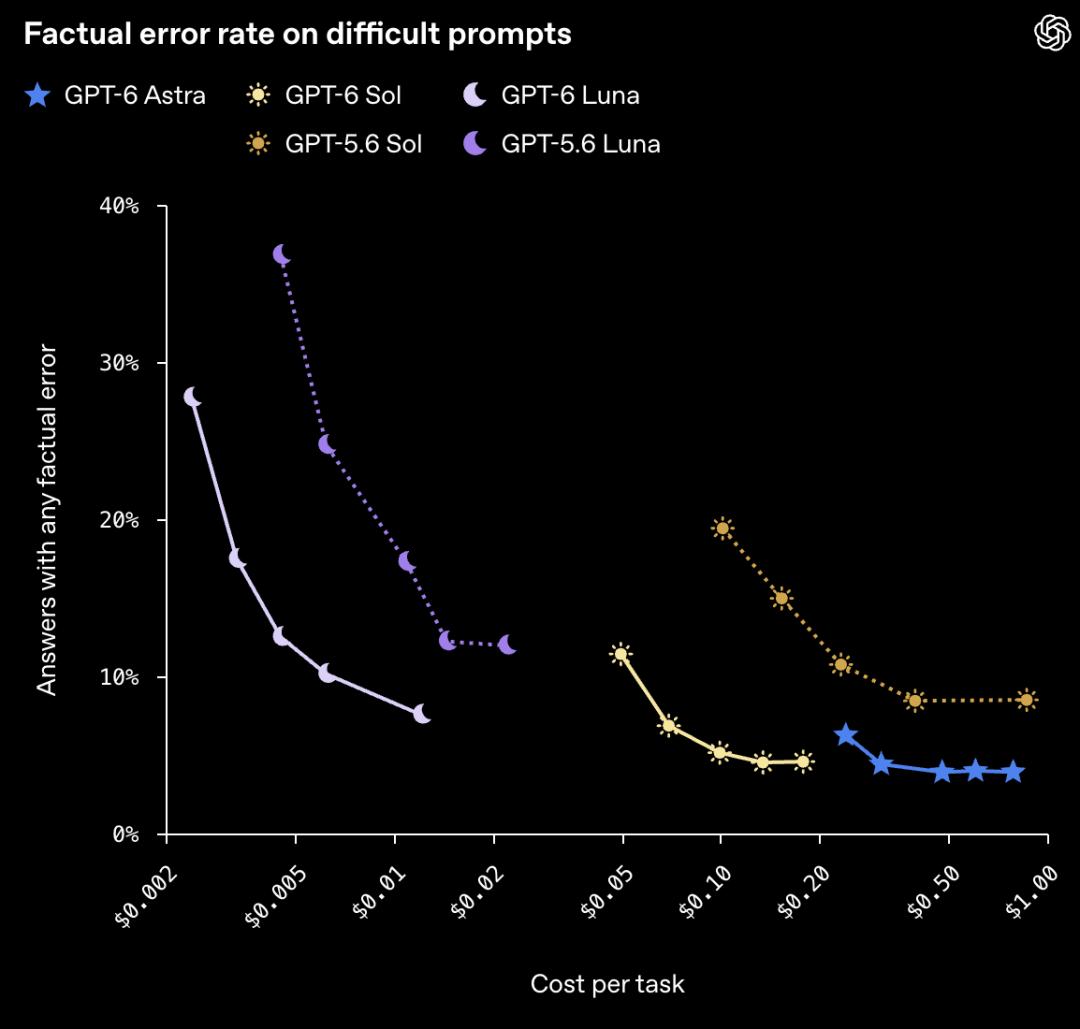
In Bezug auf die sachliche Genauigkeit hat OpenAI eine Reihe von Fällen getestet, die aus echten ChatGPT-Dialogen extrahiert wurden und von Nutzern bereits als sachlich falsch markiert wurden.
Das Ergebnis ist, dass die Fehlerrate von GPT-6 Sol etwa halb so hoch ist wie die des Vorgängermodells und nahe am Niveau von Astra liegt. GPT-6 Luna kann bei höherem Effort die Genauigkeit von GPT-5.6 Sol erreichen, während die Kosten nur ein Hundertstel betragen.
Höhere Cache-Trefferquote, das Reset der Kontingente kommt bald
Neben den Modellfähigkeiten hat OpenAI auch mehrere Verbesserungen an der Infrastruktur von GPT-6 vorgenommen.
Zuerst das Prompt-Caching.
Der verbesserte Cache-Mechanismus bietet standardmäßig eine höhere Trefferquote, und für Eingabe-Token, die im Cache getroffen werden, gibt es einen Preisnachlass von 90%.
OpenAI hat außerdem ein Cache-Überwachungsfeld und Diagnosetools veröffentlicht, mit denen Entwickler die Cache-Nutzung einsehen, die Gründe für verfehlte Treffer lokalisieren und gezielt optimieren können.
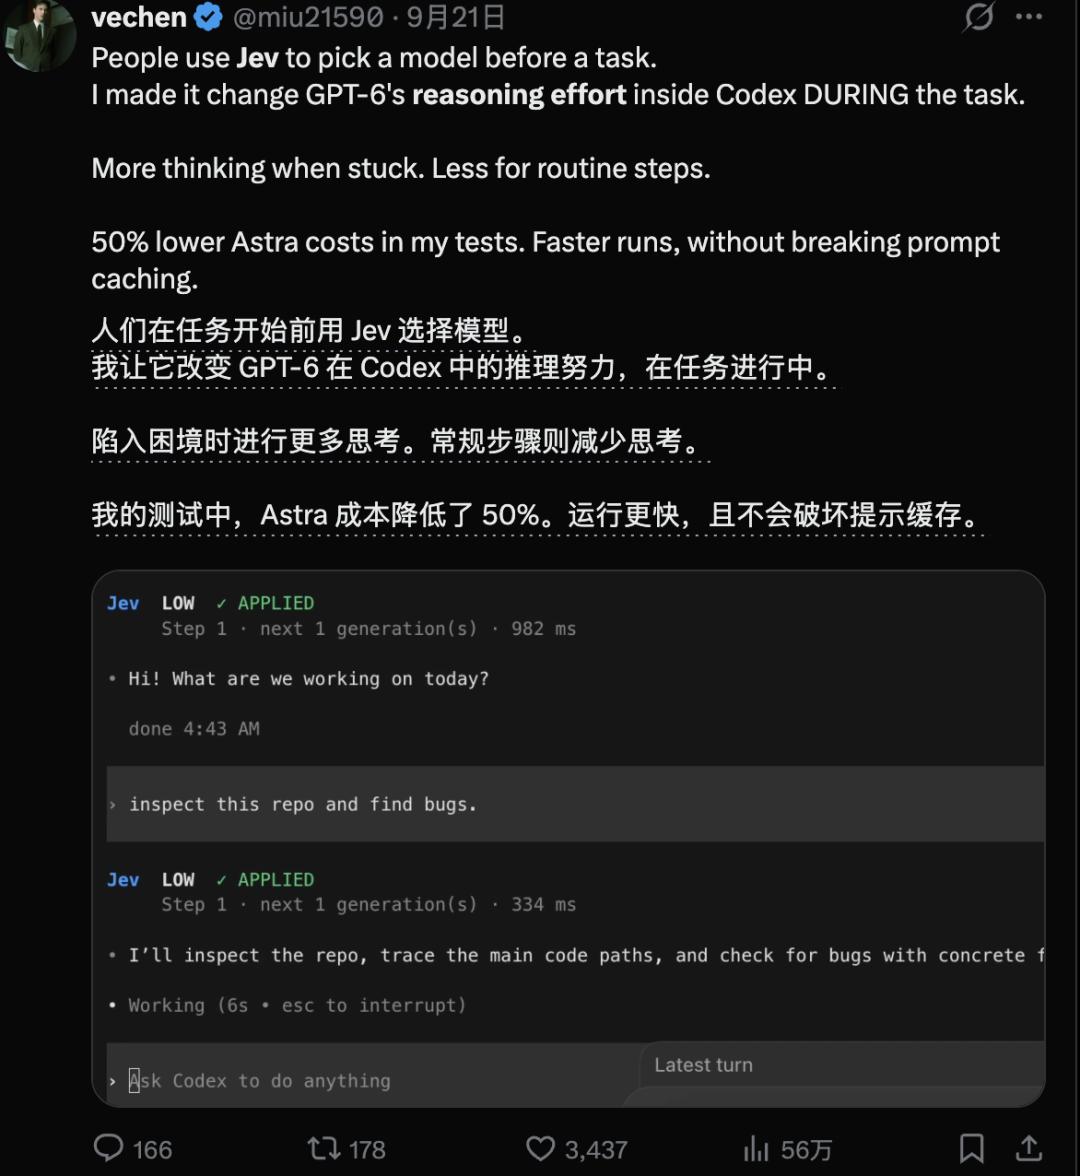
Es gibt auch eine praktische Änderung: Wenn Sie die Inferenz-Effort-Stufe anpassen oder Tools ein- und ausschalten, wird der vorherige Cache-Kontext nicht mehr unterbrochen.
GitHub nutzt diese Lösung bereits. Laut OpenAI haben diese Optimierungen in den letzten Monaten den Anteil der Prompt-Token, die von GitHub Copilot neu verarbeitet werden müssen, um über 50% gesenkt, was Milliarden von Anfragen betrifft.
Endlich kann man die Konfiguration flexibel zwischen verschiedenen Aufgaben im selben Arbeitsprozess wechseln.
Es gibt bereits Nutzer, die eine Lösung entwickelt haben, mit der man in Kombination mit Jev die Einstellungen innerhalb von Millisekunden mitten in der Aufgabe wechseln kann.
D