Grok 4.7 ist da! Internetnutzer haben es im Praxistest zuerst geschafft, SpaceX kaputtzuspielen – die große Rakete hebt ab!
Es scheint, dass Elon Musk offensichtlich auch weiß, dass die Tage um den Nationalfeiertag im Bereich der Basismodelle nicht einfach zu bestehen sind.
Also hat er zuerst den Platz besetzt – Grok 4.7 ist da!!!
Ein größeres Basismodell, der Kontext wird auf 500.000 Token erweitert, der Schwerpunkt liegt auf intensiven Übungen für Codierung, Agenten und komplexe Aufgaben, die stundenlang laufen können.
Softwareentwicklung, Elektrotechnik, lang andauernde Büroarbeit, Terminalbetrieb und rechtliche Aufgaben werden umfassend weiterentwickelt.
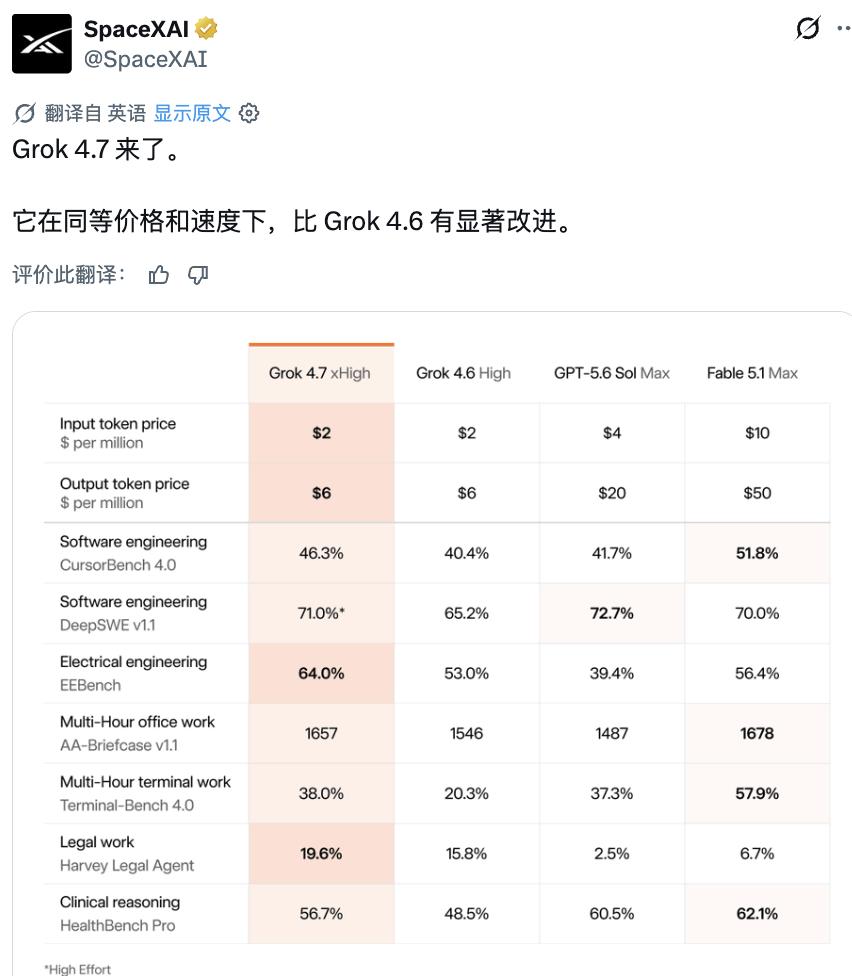
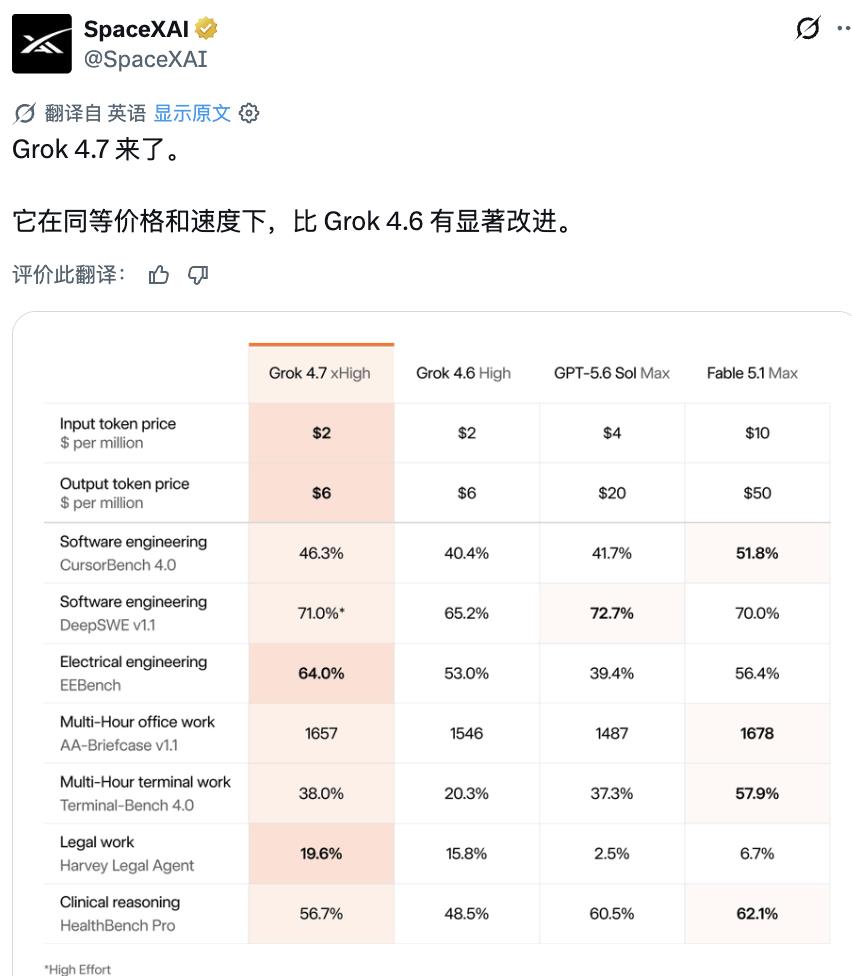
In der offiziellen Bewertungstabelle belegt es den ersten Platz mit 64 % im Benchmark-Test für Elektrotechnik, und der Wert des Benchmark-Tests für Terminalbetrieb steigt sogar von 20,3 % auf 38 %.
Natürlich ist der Preis auch sehr attraktiv: 2 USD pro Million Token für die Eingabe und 6 USD pro Million Token für die Ausgabe, es wird rein mehr Inhalt ohne Preiserhöhung geboten.
Wer hätte das gedacht: Gleich nach der Veröffentlichung des Modells wird der praktische Test der Nutzer ungewöhnlich.
Codierung? Agenten? Rechtliche Schlussfolgerungen? Lassen wir das erstmal beiseite.
Als ob sie sich vorher in Gruppen auf ein geheimes Codewort geeinigt hätten, ist das Erste, was die Nutzer nach dem Öffnen von Grok 4.7 tun – Raketen zu starten!
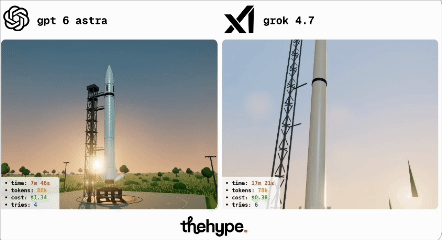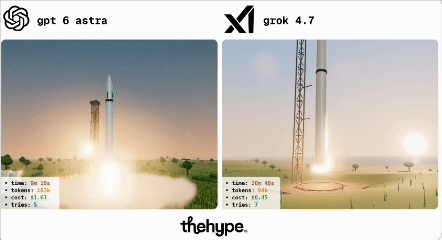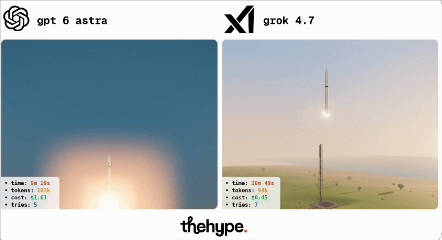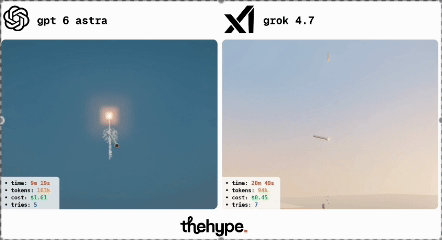
Hier hat @TheHype direkt eine großartige Show namens „Der Flug ins Weltall“ veranstaltet. Ganz zu schweigen davon, dass diese Rakete sogar schneller fliegt als die des Nachbarn:
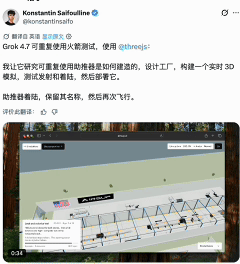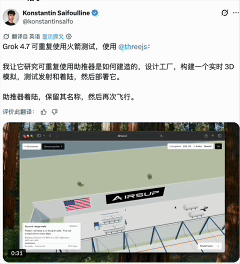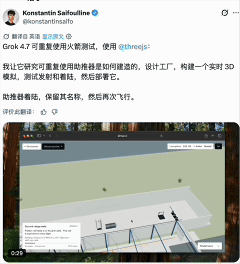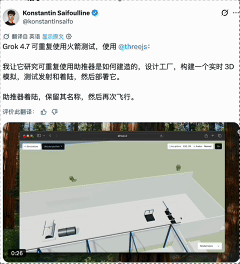
Und dieser Nutzer unten hat Grok 4.7 direkt dazu gebracht, ein 3D-Raketenprojekt zu erstellen, mit Modell und Startrampe, und es kann sogar vor Ort getestet werden??
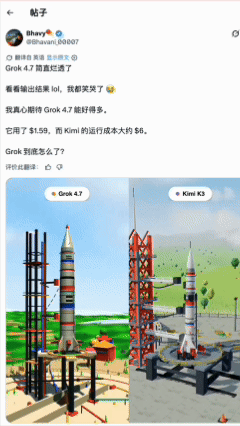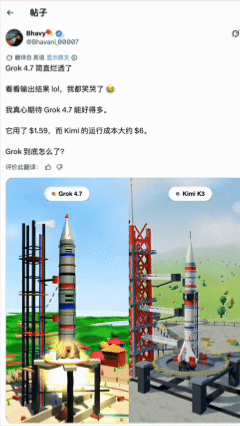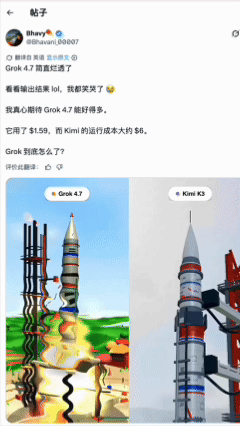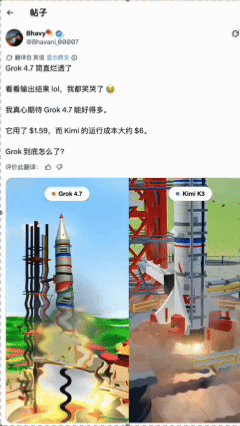
Einige Nutzer machen sich noch mehr Spaß und ziehen Kimi K3 und Grok 4.7 direkt zusammen zum Raketenstartplatz, um die gleiche Aufgabe offen zu bearbeiten!
Nach dieser Runde sieht man, dass Grok das nicht ganz aushält, direkt schwindelig zusammensackt. Die Nutzer sind damit nicht einverstanden:
Elon Musk: Ihr spielt alle so mit mir, oder??
SpaceX: Was habe ich schon wieder falsch gemacht??
Grok 4.7: Diese Version konzentriert sich auf intensive Übungen für komplexe „schwere Aufgaben“
Zusammengefasst:
Grok 4.7 ist diesmal wirklich dafür ausgelegt, schwere Aufgaben zu übernehmen.
Nach den derzeit veröffentlichten Bewertungsergebnissen sind die Verbesserungen von Grok 4.7 relativ konzentriert, hauptsächlich in den Bereichen Codierung, Agenten und lang andauernde Aufgaben.
Schauen wir uns zuerst die von xAI selbst angegebenen Bewertungsergebnisse an.
Softwareentwicklung CursorBench 4.0 steigt von 40,4 % der vorherigen Generation auf 46,3 %, und DeepSWE v1.1 steigt auch von 65,2 % auf 71 %.
Der Anstieg bei Elektrotechnik EEBench ist noch größer –
Es ist um 11 Prozentpunkte höher als die vorherige Generation und erreicht die höchste Punktzahl unter den vier Modellen in der Tabelle, die Verbesserung bei professionellen technischen Aufgaben ist ziemlich offensichtlich.
Auch bei Rechtsagenten steigt der Wert von 15,8 % auf 19,6 %, sodass der Abstand zu GPT-5.6 Sol und Fable 5.1 in der Tabelle deutlich vergrößert wird:
Schauen wir uns dann die Rangliste des Drittanbieters Artificial Analysis an.
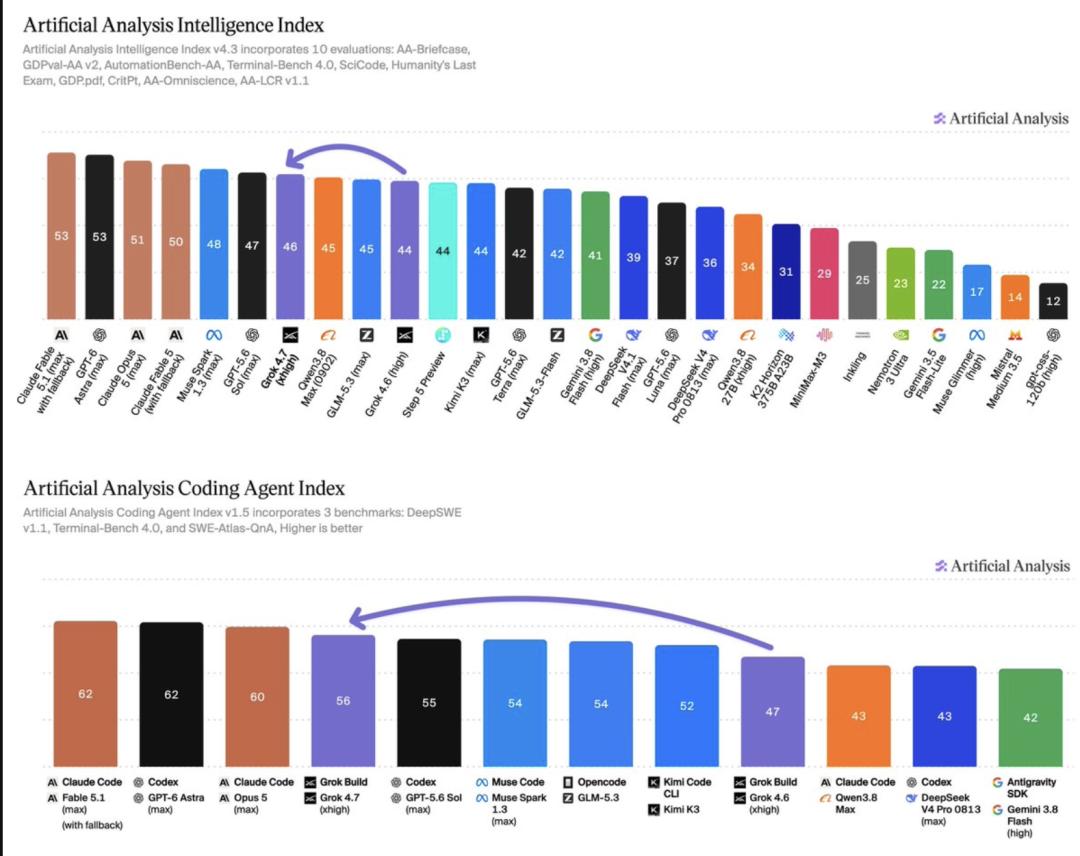
Der Index der allgemeinen Intelligenz erreicht 46 Punkte und liegt hinter der ersten Reihe. Beim passenderen Codierung-Agenten-Index erreicht das Ergebnis direkt 56 Punkte und belegt den 4. Platz, was eine deutliche Verbesserung gegenüber den 47 Punkten von Grok 4.6 darstellt.
Grok 4.7: Ich kann den Nachbarn nicht übertreffen, aber kann ich nicht mich selbst übertreffen??
Natürlich steigen bei Grok 4.7 diesmal nicht nur die Punktzahlen, sondern auch das Verhältnis von Leistung zu Kosten wird verbessert.
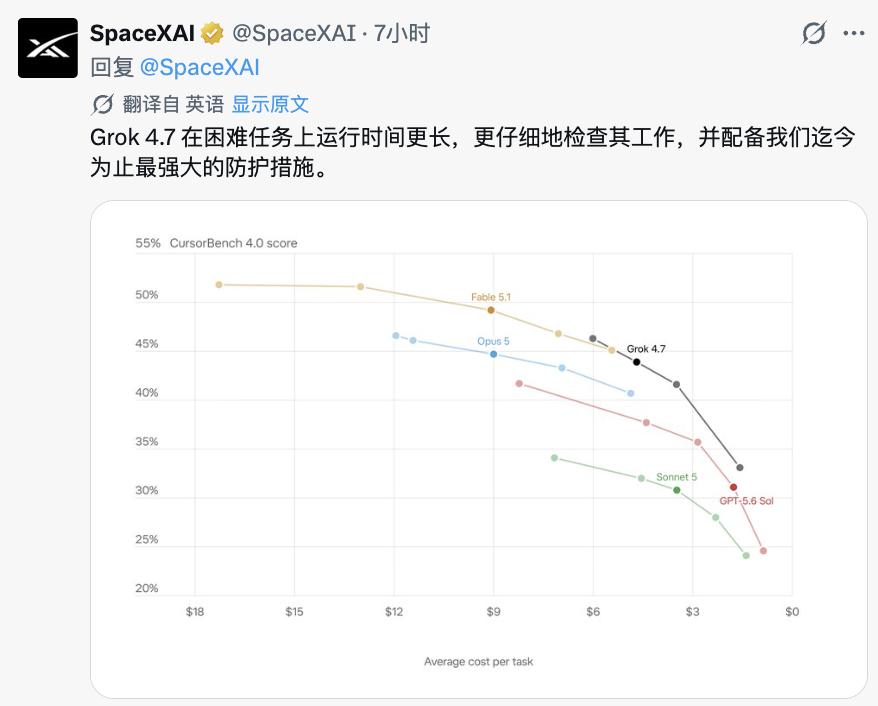
In der von xAI angegebenen Kostenkurve von CursorBench 4.0 kann die Leistung von Grok 4.7 weiter steigen, wenn das Budget für eine einzelne Aufgabe erhöht wird.
Bei etwa 4 bis 5 USD pro Aufgabe erreicht es bereits etwa 43 %, und bei weiterem Budgetanstieg kann es sich 46 % nähern.
Man sieht, dass bei gleichem Budget GPT-5.6 Sol etwa bei 37 % liegt, der Abstand beträgt etwa 6 Prozentpunkte...
Das zeigt auch, dass bei dieser Generation von Modellen bei komplexen Codieraufgaben ein etwas höheres Budget für die Schlussfolgerung tatsächlich eine stabilere Leistungssteigerung bringen kann??
Gleich nach dem Raketentest wird Grok 4.7 von Nutzern dazu gebracht, Spiele zu entwickeln und Brücken zu bauen!
Was unterhaltsamer ist als die Veröffentlichung von Grok 4.7 selbst, sind die Aktionen der Nutzer.
Kurz nachdem sie es zum Testen von Raketen verwendet haben, haben die Nutzer Grok 4.7 bereits in verschiedenen Szenarien getestet.
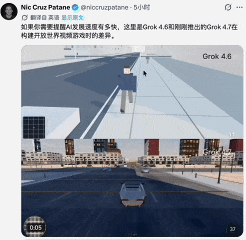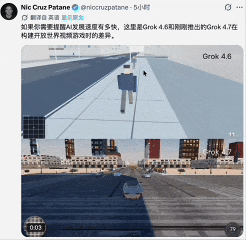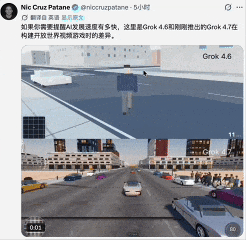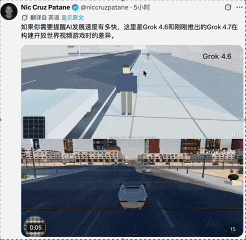
Unten ist das Vergleichsdiagramm der offenen Spielwelten von Grok 4.6 und Grok 4.7, der Unterschied im visuellen Eindruck ist tatsächlich ziemlich deutlich.
Bei 4.6 hat es noch etwas den Geschmack eines kleinen Pixelspiels, die Grafik ist flach und die Modellierung ist eher einfach (nach meiner eigenen Meinung).
Bei 4.6 ist das Gefühl der Modellierung deutlich stärker, Details von Gebäuden, Straßen, Licht und Schatten sowie Szenen sind solider, es sieht schon wie ein echtes 3D-Spiel-Demo aus:
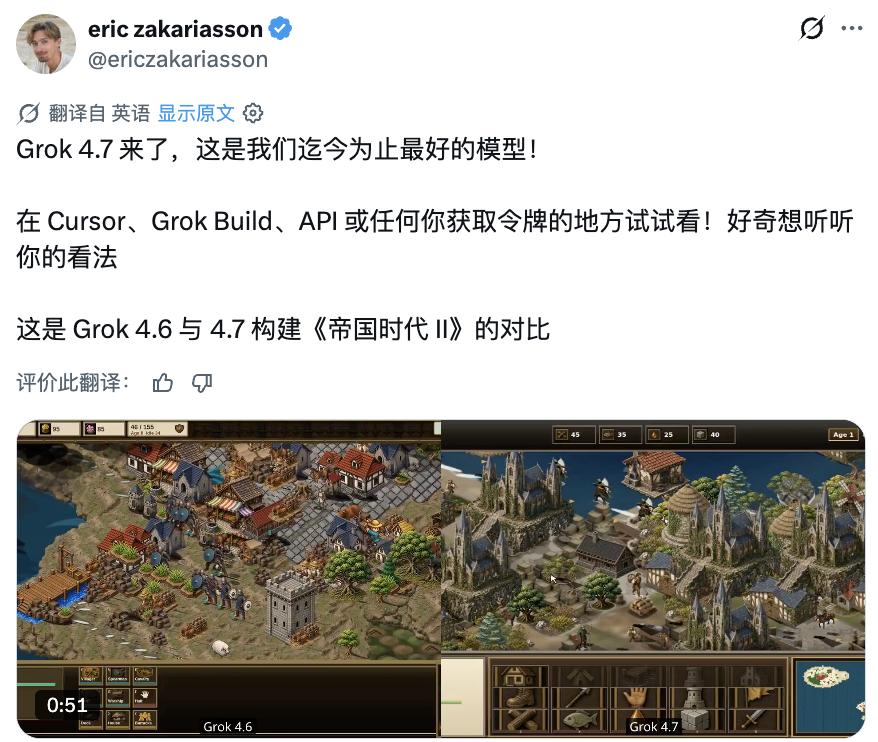
Dann schauen wir uns diesen Nutzer an, der Grok 4.7 direkt dazu gebracht hat, „Age of Empires 2“ zu erstellen.
Nach den Details der Grafik zu urteilen, ist die Detailgenauigkeit der Gebäude tatsächlich besser als bei der vorherigen Generation, aber die Farben der Grafik von 4.6 sind besser, beide haben ihre eigenen Vorteile. Was denkt ihr?
Weiter unten steigt der Schwierigkeitsgrad weiter an.
Ein Nutzer hat Grok 4.7 direkt in Blender eingesetzt, um es dazu zu bringen, vor Ort die Golden Gate Bridge zu bauen.
Der gesamte Vorgang dauerte nur 17 Minuten, Nahansicht, Fernansicht und Nahaufnahme sind im Grunde vorhanden, die Struktur der Brücke und die Vollständigkeit der gesamten Grafik sehen auch sehr gut aus.
Nach den Screenshots des Nutzers zu urteilen – die dafür aufgewendete Zeit ist absolut wert!!

Schauen wir uns dann diesen Nutzer an.
Er hat Grok 4.7 ein echtes Aufnahmevideo des SpaceX Starship als Referenz gegeben und es dazu gebracht, einen Stop-Motion-Animation nach dem echten Material neu zu erstellen.
Das endgültig erstellte Video hat einen Stil ähnlich wie handgezeichnete technische Skizzen / retro Stop-Motion-Animation:
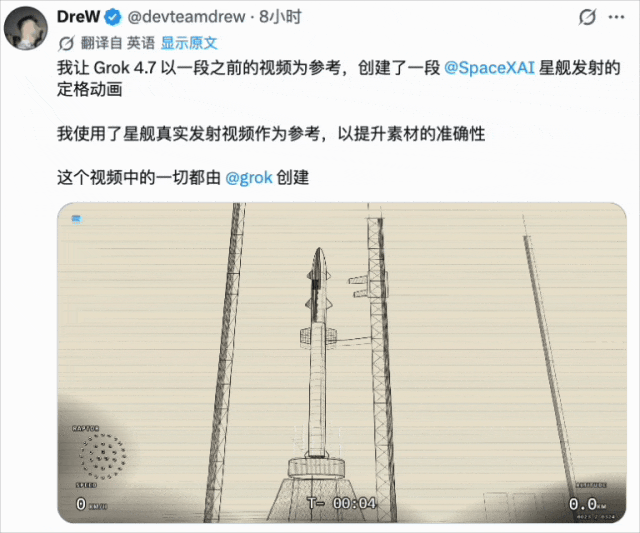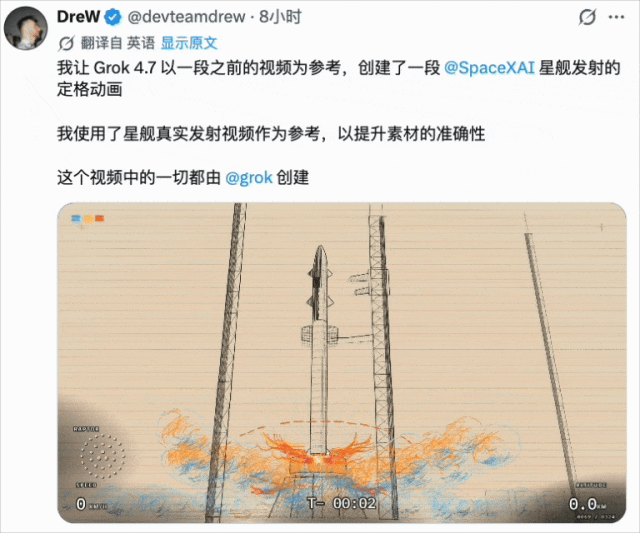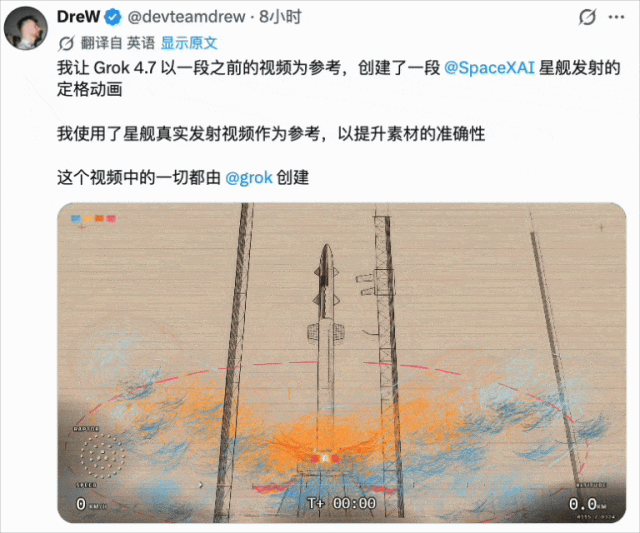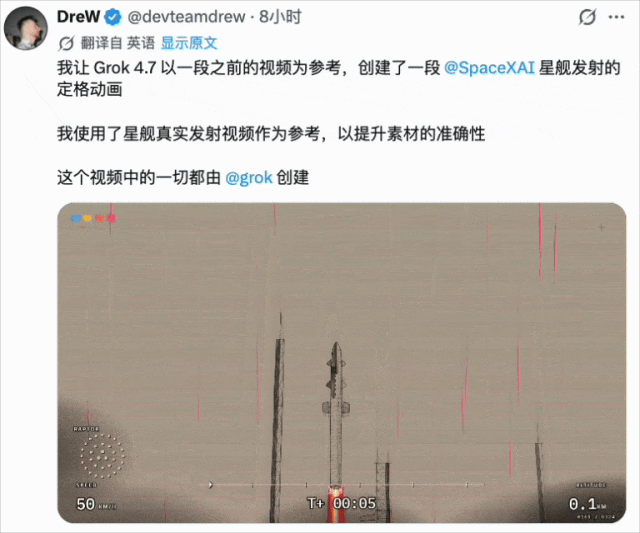
Auch bei kleinen Spielen gibt es bald jemanden, der das Ergebnis in Frage stellt.
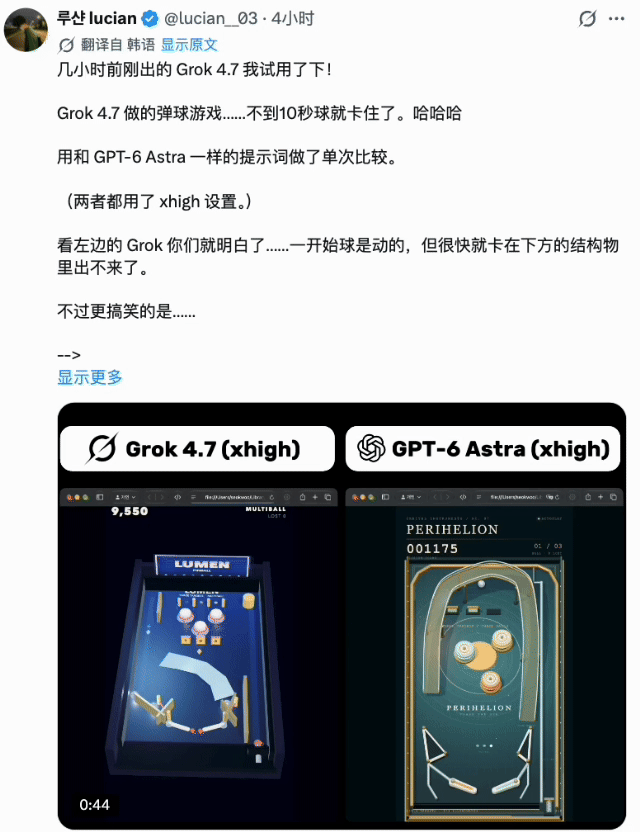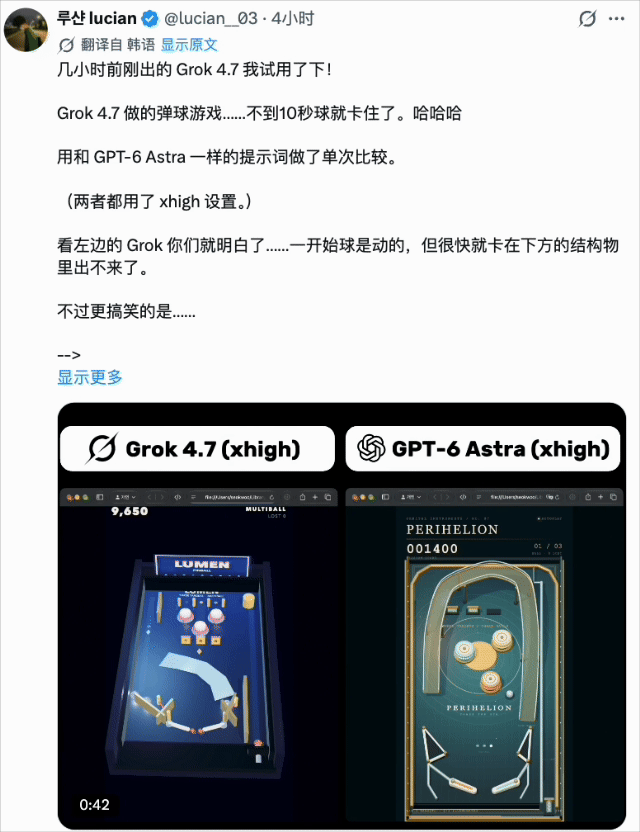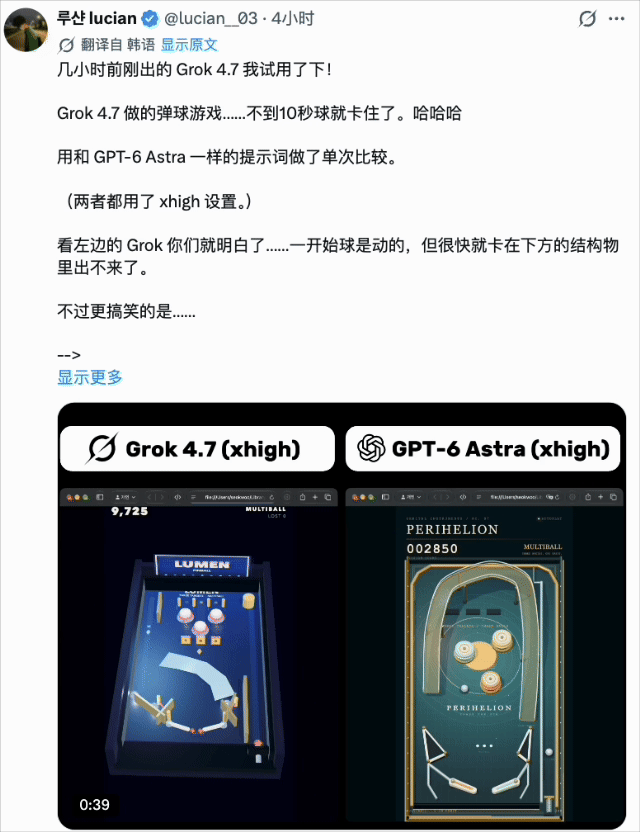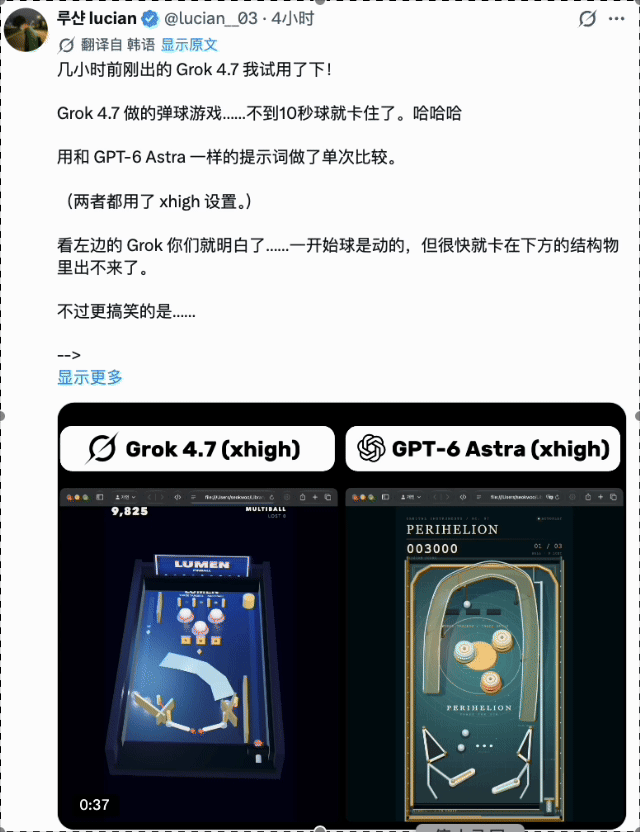
Ein Nutzer hat Grok 4.7 und GPT-6 Astra jeweils ein Flipper-Spiel erstellen lassen, dann passiert das peinliche Szenario –
Bei Grok läuft es am Anfang noch normal, der Ball kann springen und die Grafik läuft, aber nach weniger als 10 Sekunden bleibt der Ball direkt stecken und bewegt sich nicht mehr.
Es kann wirklich große Aufgaben übernehmen, aber hat Schwierigkeiten mit dem kleinen Ball!!
Zusammengezählt sind es nur noch wenige Tage bis zum Nationalfeiertag, an dem der globale Wettbewerb der Basismodelle stattfindet.
Das ist doch eine Veröffentlichung zur falschen Zeitvermeidung, oder?
Das Claude 5.2 von Unternehmen A nebenan steht kurz vor der Veröffentlichung.
Der interne Testeffekt von Google Gemini 4 Pro wird in den sozialen Medien weit verbreitet, und es wird vermutet, dass es sogar unter einem Pseudonym heimlich in die Arena eingetreten ist, um die Bewertungsprüfung zu absolvieren.
Inländische Hersteller beginnen auch nach und nach, ihre Karten zu erhöhen. Die Tage um den Nationalfeiertag sehen aus wie eine neue Runde der konzentrierten Einreichung von Ergebnissen der Basismodelle.
Grok 4.7 zu diesem Zeitpunkt zu veröffentlichen, ist doch eine sehr kluge Entscheidung, oder?
Referenzlinks:
[1]https://x.com/SpaceXAI/status/2102069815225586149?s=20
[2]https://x.com/SpaceXAI/status/2102069817893150777?s=20
[3]https://x.com/ArtificialAnlys/status/2102074898327932987?s=20
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „QbitAI“, Autor: Meng Yao, veröffentlicht mit Genehmigung von 36Kr.