Gerade hat das neue GPT-6-Modell den Markt komplett auf den Kopf gestellt und ist zu Spottpreisen in das Kerngebiet von DeepSeek vorgedrungen.
DeepSeek, wach auf, ChatGPT steht direkt vor deiner Tür.
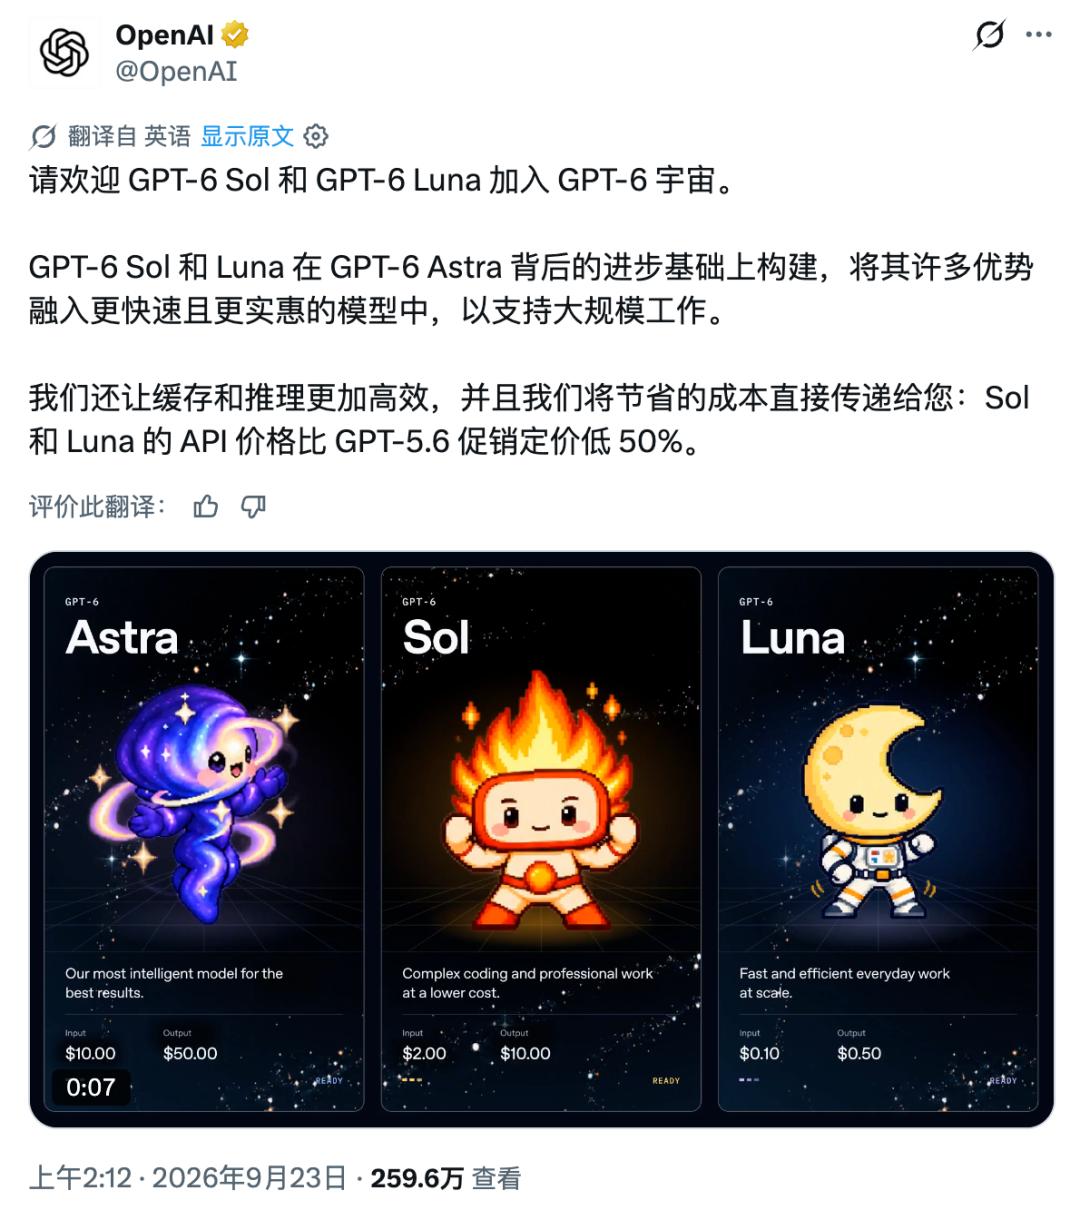
Gerade eben hat OpenAI offiziell GPT-6 Sol und GPT-6 Luna veröffentlicht, wobei der API-Preis auf etwa die Hälfte der vorherigen Generation gesenkt wurde. Bei Luna kostet eine Million Eingabe-Token 0,1 US-Dollar und eine Million Ausgabe-Token 0,5 US-Dollar, was etwa 0,7 Yuan bzw. 3,5 Yuan entspricht.
Als Vergleichswert liegt der Eingabepreis bei verfehltem Cache von DeepSeek V4.1 Flash in der Nebensaison bei 1 Yuan pro Million Token, der Ausgabepreis bei 4 Yuan, in der Spitzenzeit steigen sie auf 2 Yuan bzw. 8 Yuan. Berechnet nach normalen neuen Anfragen ist Luna bereits günstiger und weist keine Kostenschwankungen auf, die durch die Preisgestaltung für Spitzen- und Nebenzeiten entstehen.
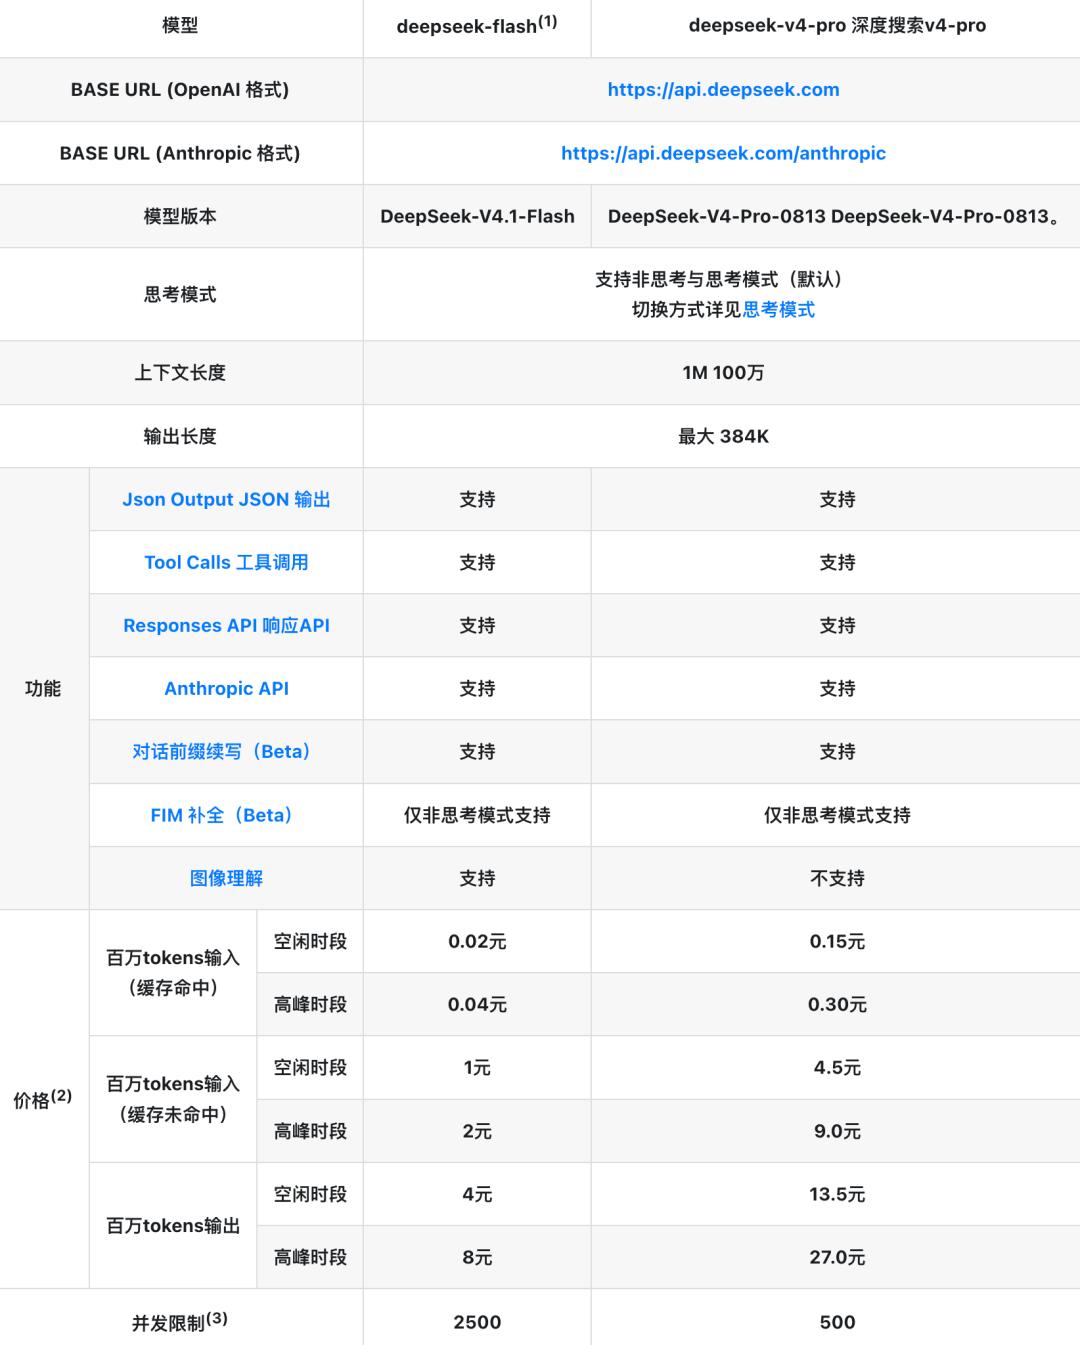
DeepSeek hält immer noch sein eigenes Preis-Ass in der Hand. Die Eingabe bei getroffenem Cache in der Nebensaison kostet nur 0,02 Yuan pro Million Token, weit weniger als bei Luna. Die umfassende Leistungsfähigkeit von V4.1 Flash ist ebenfalls deutlich höher, es verfügt über einen Kontext von 1 Million Token und unterstützt Bild- und Textverständnis, Tool-Aufrufe sowie Denkmodi.
In normalen Anfragen mit verfehltem Cache hat Luna das DeepSeek-Modell jedoch bereits in denselben Preissegment gezogen, was bedeutet, dass das unverwechselbare Niedrigpreismarkenzeichen von DeepSeek ab sofort einen starken ausländischen Konkurrenten hat.
Astra strebt nach der Höchstleistung, Sol und Luna erobern den Markt
Anfang dieses Monats veröffentlichte OpenAI GPT-6 Astra und bezeichnete es als das derzeit leistungsstärkste und am besten ausgerichtete Modell des Unternehmens. Astra ist auf schwierige und hochwertige Aufgaben ausgerichtet, aber der Preis von 10 US-Dollar pro Million Eingabe-Token und 50 US-Dollar pro Million Ausgabe-Token bestimmt, dass es kaum die Standardoption für tägliche Arbeiten werden kann.
Sol und Luna übernehmen eine andere Aufgabe.
OpenAI gab an, dass die beiden Modelle ähnliche Trainingsmethoden wie Astra verwenden und die Fortschritte von Astra bei professionellen Arbeiten, Faktengenauigkeit, Programmierung, Computerbedienung und Ausrichtung auf Produkte mit höherer Geschwindigkeit und niedrigeren Preisen übertragen.
Die neue API-Preisgestaltung ist unerwartet.
GPT-6 Sol sinkt von 4 US-Dollar pro Million Eingabe-Token und 20 US-Dollar pro Million Ausgabe-Token während des Aktionszeitraums von GPT-5.6 Sol auf 2 US-Dollar bzw. 10 US-Dollar; GPT-6 Luna sinkt von 0,2 US-Dollar und 1,2 US-Dollar auf 0,1 US-Dollar bzw. 0,5 US-Dollar.
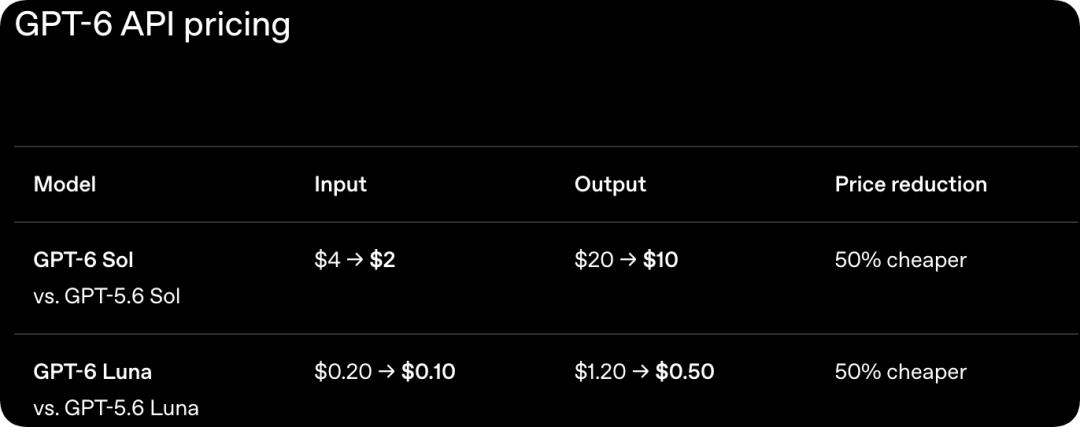
Für diese Preissenkung führt OpenAI sie auf Verbesserungen der Infrastruktur für das Inferenzieren und der Cache-Effizienz zurück und gibt an, dass das Ziel darin besteht, die Vorteile direkt an die Nutzer weiterzugeben.
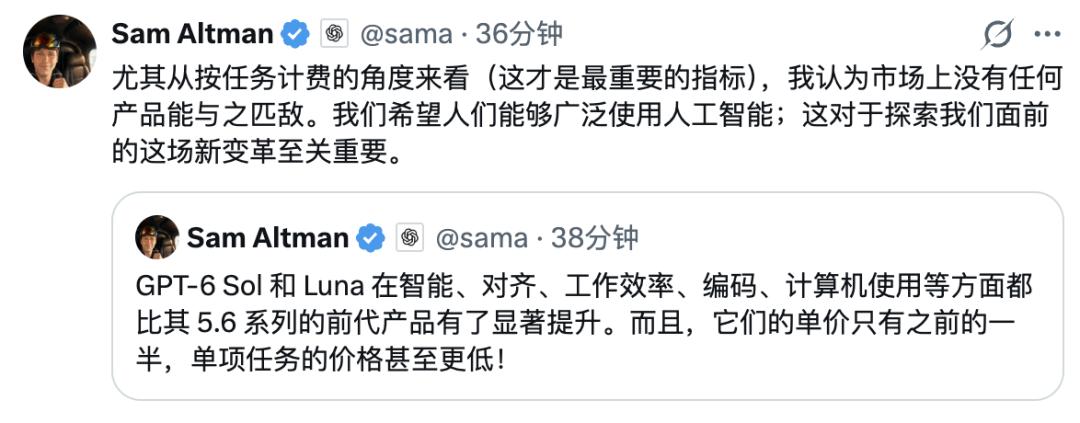
Sam Altman, CEO von OpenAI, betonte nach der Veröffentlichung, dass der wirklich wichtige Indikator die Kosten für die Erledigung einer Aufgabe sei, und in diesem Bereich glaube er, dass derzeit kein Produkt auf dem Markt mit Sol und Luna mithalten könne.
Die Produktaufteilung wird damit ebenfalls klar.
Astra übernimmt weiterhin die höchste Leistungsgrenze, Sol ist auf gängige professionelle Aufgaben ausgerichtet, die starke Inferenz-, Programmier- und Agent-Fähigkeiten erfordern, während Luna mit extrem niedrigen Preisen häufige und skalierbare Arbeiten übernimmt.
Der Schwerpunkt der diesjährigen Konkurrenz von OpenAI erstreckt sich bereits von der Höchstpunktzahl auf Ranglisten hin zu der Anzahl an Arbeiten, die mit jedem Dollar erledigt werden können.
Die offiziell veröffentlichten Ergebnisse zeigen, dass die Hauptwettbewerbsfähigkeit von GPT-6 Sol auf professionellen Arbeiten und Agent-Aufgaben liegt.
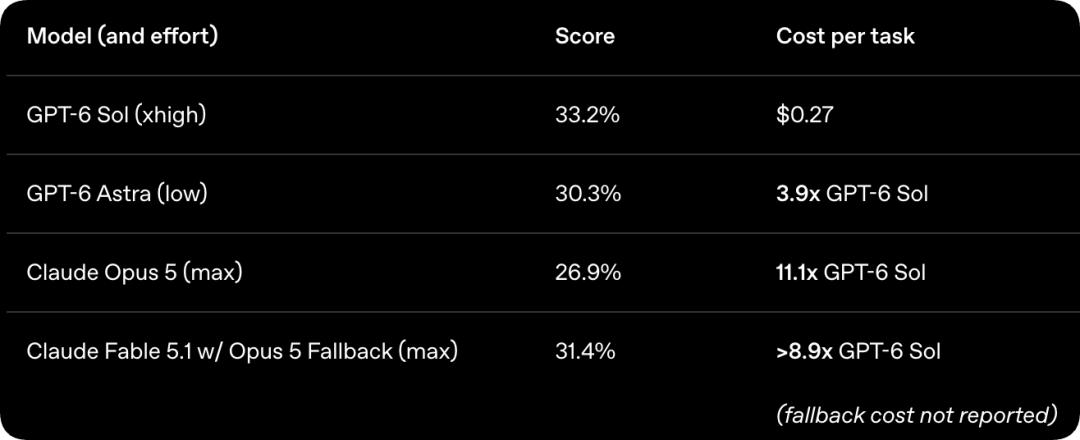
In AutomationBench, das Arbeitsabläufe aus Bereichen wie Vertrieb, Marketing, Betrieb, Kundenservice, Finanzen und Personalwesen testet, erzielte GPT-6 Sol mit der xhigh-Inferenzintensität ein Ergebnis von 33,2 %, was über dem Wert von 26,9 % von Claude Opus 5 bei maximaler Inferenzintensität liegt, während die Kosten für eine einzelne Aufgabe nur 9 % des letzteren betragen.
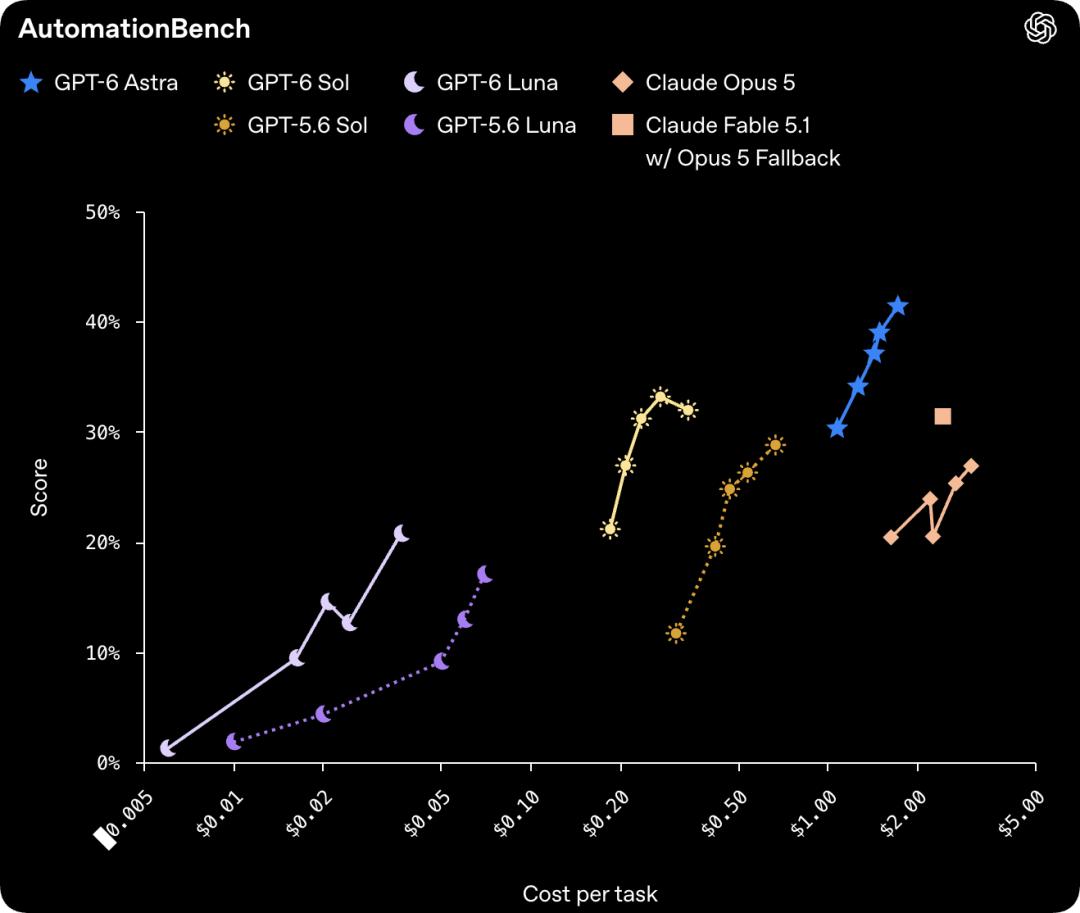
Es übertraf auch GPT-6 Astra mit niedriger Inferenzintensität und erzielte höhere Ergebnisse zu deutlich niedrigeren Kosten als Claude Fable 5.1.
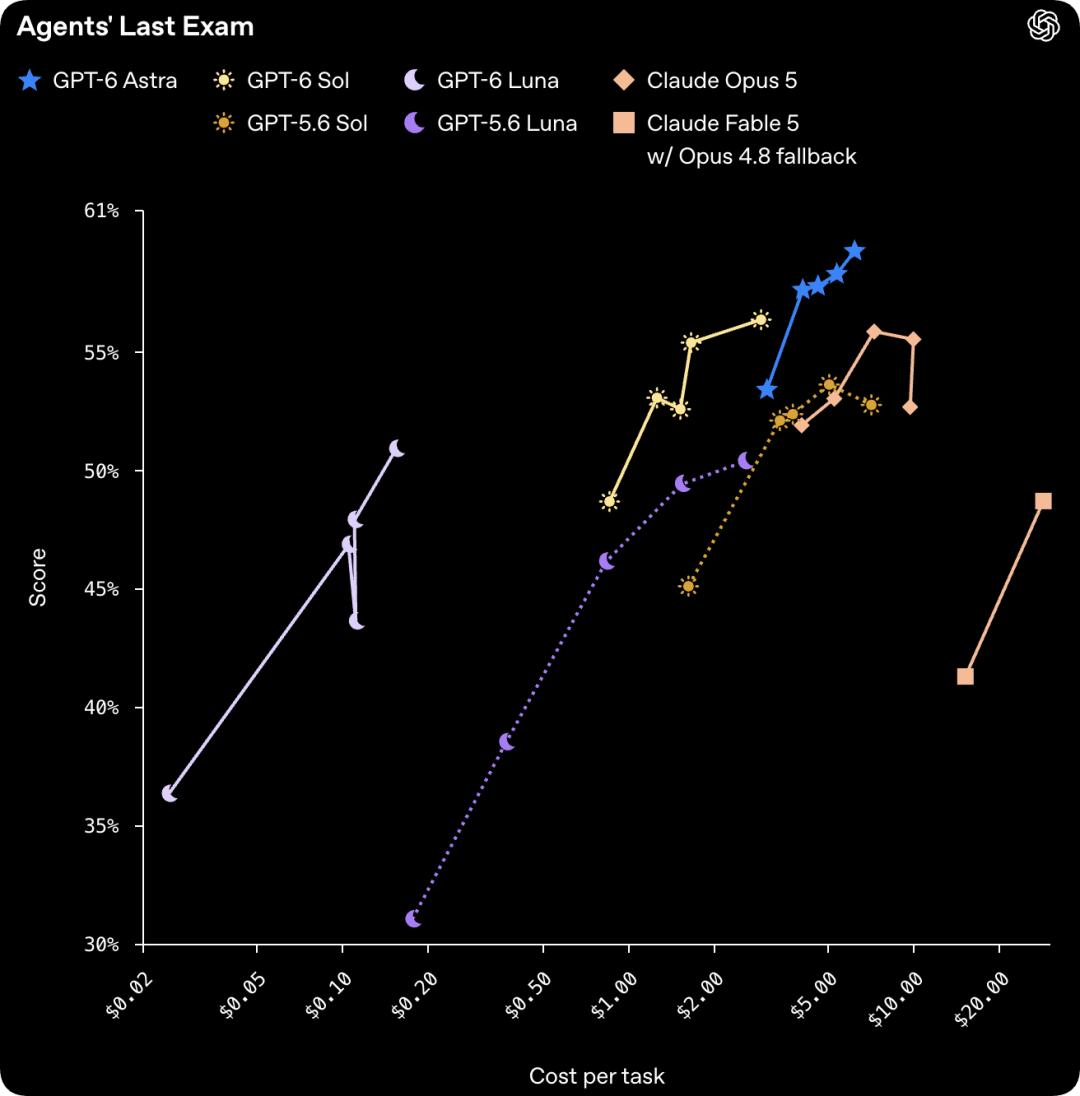
Agents’ Last Exam deckt 55 Teilbranchen ab und prüft hauptsächlich professionelle Aufgaben mit langen Verknüpfungen und tatsächlichem wirtschaftlichem Wert. GPT-6 Sol erzielte bei maximaler Inferenzintensität 56,4 %, übertraf damit das höchste Ergebnis von Claude Opus 5 in dieser Bewertung, wobei die Kosten für eine einzelne Aufgabe um etwa 60 % niedriger lagen.
Die Faktengenauigkeit wurde ebenfalls deutlich verbessert.
OpenAI führte interne Tests mit anonymen echten Gesprächen durch, in denen Nutzer zuvor Faktenfehler markiert hatten. Die Anzahl der Fehler von GPT-6 Sol betrug etwa die Hälfte der von GPT-5.6 Sol und nähert sich allmählich der Zuverlässigkeit von Astra an.
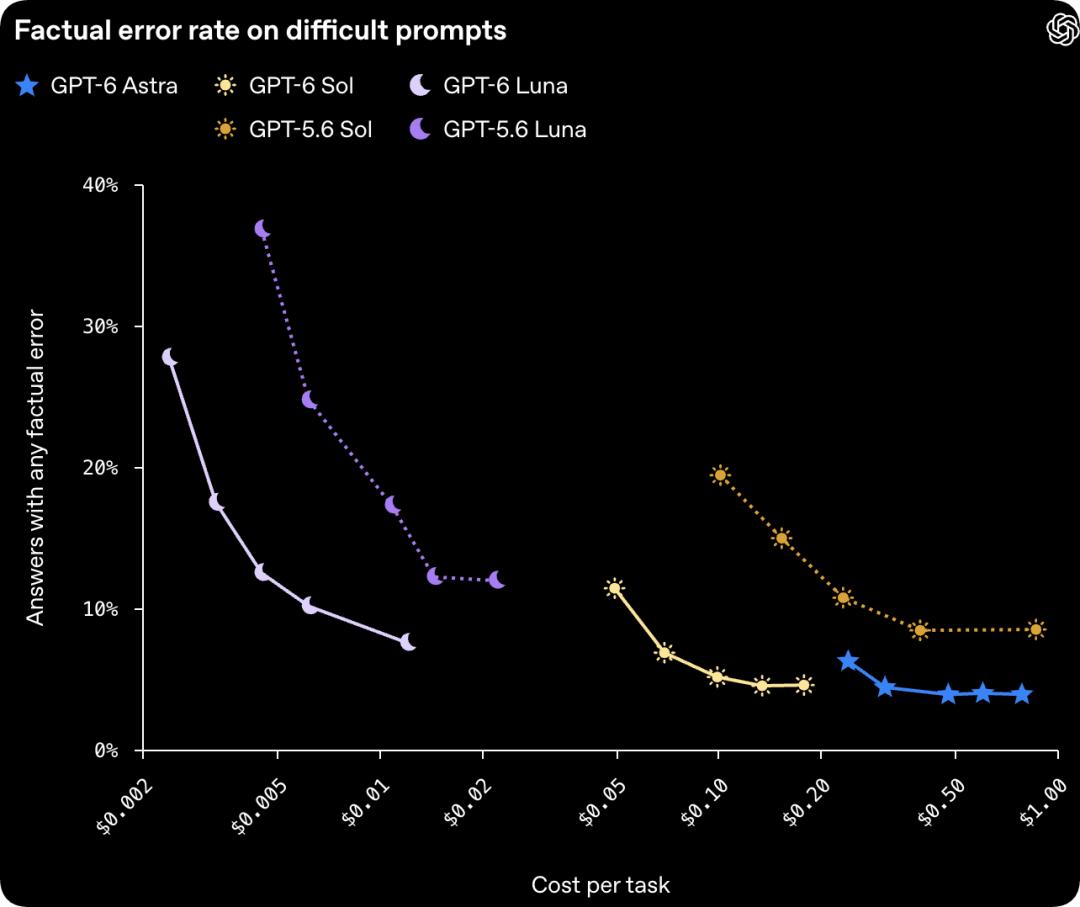
Bei hoher Inferenzintensität erreicht GPT-6 Luna etwa die Leistung von GPT-5.6 Sol zu einem Hundertstel der Kosten.
Stärkere Fähigkeiten bei Programmierung und Computerbedienung: OpenAI senkt auch die Preise auf extrem niedrige Niveaus
Programmierung ist eines der wichtigsten Anwendungszenarien von Sol.
OpenAI gab bekannt, dass die Anzahl der internen Forscher, die Programmier-Agenten verwenden, schnell wächst. Berechnet nach API-Preisen übersteigt der Wert der täglich verbrauchten Token des mittleren Forschers 600 US-Dollar, und der Wert der Token des Forschers im 90. Perzentil übersteigt 7000 US-Dollar. Je länger die Aufgaben sind, die von Agenten übernommen werden, desto deutlicher schränken die Inferenzkosten die Nutzungshäufigkeit ein.
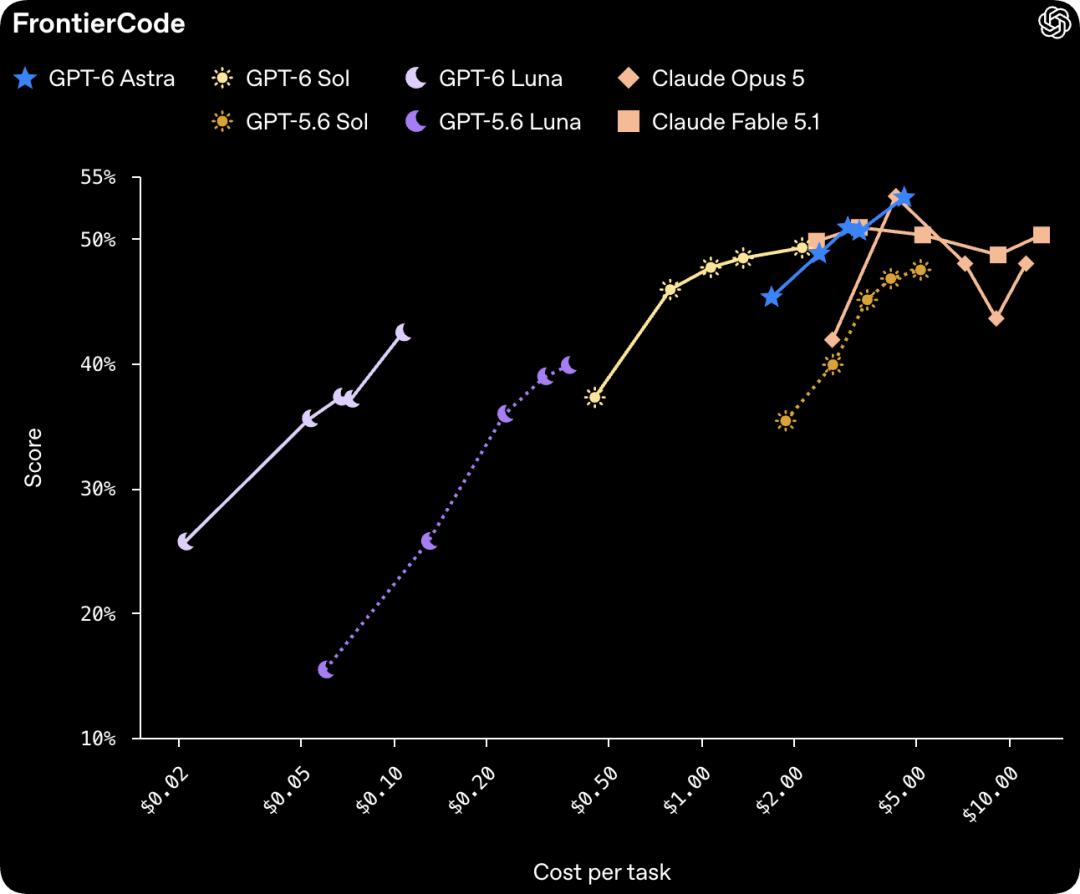
In FrontierCode, das prüft, ob Code direkt in echte Projekte eingebunden werden kann, machte GPT-6 Sol im Vergleich zur vorherigen Generation deutliche Fortschritte und erreichte die Leistung von Claude Fable 5.1 xhigh zu niedrigeren Kosten.
Im Software-Engineering-Test DeepSWE v1.1 auf einer echten Codebasis erzielte Sol bei maximaler Inferenzintensität 68,8 %, was nur 1,1 Prozentpunkte unter dem Spitzenwert von 69,9 % von Claude Fable 5 liegt, wobei die Kosten für eine einzelne Aufgabe um etwa 80 % niedriger sind. Im Vergleich dazu liegt das Ergebnis von DeepSeek V4.1 Flash bei 74,2 %.
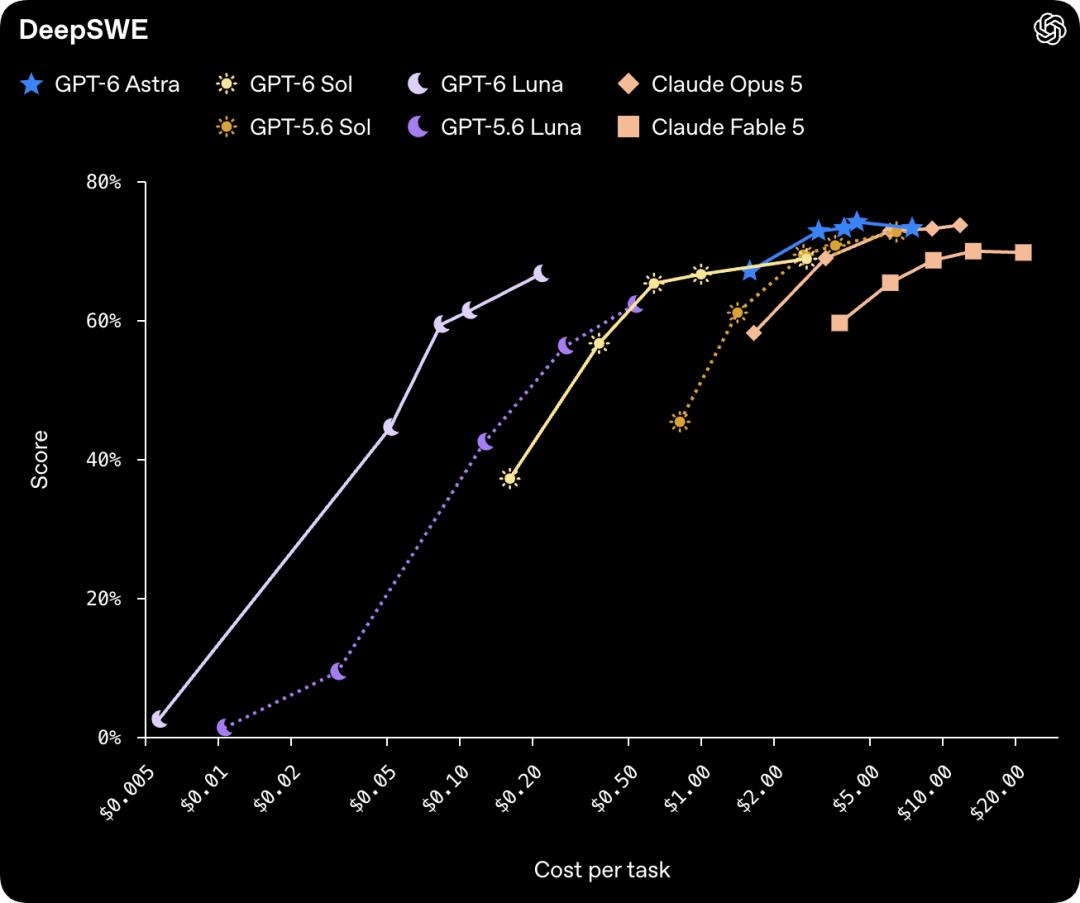
GPT-6 Luna erzielte in derselben Bewertung 66,6 %, was der Leistung von Claude Opus 5 und Fable 5 bei mittlerer Inferenzintensität ähnelt, wobei die Aufgabenkosten um 93 % bzw. 96 % niedriger liegen.
Es ist möglicherweise nicht für die komplexesten Software-Engineering-Projekte geeignet, könnte aber zu einem wirtschaftlicheren Ausführungsmodell für Code-Prüfungen, Massenänderungen, leichtgewichtige Entwicklungen und gleichzeitige Aufgaben mehrerer Agenten werden.
Bei der Computerbedienung ist Astra nach wie vor die leistungsstärkste Option von OpenAI, aber Sol und Luna verbessern die Kosteneffizienz weiter.
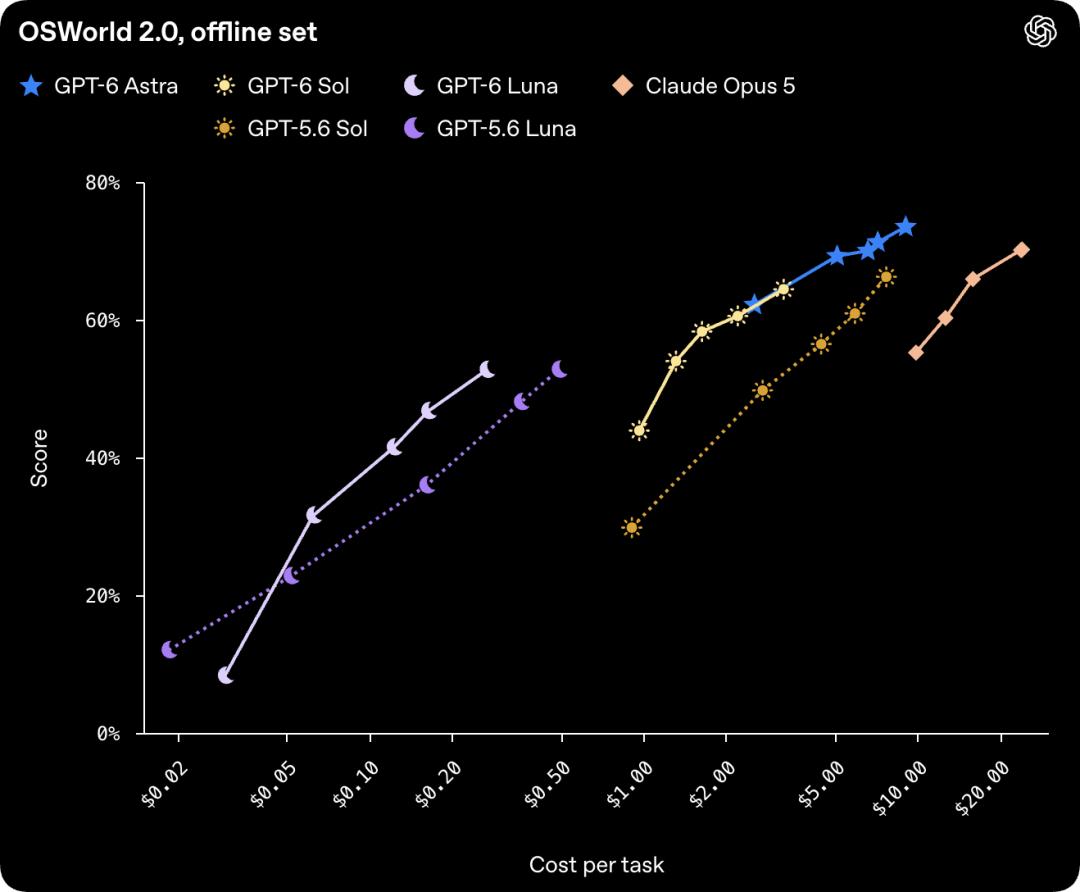
Im Offline-Test von OSWorld 2.0 erzielte Sol xhigh 60,5 %, was in etwa dem Wert von 60,3 % von Claude Opus 5 medium entspricht, wobei die Kosten für eine einzelne Aufgabe um etwa 80 % niedriger sind; das Ergebnis von Luna bei maximaler Inferenzintensität übertrifft GPT-5.6 Sol medium, während die Kosten nur ein Zehntel des letzteren betragen.
Die Kommunikationsweise der Modelle übernimmt ebenfalls die Anpassungen von Astra.
OpenAI gab an, dass Sol und Luna Fachbegriffe, seltsame Formulierungen und Details mit geringem Wert reduzieren, die Antworten insgesamt etwas kürzer halten und gleichzeitig klarer angeben, was geprüft wurde und was nicht. Bei programmierbezogenen und technischen Aufgaben, die kontinuierliche Zusammenarbeit erfordern, wird die Zuverlässigkeit der Ausdrucksweise genauso wichtig wie die Qualität einer einzelnen Antwort.
Nach der Veröffentlichung der Modelle erhielten wir auch die ersten Praxistests von Nutzern, die schnell zu zwei völlig unterschiedlichen Bewertungen führten.
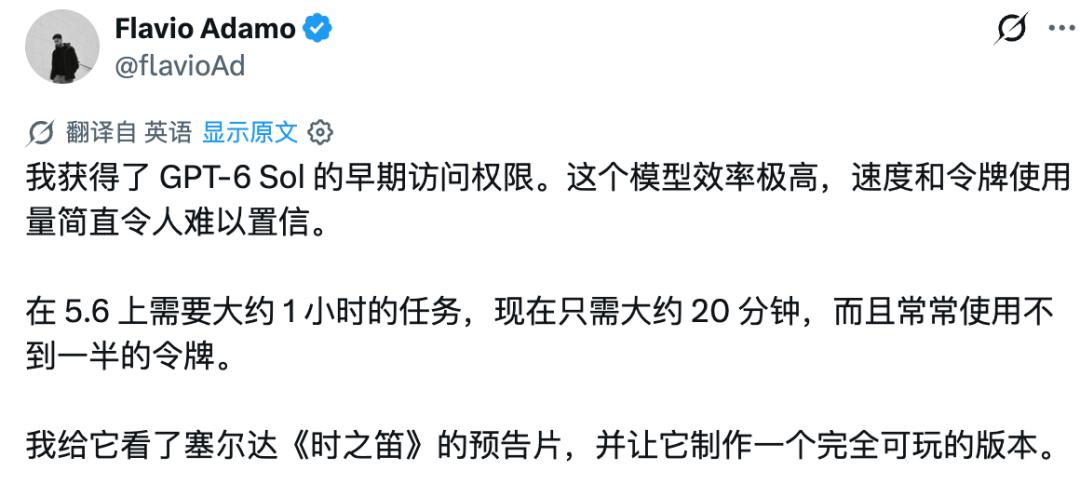
Der Entwickler Flavio Adamo sagte nach der vorzeitigen Nutzung von GPT-6 Sol, dass Aufgaben, die früher auf GPT-5.6 normalerweise etwa eine Stunde dauerten, jetzt oft in etwa 20 Minuten erledigt werden können, wobei der Token-Verbrauch weniger als die Hälfte des ursprünglichen Werts beträgt.
Als wir GPT-6 Sol für den Praxistest des venezianischen Kanal-Schnellboot-Spiels verwendeten, lieferte das Modell am Ende ein fertiges Three.js-Produkt, das direkt spielbar ist. Kernfunktionen wie das Durchqueren von Brückenöffnungen, der Countdown, der Kielwasser, Wasserspiegelreflexionen und Verfolgungsaufnahmen funktionieren alle normal, und die Ästhetik ist ziemlich gut.