Grok 4.7 ist online gegangen und belegt den dritten Platz weltweit. Elon Musk erklärt, dass auch das Training von Grok 4.8 bereits abgeschlossen ist.
Gerade eben hat Musk offiziell SpaceXAI vorgestellt, mit dem brandneuen Hauptmodell Grok 4.7!
Das Kernverkaufsargument lautet: Bei gleichem Preis und gleicher Geschwindigkeit bietet es eine überragende Leistung.
Musk hat sofort öffentlich Stellung bezogen: „Grok 4.7 hat SpaceXAI auf den dritten Platz im Bereich der intelligenten Agenten-Programmierung gebracht, nur hinter Anthropic und OpenAI.“
Mit hoher Geschwindigkeit und niedrigem Preis ist Grok 4.7 die erste Wahl für Einzelpersonen bei der täglichen Arbeit.
Auf dem offiziellen Blog von SpaceXAI wird das Modell wie folgt positioniert: Der stärkste Grok aller Zeiten, entwickelt speziell für Programmierung und wissensbasierte Arbeit.
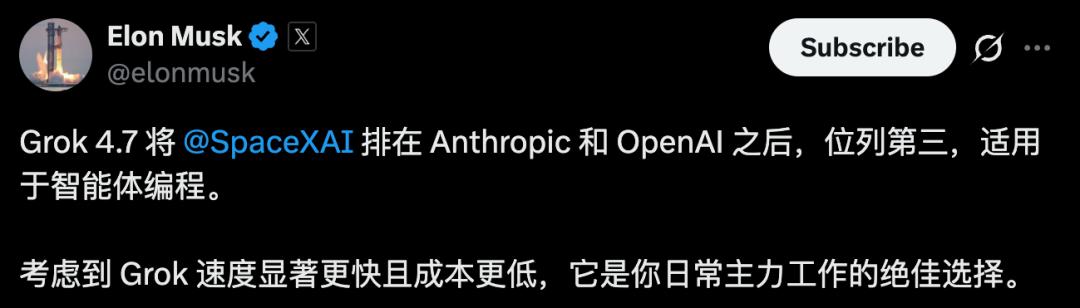
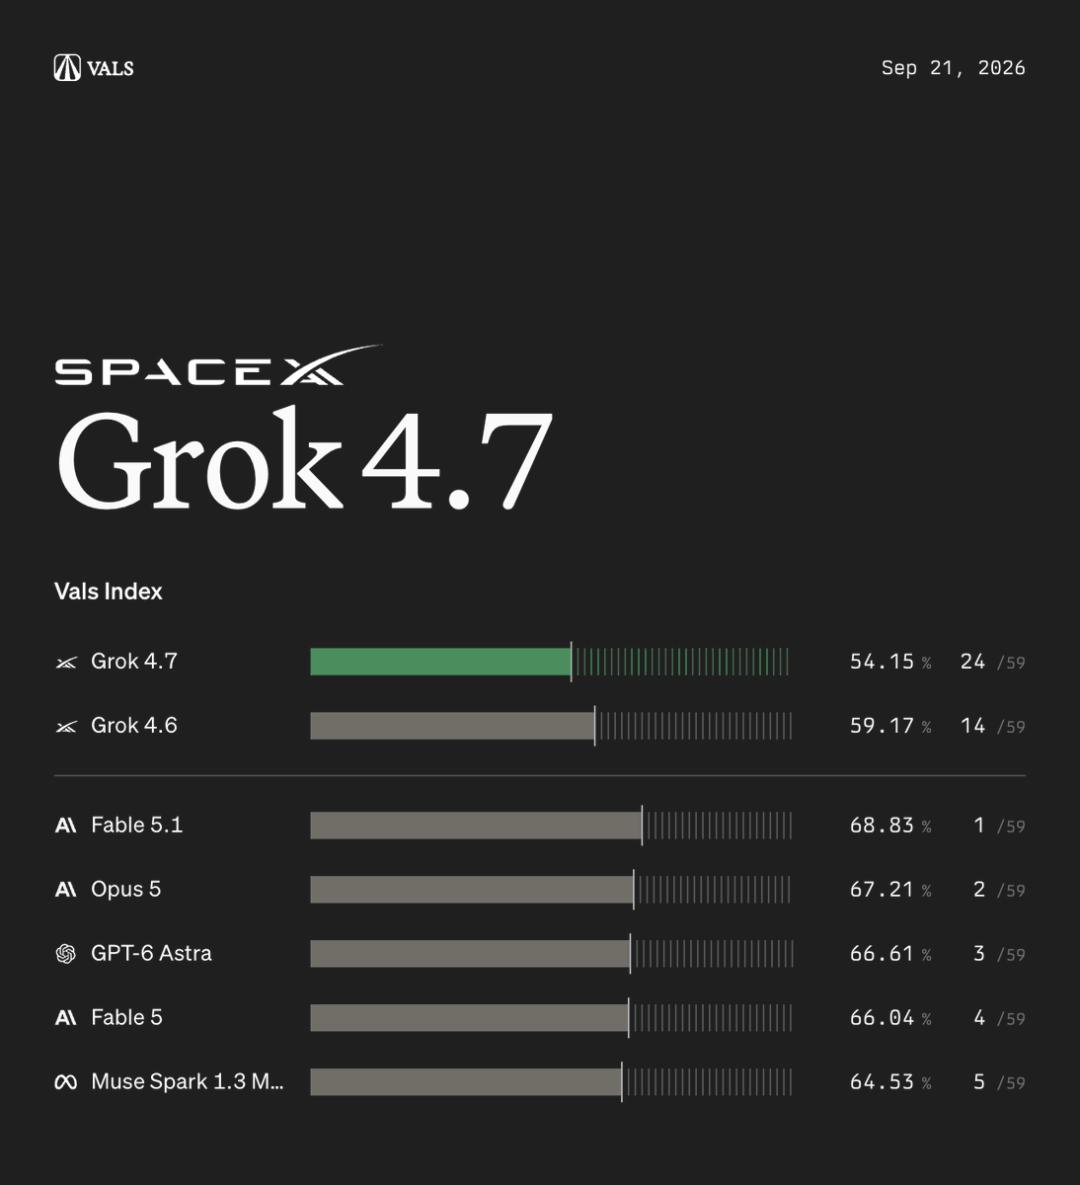
Konkret übertrifft Grok 4.7 in den Benchmarks für Programmierung und wissensbasierte Arbeit fast die Leistung von GPT-5.6 Sol Max und kommt Fable 5.1 Max sehr nahe.
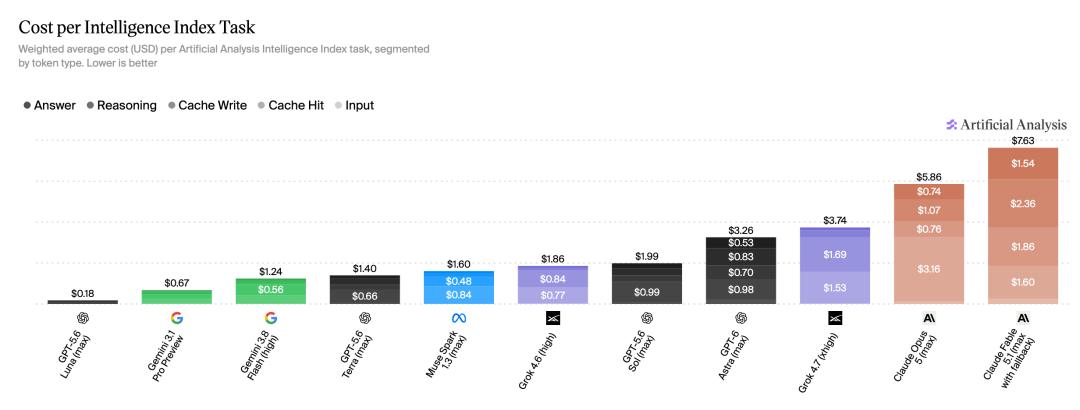
Der Preis beträgt 2 US-Dollar pro Million Token für die Eingabe und 6 US-Dollar für die Ausgabe, genau so wie bei Grok 4.6.
Aber das zugrundeliegende Modell wurde komplett überarbeitet: Das Basismodell ist größer, das Training mit verstärktem Lernen wurde verlängert, und die Gewichtung der Aufgabenschwierigkeit wurde auf „Arbeiten, die mehrere Stunden in Anspruch nehmen“ ausgerichtet.
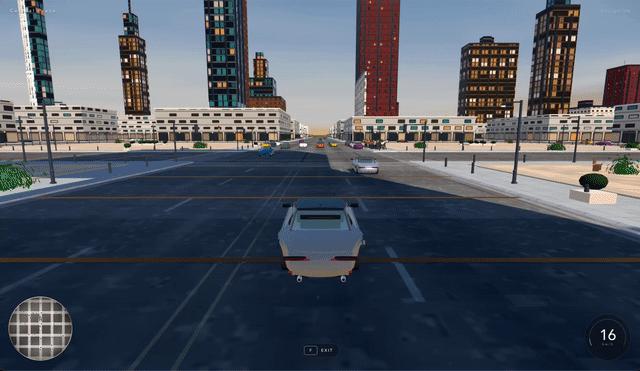
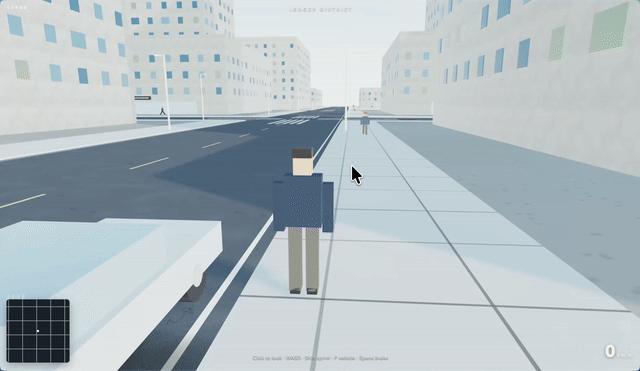
Wenn man Grok 4.7 und Grok 4.6 dazu bringt, ein Open-World-Stadtspiel zu entwickeln, ist der Unterschied mit bloßem Auge sichtbar.
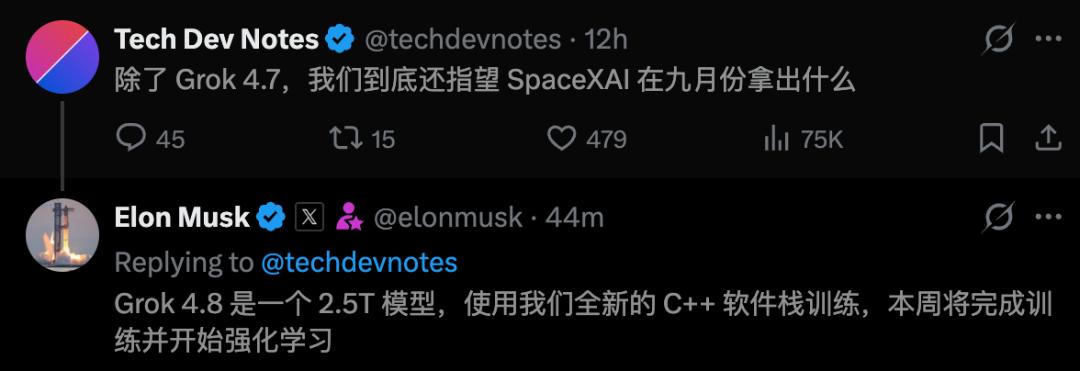
Erwähnenswert ist auch, dass das nächste 2,5-Terabyte große neue Modell Grok 4.8 bereits abgeschlossen ist.
Das Meisterstück von Musk hat gerade erst begonnen.
Grok 4.7 tritt auf den Plan und rückt in der Programmierung in die erste Leistungsgruppe vor
Der Fortschritt von Grok 4.7 lässt sich am besten durch Programmierungstests quantifizieren.
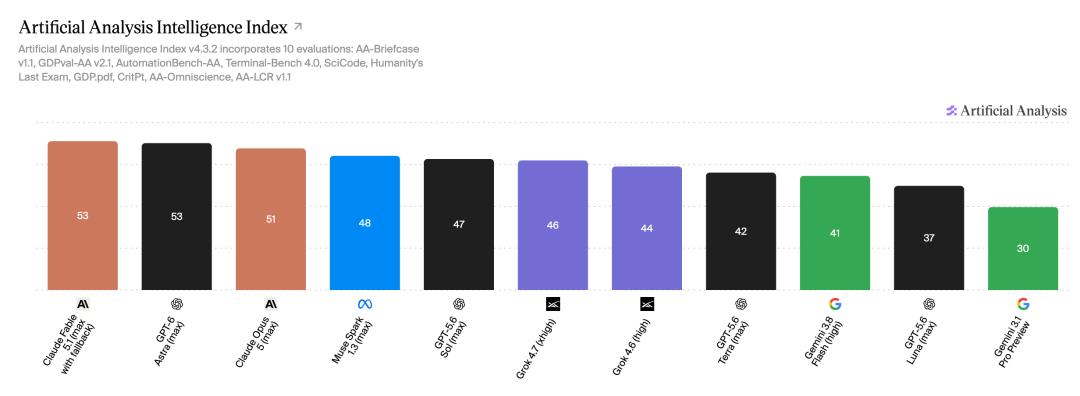
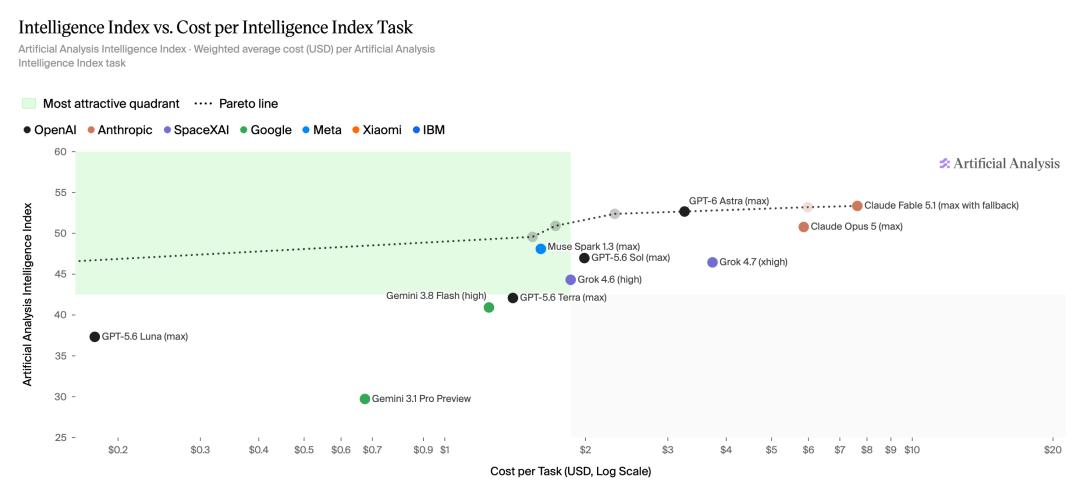
Wenn man die Rangliste von AA aufschlüsselt, sind die Daten sehr interessant.
Beim umfassenden Intelligenzindex erreicht Grok 4.7 46 Punkte, was gegenüber Version 4.6 nur einen bescheidenen Anstieg um 2 Punkte bedeutet. Die Modelle der ersten Leistungsgruppe Fable 5.1 und GPT-6 Astra erreichen beide 53 Punkte.
Gerechnet nach einzelnen Modellen belegt es den 16. Platz; gerechnet nach Forschungslabors landet es genau auf dem vierten Platz.
Die Programm-Rangliste, die Musk so stark hervorhebt, besteht eigentlich aus zwei Teilen.
1. Mit dem GrokBuild-Framework erreicht Grok 4.7 56 Punkte und liegt damit hinter Fable 5.1, GPT-6 Astra und Opus 5. Das von Musk genannte „weltweit dritte Platz“ ergibt sich daraus, dass er die zwei Modelle von Anthropic zu einem Unternehmen zusammenzählt.
2. Beim einheitlichen Benchmark Terminal-Bench4.0 sinkt die Erfolgsquote von Grok 4.7 sofort auf 26 % bis 27 %. Zum Vergleich: GPT-6 Astra erreicht 60 %, Fable 5.1 55 %.
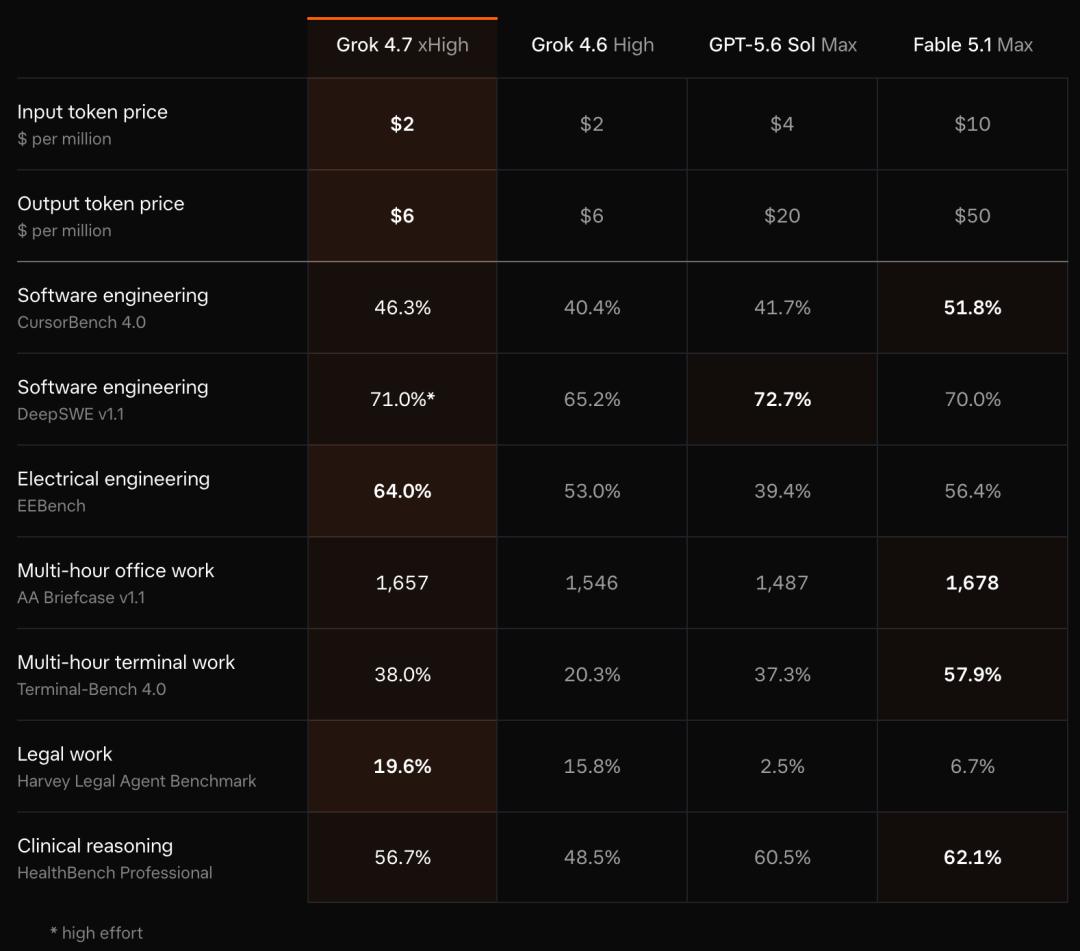
Aber bei der Bewertungsstelle ValsAI sinkt die Punktzahl von Grok 4.7 statt zu steigen: Es fällt direkt vom 14. auf den 24. Platz und liegt sogar 5 Punkte unter der Vorgängerversion 4.6.
Warum setzt Musk sich so sehr für das Build-Framework ein? Die Antwort steht im Anhang der offiziellen Ankündigung –
Grok 4.7 wurde in der Vortrainierungsphase tief an das Interaktionsmuster des GrokBot-Frameworks ausgerichtet.
Mit anderen Worten: Es ist extrem abhängig von der Aufruflogik der eigenen Tools und den Routinen zur Aufgabenzergliederung. Sobald es seine geschützte Umgebung verlässt, sinkt seine Leistungsfähigkeit sofort.
Die Wissensfähigkeit ist ebenfalls sehr stark
Ein weiterer Schwerpunkt dieser Aktualisierung ist ein Szenario, das allen näher steht: die Büroarbeit.
Beim Test für langwierige wissensbasierte Arbeit AA-Briefcase erreicht Grok 4.7 1657 Elo, was 111 Punkte mehr ist als die High-Stufe von Grok 4.6.
Auf GDPval-AA erreicht es 1695 Elo, 90 Punkte mehr als die Vorgängerversion.
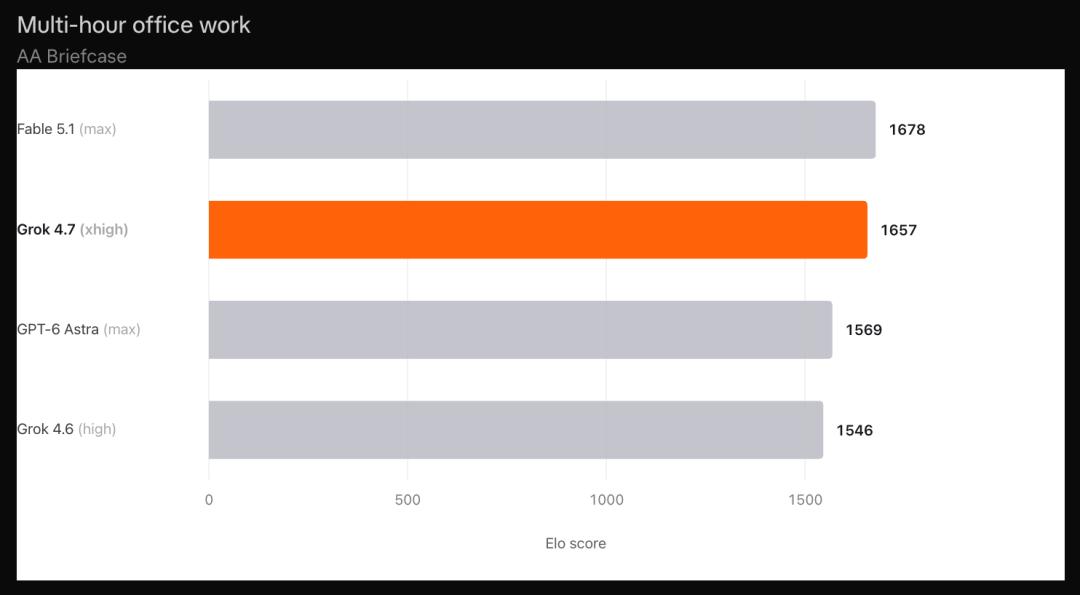
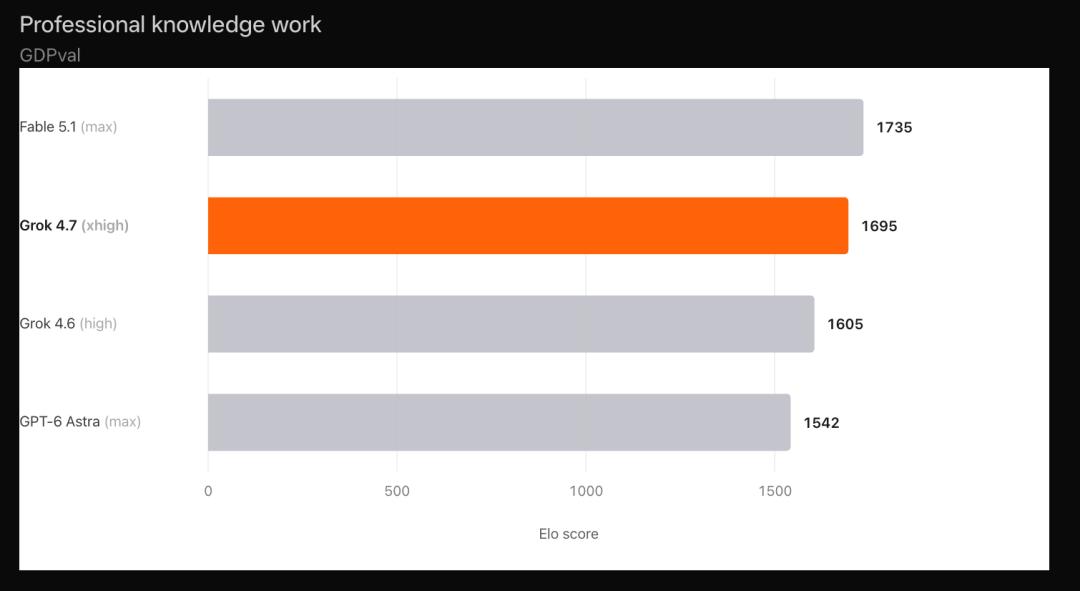
Diese Aufgaben prüfen, ob KI Fachkräften wirklich dabei helfen kann, ihre Arbeit abzuschließen und anständige Ergebnisse zu liefern.
Beispielsweise bei der Organisation von Materialien, der Erstellung von Dokumenten, der Durchführung von Analysen und der Gestaltung von Präsentationen ist Grok 4.7 deutlich leistungsfähiger als die Vorgängerversion.
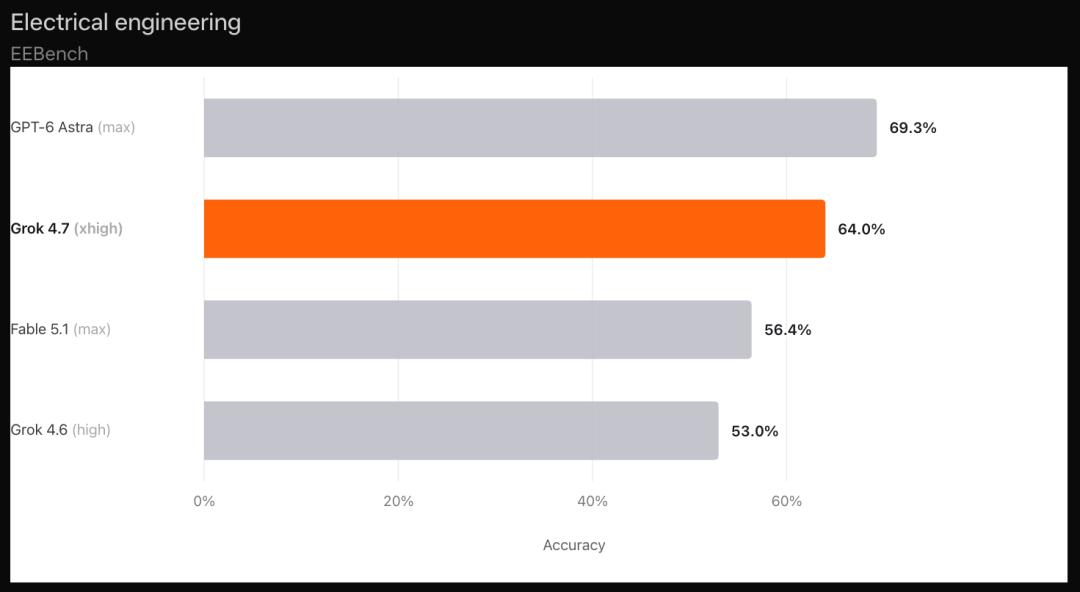
Darüber hinaus erreicht Grok 4.7 beim Elektrotechnik-Test EEBench 64,0 % und damit den höchsten Wert unter den vier aufgeführten Modellen.
Erste Tests im gesamten Netz: Es gibt Überraschungen, aber auch Misserfolge
Sobald Grok 4.7 online ging, waren viele Nutzer schon darauf vorbereitet, es auszuprobieren.
Das berühmteste Demo stammt von dem Entwickler Tak.
Er hat Grok 4.7 keine konkreten Anforderungen gestellt, sondern nur den Satz hinterlassen: „Mach einfach alles, was du in 10 Minuten schaffen kannst.“
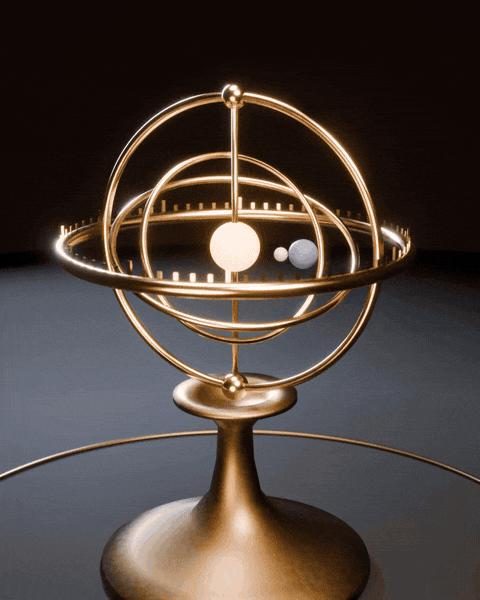
Daraufhin hat Grok selbst in Blender einen Messing-Armillarsphäre erstellt, auf der die Planeten sich sogar drehen können – das hat 250.000 Nutzer im gesamten Netz angezogen.
Tak selbst kommentierte: „Ehrlich gesagt, das Ergebnis ist überhaupt nicht schlecht.“
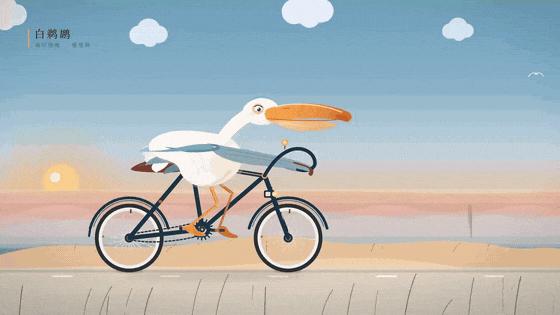
Dann kommt das klassische Beispiel: Ein Pelikan fährt Fahrrad.
Jemand hat die Konfiguration auf Maximum eingestellt, den xhigh- und fast-Modus aktiviert und 18 Minuten lang laufen lassen, was 3,16 US-Dollar gekostet hat.
Das Ergebnis sah tatsächlich gut aus: Ein weißer Pelikan fährt am Meer Fahrrad, seine Flügel liegen auf dem Lenker.
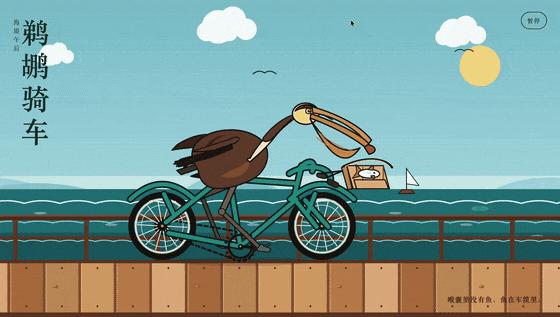
Ein anderer Nutzer erzielte ein viel schlechteres Ergebnis: Der generierte braune Vogel lag schlaff auf dem Fahrrad.
Der Produktblogger Paweł Huryn hat zwei echte Codebasen verwendet, 105 Fehler eingebaut und drei Testrunden durchgeführt.
Das Ergebnis: GPT-6 Astra kann 45 Fehler reparieren; Grok 4.7 schafft 28,7. Dramatischerweise erreicht die Vorgängerversion Grok 4.6 ebenfalls 28,7 Fehler repariert.
