Gerade hat Xiaomi die Spitzenleistungsschwelle großer KI-Großmodelle durchbrochen, Luo Fuli: Der technische Schwierigkeitsgrad übertrifft den von DeepSeek R1.
Gerade eben hat Xiaomi die Modellreihe MiMo-V2.6 offiziell veröffentlicht und quelloffen gemacht.
Diese Veröffentlichung umfasst zwei native multimodale Modelle. MiMo-V2.6-Pro ist auf komplexe Programmierung, Agenten und professionelle Aufgaben ausgerichtet, während MiMo-V2.6-Flash das Gleichgewicht zwischen Leistung, Effizienz und Kosten stärker betont.
Xiaomi hat gleichzeitig MiMo-V2.6-Pro-UltraSpeed auf den Markt gebracht. Laut offiziellen Angaben kann die Ausgabegeschwindigkeit unter Beibehaltung der Modellqualität das 20-fache der Pro-Version erreichen.
Neben der Versionsaktualisierung hat APPSO zuvor berichtet, dass Xiaomi ein fast sechs Tage dauerndes Reinforcement-Learning-Training mit Gesamtkosten von etwa 3,47 Millionen US-Dollar online öffentlich zugänglich gemacht hat.
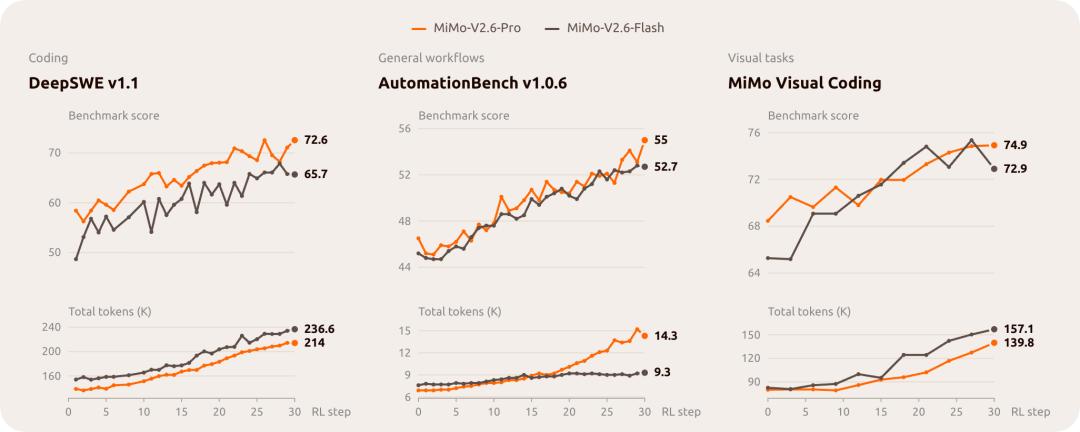
Vom Trainingsfortschritt über die Kostenentwicklung bis zur Aufgabenbestehungsrate kann die Außenwelt fast in Echtzeit beobachten, wie die beiden Modelle ihre Fähigkeiten in 30 RL-Schritten schrittweise verbessern. Xiaomi betrachtet dies als einen wichtigen Versuch, die Linie des RSI, also des rekursiven Selbstverbesserungspfades, zu erforschen.
MiMo V2.6 tritt auf den Plan: Chinesische quelloffene Modelle erhalten einen neuen Maßstab
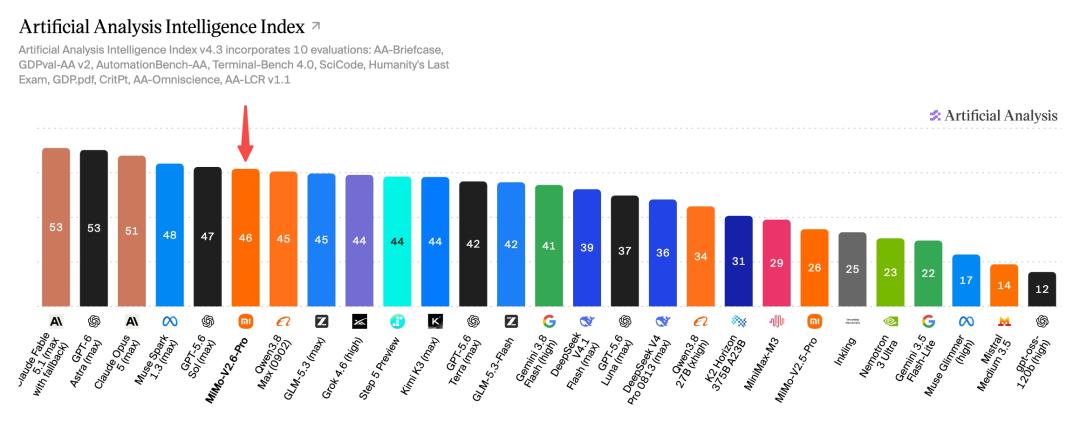
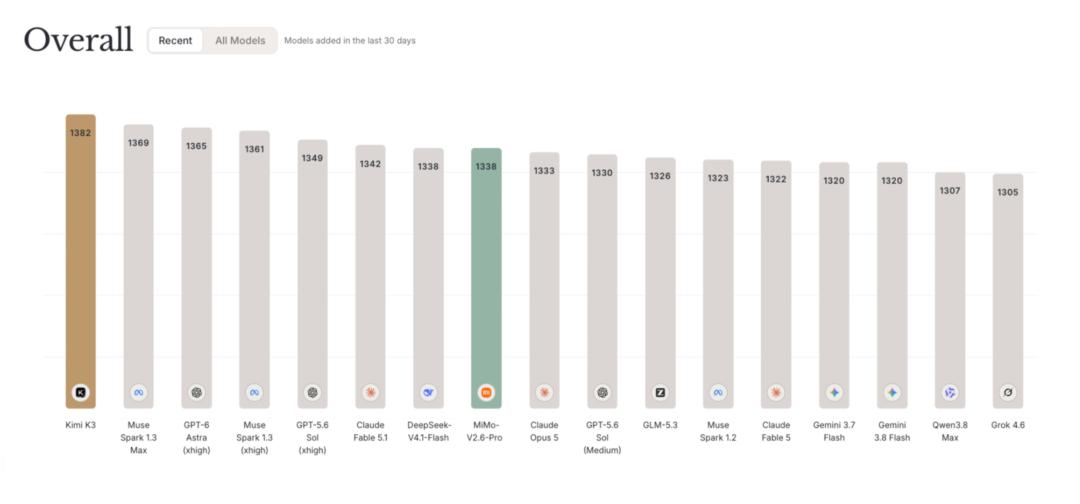
Laut den offiziell veröffentlichten Ergebnissen erzielt MiMo-V2.6-Pro im Artificial Analysis Intelligence Index v4.3 46,32 Punkte und übertrifft damit Kimi K3 und Qwen3.8 Max.
Auf dieser Grundlage bezeichnet Xiaomi es als das quelloffene Modell mit der höchsten Punktzahl auf dieser Liste derzeit und gibt an, dass V2.6 die API-Preise von V2.5 beibehält, um ein höheres Intelligenzniveau zu gleichen Kosten bereitzustellen.
Im Hinblick auf die einzelnen Testergebnisse der Benchmarks erreicht Pro 71,9 Punkte im DeepSWE v1.1, nahe an den 74,2 Punkten von DeepSeek V4.1 Flash und den 74,0 Punkten von Claude Opus 5 und GPT 6 Astra; im Toolathlon-verified erzielt es 76,9 Punkte und liegt damit über den 74,9 Punkten von GPT 5.6 Sol;
Im Automation Bench v1.0.6 erreicht es 53,1 Punkte, etwas unter den 54,8 Punkten von DeepSeek V4.1 Flash und über den 52,0 Punkten von GPT 6 Astra; die Punktzahl im JobBench für echte berufliche Aufgaben beträgt 62,0 und liegt nur hinter den 65,7 Punkten von Claude Opus 5.
Die Generierung von Webseiten und visuellen Schnittstellen ist ebenfalls ein Schwerpunkt dieser Aktualisierung.
In dem von Xiaomi selbst erstellten MiMo Visual Coding-Bewertung erzielen Pro und Flash 72,3 bzw. 71,5 Punkte, liegen damit über DeepSeek V4.1 Flash und Claude Opus 5, weisen aber noch eine Lücke zu den 82,2 Punkten von GPT 6 Astra auf.
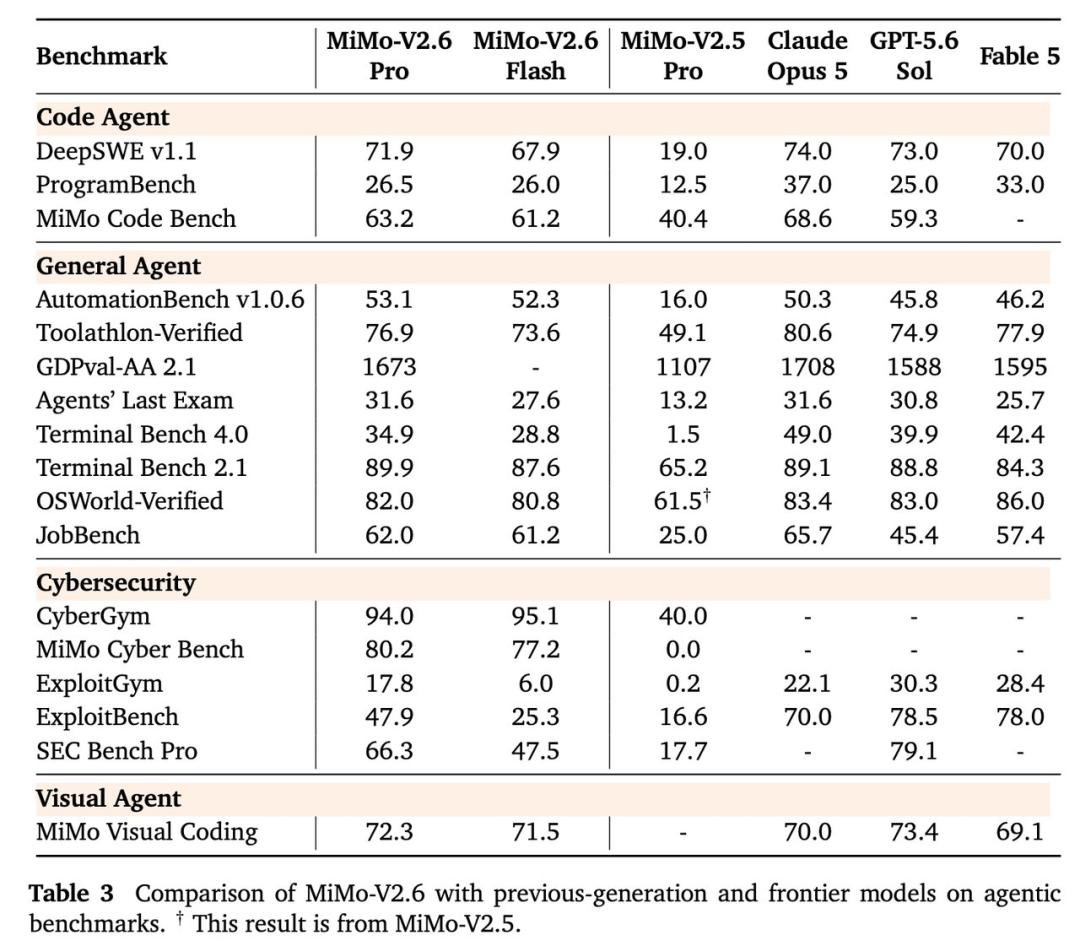
Insgesamt hat MiMo-V2.6 natürlich noch nicht in allen Fähigkeiten die Spitzenwerte geschlossener Modelle erreicht.
Pro erzielt 34,9 Punkte im Terminal Bench 4.0, es besteht noch eine deutliche Lücke zu den 59,6 Punkten von GPT 6 Astra und den 55,1 Punkten von Claude Fable 5.1, und in mehreren Cybersicherheitsbewertungen liegt es insgesamt hinter den führenden geschlossenen Modellen zurück.
Für quelloffene Modelle ist jedoch das Gesamtergebnis von 46,32 Punkten in Kombination mit dem günstigen und vorteilhaften API-Preis möglicherweise von größerer praktischer Bedeutung als die Platzierung in einzelnen Listen.
Sechs Tage lang 3,47 Millionen US-Dollar ausgegeben: Xiaomi setzt groß auf RL
Der Trainingsprozess hinter MiMo-V2.6 kann besser veranschaulichen, was Xiaomi erreichen will, als die endgültigen Punktzahlen.
APPSO hat umgehend den technischen Bericht von MiMo-V2.6 eingesehen: MiMo-V2.6-Flash und Pro haben jeweils 30 Reinforcement-Learning-Schritte abgeschlossen, erzeugen jeweils etwa 750.000 Trainingsspuren mit Kosten von etwa 850.000 bzw. 2,62 Millionen US-Dollar.
Die durchschnittliche Aufgabenbestehungsrate der beiden Modelle verbessert sich relativ um etwa 25 % bzw. 12 %. Bei dem langen Software-Engineering-Benchmark DeepSWE v1.1, der nicht am Training teilgenommen hat, steigt die Punktzahl von Flash von 48,8 auf 65,68 und die von Pro von 58,4 auf 72,57 Punkte.
Mehrere Projekte behalten im zweiten Teil des Trainings weiterhin ein Wachstum bei. Daraus schließt Xiaomi, dass groß angelegtes RL noch eine hohe Stichprobeneffizienz aufweist und die Vorteile sich über die Trainingsverteilung hinaus erstrecken können, sodass das Modell eine gewisse allgemeine Fähigkeit zur langfristigen Ausführung erlernt hat.
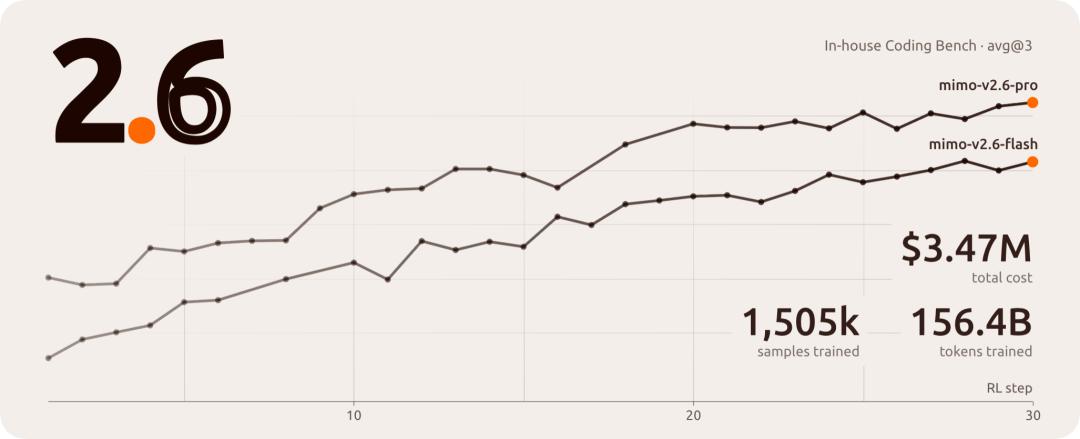
Der Trainingsumfang übersteigt bei weitem die üblichen Nachtrainingsexperimente.
Jeder Schritt enthält 1568 Eingabeaufforderungen (Prompts), jede Prompt generiert gleichzeitig 16 Kandidatenspuren, was der gleichzeitigen Verarbeitung von etwa 25.000 langen Sequenzen und 2,7 bis 3,7 Milliarden Trainings-Token entspricht, wobei der längste Kontext 1 Million Token erreicht.
Die Aufgaben umfassen Programmierung, allgemeine Agenten, Sehen und Cybersicherheit und mischen mehrere Ausführungsumgebungen; das Bewertungssystem vergleicht mehrere Spuren für dieselbe Aufgabe, liefert feinere Belohnungssignale für langkettige Aufgaben und leitet das Modell an, unnötige Schritte und Token-Verbrauch zu reduzieren.
Groß angelegtes RL ist auch anfällig für Trainingsdrift und Belohnungsspekulation.
Das Modell kann nach Lücken in den Bewertungsregeln suchen, oberflächlich hohe Punktzahlen erzielen, aber die Aufgabe tatsächlich nicht erfüllen. Während des Trainings fixiert Xiaomi den MoE-Router und verbessert die Stabilität durch Belohnungsdesign, kontradiktorische Bewertungen, Anomalieerkennung und Kreuzprüfung mehrerer Prüfer. Gleichzeitig wird das Format der Spuren vereinheitlicht, das von verschiedenen Agenten-Frameworks erzeugt wird, sodass mehrere Arten von Aufgaben in dasselbe Trainingssystem gelangen.
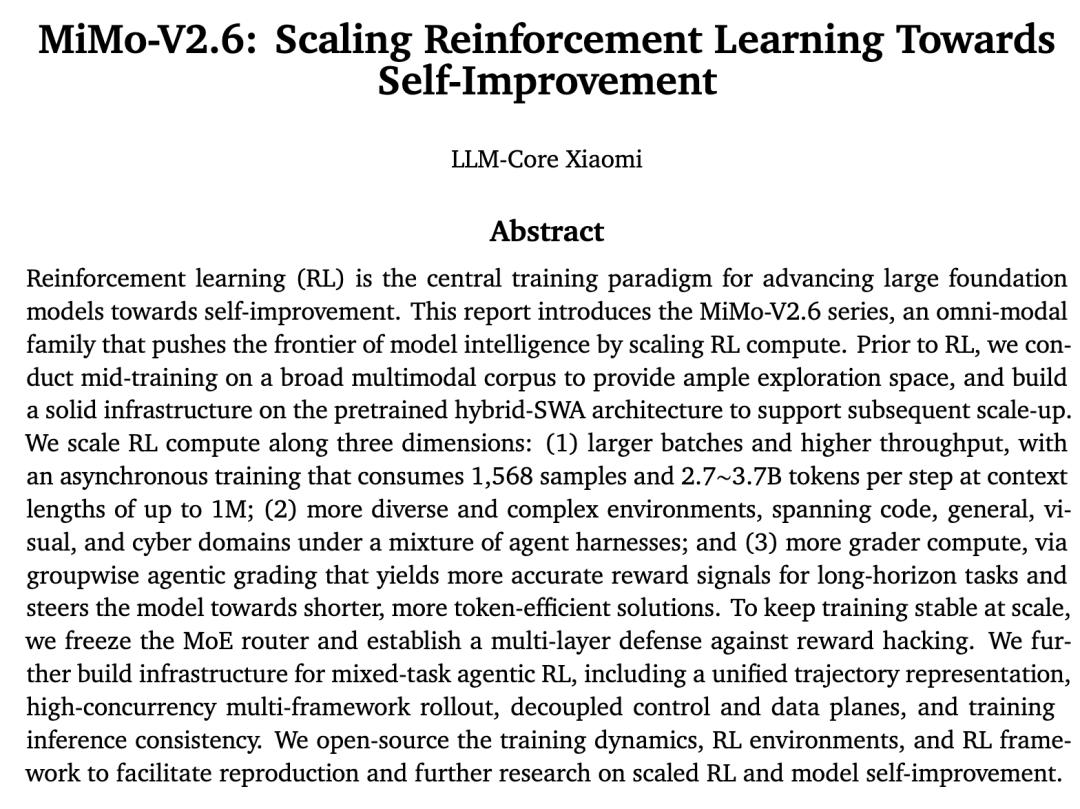
Technischer Bericht 🔗https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/blob/main/MiMo_V2_6_technical_report.pdf
Luo Fuli hat MiMo-V2.6 nach der Veröffentlichung als „den schwierigen Weg der Erweiterung von RL“ bezeichnet.
Sie erklärt, gemessen am Rechenleistungseinsatz sei es höchstwahrscheinlich eines der größten einzelnen Reinforcement-Learning-Trainings, die ein Team für quelloffene Modelle bisher durchgeführt hat. Trotz des Mangels an Rechenleistung lässt Xiaomi ein Team von mehreren Dutzend Personen langfristig auf dasselbe Ziel hinarbeiten: Zuerst wird das Modellpotenzial durch mittelfristiges Training angesammelt, dann wird es durch groß angelegtes RL freigesetzt.
Aus Sicht von Luo Fuli übersteigen die Forschungsinnovationen und technischen Schwierigkeiten hinter MiMo-V2.6 sogar die von DeepSeek R1, an dem sie teilweise beteiligt war. Sie erläutert auch die Aufgabenteilung zwischen MixRL und MOPD.
Agentenaufgaben mit mittlerem Schwierigkeitsgrad wie Code, die zuverlässig überprüft werden können, gelangen in MixRL, um Fähigkeiten zu erwerben, die auf verschiedene Aufgaben übertragbar sind; Aufgaben wie Spiele, 3D, ultra-lange Ketten und Aufgaben mit subjektiven Bewertungsstandards werden getrennt trainiert und dann über MOPD wieder in das Hauptmodell zusammengeführt, um zu verhindern, dass der Rollout verlangsamt wird oder Daten veralten.
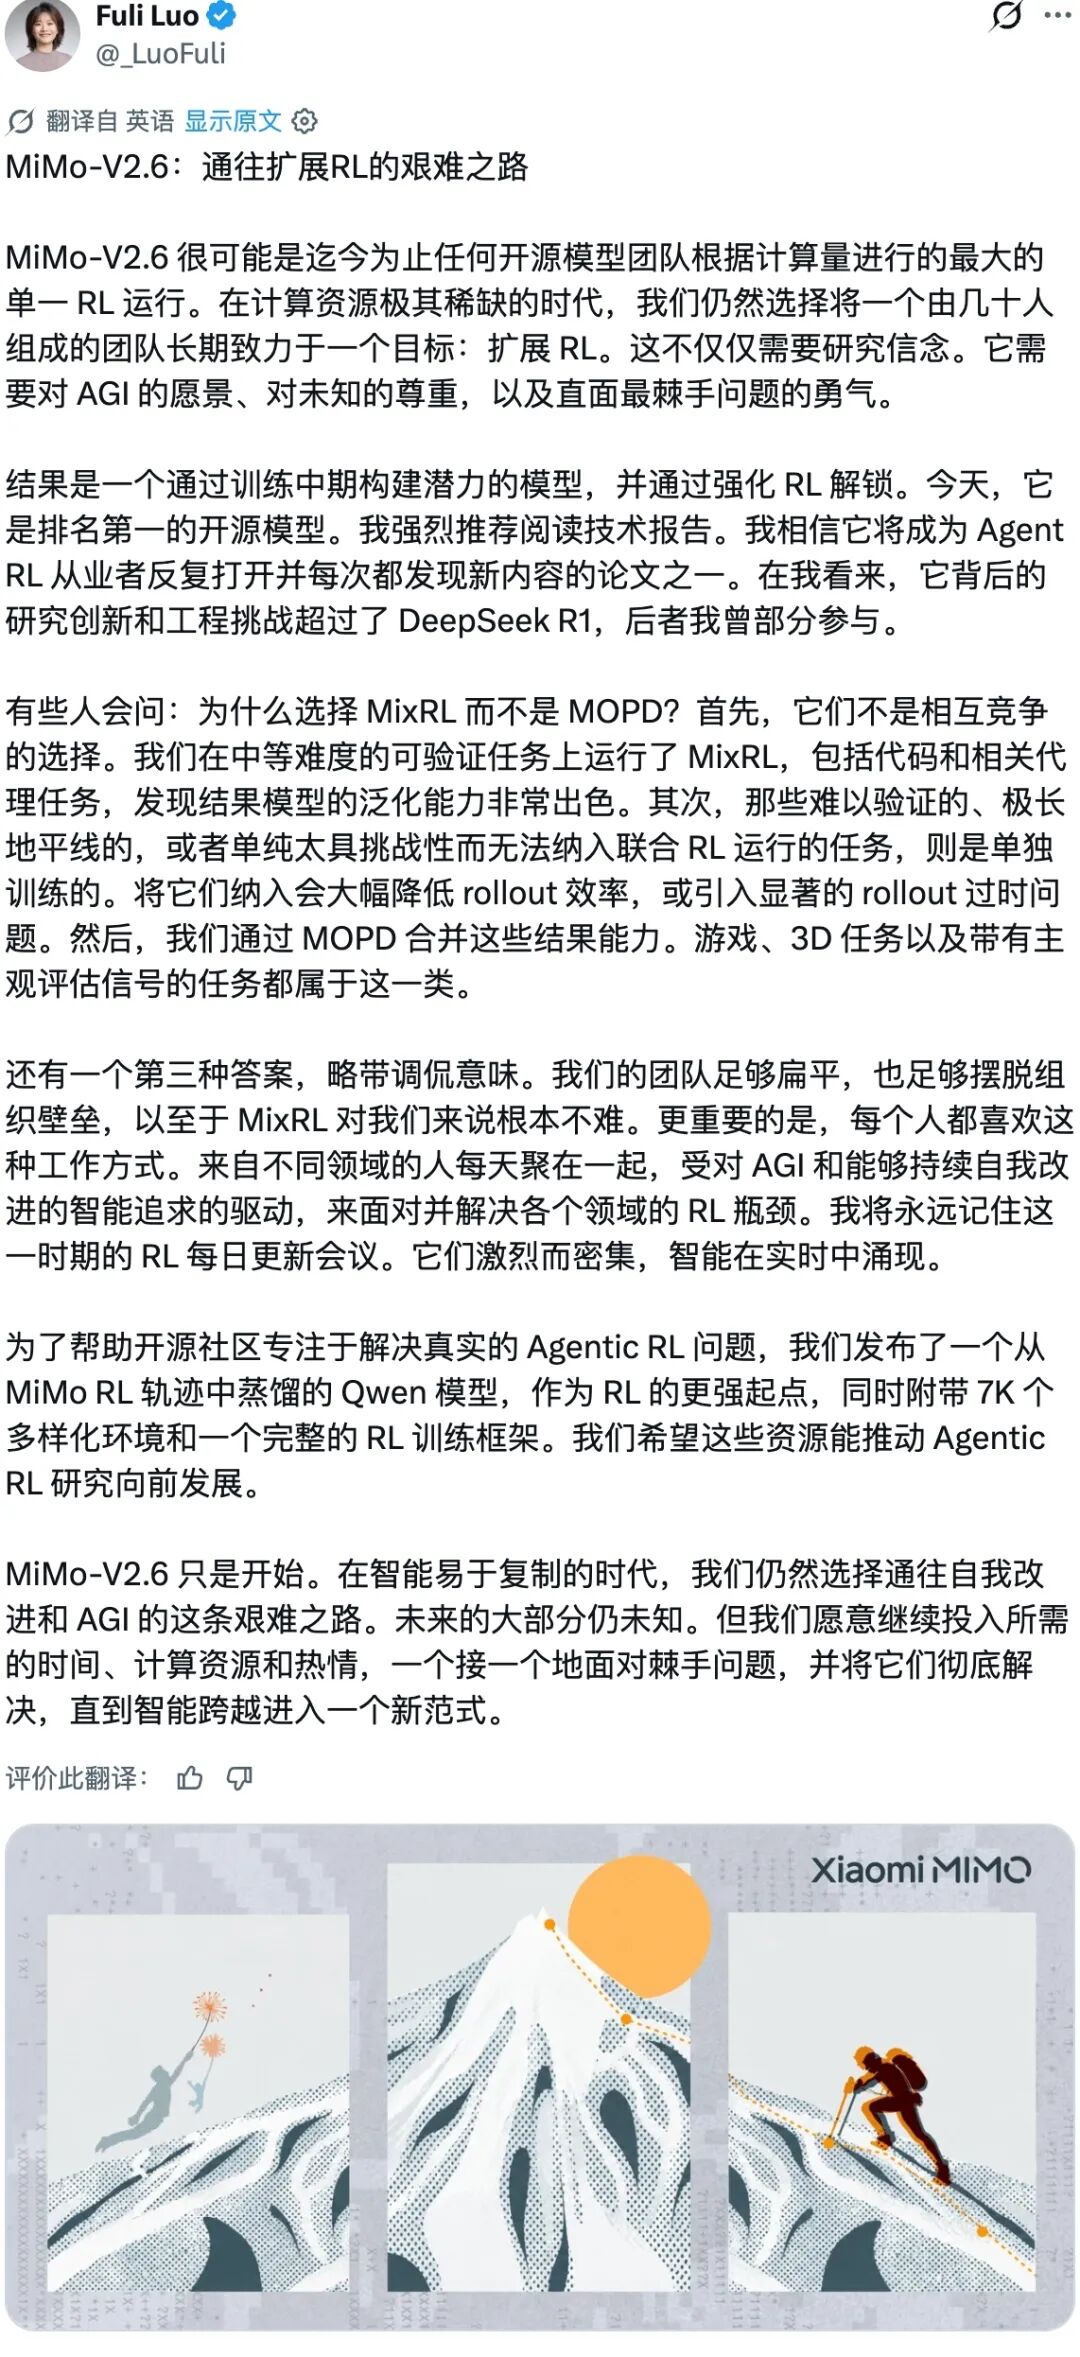
Luo Fuli ist der Ansicht, dass die flache Teamstruktur auch die Organisationskosten von MixRL senkt, sodass Mitglieder aus verschiedenen Bereichen gemeinsam um dasselbe Modell herum RL-Hindernisse lösen können.
Was Xiaomi diesmal offenlegt, sind nicht nur die Modellgewichte.
Die Trainingskurven, Belohnungsmechanismen, Aufgabenverhältnisse, Schlüsselparameter und Kostenstrukturen von MiMo-V2.6 sind alle in den technischen Bericht aufgenommen. Die Außenwelt kann damit beobachten, wie sich die beiden Modelle in 30 RL-Schritten verändern, und versuchen, diese groß angelegte Methode des agentischen RL zu reproduzieren.
Um auch Forschern mit begrenzter Rechenleistung und Budget die Teilnahme zu ermöglichen, hat Xiaomi MiMo-V2.6-Distill-Qwen-9B veröffentlicht, das aus Qwen3.5-9B destilliert wurde, sowie etwa 7000 RL-Aufgabenumgebungen, die Code, Cybersicherheit, Wissensarbeit und visuelle Entwicklung abdecken. Die dazugehörigen Prüfer, das End-to-End-RL-Trainingsframework und das Mini-Harness werden ebenfalls offen zugänglich gemacht.
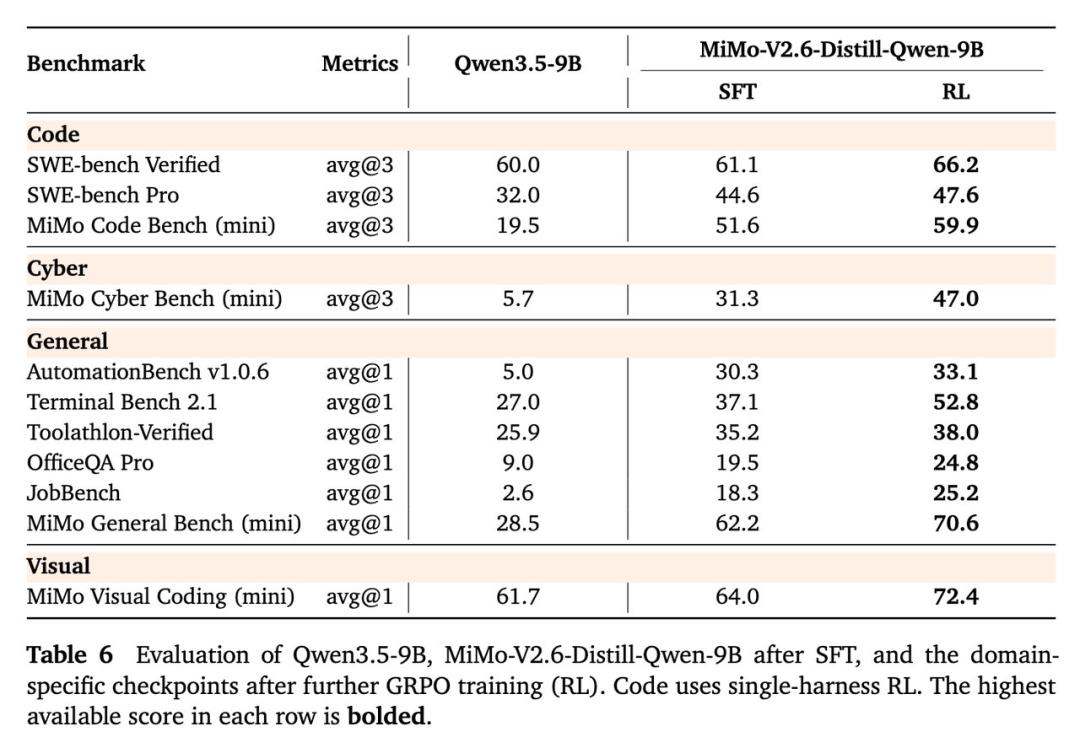
Was Xiaomi der quelloffenen Gemeinschaft beisteuert, ist daher nicht nur ein trainiertes Modell, sondern auch der Prozess und die Werkzeuge, mit denen das Modell diese Fähigkeiten erworben hat. Eine solche Großzügigkeit ist wirklich beeindruckend.
Das Ende von Vibe Coding ist Vibe World
Xiaomi hat MiMo-V2.6 von der natürlichen Sprachprogrammierung auf eine interaktive digitale Welt ausgeweitet und diese als Vibe World bezeichnet.
Das Modell kann Aufgaben anhand von Text, Bildern oder Videos aufteilen, mehrere Agenten koordinieren, um 3D-Szenen aufzubauen, Interaktionslogik zu schreiben, und dann die Ergebnisse durch Rendering wiederholt zu modifizieren.
In Spiel- und 3D-Aufgaben kann MiMo-V2.6 interaktive Szenen generieren und Blender bedienen, um Assets zu erstellen, die für Animationen, 3D-Druck und Spieleentwicklung verwendet werden können;
In der embodied Simulation kann es Bilder aus mehreren Perspektiven lesen und den Roboterarm Franka Panda steuern, um Greifaufgaben, Farbabgleich und präzises Platzieren abzuschließen.
Im Bereich Design und Inhaltsproduktion kann das Modell aus einer einfachen Anforderung Webseiten oder Folien generieren, Figma, Bild- und Videogenerierungstools aufrufen, um Materialien zu ergänzen, und dann die Gestaltung von Aufnahmen, Animationen, Musikuntermalung und Erzähltexten abschließen;
In Musikbeispielen komponiert es Orchestermusik für etwa zehn Instrumente, generiert Noten und wandelt sie in MIDI um.
