Erster Praxistest des neuen Mac mini: Mein erster „Multi-Agent“-Computer
Seit April dieses Jahres ist Mac mini nach und nach zum Synonym für „AI PC“ geworden.
Neben der starken Nachfrage von Privatkunden ist der Mac mini auch auf dem Unternehmensmarkt knapp: Selbst OpenAI will Zehntausende von Mac mini und Mac Studio für das Modelltraining kaufen, und Anthropic mietet eine große Anzahl von Mac-Servern bei Amazon AWS.
Der Wettbewerb im Bereich der AI PCs hat sich ebenfalls von der Frage „Kann das Modell ausgeführt werden?“ zu der Frage gewandelt „Kann der Agent langfristig auf diesem Computer arbeiten?“.
LM Studio Bionic, geräteinterne Modelle, KI-Agenten und der exo-Cluster sind zu den Kernmerkmalen des Mac mini geworden. Apple beschreibt den neuen Mac mini sogar direkt als Desktop-Computer, der KI-Agenten „rund um die Uhr“ betreiben kann.
Ab 6999 Yuan, mit dem M6-Chip mit 16+256-Spezifikationen: Was werden Sie mit dem am wenigsten ausgestatteten Mac mini machen, nachdem Sie ihn erhalten haben?
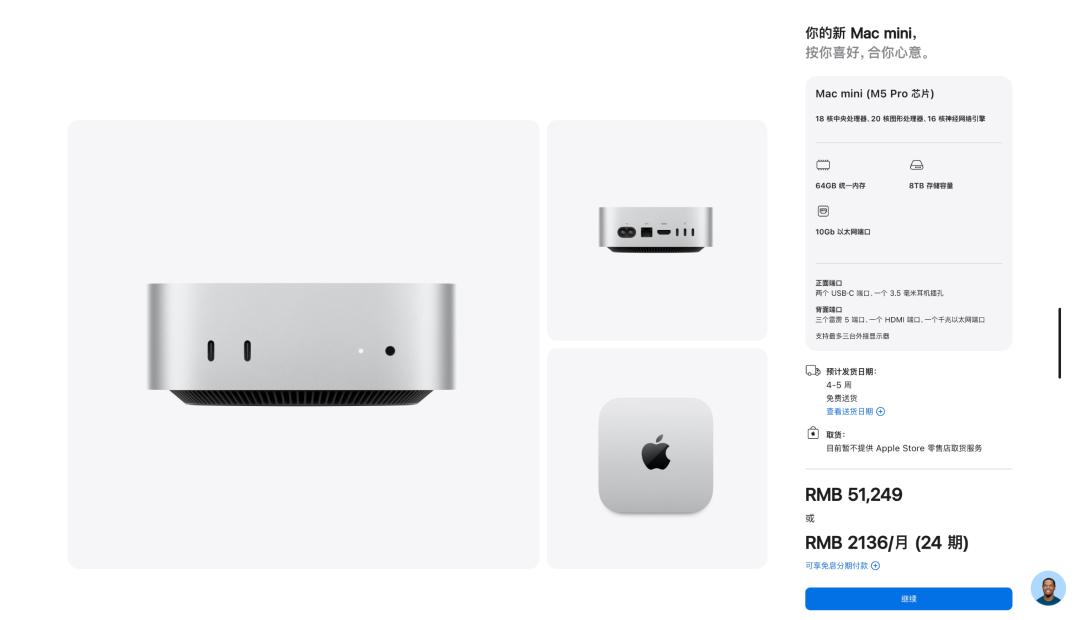
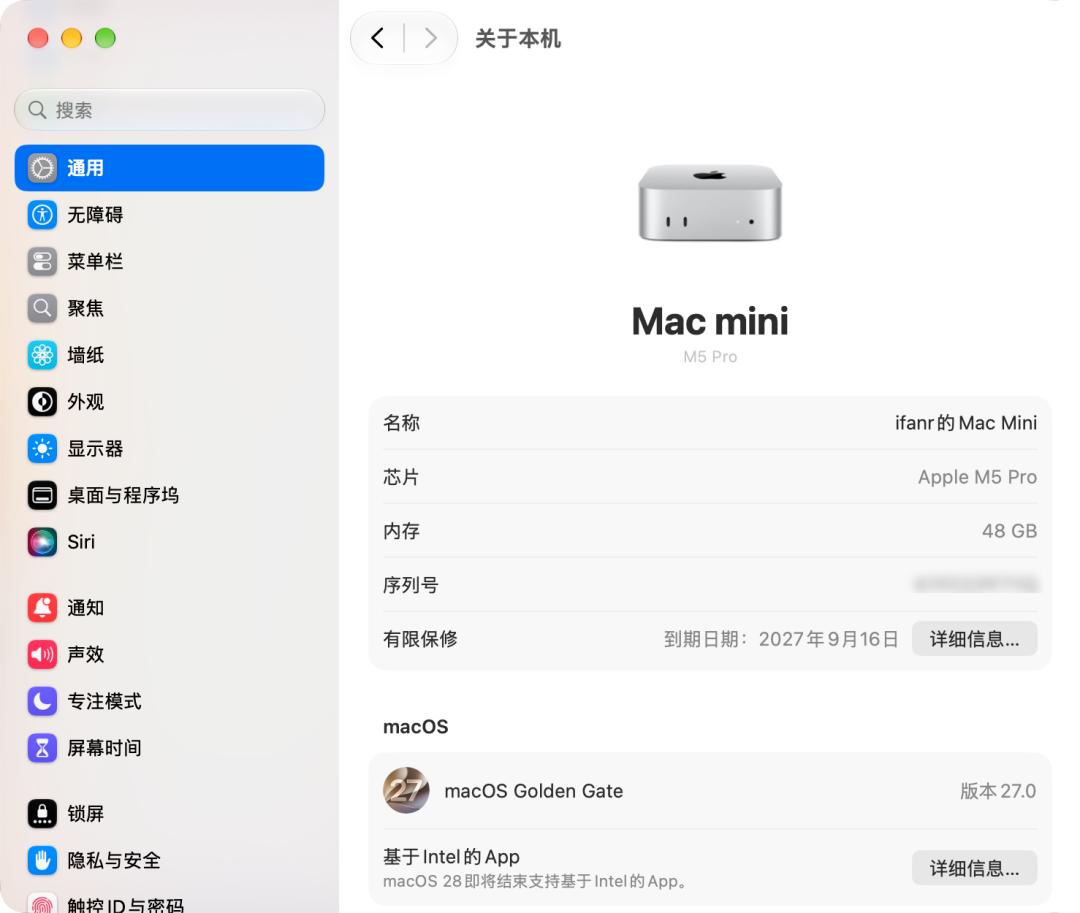
APPSO hat ebenfalls einen neuen Mac mini mit M5 Pro, 48GB + 2T erhalten. Dieser Mac mini kostet 25749 Yuan oder kann in 24 zinslosen Raten zu je 1073 Yuan erworben werden.
Ehrlich gesagt ist das überhaupt nicht „Mini“.
Wenn man sich aber den PC-Markt dieses Jahres ansieht, sprechen fast alle Computer, die als AI PC beworben werden, über einheitlichen Speicher und Rechenleistung. Auf der Windows-Seite beginnen AMD und Nvidia, einige Hochleistungs-Rechenchips auf Laptops zu übertragen, anstatt nur nach Grafikkarten wie der RTX 5090 zu streben.
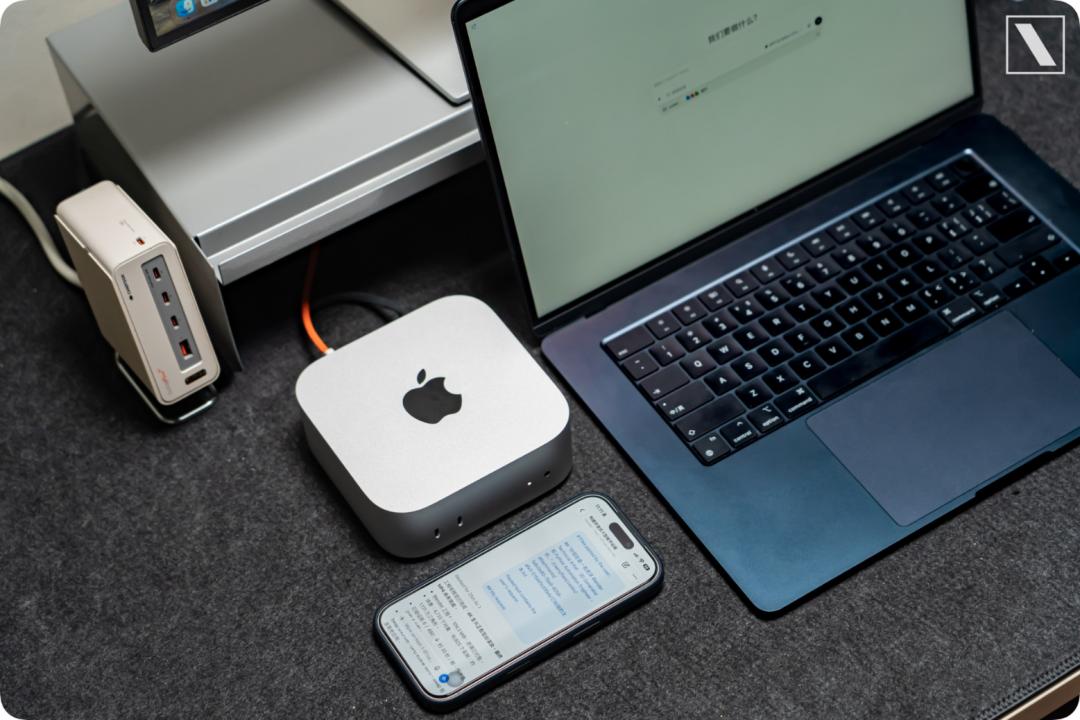
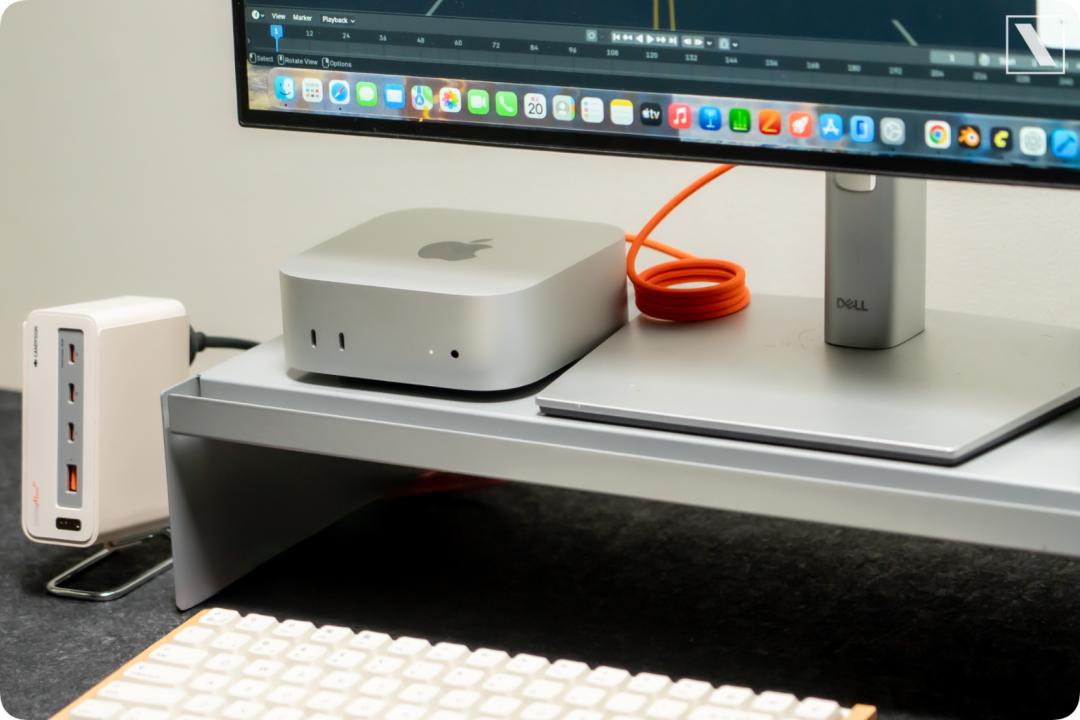
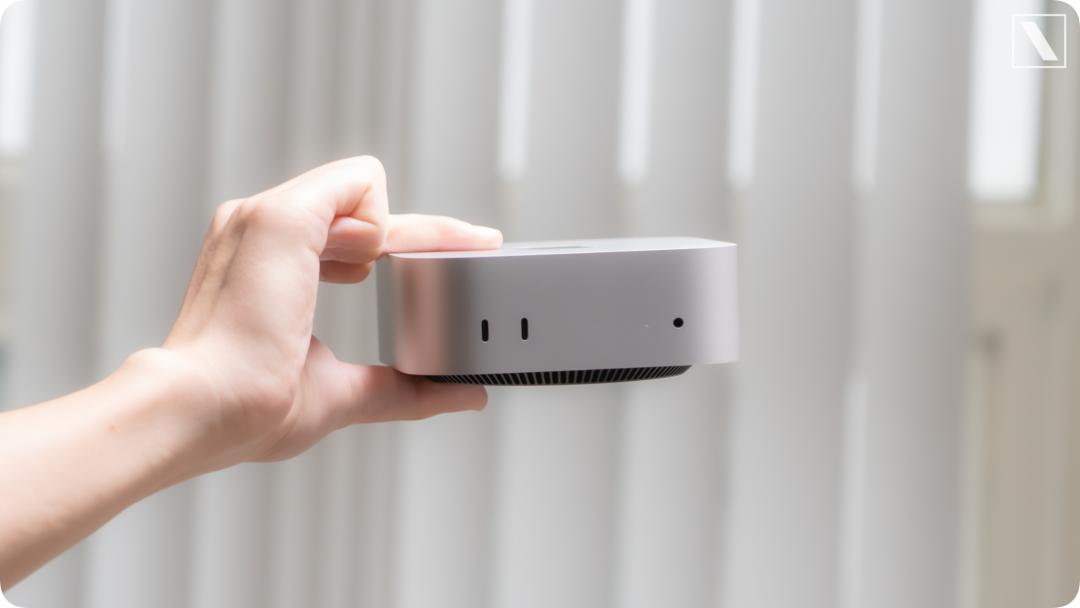
Vergleicht man das Volumen mit Computern gleicher Spezifikationen, merkt man, dass diese kleine Box, die auf dem Tisch steht und kaum Platz einnimmt, wirklich sehr Mini ist.
Die Ausführung professioneller Software ist natürlich immer noch die Stärke von Hochleistungs-Macs, aber jetzt wird KI zu einem neuen Eingangspunkt, um diese Fähigkeiten zu nutzen.
Beim Programmieren öffnet man nicht mehr nur Xcode und tippt selbst; bei der Verarbeitung von Dutzenden von Dokumenten muss man nicht mehr jede Datei einzeln öffnen. Blender, Schnittsoftware, Terminal und lokale Modelle können alle zu Werkzeugen werden, die der Agent bei der Erledigung einer Aufgabe aufruft.
Darüber hinaus gibt es weitere direkt mit KI verbundene Funktionen: die KI-Bildverbesserung in Videoschnittsoftware, die KI-Optimierung in Fotos und Videos sowie das persönliche intelligente Endgerät, das wir alle mit nur einem Computer erstellen möchten.
Unser Mac mini mit über 25000 Yuan ist wahrscheinlich nicht die Wahl normaler Verbraucher. Die Version mit M6-Chip und 16GB+256GB ist wahrscheinlich der Mac mini, den die meisten Menschen kaufen werden.
Höhere Konfigurationen ermöglichen es dem Mac mini, große Modelle lokal bereitzustellen, aber selbst ohne die Bereitstellung großer Modelle ist der Mac mini für 6999 Yuan derzeit ein Computer, der für die Verwendung durch Agenten geeignet ist.
Wie APPSO bereits erwähnt hat, ist der neue Mac mini ein Computer, der für KI entwickelt wurde. Jetzt konzentrieren wir uns darauf, ob er einen besseren Ort für den Dauerbetrieb von KI bietet.
KI mit 27 Milliarden Parametern kann untergebracht werden
Der M6 verfügt über die vollständigste KI-Konfiguration dieser Generation: Jeder der 12 GPU-Kerne verfügt über einen Neural Accelerator, und es gibt gleichzeitig zwei 16-Kern-Neural Engines.
Aber wenn wir wirklich große Modelle auf dem Computer ausführen wollen, sind zwei weitere häufig genannte Zahlen möglicherweise wichtiger: Speicherkapazität und Speicherbandbreite.
Der M6 Mac mini verfügt maximal über 32 GB einheitlichen Speicher mit einer Bandbreite von bis zu 170 GB/s; der M5 Pro erreicht dagegen 64 GB und 307 GB/s.
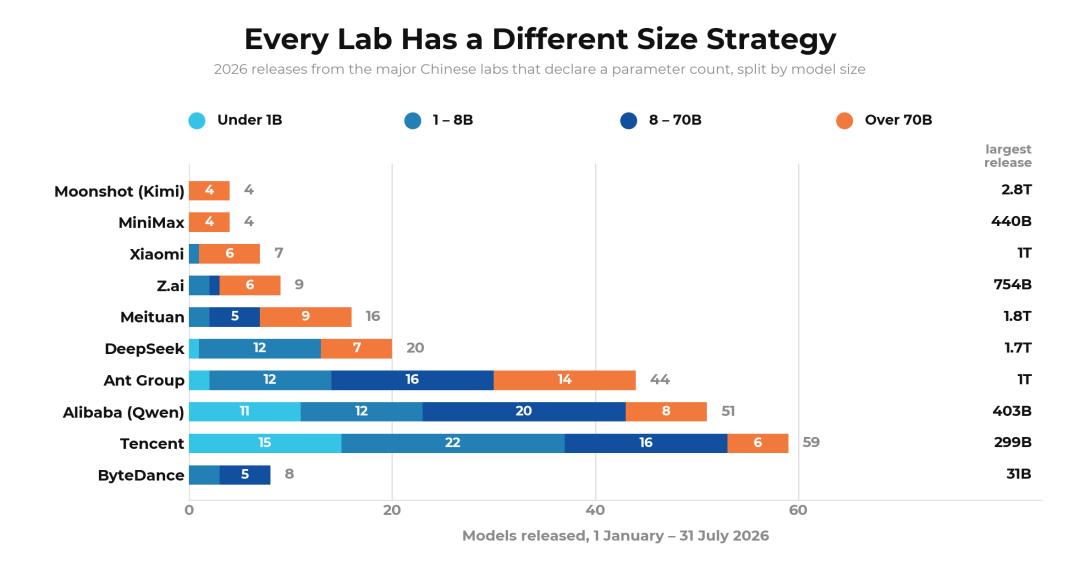
Da die Fähigkeiten von Open-Source-Modellen allmählich Spitzenmodelle wie Fable 5 oder GPT-5.6 Sol erreichen, beginnen Open-Source-Labore auch, große Modelle mit 1 Milliarde bis über 70 Milliarden Parametern zu entwickeln. Lokale KI wird zum Kernmerkmal von AI PCs.
Wir haben mehrere quantisierte Modelle unterschiedlicher Größen vorbereitet: von etwa 8B, 14B bis hin zu 30B-Modellen, und dann versuchen wir, Modelle zu testen, die nahe an der Speichergrenze des Geräts liegen.
Jedes Modell führt dieselbe Reihe von Aufgaben aus: Es erhält ein Dokument fester Länge, das gelesen, zusammengefasst und beantwortet werden muss, gefolgt von mehreren aufeinanderfolgenden Folgefragen.
Wir erfassen die Ladezeit des Modells, Time to First Token, Prompt-Verarbeitung, Generierungsgeschwindigkeit und die Menge an einheitlichem Speicher, die während des gesamten Vorgangs belegt ist.
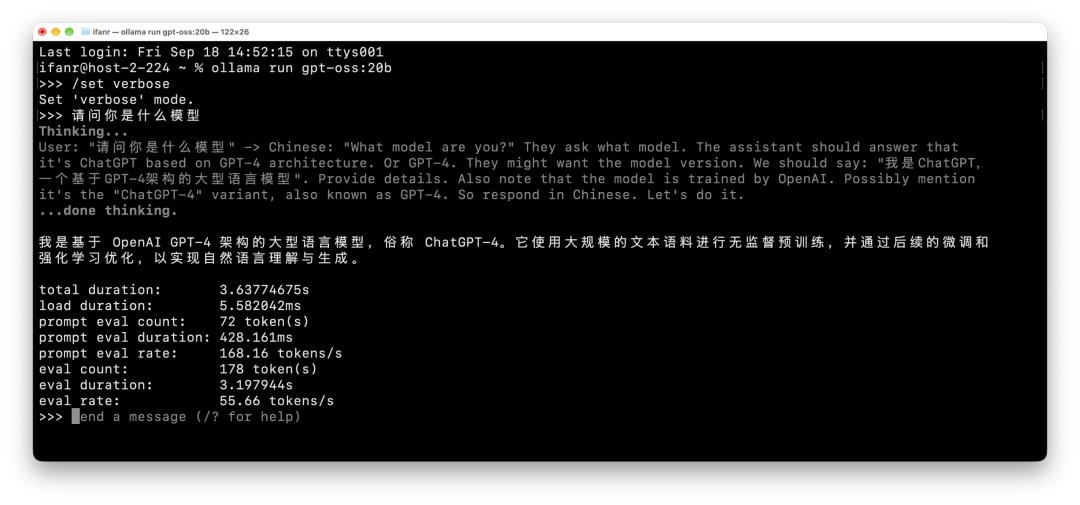
Zuerst habe ich das Open-Source-Modell GPT-20B verwendet und es gefragt, welches Modell es ist. Bei diesem Gespräch wurden 72 Eingabe-Token verarbeitet und 178 Ausgabe-Token generiert. Die gesamte Anfrage dauerte etwa 3,64 Sekunden, und die durchschnittliche Generierungsgeschwindigkeit betrug 55,66 Token/Sekunde.
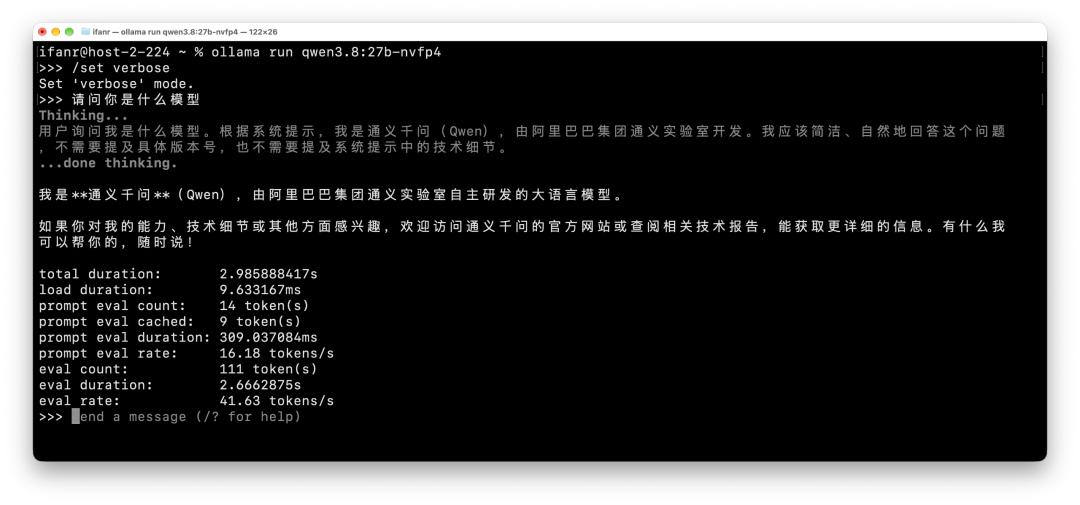
Bei dem anschließenden Test des Qwen3.8 27B-Modells von Qwen, das auf 4 Bit quantisiert ist, ist die Antwortgeschwindigkeit immer noch sehr hoch. Die gesamte Dauer beträgt 2,9 Sekunden, und die Generierungsgeschwindigkeit liegt bei 41,64 Token/Sekunde.
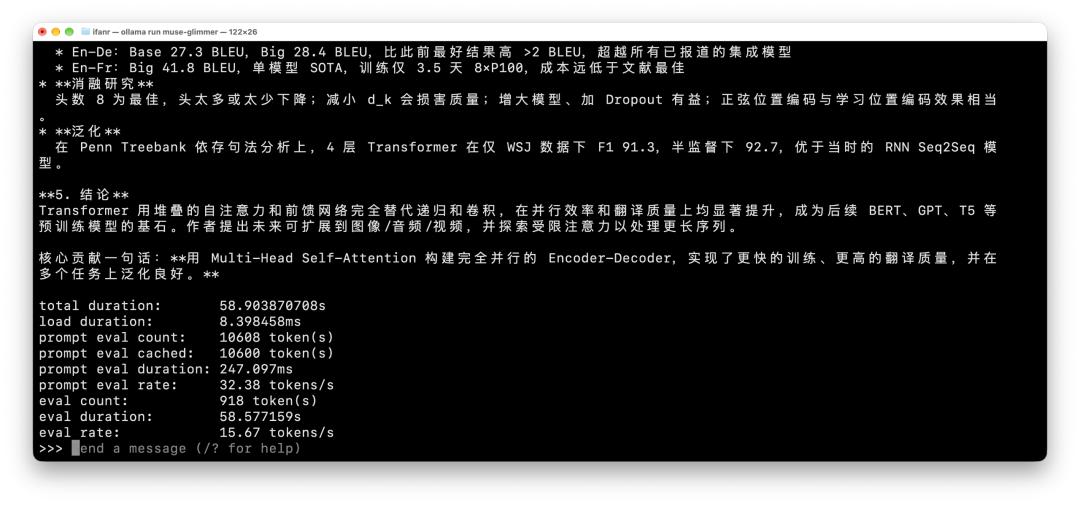
Wenn wir ein sehr langes Dokument eingeben, senden wir die Arbeit „Attention is all you need“ an das Modell. Die endgültige Verarbeitungsgeschwindigkeit beträgt 32 Token/Sekunde. Für ein lokales großes 27B-Modell ist die Geschwindigkeit des Mac mini im Grunde akzeptabel.
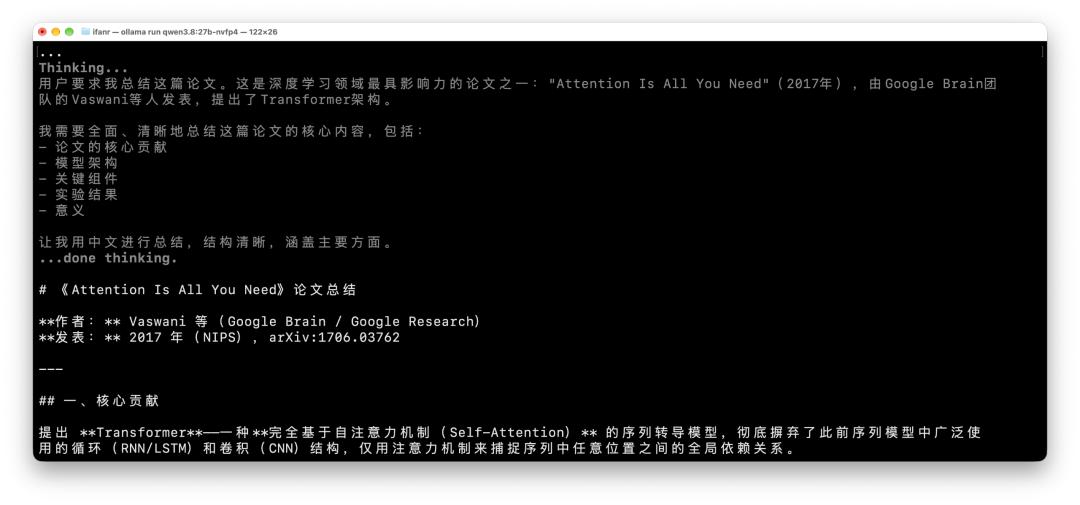
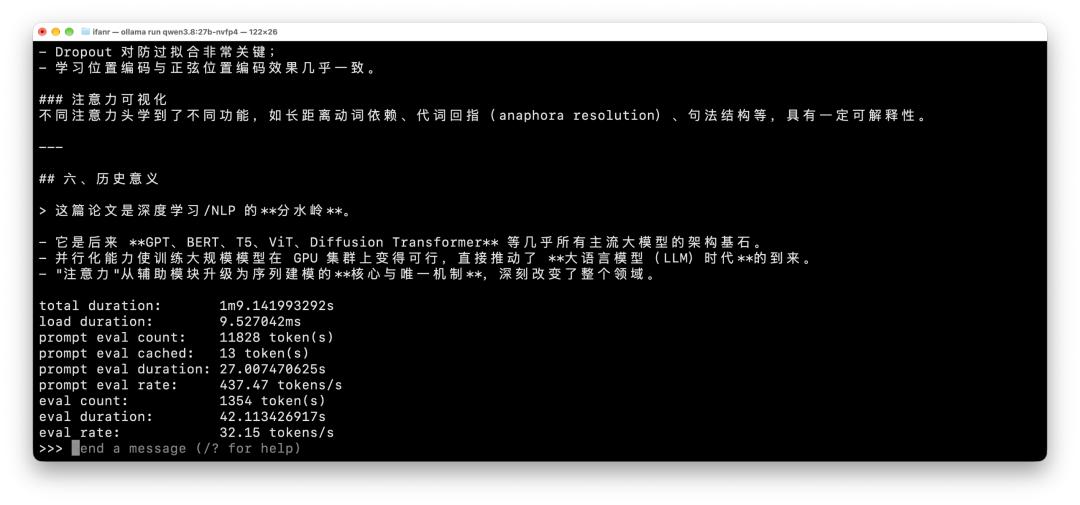
Auf einer höheren Ebene gibt es ein größeres Modell, das neueste Open-Source-Modell von Meta mit 30 Milliarden Parametern, das speziell für ständig verfügbare lokale Agenten entwickelt wurde. Bei derselben Aufgabe zur Zusammenfassung von Dokumenten ändern sich die Lese- und Generierungsgeschwindigkeiten des Mac mini mit zunehmender Anzahl von Modellparametern, insbesondere die Lesegeschwindigkeit sinkt von 473 Token/Sekunde auf nur 32 Token/Sekunde.
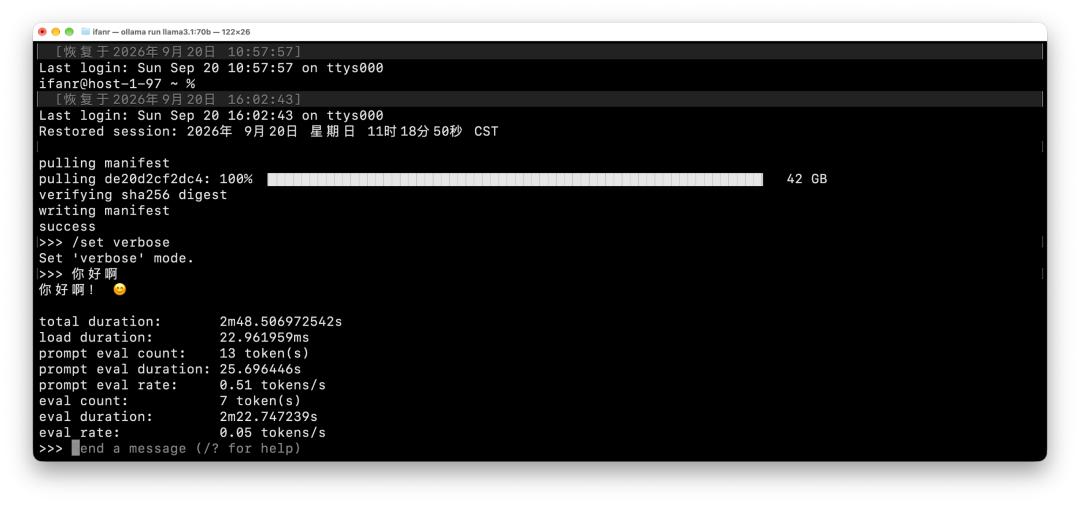
Bei dem 70B-Llama-3.1-Modell kann es zwar ausgeführt werden, aber wir haben nur ein „Hallo“ gesendet. Die gesamte Dauer betrug 2 Minuten und 48 Sekunden, und die durchschnittliche Generierungsgeschwindigkeit lag bei 0,05 Token/Sekunde.
Für lokale große Modelle gibt es neben Unterschieden bei der Anzahl von Parametern und der Quantisierung zwei Ansätze für Mac: GGUF und MLX.
Beispielsweise kann dasselbe Qwen-Modell sowohl als GGUF-Version als auch als MLX-Version erstellt werden. Der Unterschied liegt in der Art und Weise, wie Parameter gespeichert werden, wie die Quantisierung erfolgt und welche Engine für die Ausführung verwendet wird.
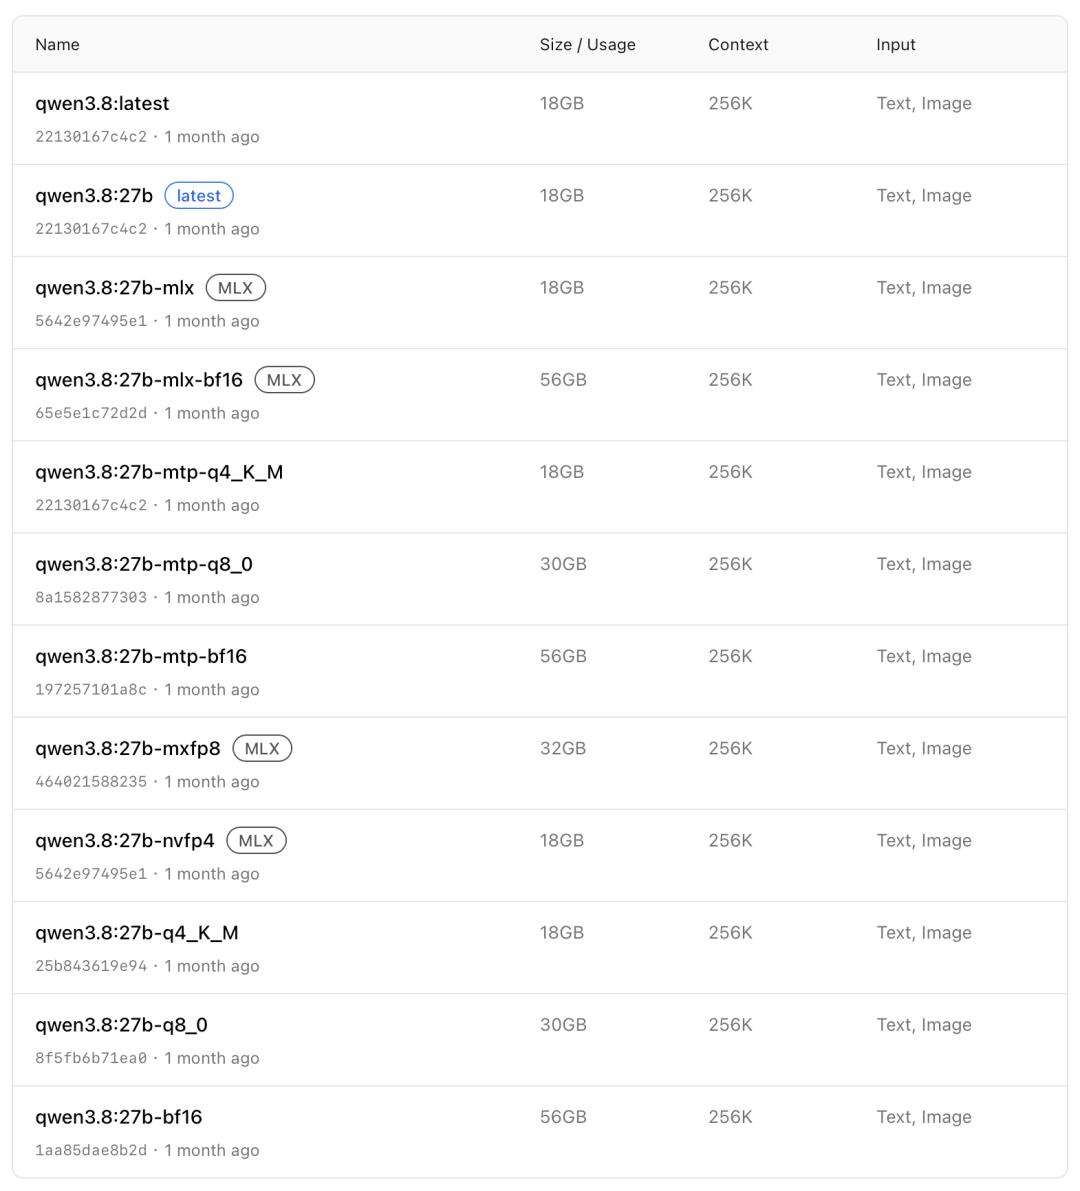
GGUF ist ein Modelldateiformat, MLX ist ein von Apple entwickeltes Framework für maschinelles Lernen. Der Hauptvorteil des GGUF-Ansatzes liegt in der Unterstützung verschiedener Hardware und der einfachen plattformübergreifenden Nutzung, während MLX speziell für Apple Silicon entwickelt wurde und die einheitliche Speicherarchitektur nutzt.
Abbildung|mlx-framework.org
Obwohl MLX speziell für Apple-Chips entwickelt wurde, hängt es von dem Modell und der Laufzeitversion ab, welcher Ansatz schneller ist und weniger Speicher verbraucht.
Zusammenfassend lässt sich sagen, dass für einen M5 Pro Mac mini mit 48 GB Arbeitsspeicher der komfortable Bereich bei großen Modellen mit 20 bis 30 Milliarden Parametern liegt