Entschlüsseln der Jev-Blackbox: Gespräche mit den weltweit ersten Reproduzenten – das 9B-Kleinmodell erreicht eine "Schnellentscheidung" in 79 Millisekunden
Das Jevons-Paradoxon in der Ökonomie besagt: Je höher die Effizienz der Nutzung einer Ressource und je niedriger ihre Stückkosten sind, desto stärker steigt ihr Gesamtverbrauch statt zu sinken. Derzeit wird die Branche der großen Sprachmodelle von diesem Gesetz voll und ganz demonstriert – je günstiger das Modell und je schneller es ist, desto explosionsartiger steigt die Anzahl der Aufrufe.
Und die neue Spezies Jev, die kürzlich das Silicon Valley erobert hat, ein „großes Sprachmodell“ mit dem gleichen Namen wie das Jevons-Paradoxon, treibt diese Offensive auf die Spitze.
Es weigert sich, Gedichte für dich zu schreiben, weigert sich, mit dir über das Leben zu diskutieren, und verschwendet nicht einmal die Mühe, einen vollständigen unsinnigen Satz zu generieren. Aber genau so ein kaltes „stummes“ Modell hat weniger als 48 Stunden nach seiner Veröffentlichung über 30 Millionen begeisterte Zuschauer auf X angezogen und 25.000 Entwickler dazu gebracht, am internen Test teilzunehmen; 24 Stunden nach der Bereitstellung auf der Plattform für große Sprachmodelle Vercel haben fast 13 % der zahlenden Teams es sofort integriert – diese Durchdringungsgeschwindigkeit ist doppelt so hoch wie die von GPT-4 damals.
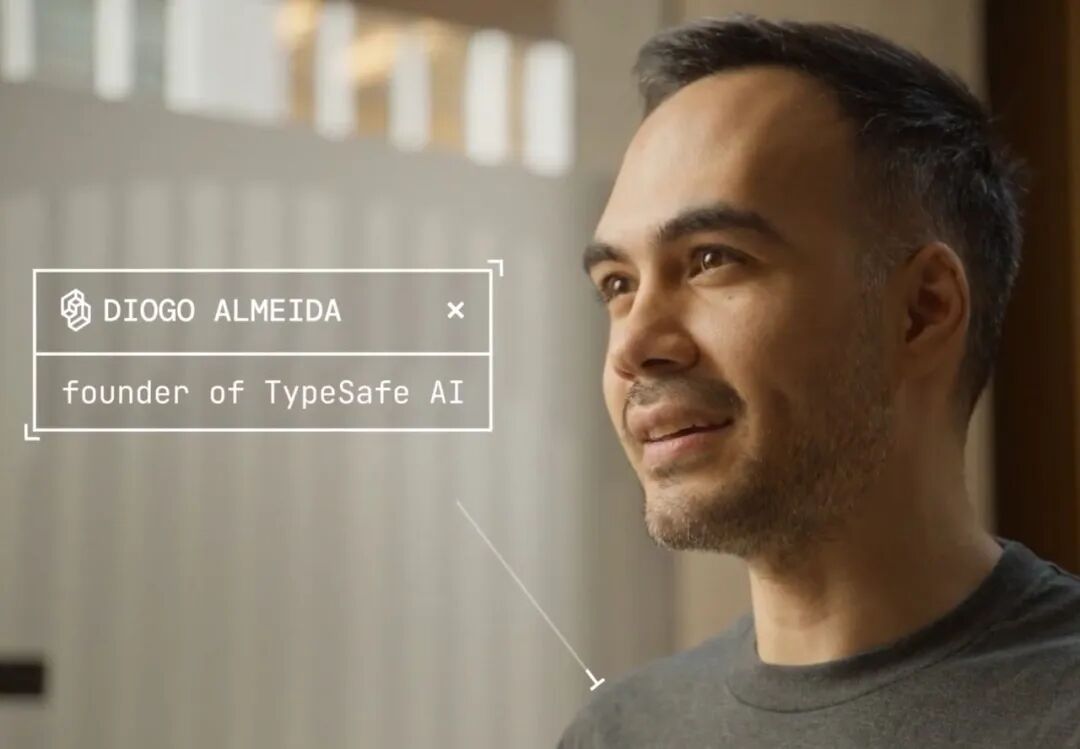
In allen Kampfkünsten ist nur Geschwindigkeit unbesiegbar. Das ist auch das Trumpf von Jev: extrem schnell und extrem günstig. Als ehemaliger Kernforscher bei OpenAI und Miterfinder der RLHF-Technologie hat der Gründer von Jev, Diogo Almeida, sogar eine kühne Aussage gemacht: „Die nächste Ära gehört nicht Hilfswerkzeugen wie Claude Code, Jev ist die Zukunft! Es ist 200 Mal schneller und 400 Mal günstiger als allgemeine Modelle und hat keine Halluzinationen. Das wird das nächste große Ding nach RLHF sein.“
Von Browser-Plug-Ins mit Antwortzeit im Millisekundenbereich über hochfrequente Entscheidungen für Transaktionen auf der Blockchain bis hin zu Cheats für *Doom*, die 10 Entscheidungen pro Sekunde treffen und menschliche Spieler übertreffen – die Anwendungsfälle, die Entwickler rund um Jev erstellen, nehmen explosionsartig zu.
Gleichzeitig steigen Neugier und Zweifel der Branche an diesem „schwarzen Kasten“, dessen Bewertung über Nacht auf 200 Millionen Dollar gestiegen ist und dessen Trainingsschema und untergeordnete Gewichte bis heute streng geheim gehalten werden: Ist es wirklich eine Revolution der Modellarchitektur oder nur ein vermarkteter „Klassifikator“?
Erst gestern Vormittag hat das KI-Labor des chinesischen KI-Unternehmens APUS (Qilin Hesheng) eine der weltweit ersten unabhängigen Open-Source-Reproduktionsergebnisse für Jev veröffentlicht und es als sofort einsetzbares Agent Skill fast-browser-use verpackt. Das Projekt unterstützt die Offline-Ausführung mit rein lokalen Modellen, läuft auf den drei Desktop- und Serverbetriebssystemen macOS, Linux und Windows und erfordert nicht einmal eine dedizierte GPU – es kann auch auf normalen Macs und PCs lokal ausgeführt werden.
Derzeit ist der vollständige Quellcode des Projekts unter der MIT-Lizenz für die Gemeinschaft offen zugänglich (https://github.com/APUS-AI-Lab/fast-browser-use).
Dr. ZHANG Xu, Studium mit Bachelor-, Master- und Doktorgrad an der Tsinghua-Universität, Doktor der Ingenieurwissenschaften, Chefwissenschaftler von APUS AI
Der Autor hat sofort den Leiter dieses Projekts kontaktiert – Dr. ZHANG Xu, Chefwissenschaftler von APUS AI. Wir haben ausführlich über Themen wie die technische Grundlogik und den Weg von Jev, die Reproduktions- und Anpassungslogik von APUS, das Anwendungspotenzial solcher Modelle für schnelle Entscheidungen sowie den zukünftigen Trend der „Aufteilung in schnelle und langsame Aufgaben“ bei Agenten diskutiert.
Genauer gesagt hat das Team von ZHANG Xu keine Modellgewichte, vollständige Architektur und Trainingsmethoden von Jev erhalten; stattdessen hat es den Arbeitsmechanismus anhand öffentlicher Materialien und tatsächlicher Ein- und Ausgaben rückgeschlossen, auf Basis von Open-Source-Modellen wie der Qwen3.5-Serie und der Google Gemma-Serie den zentralsten Arbeitsablauf von Jev wiederhergestellt und bei der Inferenzgeschwindigkeit ein vergleichbares Niveau erreicht.
Am Vormittag des Open-Source-Tages (20. September) hat APUS die ersten Ergebnisse veröffentlicht: Bei echten Browser-Aufgaben dauert die Wikipedia-Suche etwa 18 Sekunden, kürzere Aufgaben wie das Ausfüllen von Formularen und die Navigation innerhalb von Websites werden in wenigen Sekunden erledigt, ohne dass jemals ein Cloud-Modell aufgerufen werden muss. Am Nachmittag des Interviews hat das Team von ZHANG Xu die Tests auf RTX PRO 6000 übertragen, die Zeit für eine einzelne Entscheidung auf 79 Millisekunden reduziert und damit das Niveau von 70 bis 500 Millisekunden Antwortzeit von Jev erreicht.
Er hat außerdem verraten, dass das unternehmenseigene, selbst entwickelte Modell die Leistung von Jev mit einem kleineren Parameterumfang von 9B und 4B nachbilden kann und in Kürze Open-Source wird. (Bis zum Zeitpunkt der Veröffentlichung ist es bereits unter https://huggingface.co/apus-ailab/APUS-OpenJev-v1 Open-Source verfügbar.)
Im Folgenden die Kernpunkte des Interviews zwischen dem Autor und Dr. ZHANG Xu. Zur besseren Lesbarkeit wurde das ursprüngliche Gespräch verdichtet und zusammengefasst.
Die Grundlogik von Jev aufschlüsseln
AI Front: Könnten Sie abgesehen von den offiziellen Konzepten auf anschauliche Weise erklären, worin der Unterschied zwischen Jev und den heute üblichen großen Sprachmodellen besteht? Was ist sein Wesen?
ZHANG Xu: Der Schlüssel zum Verständnis dieser Frage liegt darin, die zwei grundlegenden Arbeitsschritte großer Sprachmodelle zu erkennen. Der erste Schritt ist Prefill, also die Verarbeitung der Eingabe; der zweite Schritt ist Decode, also die autoregressive Generierung.
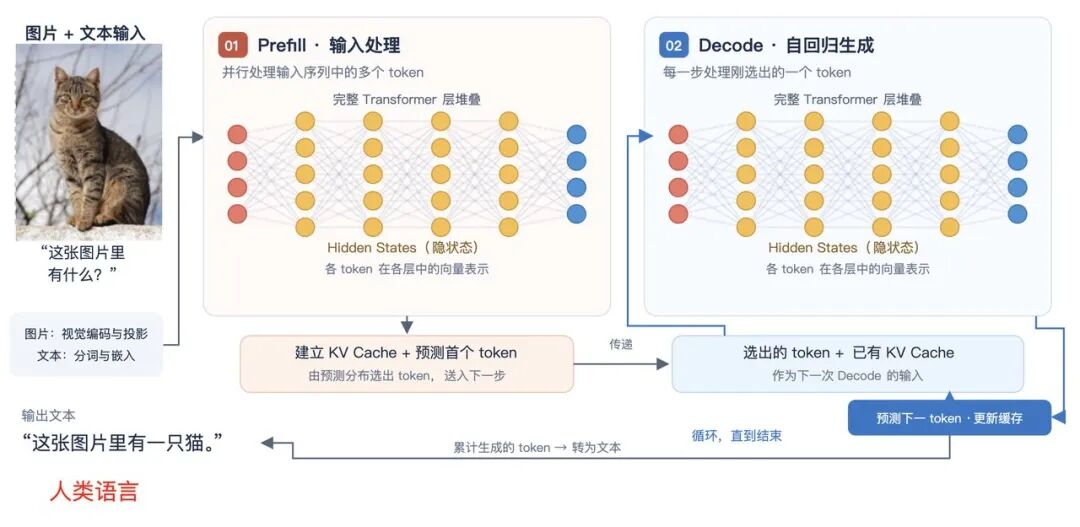
Wenn das große Sprachmodell den ersten Schritt Prefill abgeschlossen hat, haben die „Hidden States“ in seinem neuronalen Netzwerk die Details der eingegebenen Texte und Bilder bereits verstanden.
Der zweite Schritt Decode gibt Token für Token aus, dieser Schritt dient ausschließlich dazu, die Ergebnisse für Menschen lesbar zu übersetzen.
Aber die Bandbreite der menschlichen Sprache ist sehr gering, was zu hohem Informationsverlust führt. Zum Beispiel kann man ein Bild mit einer Katze, Texturen von Ästen und komplexen Lichteffekten niemals vollständig und lückenlos durch Text für eine andere Person nachbilden.
Das Kernwesen von Jev besteht darin, dass es den zweiten Schritt (Decode) entfernt und nur den ersten Schritt behält. Es generiert keine Texte Wort für Wort mehr, um Menschen entgegenzukommen, sondern berechnet das Ergebnis direkt im „Latent Space“ des Modells, nachdem es die Informationen verstanden hat.
AI Front: Was gibt es dann am Ende aus? Etwas wie Choice, Score oder Wahrscheinlichkeiten?
ZHANG Xu: Ja. Jedes Mal, wenn ein normales großes Sprachmodell ein Token generiert, berechnet es im Wesentlichen die vollständigen Wahrscheinlichkeiten im Vokabular von hunderttausend bis zweihunderttausend Wörtern und wählt dann eines aus, das ausgegeben wird.
Jev hingegen führt diesen Prozess extrem zusammen und wandelt ihn in eine Wahrscheinlichkeitsberechnung für begrenzte Optionen um. Wenn Sie zum Beispiel fragen „Ist diese Gliederung vollständig?“, gibt es nur zwei Optionen „vollständig“ und „unvollständig“ zurück, und es gibt nur die Wahrscheinlichkeitswerte (Score) dieser zwei Optionen aus.
Aus diesem Grund sagt es auch, dass es keine Halluzinationen erzeugen kann. Das bedeutet nicht, dass es nie falsch urteilt, sondern dass es keine neue Option D erfinden wird, wenn Sie ihm nur die Optionen A, B und C geben.
Aber keine Halluzinationen zu erzeugen, ist nicht dasselbe wie niemals einen Fehler zu machen.
AI Front: Da es nur die Wahrscheinlichkeiten festgelegter Optionen ausgibt, behaupten einige in der Branche, es sei nur ein verpackter „Aktionsklassifikator“. Wie stehen Sie dazu? Was ist das Neue daran?
ZHANG Xu: Diese Aussage stimmt. Aber ich denke, man sollte auch den größeren Forschungstrend dahinter sehen.
Zum Beispiel enthält ein Bild sehr reichhaltige Informationen. Egal wie lange Sie es beschreiben, es ist schwierig, alle Details vollständig nachzubilden. Die Sprache selbst führt zu Informationsverlusten.
Daher gibt es jetzt einen zukunftsweisenden Ansatz: Da das Modell diese Informationen bereits intern hat, müssen wir sie erst in menschliche Sprache umwandeln und dann mit der Sprache weiter verarbeiten?
Jev kann als ein spezifischer Sonderfall in diesem Bereich betrachtet werden. Es entfernt die nachfolgende Textgenerierung und trifft Urteile direkt anhand der internen Zustände des Modells.
AI Front: Was ist also dieser größere Bereich, von dem Sie sprechen? Geht es darum, „Verstehen“ und „Generieren“ weiter voneinander zu entkoppeln?
ZHANG Xu: Das ist einer der Aspekte. In der Branche wird eine größere Kategorie von Ansätzen als Berechnung im latenten Raum bezeichnet.
Zum Beispiel bei der Kommunikation zwischen zwei Agenten, die keine Menschen sind – warum sollten die Informationen im Kopf des ersten Agenten erst in menschliche Sprache übersetzt werden, damit der zweite Agent sie lesen kann? Theoretisch kann die Verarbeitung direkt zwischen den internen Zuständen der Modelle durchgeführt werden.
Modellrouting, Kommunikation zwischen Agenten, internes Denken des Modells – all das kann in diese Richtung weiterentwickelt werden. Jev nutzt diesen Ansatz nur für eine spezifische Aufgabe: Wahrscheinlichkeitsbeurteilung und Entscheidungen für begrenzte Optionen.
AI Front: Wie ist der Fortschritt der großen führenden Unternehmen in diesem Bereich als Branchenkonsens? Was ist der Unterschied zwischen dem Ansatz von Jev und ihren Methoden?
ZHANG Xu: Ja, zum Beispiel versucht die DeepSeek-v4.1 Flash-Version bereits, die Fähigkeiten von Prefill und Decode voneinander zu entkoppeln. Ein typischeres Beispiel ist das neueste GPT-6 (Astra). Der Mechanismus des Loop Transformer, der in der Branche diskutiert wird, zielt im Wesentlichen darauf ab, dass die Denkkette und der Denkprozess des Modells innerhalb des „latenten Raums“ zirkulär berechnet werden, ohne in ineffiziente menschliche Texte umgewandelt und ausgegeben zu werden.
Im Vergleich dazu hat Jev die Ergebnisse der Berechnung im latenten Raum geschickt „produktisiert“. Es zeigt, dass die direkte Nutzung der Zwischenergebnisse im latenten Raum die heutigen Anwendungsformen bereits verändern kann.
AI Front: Das offensichtlichste Merkmal von Jev ist seine Geschwindigkeit. Abgesehen von dem Entfernen der Generierung langer Texte – warum ist es noch so viel schneller?
ZHANG Xu: Der wichtigste Grund ist, keine Texte zu generieren, was gleichbedeutend damit ist, „nur das erste Token auszugeben“ und nur Urteile zu fällen. Darüber hinaus gibt es eine Reduzierung der Berechnungsdimensionen.
Zweitens war die Generierung zuvor offen, jetzt gibt es nur noch wenige oder Dutzende von Kandidaten, der Berechnungsbereich ist kleiner.
Drittens sind diese Kandidaten voneinander unabhängig, so dass mehr parallele Urteile möglich sind; während die traditionelle autoregressive Generierung voneinander abhängig ist, muss jedes Token auf das vorherige warten.
In unserer eigenen Implementierung haben wir auch Verarbeitungen wie die KV-Cache-Broadcast durchgeführt. Zusammengefasst heißt das also: Weniger Generierung, kleinerer Kandidatenbereich und Parallelität.
AI Front: Abgesehen von der Geschwindigkeit – hat es noch andere wesentliche Leistungsvorteile?
ZHANG Xu: Aus unserer Sicht gibt es keinen wesentlichen Unterschied zu großen Sprachmodellen in anderen Aspekten. Es ist im Grunde auch ein großes Sprachmodell, das nur zur Hälfte genutzt wird.
Ob es gut funktioniert, hängt letztendlich davon ab, wie gut das Modell selbst trainiert ist.
Wie man Jev nachbildet
AI Front: Jev hat keine offenen Gewichte, keine vollständige Architektur und keine Trainingsschemata veröffentlicht. Was genau haben Sie bei dieser sogenannten „Nachbildung“ streng genommen nachgebildet?
ZHANG Xu: Streng genommen haben wir seine Funktionalität nachgebildet.
Ich habe alle ihre öffentlichen Materialien durchgelesen, den Hintergrund des Gründers recherchiert und Jev selbst aufgerufen, um seine Ein- und Ausgaben zu beobachten.
Man kann es so verstehen, dass ich es als schwarzen Kasten behandelt habe. Wenn ich die gleiche Art von Eingabe und die gleiche Art von Ausgabe erzeugen kann, sind wir der Meinung, dass wir die von ihm veröffentlichte Funktionalität im Wesentlichen nachgebildet haben.
AI Front: Welche Änderungen haben Sie konkret an Qwen vorgenommen?
ZHANG Xu: Die ursprüngliche Version von Qwen3.5 reicht bereits aus.
Das Modell selbst muss nicht geändert werden, es wird nur die Arbeitsweise außen herum angepasst. Das Open-Source-Projekt, das wir jetzt veröffentlicht haben, ist ein Teil aus unserem vorhandenen Agent Harness, den wir extrahiert und vereinfacht haben.