Das beliebteste stumme Modell Jev in Verbindung mit WeChat hat meine geringe emotionale Intelligenz sofort geheilt.
Das stumme Modell Jev von Google ist plötzlich viral geworden,
Es führt keine Gespräche, schreibt keinen Code, verfasst keine Texte und gibt keine Erklärungen ab – egal, was man es fragt, es generiert kein einziges Wort. Es tut nur eines: Urteilen.
Nur wenige Tage nach seiner Veröffentlichung diskutieren fast alle Menschen auf Hacker News sowie in chinesischen Technikcommunities über es. Aber die Menschen diskutieren nicht darüber, wie klug es ist, sondern darüber, wie unkonventionell es ist.
Zugegeben, dass ein Modell, das nicht sprechen kann, populär wird, ist an sich schon höchst ungewöhnlich.
Das Erste, was die Menschen diskutiert haben, ist sein Einsatzbereich. Wo kann ein Modell eingesetzt werden, das nicht sprechen kann? Die Antwort lautet WeChat.
WeChat muss Nachrichten beantworten, Gruppen verwalten und Risikokontrollen durchführen – alles scheint an ein „sprechendes“ großes Sprachmodell übergeben zu werden.
Was sich völlig unlogisch anhört, ist auf diese Weise ganz logisch eingetreten.
Um aber zu verstehen, was genau vor sich geht, muss man zuerst mit Jev selbst beginnen.
01
Was genau ist Jev?
TypeSafe AI hat Jev am 16. September 2026 veröffentlicht.
Das ist ein Unternehmen mit Sitz in San Francisco, dessen Gründer Diogo Almeida ist, Mitautor der GPT-4-Arbeit und ehemaliger Forscher bei OpenAI. Das Unternehmen hat zwei Jahre lang im Verborgenen entwickelt und ist mit einer 40-Millionen-Dollar-Samenrunde unter der Leitung von DCVC an die Öffentlichkeit getreten.
Jev bezeichnet sich selbst als „System-One-Modell“.
Dieser Name stammt aus dem Buch *Schnelles Denken, Langsames Denken* von Daniel Kahneman. Darin beschreibt System 1 die intuitive, unbewusste Urteilsfindung, während System 2 für langsames, schrittweises Schlussfolgern steht.
Laut Aussage von TypeSafe haben in den letzten Jahren alle Menschen an System-2-Modellen gearbeitet, die denken, lange Texte schreiben und Erklärungen abgeben können. Aber die meisten Urteile, die in Software tatsächlich benötigt werden, gehören zum Bereich von System 1.
Der Unterschied zwischen Jev und ChatGPT oder Claude besteht darin, dass Jev nur Multiple-Choice-Fragen beantworten kann, während andere Modelle ganze Aufsätze schreiben.
So funktioniert die Nutzung von Jev: Man gibt ihm einen Zustand, zum Beispiel eine E-Mail, eine Zeile Protokoll, ein Arbeitsticket oder einen Programmzustand, und dann mehrere im Voraus festgelegte Fragen. Jev gibt alle Antworten auf einmal zurück, jede Antwort ist mit einer Wahrscheinlichkeit und einem Konfidenzwert für die eigene Zuverlässigkeit versehen.
Es kann nur drei Arten von Fragen beantworten.
Choice: Eine Auswahl aus maximal 255 Optionen treffen.
Score: Eine Bewertung auf einer Skala von 2 bis 10 Punkten vergeben.
Noul: Eine Ja/Nein-Wahrscheinlichkeit zwischen 0 und 1 angeben.
Die drei Fragetypen können in derselben Anfrage gemischt werden und werden parallel berechnet. Laut offizieller Angabe ist die Latenz fast gleich, egal ob man eine oder vier Fragen stellt.
Jev zeichnet sich durch Geschwindigkeit und niedrige Kosten aus.
Herkömmliche große Modelle generieren Text Wort für Wort, die Dauer hängt von der Länge des zu erstellenden Textes ab. Jev erzeugt keinen Text, der Umfang der Antworten ist im Voraus festgelegt, es berechnet nur die Wahrscheinlichkeit für jede Option.
Laut offiziellen Angaben von Jev beträgt die End-to-End-Antwortzeit 70 bis 500 Millisekunden. Die Kosten betragen 0,042 US-Dollar pro Million Eingabe-Token, die Ausgabe ist kostenlos. Nachdem es auf dem AI Gateway von Vercel bereitgestellt wurde, nutzten innerhalb von 24 Stunden fast 13 % der zahlenden Teams von Vercel Jev – es ist das neue Modell mit der schnellsten Akzeptanzrate auf der Vercel-Plattform.
Es kann keine Gespräche führen, keinen Code schreiben, keine Texte verfassen, keine Bilder erkennen und keine Gründe erklären. Wenn man es fragt „Warum wurde diese Option nicht ausgewählt?“, antwortet es nicht, es gibt nur Zahlen zurück.
Jev hat zudem die Besonderheit, dass die Halluzinationsrate 0 % beträgt.
Das bedeutet, dass es niemals eine Antwort außerhalb der vorgegebenen Optionen gibt und niemals Felder falsch darstellt. Aber es kann durchaus eine falsche Option auswählen, was Diogo, der CEO von TypeSafe, selbst bestätigt hat.
Der Name Jev stammt aus dem Jevons-Paradoxon.
Wenn die Effizienz von Dampfmaschinen steigt und Kohle pro Tonne günstiger wird, steigt der Gesamtverbrauch an Kohle stattdessen, weil die günstige Antriebskraft in mehr Bereichen eingesetzt wird.
Früher war die Nutzung von KI unerschwinglich, weil der Aufruf eines großen Modells teuer und langsam war – es lohnte sich nicht, es für ein winziges Urteil aufzurufen. Jetzt senkt Jev die Kosten für ein einzelnes Urteil auf ein Zehntausendstel US-Dollar.
Seine Trainingsmethode heißt RLCD, Reinforcement Learning for Calibrated Decisions. RLHF zielt darauf ab, „den Menschen zu gefallen“, RLVR zielt darauf ab, „dass Programme die Richtigkeit überprüfen können“, und RLCD zielt darauf ab, „dass die Wahrscheinlichkeiten ehrlich sind“.
Wenn RLCD angibt, zu 70 % sicher zu sein, bedeutet das, dass es bei mathematischer Überprüfung zu 70 % Wahrscheinlichkeit richtig liegt.
02
Jev ist zu einem Plugin für WeChat geworden
Nachdem Jev viral geworden ist, wird es in der Community am häufigsten als Plugin für WeChat eingesetzt.
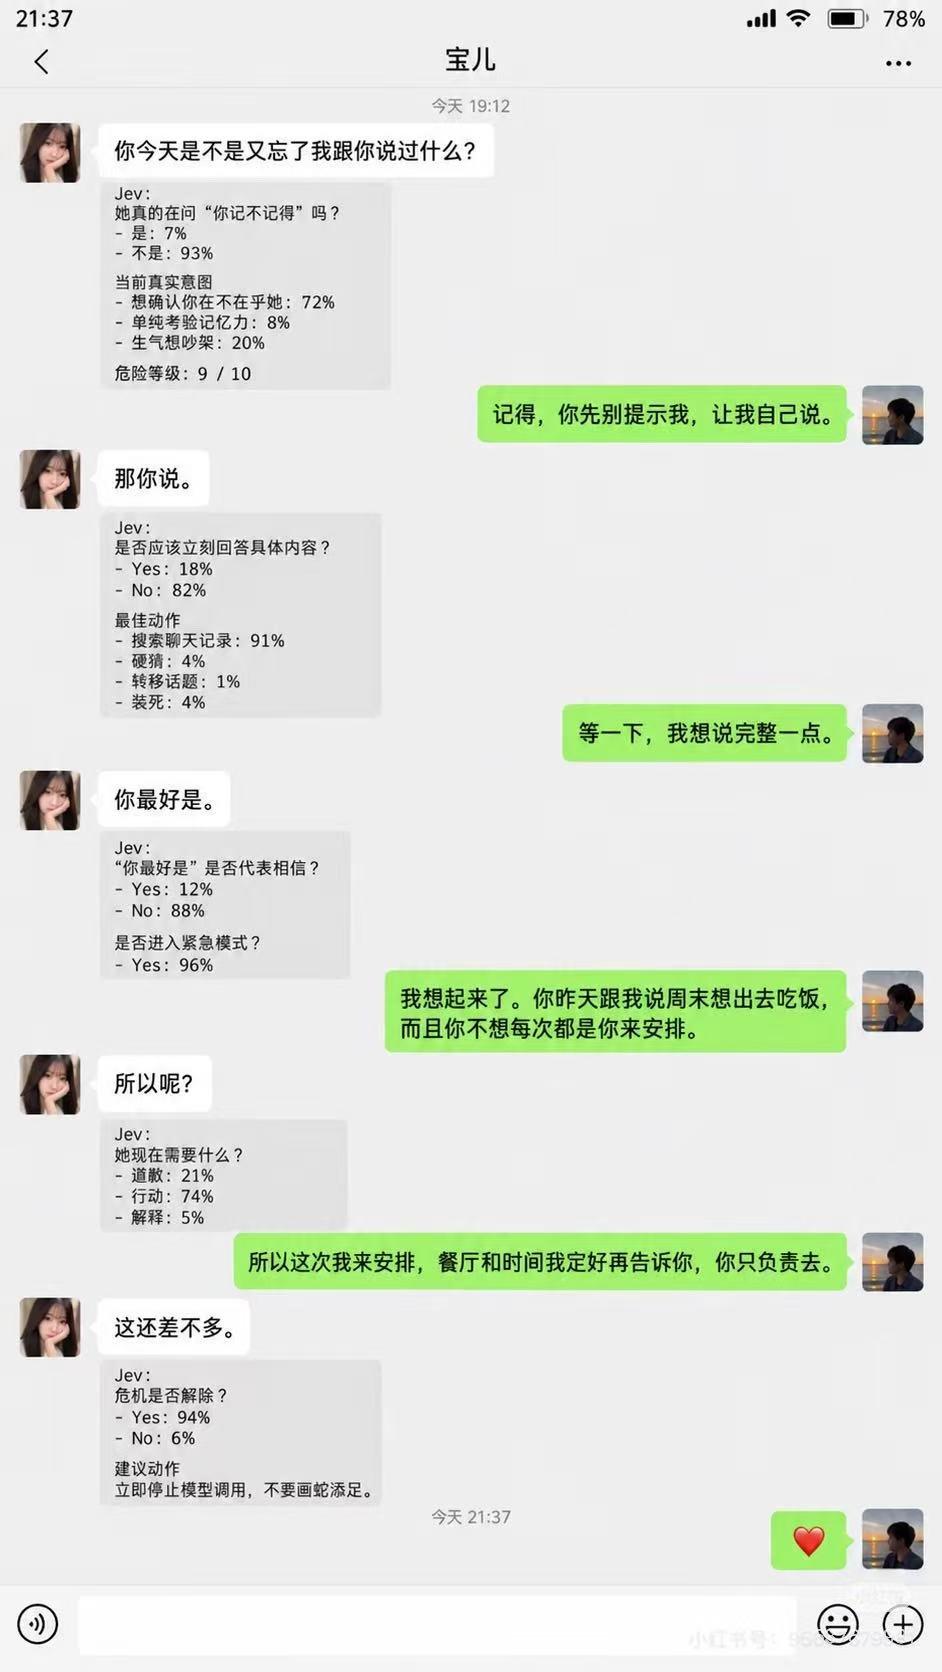
Die größte Herausforderung bei WeChat besteht darin, die Absicht des Gegenübers genau zu erfassen. Nehmen wir das klassische Beispiel „Mach du das nach eigenem Ermessen“ – was bedeutet das eigentlich? Soll man es geringfügig ändern? Soll man es unverändert lassen? Oder soll man es grundlegend überarbeiten?
Hier kommt die Stärke von Jev zum Tragen.
Soll man auf diese Nachricht antworten?
Soll man die andere Person @erwähnen?
Ist diese Nachricht Werbung?
Soll man diese Person aus der Gruppe entfernen?
Soll man diese Anfrage an einen menschlichen Mitarbeiter weiterleiten?
Möchte diese Person eine Rückerstattung beantragen?
Verstößt dieser Text gegen die Nutzungsbedingungen?
All diese Fälle sind „eine Auswahl aus begrenzten Optionen treffen“ und erfordern ein Ergebnis innerhalb von Hunderten von Millisekunden. Genau dafür ist Jev ausgelegt.
Warum nutzt man dafür kein großes Sprachmodell?
Es gibt drei Gründe.
Erstens: Langsamkeit. Ein großes Modell braucht 3 bis 30 Sekunden, um eine Antwort zu generieren. Nachrichten in WeChat-Gruppen laufen ständig weiter – wenn man nach 30 Sekunden antwortet, wird die andere Person möglicherweise ungeduldig. Jev braucht nur 70 bis 500 Millisekunden, sodass man antworten kann, bevor die Nachricht aus dem Bildschirm verschwindet.
Zweitens: Hohe Kosten.
WeChat-Roboter laufen in der Regel auf günstigen, dauerhaft laufenden Servern oder leichten Servern – die Kosten für ein einzelnes Urteil müssen so niedrig sein, dass sie vernachlässigbar sind. Wenn man jedes einzelne Nachricht mit einem großen Modell prüft, entstehen bei Hunderttausenden von Nachrichten erhebliche Kosten. Jev berechnet 0,042 US-Dollar pro Million Eingabe-Token, die Ausgabe ist kostenlos, sodass die Kosten für ein einzelnes Urteil auf ein Zehntausendstel US-Dollar sinken.
Drittens, was WeChat-Plugins am meisten fürchten: Das Modell darf keine falschen Aussagen treffen.
Ein frei generierendes großes Modell in einem Chat-Fenster kann jederzeit unangemessene Inhalte ausgeben – im besten Fall führt das zu peinlichen Situationen, im schlimmsten Fall löst es eine Risikokontrolle aus und das Konto wird direkt gesperrt. Jev generiert überhaupt keinen Text, es wählt nur aus den von Ihnen vorgegebenen Optionen aus – strukturell kann es also keine unangemessenen Inhalte erzeugen.
Das größte langwierige Problem bei WeChat-Plugins ist die Trennlinie zwischen „automatischer Antwort“ und „Weiterleitung an menschliche Mitarbeiter“.
Vollautomatisch bedeutet, dass der Inhalt nicht kontrolliert werden kann; alles an menschliche Mitarbeiter weiterzuleiten, überlastet die Mitarbeiter. Jev weist jedem Urteil einen kalibrierten Konfidenzwert zu, sodass diese Linie zu einem Schwellenwert wird: Bei hoher Zuverlässigkeit wird die Anfrage automatisch bearbeitet, bei niedriger Zuverlässigkeit wird sie an einen Menschen oder an ein teureres großes Modell weitergeleitet.
Dieses Verteilungssystem „Automatisch bei hoher Zuverlässigkeit, Weiterleitung bei niedriger Zuverlässigkeit“ ist genau die Struktur, die WeChat-Kundenservice und Gemeinschaftsverwaltung schon immer gewünscht haben.
Es gibt noch einen weiteren verborgenen Punkt: Bisher wird bei Übereinstimmung mit Schlüsselwörtern automatisch geantwortet, bei Vorhandensein des Schlüsselworts „Werbung“ wird die Person aus der Gruppe entfernt, bei Erwähnung durch @ wird geantwortet. Das alles basiert auf Schlüsselwortabgleich – wenn die andere Person eine andere Formulierung verwendet und das Schlüsselwort nicht nutzt, funktioniert die automatische Antwort nicht mehr.
Jev ersetzt den „Schlüsselwortabgleich“ durch „semantisches Urteil“. Es geht immer noch darum, ob man antwortet oder nicht, ob man die Person entfernt oder nicht – aber die Grundlage des Urteils ist nicht das Schlüsselwort, sondern die eigentliche Absicht des Nutzers.
Die Installation ist sehr einfach: Man gibt Codex den Befehl „npx skills add typesafe-ai/skills“ oder fügt einen Plugin-Marktplatz in Claude Code hinzu. Über OpenRouter kann man es sofort aufrufen.
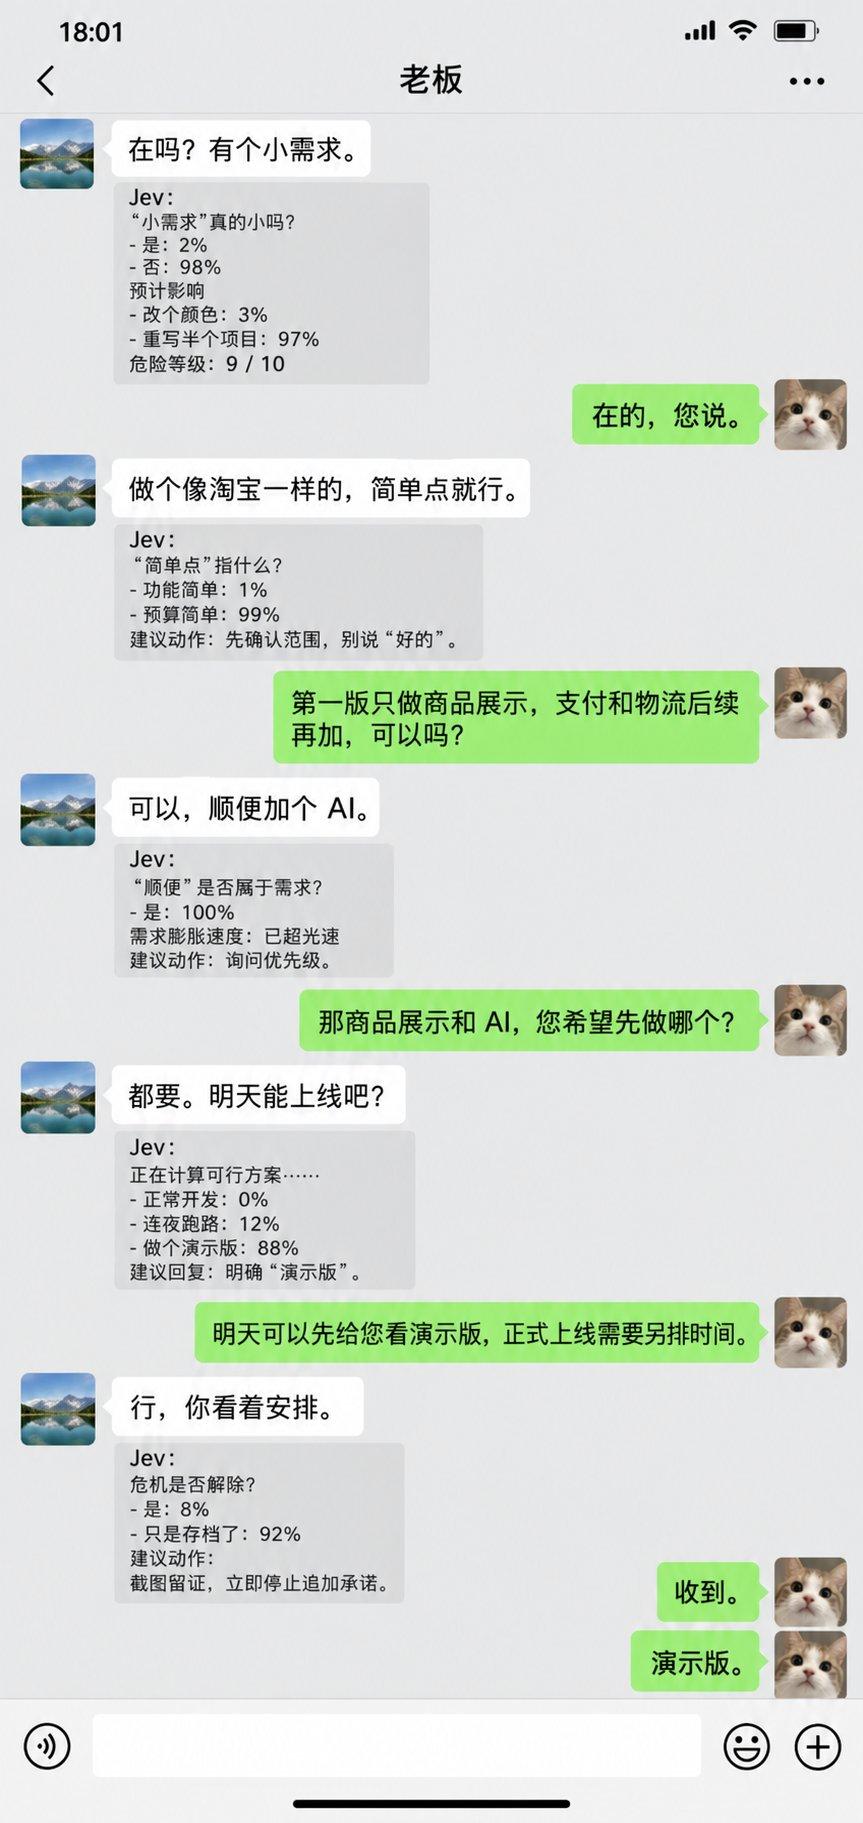
Im Internet gibt es bereits viele ausgereifte Produkte, zum Beispiel wechat-jev-hud – das ist ein WeChat-HUD, das unter Windows läuft, durch Bildschirmaufnahme den Chat-Bereich erkennt, die Textblasen identifiziert und Jev zwischen OCR und Überlagerungsschicht für Echtzeit-Urteile einsetzt.
Danach wird der Effekt wie im Bild dargestellt angezeigt: Mit welcher Wahrscheinlichkeit die Nachricht der anderen Person welche Absicht verfolgt.
03
Von der Generierung zum Urteil
Jev ist so schnell populär geworden, weil es ein großes Problem adressiert: Warum sind Agenten immer noch langsam, teuer und instabil?
In den letzten zwei Jahren drehte sich die KI-Erzählung um längere Kontexte, intelligentere Schlussfolgerungen und schönere Antworten.
Aber wenn man ein Modell tatsächlich in ein System einbaut, das Hunderttausende Male pro Tag ausgeführt wird, stellt man fest, dass die allermeisten Aufrufe gar nicht erfordern, dass das Modell „spricht“ – es muss nur „urteilen“.
Zum Beispiel, welche Abteilung für ein bestimmtes Kundenserviceticket zuständig ist, ob ein Aufruf eines Tools Risiken birgt, ob die Ausgabe einer KI von dem erwarteten Pfad abweicht oder welcher Knopf auf der Seite als nächstes angeklickt werden soll.
All diese Fragen haben nur eine richtige Antwort, und die Optionen für die Antwort sind bereits im eigenen Code festgelegt. Es ist ein großer Umweg, ein Modell, das Aufsätze schreiben kann, zuerst einen Text generieren zu lassen und diesen dann durch ein Programm wieder zu einem Urteil umzuwandeln.
Genau diesen Umweg will Jev einsparen.
Deshalb sagen viele Menschen in der Community über Jev, dass es der Software eine Art „semantische If-Anweisung“ hinzufügt: Wenn (if) die andere Person eine bestimmte Absicht zeigt, antworte ihr mit der entsprechenden Antwort.
Der Effekt ist sofort sichtbar: Wenn man Jev über Browser Use in einem Browser-Agent einsetzt und in einer einzigen Anfrage gleichzeitig auswählt, „was zu tun ist“ und „welches Element angeklickt werden soll“, kann die Zeit für die Buchung eines Flugtickets von 9,5 Sekunden auf 7 Sekunden reduziert werden.
Zusätzlich kann man Jev in langwierigen Aufgaben als Router-Middleware einsetzen, damit es für den Agenten auswählt, welches Modell verwendet werden soll – das spart ebenfalls viel Zeit.
Allerdings ist die Aussage „Jev ersetzt große Modelle“ eine falsche Behauptung. Der richtige Ansatz ist: Große Modelle helfen Ihnen, die Urteilsregeln klar zu definieren, und Jev führt diese Regeln in der Produktivumgebung mit hoher Häufigkeit und niedrigen Kosten aus.
Der eigentliche Wert von Jev liegt in der Kalibrierung: Es quantifiziert scheinbar unklare Fragen ohne eindeutige richtige Antwort, sodass man auf einen Blick erkennen kann, welche Option ausgewählt werden soll.
Das Beispiel des WeChat-Plugins zeigt bereits, dass die ersten Einsatzbereiche nicht Szenarien sind, die „Kreativität erfordern“, sondern Szenarien mit hoher Häufigkeit, niedrigen Kosten und Null-Fehler-Toleranz.
Je häufiger, je kleinteiliger und je fehlerempfindlicher das Urteil ist, desto besser eignet sich Jev dafür.
Es gibt eine Vermutung: Wenn das Urteil selbst so günstig wird, braucht man das Modell gar nicht mehr sprechen zu lassen, sondern lässt es nur urteilen. Die Urteilsebene wird wie Datenbanken oder Caches zu einer standardmäßigen Infrastruktur, die im Kern jeder Anwendung eingebettet ist.
Das WeChat-Plugin ist nur der Anfang.
Allerdings ist die Anpassungsfähigkeit von Jev an chinesische Inhalte schlecht. Die