Jev lässt Programmierer auf der ganzen Welt völlig ausflippen
In der Smart-Home-Community Home Assistant ist kürzlich ein Plugin namens HA-Jev erschienen.
Seine Logik ist extrem einfach: Ein Sensor erfasst die Leistungsänderungen der Waschmaschine und den Zustand der Waschmaschinentür, dann stellt er dem Modell eine Frage: „Die Wäsche ist fertig, sind die Kleidungsstücke noch in der Maschine vergessen?“ Das Modell gibt keine textliche Analyse aus, sondern liefert nur einen Wahrscheinlichkeitswert zurück. Wenn der Konfidenzwert über 0,8 liegt, erscheint auf dem Smartphone eine Erinnerung, die den Nutzer auffordert, die Wäsche herauszunehmen.
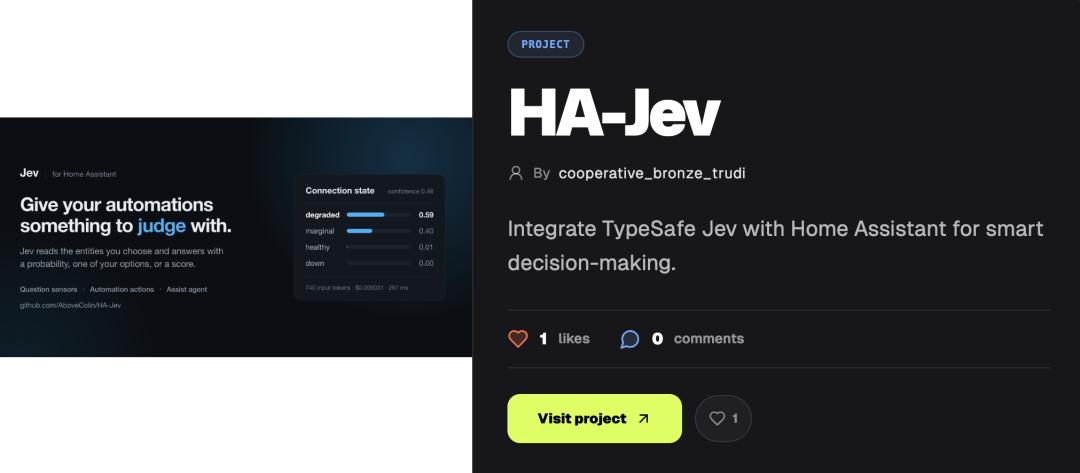
HA-Jev dient ausschließlich dazu, den Nutzer zu erinnern, ob die fertige Wäsche noch in der Waschmaschine verblieben ist | Bildquelle: pitchhut
Eine einzelne Auswertung dauert mehrere Dutzend Millisekunden und kostet 0,000015 US-Dollar.
Der Entwickler des Plugins hinterließ im Forum eine nachdenkliche Bemerkung: „Ich habe früher immer große Sprachmodelle dazu verwendet, Fragen zu beantworten, die sie überhaupt nicht brauchen. Ob man die Wäsche vergessen hat, ist eine einfache Entscheidung, kein formeller, langatmiger Aufsatz.“
Diese Aussage trifft genau die Schwäche der aktuellen generativen KI. In den vergangenen vier Jahren hat die gesamte Branche fast alle Rechenkapazitäten, Kapital und Ingenieurressourcen darauf verwendet, „Modelle dazu zu bringen, fließendere menschliche Sprache zu erzeugen“. Man hat sich daran gewöhnt, monströse Modelle mit hunderten oder sogar tausenden Milliarden Parametern zu nutzen, die zuerst einen langen Denkprozess ausgeben, diesen dann in höfliche, rücksichtsvolle natürliche Sprache verpacken, sodass Entwickler anschließend mit komplexen regulären Ausdrücken die benötigte Antwort herausfiltern müssen.
Bis der ehemalige OpenAI-Forscher Diogo Almeida mit seinem neuen Modell Jev auftrat. Dieses als „System One“ bezeichnete Modell hat keine „Stimme“: Es erzeugt keinen Text, sondern gibt nur Wahrscheinlichkeitsentscheidungen aus.
Nur wenige Tage nach der Veröffentlichung haben weltweite Entwickler fast 500 Open-Source-Projekte rund um Jev erstellt. Das ist wahrscheinlich das größte Projektaufkommen seit Openclaw.
Plötzlich wird allen klar: Sobald man das Bedürfnis großer Modelle, sich auszudrücken, wegnimmt, werden einst teure und überladene KI-Anwendungen plötzlich so leicht und schnell wie ein Windstoß.
01
Die „Neuronen“ der großen Modelle
Wenn man den früheren Aufruf von GPT-5 oder Claude damit vergleicht, einen allwissenden Philosophen einzustellen, um Überwachungskameras zu bedienen, dann gleicht das, was Entwickler jetzt mit Jev machen, eher dem Einbau von unzähligen günstigen und reaktionsschnellen Neuronen in eine Fertigungsstraße.
In dem Bereich der Agent-Infrastruktur, der die meisten Rechenressourcen verbraucht, ist diese Veränderung nahezu revolutionär.
Früher haben Entwickler bei der Verarbeitung extrem langer Kontexte meistens große Modelle dazu verwendet, Zusammenfassungen zu erstellen. Die Entwicklerin Tamara Tran ist einen anderen Weg gegangen: Sie hat ein Jev-Plugin geschrieben, um den Kontext von Claude Code zu komprimieren. Es führt keine Induktionen oder Zusammenfassungen durch, sondern bewertet die Relevanz jedes einzelnen historischen Toolaufrufs einzeln. Sobald der Wert unter einen Schwellenwert fällt, wird der gesamte Eintrag direkt entfernt.
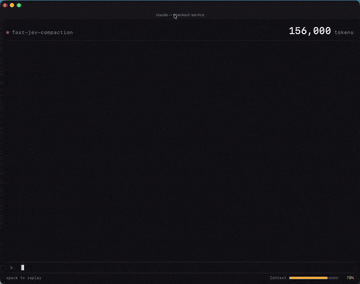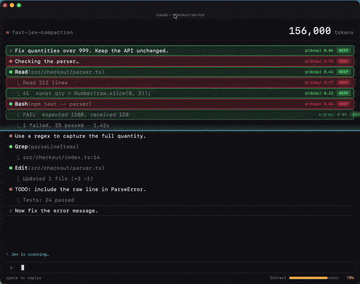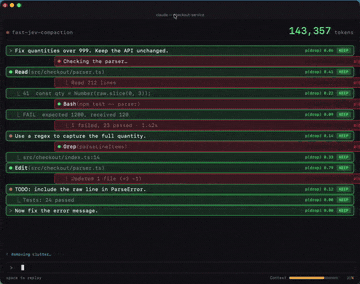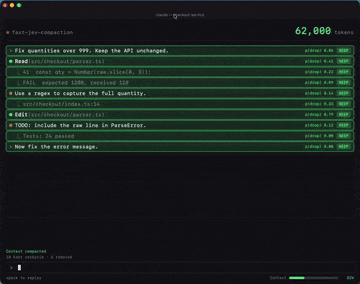
Das Jev-Plugin wird zur Komprimierung des Kontexts von Claude Code verwendet | Bildquelle: X
Das Ergebnis ist erstaunlich: Ein überladener Kontext von fast 1 Million Token wurde innerhalb von einer Sekunde auf 86.000 reduziert, und das Modell hat während des gesamten Vorgangs kein einziges Zeichen erzeugt. Die Erkenntnis dahinter ist sehr einfach: Zusammenfassungen sind teure Generierungsvorgänge, aber das Filtern ist nur eine kalte, schnelle Entscheidung.
Ähnliche Umwälzungen finden auch in der mobilen Automatisierung statt.
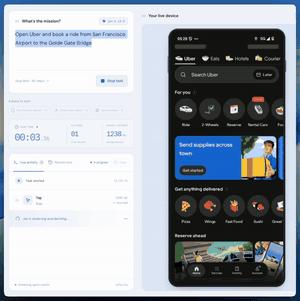
Bedienung von Mobilgeräten mit mobile-jev | Bildquelle: jevfast.com
Das Droidrun-Team hat einen Agenten zur Bedienung von Mobilgeräten namens mobile-jev entwickelt. In einer veröffentlichten Demo steuert es ein echtes Android-Gerät, öffnet Uber, gibt Start- und Zielort ein und klickt sich präzise bis zur Zahlungsseite durch – der gesamte Vorgang mit 9 Bedienungsschritten dauert nur 21 Sekunden.
Während des gesamten Ablaufs wurde kein einziges herkömmliches großes Sprachmodell aufgerufen: Die Texteingaben sind reine Textfragmente, die direkt aus den Anweisungen des Nutzers extrahiert werden. Wo auf jeder Oberfläche als Nächstes geklickt werden muss, ob man wischen oder bestätigen soll, wird vollständig Jev überlassen, das blitzschnelle Wahrscheinlichkeitsabgleiche durchführt.
Neben der Bedienung von Oberflächen haben Entwickler Jev sogar in die ältesten Infrastrukturen integriert.
Auf GitHub tauchten bald die Projekte pg-jev und duckdb-jev auf. Entwickler beginnen, mit natürlicher Sprache direkt Echtzeit-Wahrscheinlichkeitsfilter und Sortierungen für Zeilendaten in Datenbanken durchzuführen. In der Ruby-Gemeinde hat jemand die Entscheidungen direkt in native Kontrollfluss-Syntax gekapselt – der erstellte Code wirkt so, als würde man dem Programm eine Intuition verleihen.
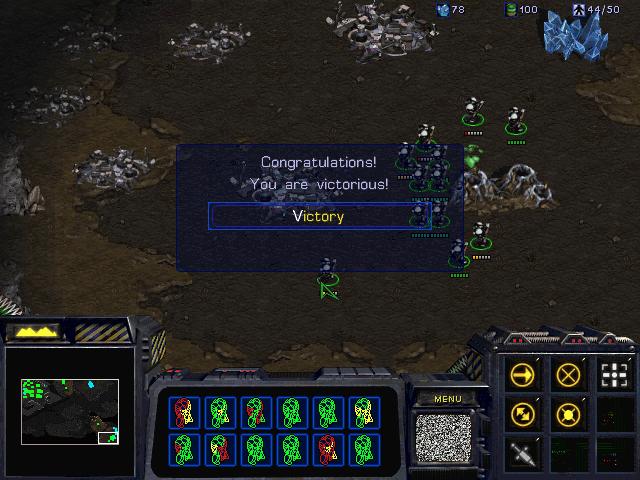
Jev zum Steuern von *StarCraft* ist inzwischen Teil einer Reihe von Github-Projekten | Bildquelle: Github
Im Spielbereich hat jemand Jev dazu gebracht, den Zustand eines Simulators zu steuern, um Super Mario zu spielen, jemand anderes lässt es Wachen in *Doom* steuern, und ein Team hat es sogar in *StarCraft* eingebunden, um die erste Kampfaufgabe abzuschließen. Spiele erfordern Entscheidungen innerhalb von mehreren Dutzend Millisekunden – bei herkömmlichen großen Modellen hat der Spielcharakter längst das Leben verloren, bevor diese überhaupt den ersten Frame verarbeitet haben.
Sogar bei lästigen, aufwändigen Aufgaben wie der Datenbereinigung ist der Unterschied so groß, dass es erstaunt.
Ein Entwickler hatte drei Monate lang 9081 Datensätze zur Produktabgleichung angehäuft. Bereits im Juni hat er mit gängigen großen Modellen berechnet, dass die teuren API-Gebühren ihn direkt davon abgebracht haben, die Aufgabe durchzuführen. Mit Jev hat er an einem Abend 150 Zeilen Skript geschrieben, die gesamte Aufgabe wurde in 13 Minuten abgeschlossen, und die Gesamtrechnung belief sich auf nur 32 US-Cent.
Wenn große Modelle nicht mehr so tun, als wären sie wissbegierige Menschen, kann KI wirklich in die feinsten Strukturen von Automatisierungssoftware integriert werden.
02
Das Jevons-Paradoxon
Der Name Jev geht auf den britischen Ökonomen William Stanley Jevons aus dem 19. Jahrhundert zurück.
Das berühmte „Jevons-Paradoxon“ aus der Ökonomie besagt: Wenn technologische Fortschritte die Effizienz der Nutzung einer Ressource steigern und ihre Nutzungskosten stark senken, wird der Gesamtverbrauch dieser Ressource nicht sinken, sondern explosionsartig ansteigen.
TypeSafe AI hat den Preis für Jev auf nur 0,042 US-Dollar pro Million Eingabe-Token festgelegt, Ausgaben sind kostenlos. Bei diesem Tarif kosten 10.000 geschäftliche Entscheidungen pro Tag etwa 120 US-Dollar im Monat. Wenn man dagegen ein großes Top-Modell mit gleicher Genauigkeit für diesen Ablauf verwendet, würde die monatliche Rechnung direkt auf 35.000 US-Dollar steigen.
Die stark gesunkenen Kosten aktivieren plötzlich all die Randbereiche, die früher als „völlig unwirtschaftlich“ eingestuft wurden.
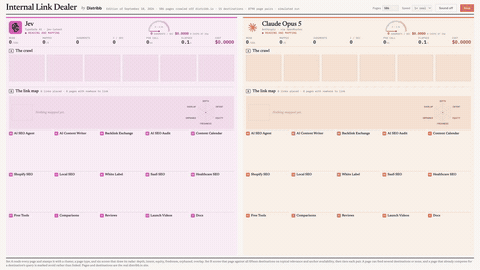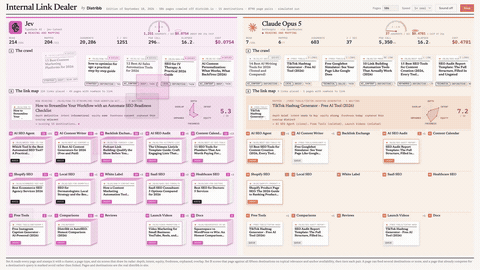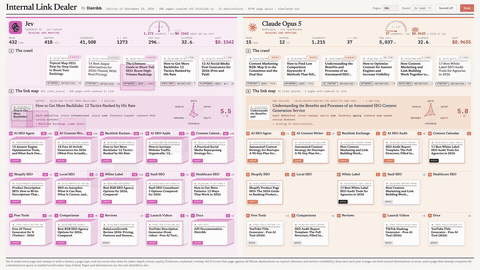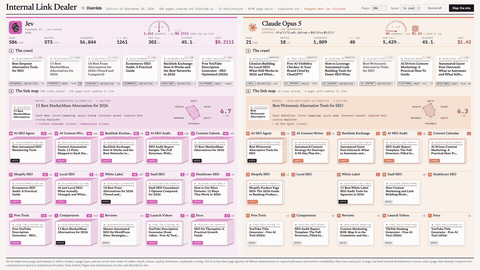
Die Nutzung von Jev für SEO ist erstaunlich schnell | Bildquelle: X
Im Bereich der Inhaltsanalyse hat der Gründer von Distribb fast 600 Webseiten mit Jev gescannt und innerhalb von 45 Sekunden die interne Linkkarte neu erstellt – er hat mehr als 500 Links platziert, und die Gesamtkosten beliefen sich auf nur 21 US-Cent. Früher hätte ein großes Top-Modell in derselben Zeit nicht einmal 20 Seiten vollständig lesen können.
Die Bemerkung dieses Gründers trifft den Kern der Sache: „Das ist keine Inhaltserstellung, das sind nur 8790 Entscheidungen, ob man einen Link setzen soll oder nicht.“
Das erklärt auch, warum der Gründer Diogo Almeida bei seinem Abschied von OpenAI die Aussage getroffen hat: „Wir halten einen Blitz in der Hand, aber er ist nicht einfach zu bedienen.“
Als Kernforscher, der am Aufbau von ChatGPT beteiligt war und RLHF mit erfunden hat, trägt Almeidas Reflexion die kalte Sachlichkeit eines Insiders der Branche. Seiner Meinung nach steckt die gesamte Branche schon viel zu lange in der Sackgasse fest, die Optimierung der menschlichen natürlichen Sprache voranzutreiben.
Für die Zusammenarbeit zwischen Computern braucht es keine betonten, ausdrucksstarken Redewendungen – Maschinen brauchen klare Anweisungen und Wahrscheinlichkeiten. Die Sprachfähigkeiten, die die KI-Branche in den vergangenen vier Jahren mit Hunderten von Milliarden Dollar trainiert hat, sind in den meisten Fällen vor dem Hintergrund ernsthafter Systemtechnik ein ineffizientes Hindernis.
Armin Ronacher, CTO des Pi-Frameworks, spricht unverblümt über dieses Phänomen: „Wir hätten das schon lange erkennen müssen. Nur weil die gängigen großen Modelle früher durch Venture-Kapital extrem subventioniert und billig waren, haben sich alle an die Verschwendung gewöhnt, und niemand wollte wirklich kreativ nachdenken.“
Sobald diese Illusion von Billigkeit zerbricht, ist die Umorientierung der Architektur unumkehrbar.
Große Modelle kehren zu dem Platz zurück, an dem sie eigentlich hingehören.
Sie sollten nicht als zentrale Prozessore fungieren, sondern eignen sich viel besser als PR-Sprecher an der Schnittstelle zum Nutzer. In zukünftigen Systemarchitekturen werden massenhaft millisekundenschnelle Entscheidungen von Intuitionsmodellen übernommen, die so billig wie Leitungswasser sind. Nur an sehr wenigen Stellen, wo man tatsächlich längere Textabschnitte für menschliche Nutzer erzeugen, emotionalen Mehrwert liefern oder komplexe lange Berichte entwerfen muss, wird das teure generative Modell aktiviert.
03
Die Trennung von „Entscheidung“ und „Generierung“
Wenn man auf die KI-Narrative der vergangenen drei Jahre zurückblickt, war die Hauptlinie immer: „Große Modelle werden immer größer, klüger und vielseitiger“. Ein Modell kann chatten, Code schreiben, Bilder analysieren und Tabellen erstellen – es kann alles. Die gesamte Branche ging davon aus, dass „Intelligenz“ ein unteilbarer Block ist.
Das Auftauchen von Jev hat diesen Block aufgebrochen. Es beweist, dass einige Aufgaben Schlussfolgerungen und Ausdrucksfähigkeit erfordern, andere nur schnelle Entscheidungen brauchen. Die beiden Dinge zusammenzubinden ist eine strukturelle Verschwendung.
Der Hype um Jev hat die Begeisterung der Open-Source-Gemeinde entfacht | Bildquelle: Google DeepMind
Nur einen Tag nach der Veröffentlichung von Jev hat die Open-Source-Gemeinde nachgezogen. Die Mitwirkenden von vLLM haben auf Basis von Googles DiffusionGemma schnell eine Open-Source-Version erstellt, deren Genauigkeit bei ersten Tests fast der offiziellen Version entspricht. Das zeigt, dass die Kategorie der „Entscheidungsmodelle“ als eigenständige Produktgattung etabliert ist – es handelt sich nicht nur um eine Produktinnovation eines einzelnen Unternehmens.
Noch bemerkenswerter ist die Veränderung der nachgelagerten Architekturen. In dem neuen Paradigma, das von Jev angeregt wurde, hat ein KI-System nicht mehr nur „ein Gehirn“, sondern beginnt mit Arbeitsteilung: Massenhaft millisekundenschnelle Entscheidungen werden von Intuitionsmodellen übernommen, die so billig wie Leitungswasser sind. Nur an sehr wenigen Stellen, wo man tatsächlich längere Textabschnitte für menschliche Nutzer erzeugen oder komplexe Dokumente entwerfen muss, wird das teure generative Modell aktiviert.
Das ist keine bloße Kostensenkung und Effizienzsteigerung, sondern der Ausgangspunkt einer Umgestaltung der KI-Grundarchitektur von „zentraler Steuerung“ hin zu „verteilter Arbeitsteilung“.
Wenn die Kosten einer einzelnen Entscheidung von mehreren US-Cent auf ein Zehntausendstel US-Cent sinken, werden Entwickler nicht einfach die ursprünglichen 100 Entscheidungen billiger machen. Sie beginnen, 10.000 Entscheidungen durchzuführen